एक बार सुंदर AI कैरेक्टर बनाना आसान है। मुश्किल यह है कि अगली 20 इमेज में वही चेहरा हूबहू वापस लाया जाए, और ज़्यादातर लोग यहीं हार मान लेते हैं। नाक थोड़ी बदल जाती है, आँखों का आकार बदल जाता है, जबड़ा नरम या तीखा हो जाता है, और अचानक आपके पास अलग-अलग सीन में एक ही इंसान की जगह अजनबियों से भरी गैलरी होती है। NSFW AI जनरेशन में यह असंगति क्रिएटर्स की सबसे आम और सबसे झुंझलाने वाली समस्याओं में से एक है, और इसके व्यावहारिक हल मौजूद हैं।
हर बार कैरेक्टर का चेहरा क्यों बिगड़ जाता है
हर स्टैंडर्ड टेक्स्ट-टू-इमेज जनरेशन रैंडम नॉइज़ से शुरू होता है। मॉडल एक विशाल प्रायिकता वितरण से सैंपल लेता है और ऐसी इमेज बनाता है जो आपके प्रॉम्प्ट से सांख्यिकीय रूप से मेल खाए। इसका मतलब है कि बिल्कुल एक ही प्रॉम्प्ट के दो रन दो अलग चेहरे देते हैं, क्योंकि "गहरी आँखों और तीखी गालों की हड्डियों वाली सुंदर महिला" एक साथ लाखों संभावित चेहरों का वर्णन करती है।
मॉडल के पास कोई मेमोरी नहीं होती। "पिछली बार वाला वही इंसान" जैसी कोई धारणा उसमें नहीं होती। हर जनरेशन पूरी तरह स्वतंत्र होती है।
विस्तृत प्रॉम्प्टिंग की सीमाएँ
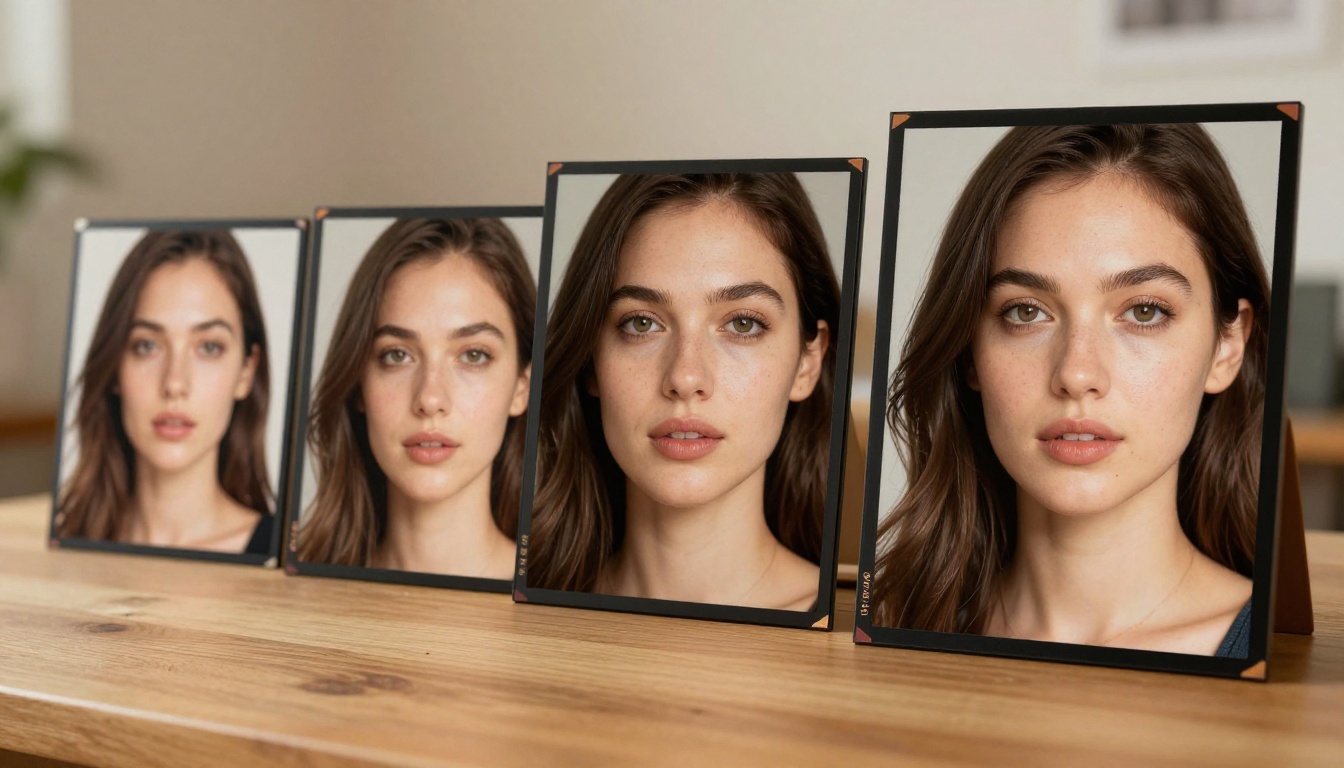
सहज हल यह लगता है कि चेहरे का वर्णन और लंबा और ज़्यादा विशिष्ट लिखा जाए। "अंडाकार चेहरा, गहरी धँसी हुई हेज़ल आँखें, ऊँची गालों की हड्डियाँ, छोटी ऊपर उठी नाक, प्राकृतिक रंग वाले भरे होंठ, हल्की जैतूनी त्वचा, दाहिने होंठ के ऊपर एक छोटा तिल।" ज़्यादातर क्रिएटर्स यह आज़मा चुके हैं। यह भरोसेमंद तरीके से काम नहीं करता।
विस्तृत प्रॉम्प्ट संभावनाओं को थोड़ा सीमित करते हैं, पर उन्हें स्थिर नहीं करते। उसी वर्णन के दो रन अब भी साफ़ तौर पर अलग लोग दिखा सकते हैं। आपको शायद वही सामान्य सौंदर्य मिले, पर वही चेहरा नहीं।
इसे सिर्फ़ बेहतर प्रॉम्प्टिंग से हल नहीं किया जा सकता। इसके लिए मॉडल को टेक्स्ट विवरण नहीं, बल्कि एक असली इमेज रेफ़रेंस देना ज़रूरी है।
व्यवहार में फ़ेस लॉक का मतलब क्या है
"फ़ेस लॉक" उस किसी भी तकनीक को कहते हैं जो किसी खास चेहरे की पहचान को आगे की जनरेशन में बाँधकर रखती है। शब्दों से चेहरे का वर्णन करने के बजाय आप मॉडल को चेहरे की इमेज देते हैं और उसे वह पहचान बनाए रखने का निर्देश देते हैं, जबकि बाकी सब कुछ आज़ादी से बदला जा सकता है: पोशाक, बैकग्राउंड, लाइटिंग, पोज़ और मूड।
नतीजा वही है जो हर गंभीर NSFW क्रिएटर असल में चाहता है: एक कैरेक्टर, अनगिनत परिदृश्य, और हर तस्वीर में वह साफ़ तौर पर वही इंसान।
तीन तरीके जो सच में काम करते हैं
आधुनिक AI प्लेटफ़ॉर्म फ़ेस-लॉक्ड जनरेशन के लिए तीन अलग तकनीकी तरीके इस्तेमाल करते हैं। हर एक की क्वालिटी, लचीलेपन और सेटअप की ज़रूरत में अलग समझौते हैं।
तरीका 1: कॉन्टेक्स्ट-अवेयर इमेज एडिटिंग
यह सबसे नया तरीका है और सबसे सुलभ भी। Flux Kontext Pro और Flux Kontext Max जैसे मॉडल एक मौजूदा इमेज को इनपुट के रूप में लेते हैं और आपको खास तत्व बदलने देते हैं, जबकि बाकी सब कुछ साफ़ तौर पर सुरक्षित रहता है।
आप अपनी मुख्य कैरेक्टर रेफ़रेंस इमेज देते हैं, फिर सिर्फ़ वही टेक्स्ट निर्देश लिखते हैं जो बदलना है: पोशाक, सेटिंग, लाइटिंग, पोज़। चेहरा बचाने का काम मॉडल खुद, बिना किसी अतिरिक्त कॉन्फ़िगरेशन के, करता है।
इस तरीके में सेटअप का समय शून्य है। रेफ़रेंस इमेज से लेकर एक जैसे कैरेक्टर की सीरीज़ तक का यह सबसे तेज़ रास्ता है।
💡 ज़्यादातर क्रिएटर्स के लिए Flux Kontext Pro सबसे अच्छी शुरुआत है। इसे ट्रेनिंग की ज़रूरत नहीं, कोई तकनीकी सेटअप नहीं, और आपकी रेफ़रेंस इमेज देते ही कुछ सेकंड में चेहरा एक जैसा रखने वाले नतीजे मिल जाते हैं।
तरीका 2: LoRA फ़ाइन-ट्यूनिंग
LoRA (Low-Rank Adaptation) गहरी कैरेक्टर कंसिस्टेंसी का सबसे उच्च-फ़िडेलिटी तरीका है। आप अपने कैरेक्टर की 15 से 30 इमेज इकट्ठा करते हैं और एक छोटी एडेप्टर फ़ाइल ट्रेन करते हैं, जिसे किसी भी जनरेशन में डाला जा सकता है और जो मॉडल को उस खास चेहरे की ओर बुनियादी स्तर पर खींचती है।
इसका समझौता यह है कि ट्रेनिंग में समय और संसाधन लगते हैं। लेकिन एक बार बन जाने पर कैरेक्टर LoRA ऐसी कंसिस्टेंसी देता है जिसे कोई और तरीका नहीं छू सकता। चेहरा हर आउटपुट में मूल रूप से पक्के तौर पर शामिल हो जाता है।
PicassoIA पर p-image-lora और flux-dev-lora दोनों जनरेशन के लिए सीधे कस्टम कैरेक्टर LoRA लोड करने को सपोर्ट करते हैं।
तरीका 3: फ़ेस रेफ़रेंस के साथ ControlNet
ControlNet रेफ़रेंस इमेज से स्ट्रक्चरल जानकारी निकालता है और उसी से आउटपुट को दिशा देता है। फ़ेस-स्पेसिफ़िक ControlNet मोड चेहरे के लैंडमार्क (आँखों की स्थिति, नाक का पुल, जॉलाइन) पकड़ते हैं और मॉडल को वही संरचना दोहराने पर मजबूर करते हैं।
जब इसे कैरेक्टर LoRA के साथ मिलाया जाता है, तो ControlNet पहचान और शरीर की संरचना, दोनों पर एक साथ नियंत्रण देता है। Realvisxl v3 Multi ControlNet LoRA और SDXL Multi ControlNet LoRA जैसे मॉडल एक ही जनरेशन में कई कंट्रोल सिग्नल स्टैक करने देते हैं।
फ़ेस-कंसिस्टेंट NSFW जनरेशन के लिए सबसे अच्छे मॉडल
सभी मॉडल फ़ेस-लॉक्ड जनरेशन को एक जैसी अच्छाई से नहीं संभालते। PicassoIA के शीर्ष मॉडल इस खास उपयोग के लिए तुलना में कैसे ठहरते हैं, यह यहाँ है।
Flux Kontext Pro और Max
ये आइडेंटिटी-प्रिज़र्विंग एडिट्स के लिए ही बने हैं। Flux Kontext Pro और Flux Kontext Max दोनों को शुरू से ही कई सीन में कैरेक्टर एडिटिंग की कंसिस्टेंसी को केंद्र में रखकर डिज़ाइन किया गया था।
| फ़ीचर | Flux Kontext Pro | Flux Kontext Max |
|---|
| फ़ेस कंसिस्टेंसी | उत्कृष्ट | बेजोड़ |
| आउटपुट रिज़ोल्यूशन | हाई | अल्ट्रा-हाई |
| जनरेशन स्पीड | तेज़ | मध्यम |
| सबसे अच्छा किसके लिए | इटरेशन और टेस्टिंग | अंतिम क्वालिटी रेंडर |
Realvisxl v3.0 Turbo
Realvisxl v3.0 Turbo NSFW कैरेक्टर वर्क के लिए सबसे अच्छे फ़ोटोरियलिस्टिक बेस मॉडल में से एक है। इसकी हाइपररियलिस्टिक स्किन रेंडरिंग फ़ेस-लॉक वर्कफ़्लो के साथ बहुत अच्छी तरह मिलती है। जब LoRA या ControlNet का फ़ेस सिग्नल लगाया जाता है, तो यह मॉडल किसी भी उपलब्ध मॉडल में सबसे विश्वसनीय रूप से असली लगने वाली स्किन टेक्सचर, बालों की डिटेल और चेहरे की लाइटिंग में से कुछ दे पाता है।
Flux 1.1 Pro Ultra
Flux 1.1 Pro Ultra हाई-फ़िडेलिटी बेस कैरेक्टर बनाने में उत्कृष्ट है। इसका इस्तेमाल अपना मुख्य रेफ़रेंस इमेज बनाने के लिए करें, फिर उस रेफ़रेंस को सीन वैरिएशन के लिए Flux Kontext में लोड करें। किसी कैरेक्टर को स्थापित करने के लिए इस मॉडल के नेटिव रिज़ोल्यूशन पर इमेज क्वालिटी असाधारण है।
ControlNet के साथ SDXL
SDXL को SDXL Multi ControlNet LoRA के साथ मिलाने से उन क्रिएटर्स को सीधा रास्ता मिलता है जिनके पास पहले से SDXL-ट्रेन्ड कैरेक्टर LoRA हैं, और वे बड़े पैमाने पर फ़ेस-कंसिस्टेंट जनरेशन कर सकते हैं। मल्टी-ControlNet सपोर्ट का मतलब है कि आप फ़ेस, पोज़ और डेप्थ कंट्रोल एक साथ लगा सकते हैं।
कैरेक्टर LoRA बनाना: इसमें क्या लगता है
अगर आपको समय के साथ सैकड़ों इमेज में पक्की फ़ेस कंसिस्टेंसी चाहिए, तो ट्रेन किया हुआ कैरेक्टर LoRA सही निवेश है। प्रक्रिया ऐसे चलती है।
ट्रेनिंग इमेज चुनना
आपके LoRA की क्वालिटी पूरी तरह आपके ट्रेनिंग डेटा पर निर्भर करती है। इन मानकों का इस्तेमाल करें:
- एक ठोस कैरेक्टर LoRA के लिए कम से कम 15 से 25 इमेज, और प्रोफ़ेशनल-ग्रेड के लिए 30 से 50
- लाइटिंग की विविधता: अलग-अलग लाइटिंग वाली इमेज शामिल करें, सिर्फ़ एक जैसे स्टूडियो सेटअप नहीं
- एंगल की विविधता: सामने से, तीन-चौथाई, साइड प्रोफ़ाइल, थोड़ा ऊपर से, थोड़ा नीचे से
- एक्सप्रेशन की विविधता: न्यूट्रल, मुस्कुराता हुआ, गंभीर, दूर देखता हुआ
- चेहरा साफ़ दिखे: हर इमेज में चेहरा साफ़ दिखना चाहिए, भारी ब्लर, ओक्लूज़न या ओवरसैचुरेशन न हो
PicassoIA पर अपना LoRA लोड और इस्तेमाल करना
ट्रेन होने के बाद अपना कैरेक्टर LoRA PicassoIA पर p-image-lora या flux-dev-lora में लोड करें। जिस पैरामीटर को सबसे ज़्यादा संभालना है वह है LoRA वेट:
| वेट रेंज | असर |
|---|
| 0.3 से 0.5 | हल्का प्रभाव, चेहरे में रचनात्मक बदलाव की गुंजाइश |
| 0.6 से 0.8 | मज़बूत फ़ेस लॉक, सुझाई गई रेंज |
| 0.9 से 1.0 | कठोर नियंत्रण, आर्टिफ़ैक्ट आ सकते हैं |
0.75 से शुरू करें और पहले कुछ आउटपुट के आधार पर एडजस्ट करें। ज़्यादातर कैरेक्टर LoRA 0.65 से 0.80 के बीच सबसे अच्छा काम करते हैं। 0.9 से ऊपर जाने पर अक्सर स्किन टेक्सचर में आर्टिफ़ैक्ट और ज़्यादा सैचुरेटेड फ़ीचर आ जाते हैं।
💡 LoRA इस्तेमाल करते समय का अहम नियम: अपने टेक्स्ट प्रॉम्प्ट में चेहरे का वर्णन करना बंद करें। LoRA के साथ चेहरे के वर्णन जोड़ने से विरोधी सिग्नल बनते हैं। सारा चेहरे वाला काम LoRA को करने दें। टेक्स्ट प्रॉम्प्ट का इस्तेमाल सिर्फ़ पोशाक, माहौल, लाइटिंग और पोज़ के लिए करें।
पोज़ और स्ट्रक्चर के लिए ControlNet
पहचान का नियंत्रण और पोज़ का नियंत्रण अलग-अलग समस्याएँ हैं। LoRA चेहरा लॉक करता है। ControlNet शरीर की स्थिति और स्ट्रक्चरल कम्पोज़िशन लॉक करता है।
OpenPose कंट्रोल
OpenPose ControlNet रेफ़रेंस इमेज से एक स्केलेटन वायरफ़्रेम निकालता है और मॉडल को कैरेक्टर को उसी सटीक शरीर की स्थिति में आउटपुट करने पर मजबूर करता है। फ़ेस LoRA के साथ मिलाने पर आपको यह पूरा नियंत्रण मिल जाता है कि इमेज में कौन दिखेगा और वह कैसे पोज़ में होगा।
मल्टी-सीन NSFW कहानियाँ बनाने के लिए यह ज़रूरी है, जहाँ आपके कैरेक्टर को अलग-अलग सेटिंग में पहले से तय पोज़ में दिखना होता है।
फ़ेस स्ट्रक्चर कंट्रोल
फ़ेस-स्पेसिफ़िक ControlNet मोड रेफ़रेंस से चेहरे के लैंडमार्क की स्थिति पकड़ते हैं और आउटपुट में उन्हें लागू करते हैं। आँखों के बीच की दूरी, नाक की जगह, मुँह की स्थिति और चेहरे की बनावट, सब रेफ़रेंस से जनरेशन में ट्रांसफ़र हो जाते हैं। यह तब खास तौर पर काम का है जब आपको शॉट्स के बीच ठीक वही चेहरे के एंगल मिलाने हों।
Realvisxl v3 Multi ControlNet LoRA फ़ेस ControlNet को OpenPose के साथ एक साथ स्टैक करने देता है, जिससे सीरीज़ की हर जनरेशन पर आपका पूरा संरचनात्मक नियंत्रण रहता है।
पहली इमेज से पूरी सीरीज़ तक एक व्यावहारिक वर्कफ़्लो
PicassoIA पर फ़ेस-कंसिस्टेंट NSFW कैरेक्टर सीरीज़ बनाने की सटीक चरण-दर-चरण प्रक्रिया यह है।
चरण 1: मुख्य रेफ़रेंस बनाएँ
Flux Kontext Pro या Flux 1.1 Pro Ultra खोलें। चेहरे और कैरेक्टर की पहचान पर केंद्रित एक विस्तृत प्रॉम्प्ट लिखें। कई वैरिएशन जनरेट करें और उनमें से एक को अपना मुख्य रेफ़रेंस चुनें। सीड नंबर नोट कर लें। यही इमेज आगे के सब कुछ का आधार है।
चरण 2: अपना कंसिस्टेंसी तरीका चुनें
| तरीका | सबसे अच्छा किसके लिए | सेटअप की ज़रूरत |
|---|
| Flux Kontext Pro/Max | तेज़ इटरेशन, सीन बदलना | कोई नहीं |
| LoRA लोडिंग | बड़े बैच, गहरी कंसिस्टेंसी | मध्यम |
| Multi ControlNet + LoRA | अधिकतम स्ट्रक्चरल सटीकता | ज़्यादा |
| Face Swap AI | एक-बार का बदलाव | न्यूनतम |
चरण 3: सीन वैरिएशन जनरेट करें
Flux Kontext Pro के साथ अपनी मुख्य रेफ़रेंस इमेज दें और छोटे, साफ़ निर्देश इस्तेमाल करें जो सिर्फ़ बदलने वाली चीज़ें बताएँ:
- "पोशाक बदलकर लाल साटन बॉडीसूट करें, चेहरा हूबहू वही रखें"
- "सेटिंग को गर्म एम्बर शाम की रोशनी वाला बेडरूम करें, वही कैरेक्टर रखें"
- "आलथी-पालथी मारकर बैठा पोज़, बाहर टेरेस का बैकग्राउंड, चेहरा सुरक्षित रखें"
मॉडल आपकी रेफ़रेंस इमेज से चेहरा पढ़ता है और उसे अपने आप लागू कर देता है। आप सिर्फ़ वही नियंत्रित करते हैं जो बदलता है।
चरण 4: अपस्केल और फ़ाइनल करें
सीन की सीरीज़ जनरेट करने के बाद हर इमेज को PicassoIA के सुपर-रिज़ॉल्यूशन टूल्स से गुज़ारें, ताकि 2x या 4x रिज़ोल्यूशन पर पूरी स्किन टेक्सचर, बालों की लटें और कपड़े की बुनावट उभर आए। फ़ेस लॉक तकनीकें बेस रिज़ोल्यूशन पर पहचान को अच्छी तरह बचाती हैं; बारीक डिटेल अपस्केलिंग के दौरान सामने आती है।
💡 हमेशा पहले बेस रिज़ोल्यूशन पर जनरेट करें और फ़ेस कंसिस्टेंसी की पुष्टि करें, फिर अपस्केल करें। अगर चेहरा सही न हो तो कंसिस्टेंसी की पुष्टि से पहले अपस्केलिंग करना समय बर्बाद करता है।
वे गलतियाँ जो फ़ेस कंसिस्टेंसी तोड़ती हैं
ज़्यादातर फ़ेस-लॉक की विफलताएँ गलतियों के एक ही छोटे समूह से आती हैं। इन्हें खास तौर पर टालें।
विरोधी सिग्नल मिलाना
जब आप चेहरे के नियंत्रण के लिए LoRA या रेफ़रेंस इमेज इस्तेमाल करते हैं, तो टेक्स्ट प्रॉम्प्ट से सारे चेहरे के वर्णन हटा दें। LoRA-गाइडेड जनरेशन में "अंडाकार चेहरा, बादाम जैसी आँखें" जोड़ने से सिग्नल में टकराव होता है। मॉडल एक साथ LoRA वाले चेहरे और टेक्स्ट वाले चेहरे, दोनों को संतुष्ट करने की कोशिश करता है। नतीजा एक औसत, धुंधला समझौता होता है जो न इधर का लगता है न उधर का।
जिम्मेदारियाँ अलग रखें: LoRA/रेफ़रेंस चेहरा संभाले, टेक्स्ट बाकी सब कुछ।
सीरीज़ के बीच में मॉडल बदलना
Flux Dev और Stable Diffusion 3.5 Large एक ही कैरेक्टर को बुनियादी स्तर पर अलग तरह से समझते हैं। किसी सीरीज़ की इमेज के बीच मॉडल बदलने से विज़ुअल असंगति तय है, भले ही फ़ेस लॉक तकनीकी रूप से काम कर रहा हो। किसी कैरेक्टर सीरीज़ के लिए एक मॉडल चुनें और उसी पर टिके रहें।
लाइटिंग की संगति को नज़रअंदाज़ करना
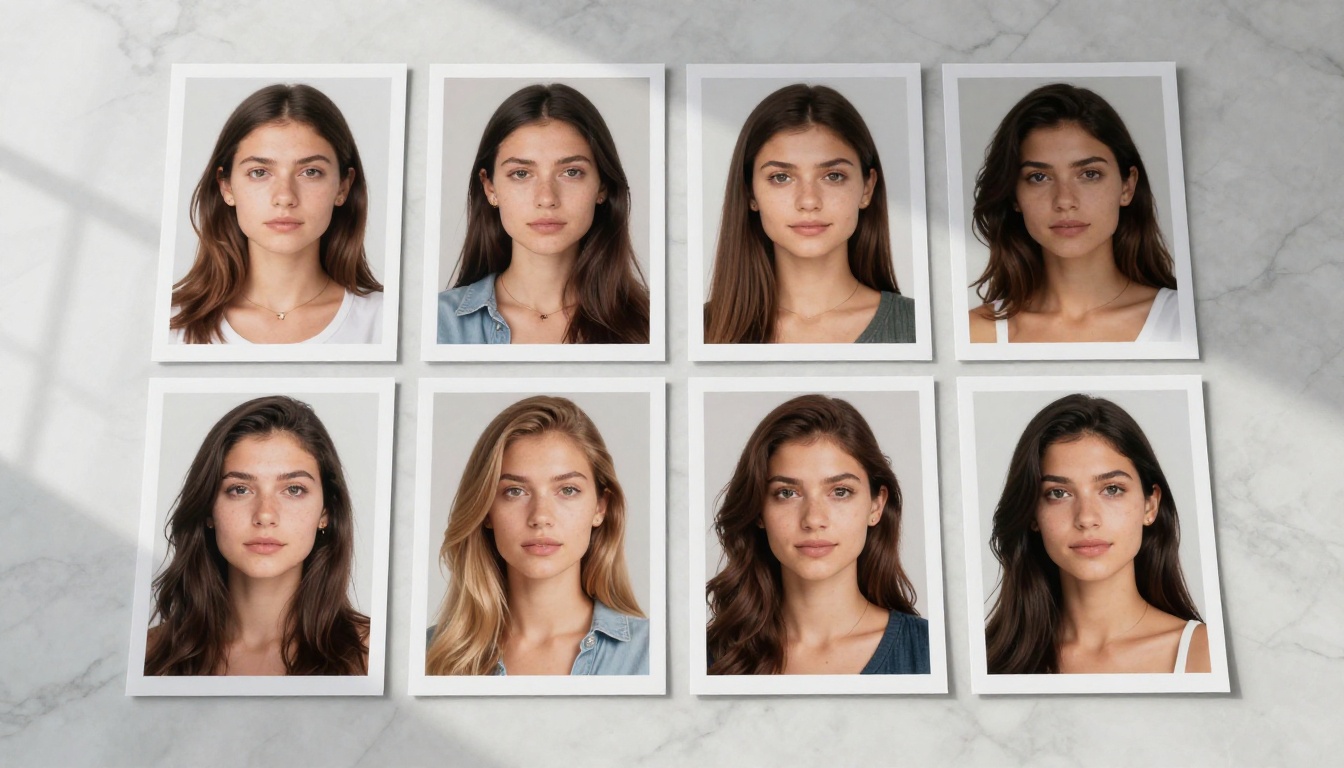
फ़ेस कंसिस्टेंसी सिर्फ़ हड्डियों की बनावट की बात नहीं है। लाइटिंग चेहरे के दिखने वाले आकार को नाटकीय रूप से बदल देती है। बाईं ओर से तेज़ साइड लाइटिंग से बनने वाली परछाइयाँ नरम फ़्रंटल डिफ़्यूज़न से पूरी तरह अलग होती हैं, और परफ़ेक्ट फ़ेस लॉक के बावजूद एक ही चेहरा दो अलग लोगों जैसा दिख सकता है।
अपने कैरेक्टर के लिए एक लाइटिंग सिग्नेचर तय करें और हर प्रॉम्प्ट में उसे शामिल करें:
- लाइट सोर्स की दिशा बताएँ: "ऊपर बाईं ओर से गर्म सुबह की रोशनी"
- परछाई की क्वालिटी बताएँ: "नरम डिफ़्यूज़्ड परछाइयाँ, तेज़ कंट्रास्ट नहीं"
- कलर टेम्परेचर बताएँ: "5500K न्यूट्रल डेलाइट"
एक जैसी लाइटिंग से धारणा में जो फ़र्क पड़ता है वह ज़्यादातर क्रिएटर्स की उम्मीद से कहीं ज़्यादा है।
गलत कारण से कम LoRA वेट
कुछ क्रिएटर ओवर-सैचुरेशन से बचने के लिए LoRA वेट घटा देते हैं, पर 0.55 से नीचे जाते ही फ़ेस कंसिस्टेंसी पूरी तरह टूट जाती है। ज़्यादातर कैरेक्टर LoRA के लिए सबसे अच्छी रेंज 0.65 से 0.80 है। अगर आपको ओवर-सैचुरेशन दिख रहा है, तो समस्या आमतौर पर ट्रेनिंग डेटा की क्वालिटी या 0.85 से ऊपर का बहुत ज़्यादा वेट होती है, वेट की रेंज खुद नहीं।
तेज़ विकल्प के रूप में फ़ेस स्वैप
उन स्थितियों के लिए जहाँ LoRA ट्रेन करना व्यावहारिक नहीं है, Face Swap AI एक सीधा शॉर्टकट है। जो सीन चाहिए उसे आज़ादी से जनरेट करें, फिर फ़ेस स्वैप लगाकर आउटपुट का चेहरा अपने टारगेट कैरेक्टर से बदल दें।
यह खास तौर पर इनके लिए काम करता है:
- वन-ऑफ़ अनुरोध जहाँ LoRA ट्रेन करने में ज़रूरत से ज़्यादा मेहनत लगे
- किसी पूरी तरह AI-जनरेटेड बॉडी और पोशाक पर असली रेफ़रेंस चेहरा लगाना
- त्वरित कंटेंट जिसे किसी चल रही कैरेक्टर सीरीज़ का हिस्सा न बनना हो
PicassoIA का Face Swap AI टूल चेहरे की सीमा पर स्किन-टोन ब्लेंडिंग और लाइटिंग की संगति संभालता है, ताकि बदलाव कंपोज़िट किया हुआ नहीं, बल्कि स्वाभाविक लगे।
लंबी सीरीज़ में संगति बनाए रखना
पेशेवर NSFW क्रिएटर्स को अक्सर हफ़्तों या महीनों में दर्जनों या सैकड़ों इमेज में एक ही कैरेक्टर बनाए रखना पड़ता है। कुछ अतिरिक्त अभ्यास इसे टिकाऊ बनाते हैं।
एक रेफ़रेंस शीट बनाएँ
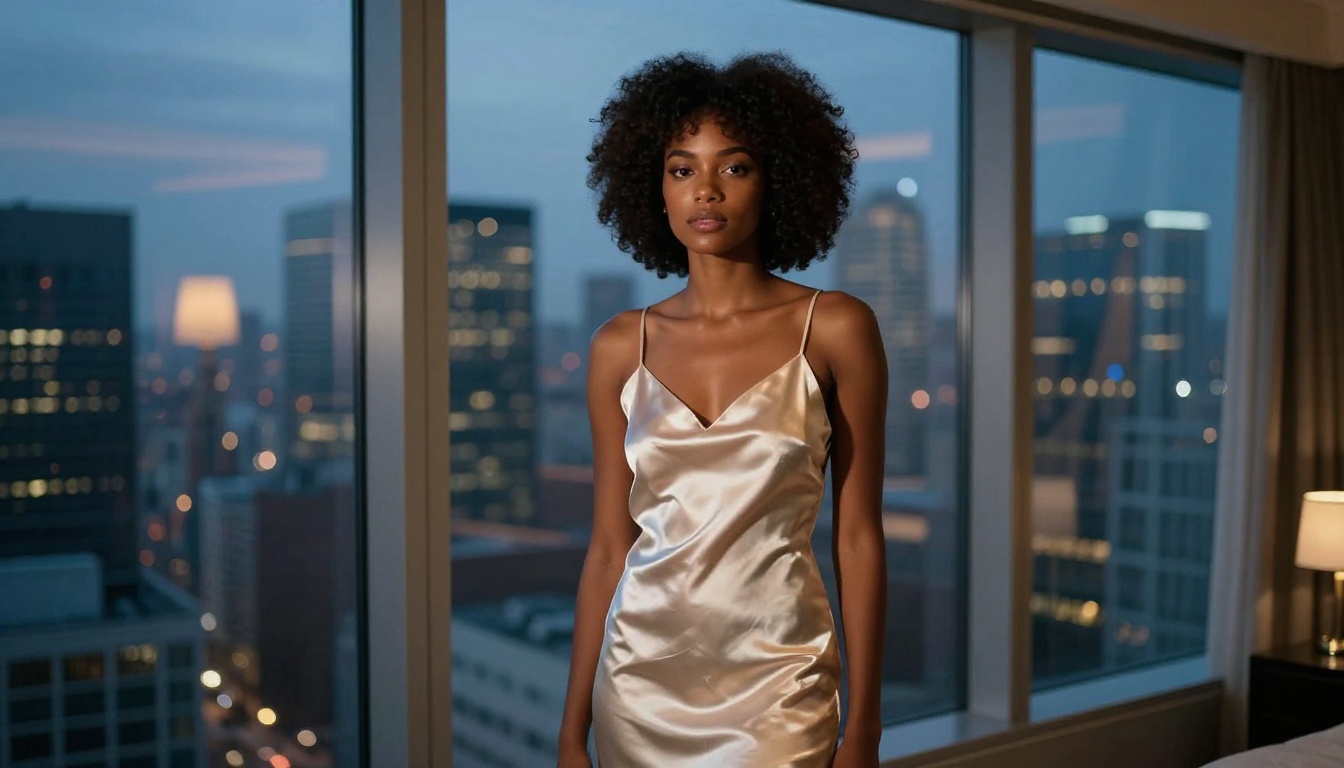
अपना मुख्य कैरेक्टर तय करने के बाद एक छोटी रेफ़रेंस शीट बनाएँ: वही चेहरा कई एंगल से (सामने, तीन-चौथाई बाईं ओर, तीन-चौथाई दाईं ओर, प्रोफ़ाइल) और एक जैसी न्यूट्रल लाइटिंग में। यह शीट आपकी भविष्य की सभी ControlNet फ़ेस रेफ़रेंस की सामग्री बन जाती है और अलग-अलग सीन कम्पोज़िशन के लिए कई एंगल देती है।
सब कुछ दर्ज करें
एक कैरेक्टर फ़ाइल रखें जिसमें यह दर्ज हो:
- मुख्य रेफ़रेंस के लिए इस्तेमाल किया गया मॉडल
- मुख्य जनरेशन में इस्तेमाल किया गया सीड
- LoRA फ़ाइल का नाम और वेट सेटिंग
- पूरी सीरीज़ में इस्तेमाल की गई बेसलाइन लाइटिंग का विवरण
- ऐसे सैंपल प्रॉम्प्ट जिन्होंने अच्छी कंसिस्टेंसी दी
हफ़्तों के अंतराल के बाद याद के सहारे कोई कैरेक्टर दोबारा बनाना, हर पैरामीटर दर्ज किए हुए एक पन्ने के दस्तावेज़ को खोलने से कहीं ज़्यादा कठिन है।
फ़ेस सुधार के लिए इनपेंटिंग का इस्तेमाल करें
जब किसी सीन जनरेशन में कम्पोज़िशन बढ़िया बने, पर चेहरा थोड़ा असंगत हो, तो पूरी इमेज दोबारा जनरेट न करें। इनपेंटिंग से सिर्फ़ चेहरे वाला हिस्सा चुनें और उसे पूरे फ़ेस-लॉक पैरामीटर के साथ दोबारा बनाएँ, बाकी इमेज वैसी ही रहने दें। जब बैकग्राउंड, पोज़ और लाइटिंग पहले से सही हों, तो इससे काफ़ी समय बचता है।
PicassoIA पर अपना कैरेक्टर बनाना शुरू करें
इस लेख में बताई गई हर चीज़ PicassoIA पर उपलब्ध है, और इसके लिए अलग-अलग टूल, ट्रेनिंग एनवायरनमेंट या तकनीकी कॉन्फ़िगरेशन संभालने की ज़रूरत नहीं है। यह प्लेटफ़ॉर्म 91 टेक्स्ट-टू-इमेज मॉडल एक जगह लाता है, जिनमें Flux Kontext Pro, Flux Kontext Max, p-image-lora, flux-dev-lora, Realvisxl v3 Multi ControlNet LoRA और SDXL Multi ControlNet LoRA शामिल हैं, साथ ही फ़ेस स्वैप, इनपेंटिंग और सुपर-रिज़ॉल्यूशन भी एक ही जगह उपलब्ध हैं।
फ़ेस-लॉक को काम करते देखने का सबसे तेज़ तरीका है Flux Kontext Pro खोलना, एक ऐसा कैरेक्टर जनरेट करना जो आपको पसंद हो, और फिर उस इमेज से अलग पोशाक और सेटिंग वाले तीन-चार सीन वैरिएशन बनाना। इस वर्कफ़्लो और सिर्फ़ टेक्स्ट वाली सामान्य जनरेशन में फ़र्क तुरंत साफ़ दिख जाता है।
अगर किसी लंबे समय तक चलने वाले कैरेक्टर पर आपको गहरा नियंत्रण चाहिए, तो flux-dev-lora में ट्रेन किया हुआ LoRA लोड करें, या पूरी स्ट्रक्चरल सटीकता के लिए Realvisxl v3 Multi ControlNet LoRA के साथ मल्टी-ControlNet पाइपलाइन आज़माएँ। दोनों तरह से आपका कैरेक्टर बहकना बंद करता है और वैसा ही बना रहता है जैसा आपने उसे बनाया था।


