Alibaba vient de changer ce que l’on attend des modèles d’image d’IA open source, et la plupart des gens ne l’ont pas encore remarqué. Qwen Image n’est pas simplement un modèle texte vers image de plus qui rivalise sur les scores de benchmark. C’est une architecture multimodale qui comprend le contexte, modifie les images en cours de génération et produit des résultats qui se placent sans peine aux côtés des meilleurs systèmes propriétaires au monde. Cet article explique ce qu’est réellement Qwen Image, comment fonctionne l’architecture du modèle, ce qui a changé dans la version 2, et où vous pouvez commencer à l’utiliser aujourd’hui sans écrire une seule ligne de code.
Ce qu’est réellement Qwen Image
Qwen Image est la famille de modèles vision-langage multimodaux d’Alibaba, conçue pour la génération et l’édition d’images haute fidélité. Publié sous l’égide de Qwen (Tongyi Qianwen) par la DAMO Academy d’Alibaba Cloud, le modèle associe un grand modèle de langage comme colonne vertébrale, un encodeur visuel dédié et un décodeur d’image basé sur la diffusion. Cette combinaison le distingue des modèles de diffusion purs comme Stable Diffusion ou Flux.
Là où la plupart des modèles d’image prennent un prompt texte et le traitent en une seule passe de génération, Qwen Image traite simultanément le texte, le contexte visuel et le raisonnement spatial. Le modèle ne se contente pas de « peindre » une image à partir de mots ; il construit une interprétation sémantique de ce que vous voulez avant que le moindre pixel ne soit rendu.
L’unité de recherche en IA d’Alibaba
La DAMO Academy d’Alibaba (Discovery, Adventure, Momentum and Outlook) publie des travaux de recherche depuis 2017, avec des axes privilégiés en traitement automatique du langage naturel, vision par ordinateur et IA multimodale. La famille Qwen occupe une place centrale dans leur stratégie de LLM, en commençant par des modèles uniquement textuels avant de s’étendre à la vision et à la génération d’images.
La branche de génération d’images de la famille Qwen vise précisément l’écart entre le respect des instructions et la qualité visuelle, deux aspects historiquement en tension. Les anciens modèles suivaient les prompts avec précision mais donnaient des images plates, ou produisaient de belles images tout en ignorant la moitié de la consigne.
Du langage à la vision
L’architecture repose sur un tokenizer visuel qui encode les images d’entrée dans le même espace d’embedding que les tokens de texte. C’est la base technique de la capacité de Qwen Image à réaliser une édition guidée par des instructions. Quand vous demandez au modèle « assombrissez l’arrière-plan et ajoutez de la pluie », il n’utilise pas un outil d’inpainting séparé ; il réinterprète toute la scène à partir des nouvelles instructions.
💡 C’est pourquoi Qwen Image gère mieux les prompts complexes à plusieurs sujets que de nombreux modèles concurrents. Le composant de modèle de langage raisonne activement sur les relations spatiales avant de générer l’image.
Le fonctionnement réel du modèle
Au cœur de Qwen Image, on trouve un processus de diffusion basé sur le flow matching, reposant sur une colonne vertébrale de type transformer. Voici le pipeline simplifié :
- Encodage du texte : votre prompt est tokenisé et encodé par le modèle de langage Qwen
- Conditionnement visuel : si vous fournissez une image de référence, elle est encodée en parallèle
- Planification du bruit : le modèle initialise une représentation latente bruitée
- Débruitage itératif : le transformer affine progressivement le latent en plusieurs étapes
- Décodage VAE : le latent final est décodé en une image pleine résolution
Cette architecture est spécifiquement conçue pour suivre les instructions à grande échelle. La colonne vertébrale du modèle de langage représente une part importante du nombre total de paramètres, ce qui signifie que l’interprétation du prompt ne se dégrade pas lorsque les prompts deviennent plus longs ou plus complexes.
Prise en charge des entrées multimodales
La conception multimodale permet à Qwen Image de traiter des entrées que les modèles de diffusion purs ne peuvent pas gérer :
| Type d’entrée | Ce qu’il permet |
|---|
| Texte seul | Génération classique texte vers image |
| Texte + image de référence | Transfert de style ou édition d’image |
| Texte + masque | Inpainting de zones spécifiques |
| Plusieurs images | Fusion compositionnelle |
| Image + instruction d’édition | Édition guidée par des instructions |
Cet éventail d’entrées est ce qui distingue Qwen Image Edit d’un simple générateur. C’est un éditeur qui traite le langage naturel au niveau d’un collaborateur humain compétent.
Variantes texte vers image et édition d’image
Le modèle Qwen Image de base excelle en génération texte vers image, avec une forte fidélité au prompt. Les variantes Qwen Image Edit et Qwen Image Edit Plus étendent cette capacité à des flux de travail d’édition complets. La distinction compte si vous hésitez entre les deux :
- Utilisez le modèle de base lorsque vous générez à partir de zéro ou lorsque vous avez besoin d’une qualité visuelle maximale sur un prompt détaillé unique
- Utilisez les variantes d’édition lorsque vous disposez d’une image source à modifier, lorsque vous devez remplacer des objets, ou lorsque vous travaillez de façon itérative avec des boucles de retour
Qwen Image 2 et 2 Pro
La sortie de Qwen Image 2 a marqué un progrès notable. Alibaba ne s’est pas contenté d’augmenter les paramètres ; l’entreprise a repensé le pipeline d’entraînement autour d’une sélection de données de meilleure qualité et d’un modèle de récompense plus sophistiqué pour l’alignement sur les préférences humaines.
Ce qui a changé dans la version 2
Les principales améliorations de Qwen Image 2 par rapport à la version d’origine :
- Sorties en plus haute résolution par défaut, avec une meilleure préservation des détails à 1024x1024 et au-delà
- Décomposition du prompt améliorée : le modèle gère désormais les prompts longs et multi-propositions sans omettre les sujets secondaires
- Meilleure génération des visages et des mains, historiquement un point faible des modèles de diffusion
- Inférence plus rapide grâce à des optimisations d’architecture au niveau de la couche d’attention
- Adhérence au style plus constante lorsque des images de référence sont fournies
💡 À elle seule, l’amélioration de la génération des mains et des visages justifie de passer à Qwen Image 2 pour les portraits et la photographie lifestyle, où les sujets humains sont au centre.
Pro ou standard : lequel choisir
Qwen Image 2 Pro est la variante plus grande et plus haute fidélité. Voici quand chacune se justifie :
| Modèle | Idéal pour | Vitesse de génération |
|---|
| Qwen Image 2 | Itération rapide, contenu pour les réseaux sociaux, prototypage | Plus rapide |
| Qwen Image 2 Pro | Rendus finaux, travaux commerciaux, qualité d’impression | Plus lent |
Pour la plupart des flux de travail, commencer avec Qwen Image 2 pour tester les prompts, puis passer à Pro pour le rendu final, est l’approche la plus efficace.
Qualité réelle des résultats
Les benchmarks ne racontent qu’une partie de l’histoire. Le vrai test est la façon dont le modèle se comporte sur les types d’images que les gens ont réellement besoin de générer.
Portraits et personnes
Qwen Image produit des résultats de qualité portrait, avec une anatomie faciale précise, une texture de peau naturelle et des reflets corrects dans les yeux. La colonne vertébrale multimodale lui donne une meilleure maîtrise des proportions humaines que les anciens modèles open source, qui déformaient souvent les traits lorsque le prompt devenait complexe.
Pour les photos de mode et de style de vie, le modèle gère particulièrement bien les textures des vêtements : motifs de tissage visibles, drapé naturel et interaction correcte de la lumière avec différents matériaux.
Paysages et architecture
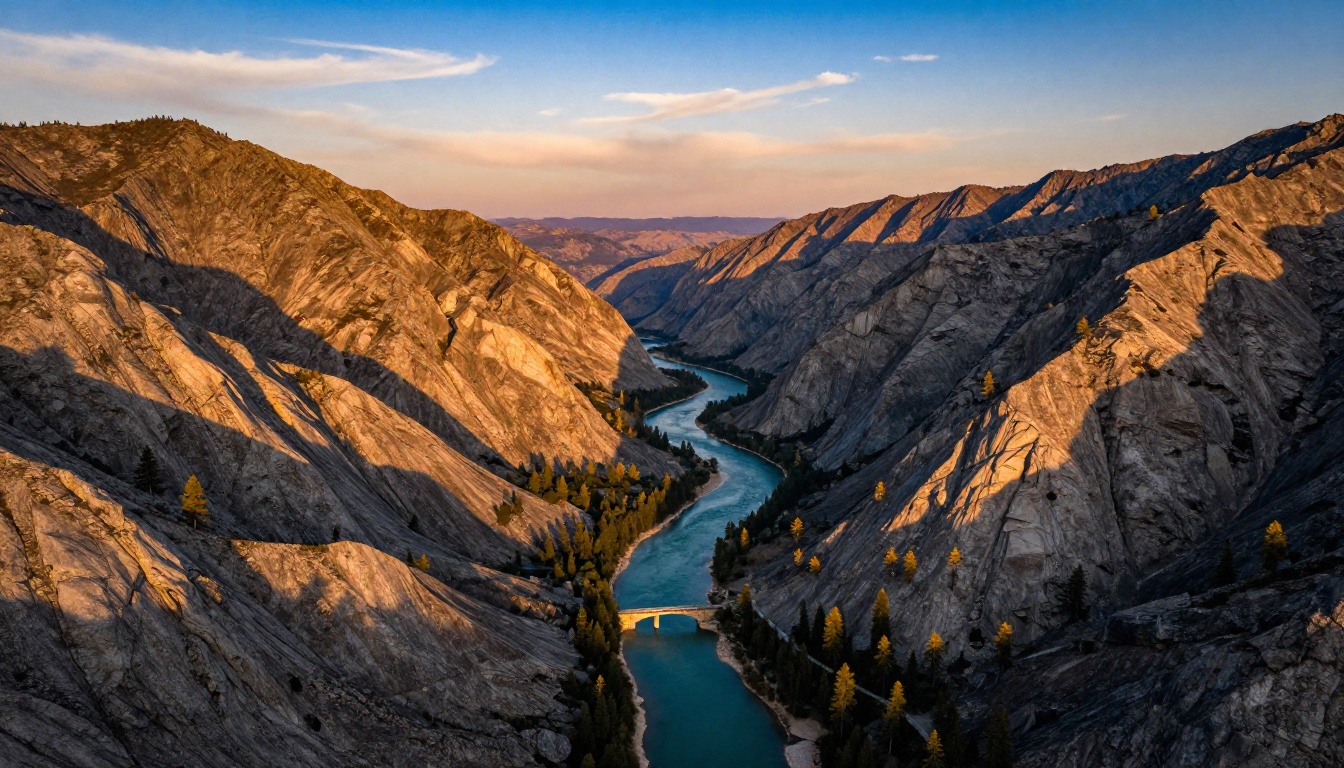
Les prompts aériens et paysagers sont l’endroit où un raisonnement spatial solide se remarque le plus. Qwen Image 2 Pro interprète correctement des instructions comme « vallée de montagne avec une rivière au premier plan et des nuages d’orage en arrière-plan » comme une scène spatialement cohérente, et non comme une composition plate d’éléments disjoints.
La génération architecturale profite de l’entraînement du modèle sur des données visuelles structurées. Les lignes de perspective sont justes, les reflets sur les façades en verre suivent une logique physique, et les dégradés de lumière sur les surfaces des bâtiments se comportent de façon cohérente avec la physique du monde réel.
Produits et travaux commerciaux
Pour la simulation de photographie produit, Qwen Image Edit Plus est particulièrement efficace. Vous pouvez fournir une photo de produit et utiliser des instructions d’édition pour changer les arrière-plans, ajuster l’éclairage ou ajouter des éléments de contexte. La qualité du suivi des instructions sur cette tâche réduit nettement les cycles d’itération par rapport à un montage traditionnel.
PicassoIA héberge toute la famille de modèles Qwen Image, ce qui vous permet d’utiliser Qwen Image, Qwen Image 2, Qwen Image 2 Pro et les variantes d’édition depuis un seul onglet de navigateur, sans installation, sans clés API et sans infrastructure à gérer.
Étape par étape sur PicassoIA
Étape 1 : choisissez votre modèle
Rendez-vous sur Qwen Image 2 Pro pour les résultats de meilleure qualité, ou sur Qwen Image 2 pour une itération plus rapide. Pour les flux d’édition, ouvrez Qwen Image Edit Plus.
Étape 2 : rédigez votre prompt avec des précisions
Qwen Image répond bien aux prompts détaillés, car le modèle de langage peut analyser des instructions complexes à plusieurs propositions. Incluez :
- Sujet : âge, vêtements, expression, pose
- Environnement : intérieur ou extérieur, moment de la journée, météo
- Éclairage : direction, qualité, température de couleur
- Perspective de la caméra : plan large, gros plan, vue aérienne, contre-plongée
Étape 3 : réglez le format
Pour le contenu web et les articles de blog, le format 16:9 convient à la plupart des mises en page. Le contenu en portrait (9:16) convient aux réseaux sociaux. Le format carré (1:1) est épuré pour les photos produit et les miniatures.
Étape 4 : générez et itérez
Lancez une première génération pour évaluer l’interprétation du prompt, puis affinez. Si un sujet secondaire est omis, placez-le plus tôt dans le prompt. Si les couleurs ne sont pas justes, soyez plus explicite avec les adjectifs (« terre cuite poussiéreuse » plutôt que « orange »).
Étape 5 : affinez avec les variantes d’édition
Si la génération de base est proche mais nécessite des modifications ciblées, importez-la dans Qwen Image Edit Plus et donnez une instruction d’édition en langage courant. Le modèle comprend des formulations naturelles comme « rendez l’arrière-plan plus chaud » ou « remplacez la veste par un manteau ».
Conseils pour de meilleurs résultats
💡 Qwen Image réagit mieux aux descriptions de caméra et d’éclairage que la plupart des modèles open source. Inclure « 85mm f/1.8, octabox de studio, ISO 200 » dans votre prompt, même pour des sujets non photographiques, aide le modèle à calibrer le réalisme.
- Évitez les adjectifs abstraits seuls : « beau » ne donne rien au modèle ; « contre-jour chaud de l’heure dorée sur une peau bronzée » lui donne une direction
- Faites référence à des styles photographiques réels : « dans le style d’un reportage Condé Nast Traveler des années 1990 » ou « style documentaire National Geographic » offrent de solides repères stylistiques
- Utilisez le LoRA trainer pour des personnages cohérents : Qwen Image LoRA Trainer vous permet d’effectuer un fine-tuning sur vos propres jeux d’images pour obtenir des personnages ou des univers de marque reproductibles
- Multipliez les variations : lancez 3 à 4 seeds avant de modifier le prompt. Le modèle a une variance suffisante pour que des seeds différents produisent souvent des compositions très différentes
Qwen Image face aux modèles concurrents
Il est utile d’être direct sur la position de Qwen Image par rapport aux alternatives que vous avez probablement déjà utilisées.
| Modèle | Respect du prompt | Réalisme | Édition | Poids ouverts |
|---|
| Qwen Image 2 Pro | Excellent | Très élevé | Multimodale native | Oui |
| Midjourney v6 | Bon | Très élevé | Remix uniquement | Non |
| DALL-E 3 | Excellent | Élevé | Inpainting limité | Non |
| Stable Diffusion XL | Modéré | Élevé | Via des plugins | Oui |
| Flux 1.1 Pro | Très bon | Très élevé | Pas d’édition native | Partiellement |
La différence majeure est l’édition multimodale native. Midjourney propose des options de remix, DALL-E dispose d’une interface d’inpainting, mais aucun ne rivalise avec Qwen Image Edit Plus sur les modifications complexes où vous voulez changer des éléments précis tout en préservant le reste du cadre.
Les poids ouverts comptent aussi concrètement. Les modèles Qwen Image sont publiés avec des poids disponibles pour un usage de recherche, ce qui signifie que l’écosystème de variantes affinées, d’adaptateurs LoRA et de pipelines spécialisés se développe grâce aux contributions de la communauté, et pas seulement grâce aux publications d’Alibaba.
Pourquoi les poids ouverts comptent pour ce modèle
La publication des poids du modèle par Alibaba n’est pas qu’un argument de positionnement. Elle accélère le développement de variantes spécialisées qu’aucune entreprise seule ne pourrait construire. Le Qwen Image LoRA Trainer sur PicassoIA en est une conséquence directe, offrant aux utilisateurs la possibilité d’affiner le modèle de base sur des esthétiques, des personnages ou des types de produits spécifiques, sans toucher à l’infrastructure.
Des checkpoints affinés apparaissent régulièrement dans la communauté open source, couvrant des styles photographiques précis, des esthétiques culturelles et des applications sectorielles que le modèle de base ne maîtrise pas. Cela renforce la valeur du modèle avec le temps, d’une manière que les modèles propriétaires fermés ne peuvent pas égaler.
Pour les utilisateurs professionnels, les poids ouverts réduisent la dépendance envers un fournisseur. Vous ne confiez pas votre chaîne de production à une seule API qui doit rester disponible et abordable. Qwen Image peut être auto-hébergé, adapté et étendu de manière indépendante.
💡 La combinaison de solides performances de base et de poids ouverts est exactement ce qui rend cette série de modèles intéressante comme base sur laquelle construire. Chaque publication d’Alibaba repousse le plafond de ce qui est réalisable sans infrastructure propriétaire.
Commencez à créer avec Qwen Image dès maintenant
Chaque image de cet article a été générée avec des modèles d’image photoréalistes disponibles sur PicassoIA. La technologie est prête pour la production, et la barrière d’entrée n’a jamais été aussi basse.
PicassoIA vous donne un accès direct depuis le navigateur à Qwen Image, Qwen Image 2, Qwen Image 2 Pro, Qwen Image Edit Plus et le LoRA Trainer, sans gérer d’infrastructure ni de tokens API.
Choisissez un sujet, rédigez un prompt détaillé et lancez votre première génération. L’écart entre ce que vous imaginez et ce que vous pouvez réellement produire n’a jamais été aussi réduit. Qwen Image 2 Pro vous attend.


