A Alibaba acaba de mudar o que esperamos dos modelos de geração de imagens por IA de código aberto, e a maioria das pessoas ainda não percebeu. O Qwen Image não é apenas mais um modelo de texto para imagem disputando pontuações em benchmarks. Trata-se de uma arquitetura multimodal que entende o contexto, edita imagens durante a geração e entrega resultados que ficam lado a lado com os melhores sistemas proprietários do mundo. Este artigo explica o que o Qwen Image realmente é, como funciona a arquitetura do modelo, o que mudou na versão 2 e onde você pode começar a usá-lo hoje sem escrever uma única linha de código.
O que é o Qwen Image, de fato
Qwen Image é a família de modelos de linguagem e visão multimodal da Alibaba, criada para geração e edição de imagens de alta fidelidade. Lançado sob o guarda-chuva Qwen (Tongyi Qianwen) pelo DAMO Academy da Alibaba Cloud, o modelo combina um modelo de linguagem de grande porte como base com um codificador visual dedicado e um decodificador de imagem baseado em difusão. Essa combinação é o que o diferencia de modelos de difusão puros, como o Stable Diffusion ou o Flux.
Enquanto a maioria dos modelos de imagem recebe um prompt de texto e o processa em uma única passagem de geração, o Qwen Image processa texto, contexto da imagem e raciocínio espacial ao mesmo tempo. O modelo não apenas "pinta" uma imagem a partir de palavras; ele constrói uma interpretação semântica do que você quer antes de qualquer pixel ser renderizado.
A unidade de pesquisa em IA da Alibaba
O DAMO Academy (Discovery, Adventure, Momentum and Outlook) da Alibaba publica pesquisas desde 2017, com foco em processamento de linguagem natural, visão computacional e IA multimodal. A família Qwen está no centro da estratégia de LLM deles, começando com modelos somente de texto antes de avançar para visão e geração de imagens.
O ramo de geração de imagens da família Qwen mira especificamente a lacuna entre seguir instruções e qualidade visual, duas coisas que historicamente estiveram em tensão. Modelos mais antigos ou seguiam os prompts com precisão e resultavam em imagens sem vida, ou produziam imagens bonitas e ignoravam metade da instrução.
Da linguagem à visão
A arquitetura usa um tokenizador visual que codifica imagens de entrada no mesmo espaço de embeddings dos tokens de texto. Essa é a base técnica da capacidade do Qwen Image de fazer edição baseada em instruções. Quando você diz ao modelo "escureça o fundo e adicione chuva", ele não está executando uma ferramenta de inpainting separada; ele está reinterpretando a cena inteira a partir das instruções atualizadas.
💡 É por isso que o Qwen Image lida melhor com prompts complexos de múltiplos sujeitos do que muitos modelos concorrentes. O componente de modelo de linguagem raciocina ativamente sobre as relações espaciais antes de gerar.
Como o modelo realmente funciona
Em sua essência, o Qwen Image usa um processo de difusão baseado em flow matching sobre uma base de transformer. Aqui está o pipeline simplificado:
- Codificação do texto: seu prompt é tokenizado e incorporado pelo modelo de linguagem Qwen
- Condicionamento visual: se você fornecer uma imagem de referência, ela é codificada em paralelo
- Agendamento de ruído: o modelo inicializa uma representação latente com ruído
- Remoção de ruído iterativa: o transformer refina progressivamente o latente em múltiplas etapas
- Decodificação VAE: o latente final é decodificado em uma imagem de resolução total
Essa arquitetura foi projetada especificamente para seguir instruções em escala. A base de modelo de linguagem concentra uma parcela significativa da contagem total de parâmetros, o que significa que a interpretação do prompt não se degrada à medida que os prompts ficam mais longos ou complexos.
Suporte a entradas multimodais
O design multimodal significa que o Qwen Image aceita entradas que modelos de difusão puros não conseguem processar:
| Tipo de entrada | O que faz |
|---|
| Somente texto | Geração de texto para imagem padrão |
| Texto + imagem de referência | Transferência de estilo ou edição de imagem |
| Texto + máscara | Inpainting de regiões específicas |
| Múltiplas imagens | Fusão composicional |
| Imagem + instrução de edição | Edição baseada em instruções |
Essa variedade de entradas é o que separa o Qwen Image Edit de ser apenas um gerador. Ele é um editor que processa linguagem natural no nível de um colaborador humano capaz.
Variantes de texto para imagem ou de edição de imagem
O modelo base Qwen Image se destaca na geração de texto para imagem, com forte aderência ao prompt. As variantes Qwen Image Edit e Qwen Image Edit Plus estendem isso para fluxos de trabalho completos de edição. A diferença importa se você está escolhendo entre elas:
- Use o modelo base quando estiver gerando do zero ou quando precisar da máxima qualidade visual em um único prompt detalhado
- Use as variantes de edição quando tiver uma imagem de origem que quer modificar, quando precisar trocar objetos ou quando estiver trabalhando de forma iterativa com ciclos de feedback
Qwen Image 2 e 2 Pro
O lançamento do Qwen Image 2 marcou um avanço substancial. A Alibaba não apenas aumentou os parâmetros; ela reconstruiu o pipeline de treinamento em torno de uma curadoria de dados de maior qualidade e de um modelo de recompensa mais sofisticado para alinhar as preferências humanas.
O que mudou na versão 2
As maiores melhorias do Qwen Image 2 em relação ao lançamento original:
- Saídas de maior resolução por padrão, com melhor preservação de detalhes em 1024x1024 e acima
- Decomposição de prompt aprimorada: o modelo agora lida com prompts longos e de múltiplas cláusulas sem deixar de lado sujeitos secundários
- Melhor geração de rostos e mãos, historicamente um ponto fraco dos modelos de difusão
- Inferência mais rápida graças a otimizações arquiteturais na camada de atenção
- Aderência de estilo mais consistente quando recebe imagens de referência
💡 A melhoria apenas na geração de mãos e rostos já faz o Qwen Image 2 valer a pena trocar para retratos e fotografia de estilo de vida, em que sujeitos humanos são o centro.
Pro ou padrão: qual usar
O Qwen Image 2 Pro é a variante maior e de maior fidelidade. Veja quando cada uma faz sentido:
| Modelo | Melhor para | Velocidade de geração |
|---|
| Qwen Image 2 | Iteração rápida, conteúdo para redes sociais, prototipagem | Mais rápido |
| Qwen Image 2 Pro | Resultados finais, trabalhos comerciais, qualidade para impressão | Mais lento |
Para a maioria dos fluxos de trabalho, começar com o Qwen Image 2 para testar prompts e depois mudar para o Pro na renderização final é a abordagem mais eficiente.
Qualidade real das imagens geradas
Os benchmarks contam apenas parte da história. O teste real é como o modelo se sai nos tipos de imagem que as pessoas realmente precisam gerar.
Retratos e pessoas
O Qwen Image produz resultados com qualidade de retrato, com anatomia facial precisa, textura natural da pele e reflexos corretos nos olhos. A base multimodal lhe dá uma compreensão mais sólida das proporções humanas em comparação com modelos de código aberto anteriores, que frequentemente distorciam traços sob prompts de alta complexidade.
Para fotos de moda e de estilo de vida, o modelo lida particularmente bem com a textura das roupas: padrões de trama visíveis no tecido, comportamento natural de caimento e interação precisa da luz com diferentes materiais.
Paisagens e arquitetura
Prompts aéreos e de paisagem são onde o raciocínio espacial forte fica visível. O Qwen Image 2 Pro interpreta corretamente instruções como "vale de montanha com um rio em primeiro plano e nuvens de tempestade ao fundo" como uma cena espacialmente coerente, e não como uma composição achatada de elementos desconectados.
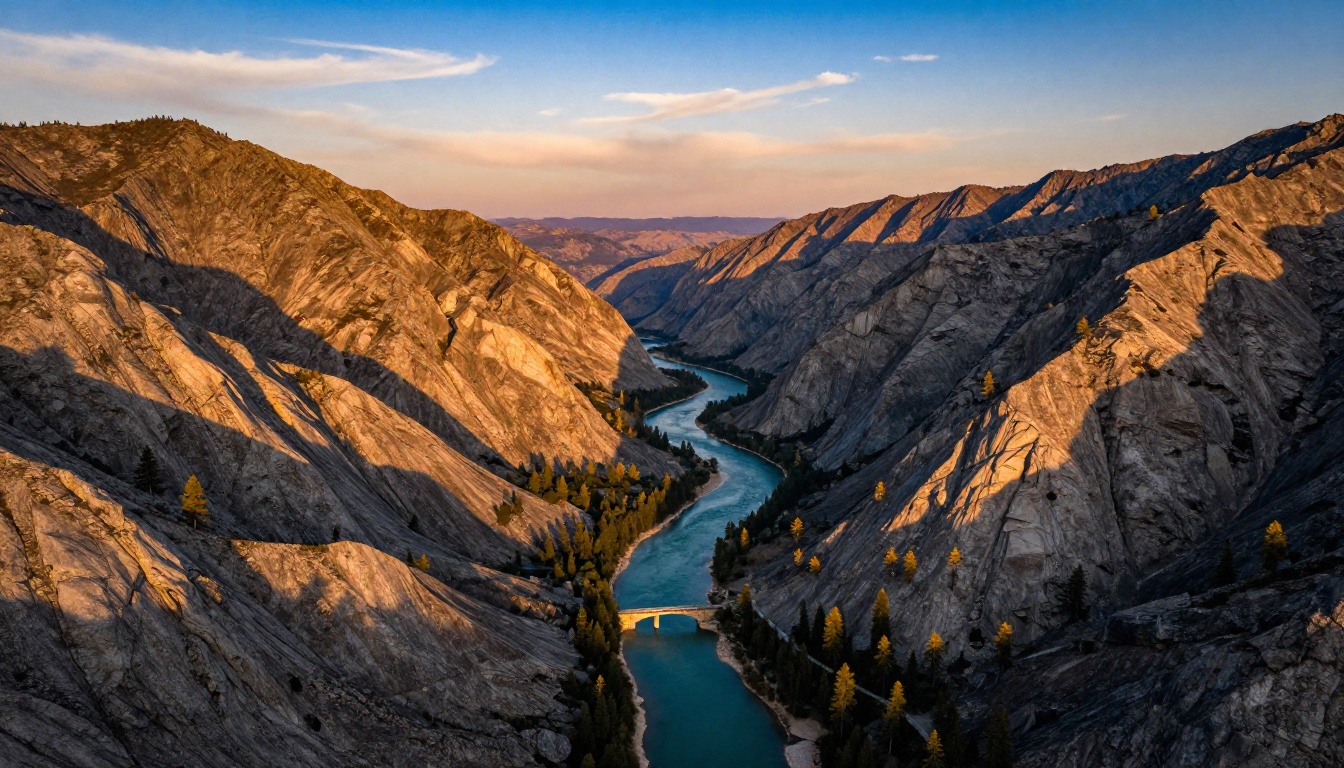
A geração de arquitetura se beneficia do treinamento do modelo com dados visuais estruturados. As linhas de perspectiva são precisas, os reflexos em fachadas de vidro seguem a lógica física e os gradientes de luz sobre as superfícies dos prédios se comportam de forma coerente com a física do mundo real.
Produtos e trabalhos comerciais
Para simulação de fotografia de produto, o Qwen Image Edit Plus é particularmente eficaz. Você pode fornecer uma foto de produto e usar instruções de edição para trocar fundos, ajustar a iluminação ou adicionar elementos de contexto. A qualidade de seguimento de instruções nessa tarefa reduz significativamente os ciclos de iteração em comparação com a composição tradicional.
Como usar o Qwen Image no PicassoIA
O PicassoIA hospeda a família completa de modelos Qwen Image, o que significa que você pode executar o Qwen Image, o Qwen Image 2, o Qwen Image 2 Pro e as variantes de edição, tudo a partir de uma única aba do navegador, sem configuração, sem chaves de API e sem infraestrutura para gerenciar.
Passo a passo no PicassoIA
Passo 1: escolha seu modelo
Acesse o Qwen Image 2 Pro para os resultados de maior qualidade, ou o Qwen Image 2 para iteração mais rápida. Para fluxos de edição, abra o Qwen Image Edit Plus.
Passo 2: escreva seu prompt com detalhes
O Qwen Image responde bem a prompts detalhados, porque a base de modelo de linguagem consegue interpretar instruções complexas com várias cláusulas. Inclua:
- Sujeito: idade, roupa, expressão, pose
- Ambiente: interior ou exterior, hora do dia, clima
- Iluminação: direção, qualidade, temperatura de cor
- Perspectiva da câmera: plano aberto, close-up, aérea, ângulo baixo
Passo 3: defina a proporção
Para conteúdo de sites e blogs, a proporção 16:9 funciona bem na maioria dos layouts. Conteúdo em retrato (9:16) combina com redes sociais. O quadrado (1:1) é limpo para fotos de produto e miniaturas.
Passo 4: gere e itere
Faça uma primeira geração para avaliar a interpretação do prompt e depois refine. Se um sujeito secundário estiver sendo deixado de lado, mova-o para mais perto do início do prompt. Se as cores estiverem erradas, seja mais explícito com os adjetivos ("terracota empoeirado" em vez de "laranja").
Passo 5: refine com as variantes de edição
Se a geração base estiver próxima, mas precisar de mudanças pontuais, envie-a para o Qwen Image Edit Plus e forneça uma instrução de edição em linguagem simples. O modelo entende frases naturais como "deixe o fundo mais quente" ou "troque a jaqueta por um casaco".
Dicas para melhores resultados
💡 O Qwen Image responde melhor a descrições de câmera e iluminação do que a maioria dos modelos de código aberto. Incluir "85mm f/1.8, octabox de estúdio, ISO 200" no seu prompt, mesmo para sujeitos não fotográficos, ajuda o modelo a calibrar o realismo.
- Evite apenas adjetivos abstratos: "bonito" não dá nada ao modelo; "luz de contraluz quente da hora dourada sobre pele bronzeada" dá a ele uma direção
- Cite estilos fotográficos reais: "fotografado como uma matéria da Condé Nast Traveler dos anos 1990" ou "estilo documentário da National Geographic" são referências estilísticas fortes
- Use o treinador de LoRA para personagens consistentes: o Qwen Image LoRA Trainer permite fazer fine-tuning com conjuntos de imagens próprios para estéticas repetíveis de personagens ou marcas
- Faça variações em lote: rode de 3 a 4 seeds antes de mudar o prompt. O modelo tem variância suficiente para que seeds diferentes muitas vezes produzam composições bem distintas
Vale ser direto sobre onde o Qwen Image se posiciona em relação às alternativas que você provavelmente já usou.
| Modelo | Seguimento de prompt | Realismo | Edição | Pesos abertos |
|---|
| Qwen Image 2 Pro | Excelente | Muito alto | Multimodal nativa | Sim |
| Midjourney v6 | Bom | Muito alto | Somente remix | Não |
| DALL-E 3 | Excelente | Alto | Inpainting limitado | Não |
| Stable Diffusion XL | Moderado | Alto | Via plugins | Sim |
| Flux 1.1 Pro | Muito bom | Muito alto | Sem edição nativa | Parcialmente |
A principal diferença é a edição multimodal nativa. O Midjourney tem opções de remix, o DALL-E tem uma interface de inpainting, mas nenhum dos dois se iguala ao Qwen Image Edit Plus em edições complexas, nas quais você quer modificar elementos específicos preservando tudo o mais no quadro.
Os pesos abertos também importam na prática. Os modelos Qwen Image são lançados com pesos disponíveis para uso em pesquisa, o que significa que o ecossistema de variantes ajustadas, adaptadores LoRA e pipelines especializados cresce pela contribuição da comunidade, e não apenas pelos lançamentos da própria Alibaba.
Por que os pesos abertos importam para este modelo
A Alibaba liberar os pesos do modelo não é apenas uma jogada de posicionamento. Isso acelera o desenvolvimento de variantes especializadas que nenhuma empresa poderia construir sozinha. O Qwen Image LoRA Trainer no PicassoIA é um resultado direto disso, dando aos usuários a capacidade de fazer fine-tuning do modelo base em estéticas, personagens ou tipos de produto específicos sem mexer em infraestrutura.
Checkpoints ajustados aparecem regularmente na comunidade de código aberto, cobrindo estilos fotográficos específicos, estéticas culturais e aplicações para setores em que o modelo base não se especializa. Isso multiplica o valor do modelo com o tempo de um jeito que modelos proprietários e fechados não conseguem igualar.
Para usuários comerciais, os pesos abertos reduzem a dependência de um fornecedor. Você não está apostando seu pipeline em uma única API que continue disponível e com preço acessível. O Qwen Image pode ser hospedado por conta própria, adaptado e estendido de forma independente.
💡 A combinação de desempenho base forte com pesos abertos é exatamente o que torna esta série de modelos digna de ser usada como base. Cada lançamento da Alibaba eleva o teto do que é possível sem infraestrutura proprietária.
Cada imagem deste artigo foi gerada com modelos de IA fotorrealistas disponíveis no PicassoIA. A tecnologia está pronta para produção, e a barreira de entrada é menor do que nunca.
O PicassoIA oferece acesso direto pelo navegador ao Qwen Image, ao Qwen Image 2, ao Qwen Image 2 Pro, ao Qwen Image Edit Plus e ao LoRA Trainer, tudo sem gerenciar infraestrutura ou tokens de API.
Escolha um sujeito, escreva um prompt detalhado e rode sua primeira geração. A distância entre o que você consegue imaginar e o que realmente consegue produzir nunca foi tão pequena. O Qwen Image 2 Pro está esperando.


