Vous avez un script, un visage et pas le temps de tourner. Il y a dix ans, cela voulait dire engager une équipe ou enregistrer prise après prise jusqu’à ne plus grimacer en entendant votre propre voix. Aujourd’hui, un générateur de têtes parlantes prend une photo fixe et une piste audio, puis renvoie une vidéo de cette personne qui parle, avec lèvres, mâchoire, clignements et petits mouvements de tête parfaitement synchronisés. Les meilleurs sont gratuits à essayer, fonctionnent dans un navigateur et se terminent en quelques minutes.
Cet article détaille le fonctionnement de ces outils, ce que vous obtenez réellement avec un « créateur en ligne gratuit », comment choisir une voix IA qui ne ressemble pas à un GPS, et à quoi ressemble une synchronisation labiale réaliste selon les situations. Vous trouverez aussi un flux de travail pas à pas que vous pouvez suivre dès aujourd’hui sur PicassoIA.
Ce que fait un générateur de têtes parlantes
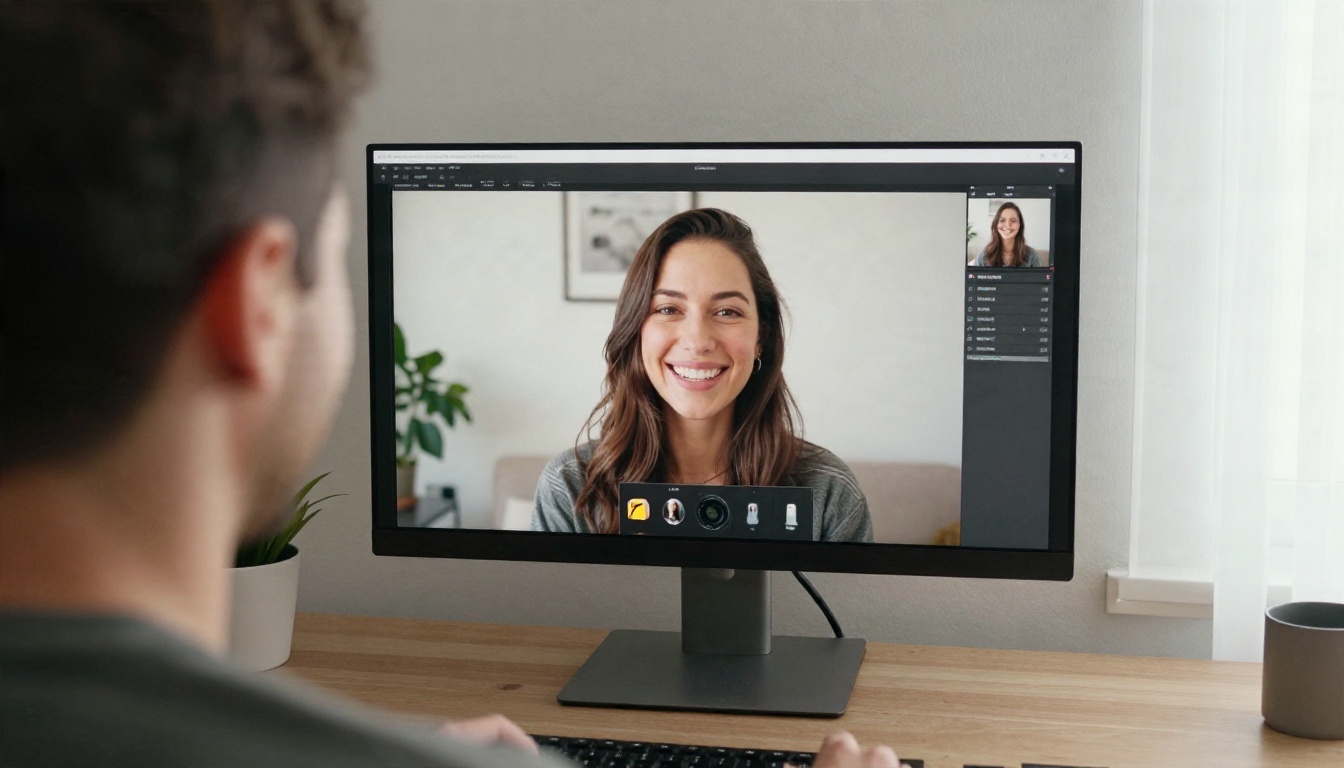
Une photo en entrée, une vidéo qui parle en sortie
Un générateur de têtes parlantes est un modèle de synchronisation labiale enveloppé dans une interface simple. Vous lui donnez deux entrées : une image de visage (ou parfois une courte vidéo) et un fichier audio. Le modèle prédit comment la bouche, les joues, les sourcils et la tête doivent bouger pour chaque fraction de seconde de cet audio, puis il génère les images.
Les premières versions ne faisaient bouger que les lèvres et laissaient le reste du visage figé, ce qui leur donnait un air de masque. Les modèles actuels, comme Omni Human 1.5 et Fabric 1.0, animent tout le haut du corps. Vous obtenez des clignements, des décalages d’épaules, parfois des gestes de la main, et un rythme naturel qui suit l’émotion de la voix.
💡 Distinction rapide : les outils photo vers vidéo créent du mouvement à partir d’une image fixe. Les outils de synchronisation labiale vidéo prennent une séquence existante et ne réécrivent que la zone de la bouche. Les deux sont appelés outils de « tête parlante » en ligne, mais ils résolvent des problèmes différents.
Pourquoi ce format fonctionne
Le format « tête parlante » a survécu à tous les changements de plateformes pour une raison simple : les gens font confiance aux visages. Une personne qui regarde la caméra et parle retient l’attention plus longtemps qu’un diaporama commenté, et il coûte bien moins cher qu’un tournage complet.
Les usages sont pratiques plutôt que spectaculaires :
- Vidéos de formation et d’intégration qui doivent être mises à jour chaque trimestre
- Vidéos explicatives de produits en plusieurs langues sans nouveau tournage
- Clips pour les réseaux sociaux réalisés par un créateur qui préfère ne pas apparaître à l’écran
- Prospection commerciale avec une présentation personnelle qui n’a jamais été réellement enregistrée
- Leçons de cours pour lesquelles l’instructeur n’enregistre que l’audio
Comparatif des créateurs en ligne gratuits
Ce que « gratuit » veut vraiment dire
La plupart des sites qui annoncent un créateur de têtes parlantes gratuit vous offrent un aperçu, pas un flux de travail complet. Les limites typiques comprennent un filigrane sur toute l’image, une durée de clip de 10 à 30 secondes, une faible résolution ou un plafond quotidien de générations. Certains demandent une carte bancaire avant le premier rendu. Rien de tout cela n’est une arnaque, mais cela compte lorsque vous construisez un projet concret.
PicassoIA adopte une approche différente. Vous pouvez essayer directement les modèles de synchronisation labiale et d’avatars, choisir celui qui convient à votre séquence et voir le résultat avant de décider de la quantité à produire. Comme tout se trouve au même endroit, vous pouvez aussi générer le portrait, la voix et la vidéo sans passer d’un onglet à l’autre.
Comparaison des modèles en un coup d’œil
Voici en pratique ce qui distingue les principaux modèles de synchronisation labiale et d’avatars disponibles sur PicassoIA :
| Modèle | Entrée | Idéal pour | Remarques |
|---|
| Omni Human 1.5 | Photo + audio | Mouvements expressifs du haut du corps | Large éventail émotionnel, gestes naturels |
| Omni Human | Photo + audio | Portraits parlants rapides | Fiable sur des photos de face et nettes |
| Fabric 1.0 | Photo + audio | Faire parler n’importe quelle photo | Gère aussi les illustrations et les mascottes |
| P Video Avatar | Photo + audio | Clips d’avatar rapides | Bien adapté aux courtes vidéos sociales |
| Lipsync 2 Pro | Vidéo + audio | Remplacement de bouche de qualité studio | Préserve les dents et les détails du visage |
| Lipsync 2 | Vidéo + audio | Doublage au quotidien | Bon équilibre entre vitesse et qualité |
| Kling Lip Sync | Vidéo + audio | Synchroniser les bouches dans des clips générés | S’associe bien aux séquences créées par IA |
| React 1 | Vidéo + audio | Montages attentifs à l’interprétation | Ajuste l’expression en même temps que les lèvres |
Ce qu’il faut vérifier avant de choisir
Avant de vous engager sur un outil, faites passer la même photo et les mêmes dix secondes d’audio dans deux ou trois modèles. Comparez ces points :
- Dents et langue. Les modèles bon marché les rendent floues. Les bons conservent des contours nets.
- Rythme des clignements. Un locuteur qui ne cligne jamais, ou qui cligne toutes les secondes, paraît bizarre.
- Dérive de la tête. Le visage doit rester dans le cadre sans glisser ni se déformer lentement.
- Correspondance audio sur les sons durs. Surveillez les sons « p », « b » et « m », où les lèvres doivent se fermer complètement.
- Limites de durée des clips. Certains modèles plafonnent à 15 secondes, d’autres gèrent plusieurs minutes.
Choisir une voix IA adaptée
Les options de synthèse vocale
La voix contribue davantage à la crédibilité que les images. Un visage parfait avec une voix plate et robotique paraît étrange en trois secondes. Heureusement, les modèles actuels de synthèse vocale sont bien meilleurs que les voix dont on se souvient d’il y a quelques années.
Sur PicassoIA, vous pouvez choisir parmi plusieurs familles, toutes accessibles ici :
💡 Astuce : écrivez votre script pour l’oreille, pas pour l’œil. Phrases courtes, contractions et une virgule là où vous reprendriez naturellement votre souffle. Lisez-le à voix haute une fois avant de générer.
Voix enregistrée ou voix de synthèse
Vous n’êtes pas obligé d’utiliser une voix de synthèse. Si vous enregistrez votre propre audio avec un téléphone dans une pièce calme, le modèle de synchronisation labiale le suivra tout aussi bien. Beaucoup de créateurs combinent les deux : ils enregistrent le message principal et génèrent des versions dans d’autres langues avec des voix IA.
| Source de la voix | Atout | Faiblesse |
|---|
| Votre propre enregistrement | Authentique, personnel | Demande une pièce calme et des reprises en cas d’erreur |
| Synthèse vocale par IA | Montages rapides, toutes les langues | Demande un script soigné pour un rythme naturel |
| Hybride | Le meilleur des deux | Deux flux de travail à gérer |
Exemples de synchronisation labiale par usage
À quoi ressemble réellement une « bonne » synchronisation labiale ? C’est plus facile à juger en contexte. Voici donc les situations où ces outils de têtes parlantes sont vraiment utiles.
Formation et enseignement
Un formateur enregistre une leçon une seule fois, puis doit corriger une phrase après un changement de politique. Au lieu de refaire le tournage, il régénère cette phrase en audio, la fait passer dans un modèle de synchronisation labiale vidéo comme Lipsync 2 Pro, et insère le clip dans la timeline. Le visage, l’arrière-plan et l’éclairage restent identiques, car seule la zone de la bouche est réécrite.
Ce qu’il faut observer dans ce type de résultat : un regard stable vers la caméra, pas de tremblement autour de la mâchoire, et des dents identiques avant et après le montage.
Clips marketing et produits
Un fondateur veut une introduction de 20 secondes pour une campagne par e-mail, mais n’aime pas être filmé. Il génère un portrait net, rédige un court script, choisit une voix chaleureuse et produit le clip avec P Video Avatar ou Omni Human 1.5.
Les scripts courts et précis fonctionnent le mieux ici. Un seul message, un seul appel à l’action, et une pause à la fin pour que la dernière image ne coupe pas en plein souffle.
Doublage dans d’autres langues
C’est là que la synchronisation labiale devient un vrai gain de temps. Vous prenez une présentation enregistrée et produisez des versions pour de nouveaux marchés. Video Translate gère le doublage dans plus de 150 langues, tandis que Lipsync Precision et Lipsync Speed vous permettent de choisir entre fidélité maximale et délai de livraison court.
💡 Surveillez la durée : certaines langues demandent plus de syllabes que l’anglais pour exprimer la même idée. Si votre audio traduit dure 30 % de plus que l’original, raccourcissez le script plutôt que d’accélérer la voix.
Voici un flux de travail qui prend environ dix minutes, de la page blanche au clip final.
Étape 1 : préparer votre portrait
Utilisez une photo nette, de face, avec un éclairage uniforme et une bouche neutre ou légèrement entrouverte. Évitez les lunettes de soleil, les mains qui cachent le menton et les fortes ombres sur le visage. Si vous n’avez pas de bonne photo, générez-en une avec Seedream 4.5 ou Nano Banana Pro. Un prompt comme « portrait photoréaliste d’une femme amicale dans la trentaine, lumière douce de fenêtre, arrière-plan neutre, regard vers la caméra » donne de bons résultats.
Étape 2 : rédiger et générer la voix
Gardez le script sous 150 mots pour un premier test. Collez-le dans un modèle de synthèse vocale comme ElevenLabs v3 ou Speech 2.8 HD, choisissez une voix qui correspond au visage, puis téléchargez l’audio. Écoutez-le une fois au casque pour repérer les prononciations bizarres.
Étape 3 : lancer le modèle de synchronisation labiale
Ouvrez Omni Human 1.5, importez le portrait, importez l’audio, puis soumettez. Si votre photo est une illustration, une mascotte ou un personnage stylisé, essayez plutôt Fabric 1.0.
Étape 4 : relire et affiner
Regardez le résultat en plein écran, son activé. Vérifiez les deux premières secondes, car c’est là que la plupart des problèmes apparaissent. Si quelque chose semble décalé, modifiez une seule variable à la fois : la photo, la voix ou le modèle. Si vous changez les trois en même temps, il devient impossible de savoir ce qui a aidé.
💡 Raccourci : si vous voulez générer la parole et l’image ensemble, Veo 3.1 Fast crée une vidéo avec audio natif à partir d’un prompt texte, ce qui convient aux scènes où une personne parle dans un décor plutôt que directement à la caméra.
Résoudre les problèmes courants
Bouche raide et visage figé
Si la bouche bouge mais que le reste du visage paraît bloqué, la photo source est généralement en cause. Les photos avec un sourire forcé et tendu, ou une bouche fermée, donnent peu de matière au modèle. Choisissez une photo avec une expression détendue et les lèvres légèrement entrouvertes.
Décalage entre voix et visage
Une voix grave et rauque sur un visage jeune paraît fausse, même si la synchronisation est parfaite. Faites correspondre l’âge, l’énergie et l’accent à la personne à l’écran. Si vous utilisez un personnage illustré ou stylisé, une voix un peu plus enjouée fonctionne mieux qu’un ton de présentateur lissé.
Tableau de dépannage rapide
| Problème | Cause probable | Solution |
|---|
| La bouche se désynchronise | L’audio commence par un long silence | Couper le silence initial |
| Les dents paraissent floues | Source de faible résolution | Upscaler d’abord la photo |
| Le visage se déforme en cours de clip | Tête trop tournée sur la photo | Utiliser un portrait de face |
| La voix sonne plate | Le script se lit comme un texte | Réécrire avec des phrases courtes et orales |
| La sortie paraît floue | Image source de faible qualité | Partir d’une photo nette et bien éclairée |
Une note sur le consentement
N’animez que les visages que vous avez le droit d’utiliser. Il peut s’agir de votre propre photo, d’un modèle de banque d’images sous licence, d’un personnage que vous avez créé ou d’une personne qui a donné son accord. Signaler clairement une vidéo générée par IA protège aussi la confiance de votre audience, et les plateformes l’exigent de plus en plus.
Prêt à créer la vôtre ?
Vous n’avez besoin ni de studio, ni d’équipe de tournage, ni de prise parfaite. Il vous faut une bonne photo, un script qui sonne comme une personne qui parle, et un modèle adapté à votre séquence. Commencez par un test court de dix secondes, comparez deux modèles côte à côte, puis passez seulement ensuite aux vidéos de pleine longueur.
Ouvrez PicassoIA, générez un portrait, choisissez une voix et lancez dès aujourd’hui votre premier clip de tête parlante. Essayez-le avec votre propre visage, un personnage que vous avez inventé ou une mascotte de produit, et voyez à quelle vitesse une page blanche devient une vidéo qui parle.


