La vidéo est apparue dans un groupe de discussion. Aucune source, aucun contexte, juste un court extrait d’une femme qui parle face caméra dans un appartement baigné de soleil. Trente secondes. Un éclairage naturel, une légère secousse de caméra, le genre de séquence que l’on tourne avec un téléphone. Seize personnes étaient dans ce groupe, dont trois journalistes en activité et un réalisateur de documentaires. Aucune n’a signalé la vidéo comme synthétique. Parce qu’elle ne l’était pas. Ou l’était-elle ?
Cette question n’est plus rhétorique. La vidéo IA qui a trompé même les experts n’est pas une hypothèse. Cela se produit à grande échelle, maintenant, avec des outils accessibles au grand public qui ne demandent aucune formation technique et coûtent moins cher qu’un abonnement mensuel à une plateforme de streaming. La frontière perceptive entre vidéo réelle et vidéo synthétique a été franchie, et la plupart des gens ne l’ont jamais vu se produire.
Quand plus personne ne pouvait faire la différence
Le point de bascule n’est pas arrivé avec une percée unique. Il s’est produit progressivement, puis soudainement. Encore en 2022, les vidéos générées par IA avaient des défauts évidents : dents déformées, arrière-plans qui scintillent, regard qui ne suit jamais vraiment correctement. En 2024, ces artefacts avaient presque disparu. En 2025, les meilleurs modèles produisaient des séquences qui passaient tous les tests heuristiques sur lesquels les professionnels s’appuyaient depuis des années.
Dans des études documentées, des analystes en criminalistique des médias formés ont identifié correctement des vidéos générées par IA à des taux à peine supérieurs au hasard lorsqu’ils visionnaient des clips de moins de 10 secondes. Ce n’est pas de l’incompétence de leur part. C’est une technologie qui a réellement franchi un seuil perceptif. Les signaux que les humains ont développés pour détecter la tromperie, les micro-expressions, les incohérences d’éclairage, les erreurs de physique, ont été systématiquement appris et corrigés par des réseaux de neurones entraînés sur des milliards d’heures de séquences réelles.
La ligne de Turing pour la vidéo
Alan Turing a proposé qu’une machine soit considérée comme intelligente lorsqu’un humain ne pourrait pas la distinguer d’un autre humain dans une conversation. La vidéo a franchi sa propre version de cette ligne. Plusieurs études indépendantes menées en 2024 et 2025 ont montré que la précision de détection humaine pour de courts clips vidéo générés par IA tombait à 54 %, soit pratiquement un pile ou face. Les machines ont gagné.
Ce qui a fait la différence en 2025
Trois éléments ont convergé :
- Échelle des données d’entraînement : les modèles s’entraînent désormais sur des séquences mesurées en pétaoctets, et non plus en téraoctets
- Cohérence temporelle : le problème le plus difficile de la vidéo IA, garder les sujets, la lumière et la physique cohérents d’une image à l’autre, a été en grande partie résolu
- Affinement par diffusion : la réduction itérative du bruit appliquée aux images vidéo a éliminé les signatures d’artefacts que les outils de criminalistique avaient été réglés pour détecter
Quand ces trois avancées se sont combinées dans une même génération de modèles, le saut de qualité a été discontinu. Pas progressif. Un saut brutal.
Ce que font réellement les modèles
Pour comprendre pourquoi ces séquences sont si convaincantes, il faut avoir une idée de base du fonctionnement de ces systèmes. Les modèles de texte vers vidéo n’enregistrent pas et n’échantillonnent pas de vraies séquences. Ils synthétisent chaque pixel, chaque image, à partir d’un modèle statistique appris de ce à quoi ressemble la réalité.
Des modèles comme Kling v3 Video et Veo 3 fonctionnent selon ce que les chercheurs appellent la diffusion dans l’espace latent, un processus où le bruit est retiré de manière systématique jusqu’à ce qu’une vidéo cohérente et très fidèle apparaisse et corresponde au prompt saisi. Le modèle ne récupère pas de séquences. Il les construit à partir de distributions de probabilité apprises pendant l’entraînement.
Pourquoi la physique fonctionne désormais
Les modèles antérieurs échouaient sur la physique parce qu’ils apprenaient des corrélations sans causalité. Ils savaient que les ombres apparaissent généralement sous les objets, mais ne modélisaient pas les sources lumineuses avec une cohérence directionnelle. Les architectures récentes, notamment celles dotées de mécanismes d’attention explicitement sensibles à la 3D, modélisent les scènes à l’aide de représentations spatiales implicites. Quand la caméra bouge, les ombres bougent correctement. Quand un objet passe derrière un autre, l’occlusion est gérée naturellement.
C’est pourquoi Sora 2 Pro peut générer une séquence d’un verre d’eau tombant d’une table avec un comportement du liquide physiquement exact. Le modèle n’a pas consulté « comment tombe l’eau ». Il a intériorisé la physique en observant des millions de cas réels.
Le bond en résolution
La résolution compte énormément pour la détection. En 480p, même des yeux bien entraînés peuvent parfois repérer des artefacts de compression des textures. En 1080p avec un flou de bougé correct, la tâche devient nettement plus difficile. Hailuo 02 génère nativement en 1080p. C’est aussi le cas de Seedance 1.5 Pro. Quand une image est rendue à la résolution de la télévision diffusée, avec un étalonnage des couleurs correct, le cerveau du spectateur cesse de chercher activement des problèmes et se met à accepter passivement ce qu’il voit.
Le phénomène viral auquel personne ne s’attendait
Les vidéos qui deviennent virales sont rarement celles qui sont techniquement les plus impressionnantes. Ce sont plutôt celles qui touchent émotionnellement. La voix d’un grand-père recréée. Une célébrité dans un scénario qui paraît plausible. Un extrait d’information avec juste assez de bruit ambiant pour sembler authentique.
Ce qui a changé en 2025, c’est que la qualité de base de la vidéo IA a franchi le seuil du « assez bien pour être partagé » pour les utilisateurs occasionnels des réseaux sociaux. Il n’est pas nécessaire de générer une perfection photoréaliste pour tromper quelqu’un qui fait défiler son fil à 1,5 fois la vitesse normale. Il suffit d’un rendu qui ne déclenche pas immédiatement une réaction du type « quelque chose cloche ». Les modèles y sont parvenus il y a des mois. Ils n’ont cessé de s’améliorer depuis.
Comment le partage amplifie tout
Chaque fois qu’une vidéo synthétique est partagée sans examen, elle habitue les personnes qui l’entourent à accepter ce type de contenu comme réel. L’exposition répétée à la vidéo IA, même lorsqu’elle est finalement identifiée comme synthétique, élève le seuil de tolérance aux artefacts. C’est un cliquet, qui ne se déplace que dans un sens.
L’effet cumulatif : les études sur la désinformation montrent que, même lorsque les gens apprennent qu’un contenu était faux, un effet d’influence persistante subsiste. Le fait de voir et de partager compte davantage que la correction qui arrive ensuite.
Le facteur vitesse
Avec les outils actuels, une vidéo peut être générée, affinée et publiée en moins de trois minutes. Une vérification sérieuse prend des heures. C’est dans cet écart que prospèrent les médias synthétiques. Ce n’est pas que la vérification soit impossible. C’est qu’elle ne peut pas suivre la vitesse du partage.
Pourquoi les experts se sont trompés
Les experts qui ont échoué ne manquaient pas de compétence. Ils utilisaient une expertise calibrée pour un problème plus ancien.
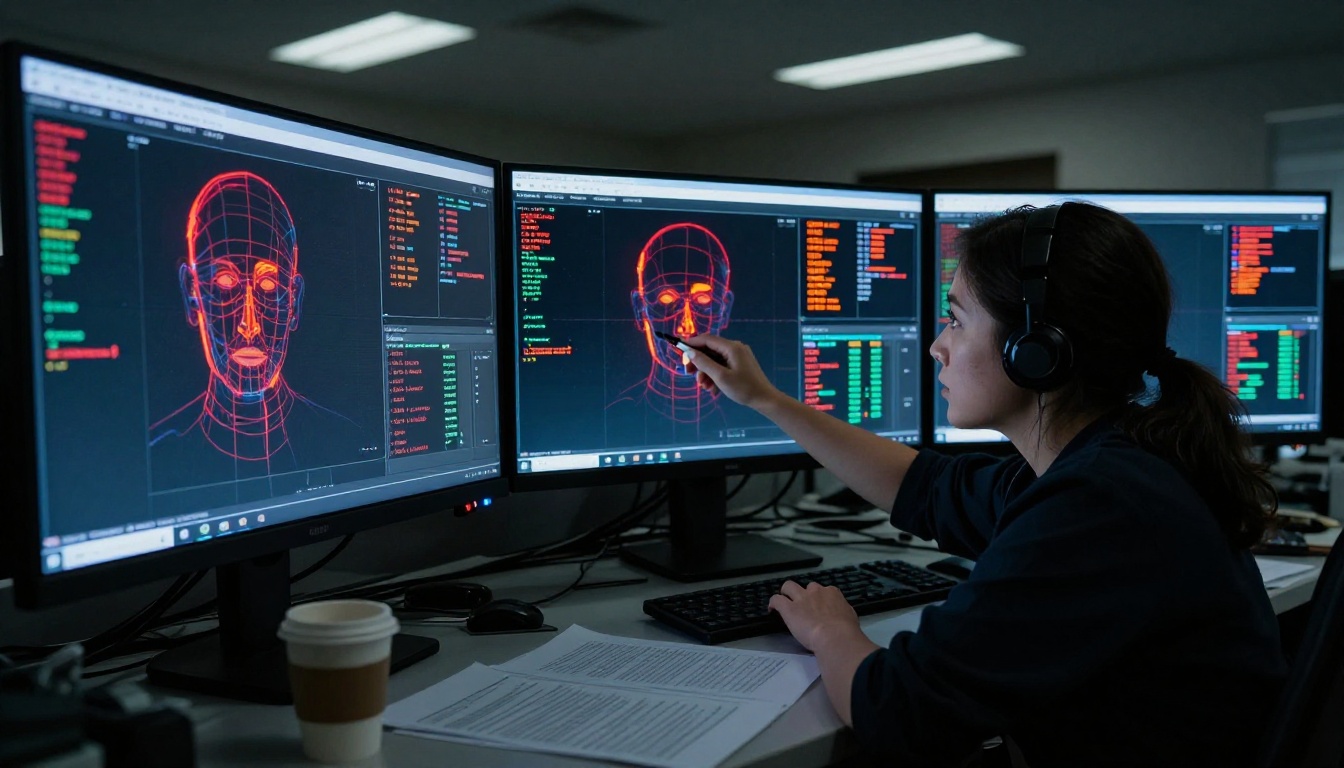
La plupart des formations professionnelles en criminalistique vidéo portent sur les artefacts de compression, les signatures de clonage et les incohérences de métadonnées, toutes des signatures du montage vidéo traditionnel et des deepfakes antérieurs basés sur les GAN. Les modèles vidéo fondés sur la diffusion laissent des signatures fondamentalement différentes, ou, dans certains cas, presque aucune. Les experts cherchaient les empreintes d’un autre type de crime.
Ce qu’ils vérifiaient
| Méthode de détection | Efficace contre les anciens deepfakes | Efficace contre les nouveaux modèles |
|---|
| Inspection des métadonnées | Oui | Partiellement |
| Analyse des artefacts de compression | Oui | Non |
| Analyse du rythme des clignements d’yeux | Oui | Non |
| Fusion des contours du visage | Oui | Non |
| Analyse des fréquences spectrales | Partiellement | Partiellement |
| Test de cohérence temporelle | Non | Non |
La tendance est claire. L’ancien arsenal est en grande partie obsolète pour les modèles de la génération actuelle. De nouveaux outils de détection sont en cours de développement, mais les meilleurs systèmes disponibles aujourd’hui affichent encore des taux de précision qui ne tiendraient pas devant un tribunal.
L’échec de la calibration
Il y a aussi une dimension psychologique. Les experts qui ont rarement vu une vidéo IA qui les a réellement trompés ont tendance à être trop confiants. Le modèle mental selon lequel « la vidéo IA a un aspect bien précis » devient un facteur de risque dès que la technologie franchit certains seuils. La calibration exige d’être confronté à des cas d’échec, et jusqu’à récemment, il n’existait pas assez de cas d’échec convaincants pour recalibrer les détecteurs.
Ce n’est pas un problème entièrement résolu, mais il existe des signaux qui méritent d’être vérifiés avant de partager.
Vérifiez d’abord l’arrière-plan : les modèles d’IA génèrent souvent des sujets de premier plan convaincants, mais perdent la cohérence spatiale de l’arrière-plan lors de mouvements de caméra rapides. Surveillez les murs qui respirent ou les meubles qui changent subtilement de position.
Cinq points à surveiller
- Bijoux et accessoires : les boucles d’oreilles, les bagues, les montres et les colliers restent difficiles à rendre de façon constante par l’IA lors des mouvements. Ils traversent souvent la peau ou changent légèrement de forme d’une image à l’autre.
- Géométrie des mains : les doigts sont notoirement difficiles. Comptez-les lorsque les mains sont clairement visibles dans le cadre.
- Texte dans l’environnement : panneaux de signalisation, étiquettes, textes sur les vêtements. Les modèles d’IA peinent à rendre un texte lisible et stable. Il se déforme ou se brouille souvent lorsqu’on l’examine de près.
- La règle des 8 secondes : la plupart des artefacts de la vidéo IA s’accumulent avec le temps. Regardez huit secondes complètes avant de vous faire un avis sur un clip.
- Cohérence du contexte : le lieu paraît-il géographiquement cohérent tout au long du clip ? Les arrière-plans de la vidéo IA intègrent parfois des éléments issus de combinaisons géographiquement impossibles.
Ce que peuvent faire les logiciels
Des outils de détection comme Hive Moderation, Reality Defender et Sensity AI développent activement des flux de détection en temps réel. Aucun n’est proche de la perfection. Les chercheurs les plus honnêtes du domaine estiment que la précision de détection sur les vidéos IA de qualité grand public se situe autour de 75 à 85 %, ce qui paraît élevé jusqu’à ce qu’on prenne en compte le volume de contenus générés chaque jour.
Les modèles derrière la révolution
Comprendre les modèles spécifiques à l’origine de ce changement est utile, à la fois pour le contexte et pour l’usage concret.
Les modèles disponibles aujourd’hui offrent des capacités qui auraient exigé un budget de production hollywoodien encore en 2022. Le paysage actuel de la génération de vidéos accessibles par texte est remarquable :
| Modèle | Résolution | Atout principal |
|---|
| Kling v3 Video | 1080p | Qualité de mouvement cinématographique |
| Veo 3 | 1080p | Audio natif, photoréalisme |
| Sora 2 Pro | HD | Précision physique, clips longs |
| Hailuo 02 | 1080p | Rapidité avec une sortie de haute qualité |
| Seedance 1.5 Pro | 1080p | Synchronisation texte et audio |
| Wan 2.7 T2V | 1080p | Poids ouverts, très contrôlable |
| Pixverse v5 | 1080p | Génération rapide, esthétique marquée |
| LTX 2 Pro | 4K | Résolution la plus élevée disponible |
| Gen 4.5 | HD | Mouvement cinématographique, rendu professionnel |
Chacun représente une approche distincte de la synthèse vidéo, avec des forces différentes en matière de respect du prompt, de fluidité du mouvement et de qualité photoréaliste.
Le problème de l’audio dont personne ne parle
La vision a attiré l’essentiel de l’attention du public, mais l’audio est tout aussi important et tout aussi résolu. Des modèles comme Veo 3 et Seedance 1.5 Pro génèrent désormais un son d’ambiance synchronisé avec le contenu visuel. Quand une porte s’ouvre, vous entendez une porte. Quand quelqu’un parle, l’acoustique de la pièce correspond à l’espace montré à l’image. La synchronisation audio était l’un des derniers indices fiables. Elle ne l’est plus.
Ce que cela change dès maintenant
Les conséquences se propagent dans tous les secteurs plus vite que la plupart des organisations ne sont prêtes à le gérer.
Pour le journalisme : la vidéo n’est plus intrinsèquement plus crédible que le texte. Chaque séquence exige désormais une vérification de sa provenance avant publication. La norme professionnelle évolue vers l’exigence de séquences certifiées C2PA ou d’une vérification directe auprès de la source pour toute vidéo utilisée comme preuve d’événements réels.
Pour les procédures judiciaires : les tribunaux commencent à se confronter aux preuves vidéo d’une manière qu’ils n’avaient pas eu à affronter depuis la généralisation de la photographie. Une vidéo montrant une personne commettre un acte ne peut pas, à elle seule, être considérée comme une preuve concluante sans une chaîne de provenance corroborée.
Pour la création de contenus : les mêmes modèles qui produisent de la désinformation synthétique créent aussi de l’art, du divertissement, de la publicité et du contenu pédagogique légitimes. Chaque maison de production disposant d’un budget vidéo évalue activement la part de ce budget qui peut être réorientée vers la génération par IA.
Le contrat social autour de la vidéo
Pendant des décennies, « voir, c’est croire » a été une heuristique raisonnable. Elle était fausse bien avant la vidéo IA, compte tenu de l’histoire du montage cinématographique et du cadrage sélectif, mais elle était fonctionnelle. Les gens faisaient largement plus confiance à la vidéo qu’au texte parce qu’elle paraissait plus difficile à fabriquer. Cette asymétrie s’est effondrée.
Ce que cela exige maintenant : la responsabilité de la vérification passe du spectateur, qui n’a pas les outils, à l’éditeur et aux plateformes. Les plateformes qui continuent de diffuser des vidéos non vérifiées, sans signaux de provenance, font au minimum preuve de négligence.
Trois secteurs déjà touchés
- Politique : des vidéos de campagne synthétiques sont déjà apparues dans plusieurs pays. Les taux de détection au moment de la première publication sont souvent proches de zéro.
- Finance : des appels vidéo deepfake usurpant l’identité de dirigeants ont donné lieu à des cas documentés de fraude par virement, dont des incidents largement relayés impliquant des transferts supérieurs à 20 millions de dollars.
- Divertissement : les studios négocient activement les droits à l’image liés à l’IA, car les modèles peuvent désormais reproduire de façon crédible les prestations d’acteurs réels à partir d’un matériau de référence minimal.
Vos questions, nos réponses
Peut-on filigraner la vidéo IA ?
Oui, techniquement. SynthID de Google intègre des filigranes imperceptibles qui résistent à la plupart des opérations de montage. Le problème, c’est que le filigrane est facultatif et n’est pas adopté de façon universelle. Les modèles à poids ouverts peuvent être déployés sans aucune infrastructure de filigrane.
Les outils de détection vont-ils rattraper leur retard ?
Les outils de détection s’améliorent, mais la dynamique entre attaque et défense dans ce domaine favorise nettement les générateurs. Chaque fois qu’une signature de détection devient largement connue, l’entraînement du modèle peut être ajusté pour ne plus la produire. La détection est une discipline réactive, dans un monde où la génération est proactive et plus rapide.
La création de ce type de contenu est-elle illégale ?
Certaines utilisations précises des vidéos deepfake non consenties sont illégales dans plusieurs juridictions, notamment au Royaume-Uni, dans certaines parties des États-Unis et en Australie. La création de vidéos synthétiques en elle-même n’est pas réglementée de façon générale. Dans toutes les juridictions suivies, la législation avance systématiquement plus lentement que la technologie.
Quel est le geste le plus simple qu’une personne ordinaire puisse faire ?
Marquez une pause avant de partager. Une seule seconde de scepticisme face à une vidéo surprenante ou émotionnellement provocante a un effet mesurable sur sa diffusion. Votre seuil de partage doit être plus élevé que votre seuil de visionnage.
À vous de jouer
La même technologie, qui produit aujourd’hui des médias synthétiques d’une telle qualité, est accessible à quiconque dispose d’un navigateur et d’un prompt. La différence entre ceux qui créent les contenus qui façonnent notre perception et ceux qui se contentent de les consommer n’a jamais été aussi faible.
Que vous vouliez réaliser un court métrage, créer des contenus visuels pour une marque ou simplement comprendre ce que l’on ressent à utiliser ces outils de l’intérieur, le catalogue de modèles de texte vers vidéo de Picasso IA met à portée de main tout ce qui est évoqué dans cet article. Kling v3 Video pour la qualité de mouvement cinématographique. Veo 3 pour un photoréalisme synchronisé avec l’audio. LTX 2 Pro pour une résolution 4K sur des projets de haute production.
La question n’est plus de savoir si la vidéo IA peut tromper les experts. Elle l’a déjà fait. La question est désormais de savoir ce que vous en faites, et si vous utilisez ces outils pour créer quelque chose qui vaut la peine d’être regardé.
Commencez par un prompt. Regardez ce qui apparaît. L’écart entre ce que vous imaginez et ce que ces modèles produisent est plus petit que vous ne le pensez.


