O clipe apareceu num grupo de mensagens. Sem autoria, sem contexto, apenas um vídeo curto de uma mulher falando diretamente para a câmera em um apartamento iluminado pelo sol. Trinta segundos. Iluminação natural, leve tremor de câmera, o tipo de imagem que você gravaria com o celular. Dezesseis pessoas naquele grupo, incluindo três jornalistas em atividade e um cineasta documentarista. Nenhuma delas sinalizou como sintético. Porque não era. Ou era?
Essa pergunta já não é retórica. O vídeo de IA que enganou até os especialistas não é uma hipótese. Está acontecendo em grande escala, agora, com ferramentas acessíveis ao público que não exigem nenhum treinamento técnico e custam menos do que uma assinatura mensal de streaming. A linha perceptual entre vídeo real e sintético já foi cruzada, e a maioria das pessoas nunca percebeu quando isso aconteceu.
Quando ninguém conseguia perceber
O ponto de inflexão não veio com um único avanço. Aconteceu aos poucos e, depois, de repente. Ainda em 2022, os vídeos gerados por IA tinham sinais evidentes: dentes deformados, fundos que tremulavam, o jeito estranho como os olhos nunca acompanhavam direito. Em 2024, esses artefatos quase tinham desaparecido. Em 2025, os melhores modelos produziam imagens que passavam em todos os testes heurísticos em que os profissionais se apoiavam havia anos.
Em estudos documentados, analistas de perícia em mídia treinados identificaram vídeos gerados por IA corretamente em taxas pouco acima do acaso, ao assistir clipes de menos de 10 segundos. Isso não é incompetência deles. É uma tecnologia que de fato cruzou um limiar perceptual. Os sinais que os seres humanos desenvolveram para detectar engano, as microexpressões, as inconsistências de iluminação, os erros de física, foram sistematicamente aprendidos e corrigidos por redes neurais treinadas com bilhões de horas de imagens reais.
A linha de Turing para o vídeo
Alan Turing propôs que uma máquina seria considerada inteligente quando um humano não conseguisse distingui-la de outro humano numa conversa. O vídeo cruzou sua própria versão dessa linha. Vários estudos independentes de 2024 e 2025 mostraram que a precisão humana para detectar clipes curtos de vídeo por IA caiu para 54%, essencialmente cara ou coroa. As máquinas venceram.
O que tornou 2025 diferente
Três fatores convergiram:
- Escala dos dados de treinamento: Os modelos agora são treinados com imagens medidas em petabytes, não em terabytes
- Coerência temporal: O problema mais difícil da IA de vídeo, manter sujeitos, luz e física consistentes ao longo dos quadros, foi em grande parte resolvido
- Refinamento por difusão: A redução iterativa de ruído aplicada aos quadros de vídeo eliminou as assinaturas de artefatos para as quais as ferramentas forenses haviam sido ajustadas para detectar
Quando esses três avanços se sobrepuseram na mesma geração de modelos, o salto de qualidade foi descontínuo. Não incremental. Uma mudança de patamar.
O que os modelos realmente fazem
Para entender por que essas imagens são tão convincentes, você precisa de uma visão básica de como esses sistemas funcionam. Os modelos de texto para vídeo não gravam nem amostram imagens reais. Eles sintetizam cada pixel, cada quadro, a partir de um modelo estatístico aprendido de como a realidade se parece.
Modelos como o Kling v3 Video e o Veo 3 operam sobre o que os pesquisadores chamam de difusão no espaço latente, um processo em que o ruído é removido sistematicamente até surgir um vídeo coerente e de alta fidelidade que corresponde ao prompt de entrada. O modelo não recupera imagens. Ele as constrói a partir de distribuições de probabilidade aprendidas durante o treinamento.
Por que a física agora funciona
Os modelos anteriores falhavam na física porque aprendiam correlações sem causalidade. Eles sabiam que sombras geralmente aparecem abaixo dos objetos, mas não modelavam fontes de luz com consistência direcional. Arquiteturas mais novas, especialmente as com mecanismos de atenção explicitamente conscientes de 3D, modelam cenas com representações espaciais implícitas. Quando a câmera se move, as sombras se movem corretamente. Quando um objeto passa atrás de outro, a oclusão é tratada de forma natural.
É por isso que o Sora 2 Pro consegue gerar imagens de um copo de água caindo de uma mesa com um comportamento de líquido fisicamente preciso. O modelo não consultou "como a água cai". Ele internalizou a física ao observar milhões de ocorrências dela.
O salto de resolução
A resolução importa enormemente para a detecção. Em 480p, mesmo olhos bem treinados às vezes conseguem captar artefatos de compressão de textura. Em 1080p, com desfoque de movimento adequado, a tarefa fica bem mais difícil. O Hailuo 02 gera em 1080p nativamente. O Seedance 1.5 Pro também. Quando algo é renderizado na resolução da televisão aberta, com correção de cor adequada, o cérebro do espectador deixa de procurar ativamente problemas e passa a aceitar passivamente o que vê.
O momento viral que ninguém esperava
Os vídeos que viralizam raramente são os tecnicamente impressionantes. São os que ressoam emocionalmente. A voz de um avô reconstruída. Uma celebridade numa situação que parece plausível. Um trecho de notícia com ruído ambiente suficiente para parecer autêntico.
O que mudou em 2025 é que a qualidade básica do vídeo de IA cruzou o limiar de "boa o bastante para compartilhar" para usuários casuais de redes sociais. Você não precisa gerar perfeição fotorrealista para enganar alguém que rola a tela a 1,5x de velocidade. Você precisa de algo que não dispare imediatamente uma reação de tem algo errado. Os modelos alcançaram isso meses atrás. Desde então, só vêm melhorando.
Como o compartilhamento amplifica tudo
Toda vez que um vídeo sintético é compartilhado sem escrutínio, ele treina as pessoas ao redor a aceitar esse tipo de conteúdo como real. A exposição repetida a vídeos de IA, mesmo quando eles acabam sendo identificados como sintéticos, eleva a tolerância básica a artefatos. É uma catraca, e ela só se move em uma direção.
O efeito cumulativo: Estudos sobre desinformação mostram que, mesmo quando as pessoas descobrem que um conteúdo era falso, um efeito de influência contínua persiste. Ver e compartilhar pesa mais do que a correção que vem depois.
O fator velocidade
Um vídeo pode ser gerado, refinado e publicado em menos de três minutos com as ferramentas atuais. Uma checagem de fatos criteriosa leva horas. Essa diferença é o território em que a mídia sintética opera. Não é que a verificação seja impossível. É que ela não consegue andar na velocidade do compartilhamento.
Por que os especialistas erraram
Os especialistas que falharam não eram desprovidos de conhecimento. Eles usavam um conhecimento calibrado para um problema mais antigo.
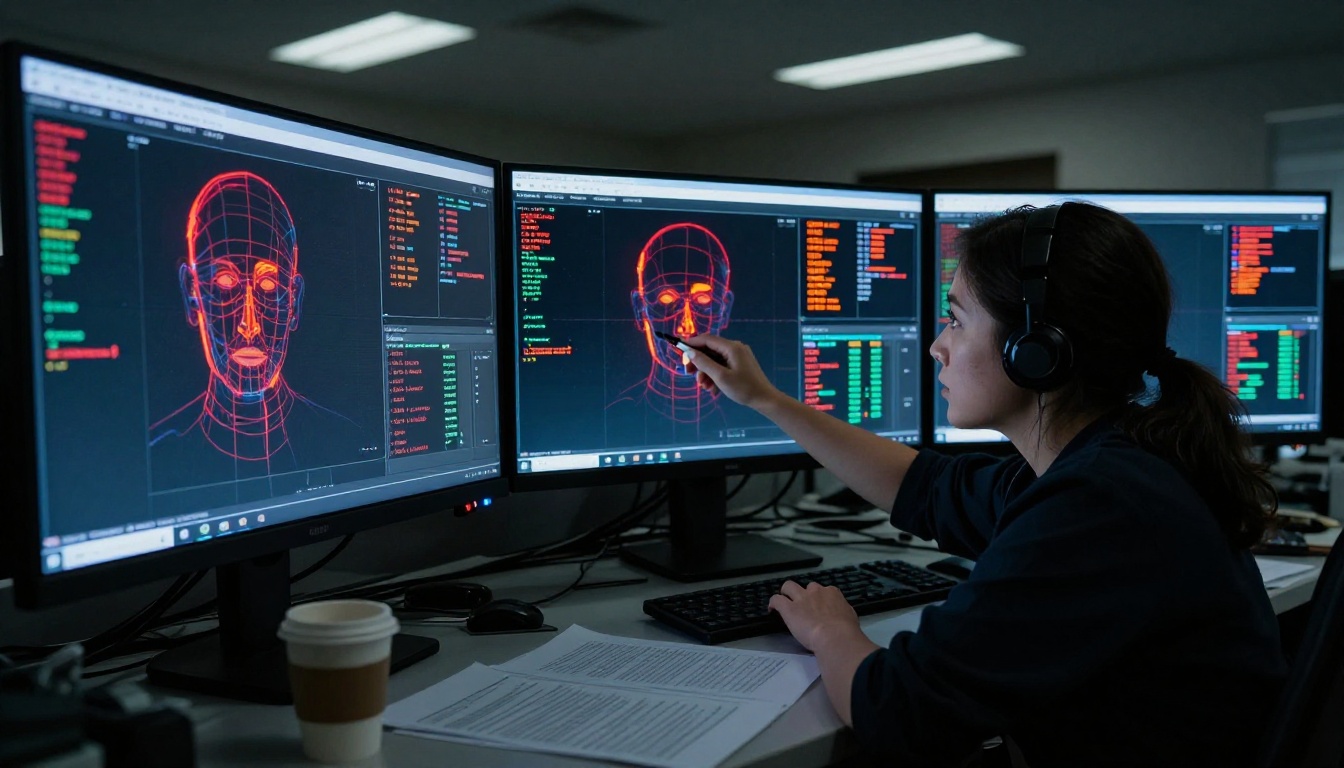
A maior parte do treinamento profissional em perícia de vídeo foca em artefatos de compressão, assinaturas de clonagem e inconsistências de metadados, todas assinaturas da edição tradicional de vídeo e dos deepfakes anteriores baseados em GAN. Modelos de vídeo por difusão deixam assinaturas fundamentalmente diferentes, ou, em alguns casos, quase nenhuma. Os especialistas procuravam impressões digitais de um crime diferente.
O que eles estavam verificando
| Método de detecção | Funciona contra deepfakes antigos | Funciona contra modelos novos |
|---|
| Inspeção de metadados | Sim | Parcialmente |
| Análise de artefatos de compressão | Sim | Não |
| Análise do padrão de piscadas | Sim | Não |
| Mesclagem nas bordas do rosto | Sim | Não |
| Análise de frequência espectral | Parcialmente | Parcialmente |
| Teste de coerência temporal | Não | Não |
O padrão é claro. O conjunto antigo de ferramentas está em grande parte obsoleto para os modelos de geração atual. Novas ferramentas de detecção estão sendo desenvolvidas, mas os melhores sistemas disponíveis hoje ainda operam com taxas de precisão que não se sustentariam em contextos jurídicos.
Falha de calibração
Há também uma dimensão psicológica. Especialistas que raramente viram vídeos de IA que de fato os enganaram tendem a ser excessivamente confiantes. O modelo mental de que "vídeo de IA tem uma certa aparência" vira uma desvantagem quando a tecnologia cruza certos limiares. A calibração exige exposição a casos de falha, e até recentemente não havia casos convincentes de falha suficientes para recalibrar os detectores.
Como identificar o que a maioria das pessoas deixa passar
Este não é um problema totalmente resolvido, mas há sinais que valem a pena checar antes de compartilhar.
Verifique primeiro o fundo: Os modelos de IA frequentemente geram sujeitos em primeiro plano convincentes, mas perdem a consistência espacial do fundo durante movimentos rápidos de câmera. Observe paredes que parecem respirar ou móveis que mudam de posição discretamente.
Cinco coisas para observar
- Joias e acessórios: Brincos, anéis, relógios e colares continuam difíceis de renderizar de forma consistente para a IA em movimento. Muitas vezes atravessam a pele ou mudam de forma sutilmente entre um quadro e outro.
- Geometria das mãos: Os dedos são notoriamente difíceis. Conte-os quando as mãos estiverem claramente visíveis no quadro.
- Texto no ambiente: Placas de rua, rótulos, textos em roupas. Modelos de IA têm dificuldade em renderizar textos legíveis e consistentes. Muitas vezes eles se deformam ou ficam borrados quando examinados de perto.
- A regra dos 8 segundos: A maioria dos artefatos de vídeo de IA se acumula com o tempo. Observe oito segundos completos antes de julgar um clipe.
- Coerência do contexto: O local parece geograficamente coerente ao longo de todo o clipe? Os fundos de vídeos de IA às vezes reúnem elementos de combinações geograficamente impossíveis.
O que os softwares podem fazer
Ferramentas de detecção como Hive Moderation, Reality Defender e Sensity AI estão desenvolvendo ativamente pipelines de detecção em tempo real. Nenhuma está perto de ser perfeita. Os pesquisadores mais francos da área dizem que a precisão de detecção em vídeos de IA de qualidade de consumo fica em torno de 75-85%, o que parece alto até você considerar o volume de conteúdo gerado diariamente.
Os modelos por trás da revolução
Entender os modelos específicos que impulsionam essa mudança importa, tanto para o contexto quanto para a aplicação prática.
Os modelos disponíveis hoje representam capacidades que, ainda em 2022, teriam exigido o orçamento de uma produção de Hollywood. O cenário atual de texto para vídeo acessível é notável:
Cada um representa uma abordagem distinta da síntese de vídeo, com pontos fortes diferentes em aderência ao prompt, suavidade de movimento e qualidade de fotorrealismo.
O problema do áudio que ninguém comenta
A visão recebeu a maior parte da atenção do público, mas o áudio é igualmente importante e igualmente resolvido. Modelos como o Veo 3 e o Seedance 1.5 Pro agora geram áudio ambiente sincronizado com o conteúdo visual. Quando uma porta se abre, você ouve uma porta. Quando alguém fala, a acústica do ambiente combina com o espaço visual. O áudio sincronizado era um dos últimos sinais confiáveis. Ele já não é confiável.
O que isso muda agora
As implicações se espalham pelos setores mais rápido do que a maioria das organizações está preparada.
Para o jornalismo: O vídeo deixou de ser inerentemente mais crível do que o texto. Cada clipe agora exige verificação de procedência antes da publicação. O padrão profissional está se deslocando para exigir imagens com certificação C2PA ou verificação direta da fonte para qualquer vídeo usado como prova de acontecimentos do mundo real.
Para processos judiciais: Os tribunais estão começando a lidar com provas em vídeo de maneiras que não precisam desde a adoção generalizada da fotografia. Um vídeo que mostra uma pessoa cometendo um ato não pode, por si só, ser tratado como prova conclusiva sem uma cadeia de procedência que o corrobore.
Para a criação de conteúdo: Os mesmos modelos que produzem desinformação sintética também criam arte, entretenimento, publicidade e educação legítimos. Toda produtora com orçamento para vídeo está avaliando ativamente quanto desse orçamento pode ser redirecionado para a geração por IA.
O contrato social em torno do vídeo
Por décadas, "ver para crer" foi uma heurística razoável. Estava errada mesmo antes do vídeo de IA, dada a história da edição de filmes e do enquadramento seletivo, mas era funcional. As pessoas confiavam, em geral, mais no vídeo do que no texto porque parecia mais difícil de fabricar. Essa assimetria desmoronou.
O que isso exige agora: A responsabilidade pela verificação passa do espectador, que não tem as ferramentas, para o publicador e as plataformas. Plataformas que continuam exibindo vídeos não verificados, sem sinais de procedência, estão, no mínimo, agindo com negligência.
Três setores já afetados
- Política: Material de campanha sintético já apareceu em vários países. As taxas de detecção no momento da primeira publicação costumam ficar perto de zero.
- Finanças: Chamadas de vídeo com deepfake se passando por executivos resultaram em casos documentados de fraude com transferências bancárias, incluindo incidentes amplamente noticiados envolvendo transferências acima de US$ 20 milhões.
- Entretenimento: Estúdios estão em negociação ativa sobre os direitos de imagem diante da IA, já que os modelos agora conseguem sintetizar, de forma crível, performances de atores reais com pouco material de referência.
Suas perguntas, respondidas
Dá para colocar marca d'água em vídeo de IA?
Sim, tecnicamente. O SynthID, do Google, incorpora marcas d'água imperceptíveis que sobrevivem à maioria das operações de edição. O desafio é que a marcação é voluntária e não é adotada de forma universal. Modelos de pesos abertos podem ser implantados sem nenhuma infraestrutura de marca d'água.
As ferramentas de detecção vão alcançar?
As ferramentas de detecção estão melhorando, mas a dinâmica entre ataque e defesa nesse campo favorece fortemente os geradores. Toda vez que uma assinatura de detecção se torna amplamente conhecida, o treinamento do modelo pode ser ajustado para evitar produzi-la. A detecção é uma disciplina reativa num mundo em que a geração é proativa e mais rápida.
Criar esse tipo de conteúdo é ilegal?
Aplicações específicas de vídeos deepfake feitos sem consentimento são ilegais em várias jurisdições, incluindo o Reino Unido, partes dos EUA e a Austrália. A criação de vídeo sintético em si não é regulamentada de forma ampla. Em todas as jurisdições acompanhadas, a legislação avança mais devagar do que a tecnologia.
Qual é a coisa mais simples que uma pessoa comum pode fazer?
Pare antes de compartilhar. Um segundo extra de ceticismo diante de vídeos surpreendentes ou emocionalmente provocativos tem impacto mensurável na disseminação. Seu limiar para compartilhar deve ser mais alto do que o limiar para assistir.
Agora é a sua vez
A mesma tecnologia que produz mídia sintética nesse nível de qualidade está acessível a qualquer pessoa com um navegador e um prompt. A diferença entre quem cria o conteúdo que molda a percepção e quem apenas o consome é menor do que nunca.
Seja para produzir um curta, criar conteúdo visual para uma marca ou simplesmente entender como é usar essas ferramentas por dentro, o catálogo de modelos de texto para vídeo no Picasso IA coloca ao seu alcance tudo o que foi discutido neste artigo. O Kling v3 Video para qualidade de movimento cinematográfico. O Veo 3 para fotorrealismo sincronizado com áudio. O LTX 2 Pro para resolução 4K em projetos de alta produção.
A questão já não é se o vídeo de IA consegue enganar especialistas. Ele já conseguiu. A questão agora é o que você faz com essa informação, e se usa essas ferramentas para criar algo que valha a pena assistir.
Comece com um prompt. Veja o que aparece. A distância entre o que você imagina e o que esses modelos produzem é menor do que você imagina.


