L’image vers image par IA fait partie de ces fonctionnalités qui semblent simples jusqu’à ce que vous les utilisiez, et qui deviennent alors l’outil auquel vous faites appel en permanence. Au lieu de partir d’un prompt textuel vierge, vous importez une photo existante dans un modèle d’IA et lui demandez de produire quelque chose de nouveau à partir de cette image. Le résultat hérite de la structure, de la composition ou du style de l’original, mais se transforme en quelque chose de tout à fait différent.
Ce n’est pas un filtre. Ce n’est pas Photoshop. C’est une manière fondamentalement différente de travailler avec des visuels générés par l’IA, et une fois que vous aurez compris son fonctionnement, vous comprendrez pourquoi les photographes professionnels, les designers et les directeurs de création s’en servent chaque jour.
L’idée centrale de l’img2img
Dans sa forme la plus simple, l’image vers image (souvent écrite img2img) prend une image existante comme point de départ, au lieu d’un bruit aléatoire pur. La génération texte vers image classique part d’un champ de parasites aléatoires et le débruite progressivement pour obtenir une image cohérente, guidée par votre prompt textuel. L’image vers image fonctionne de la même façon, sauf que le point de départ n’est pas un hasard pur. C’est une version bruitée de votre photo de référence.
Le modèle détruit en partie votre image d’origine en y ajoutant du bruit, puis la reconstruit en se guidant à la fois sur la structure de l’image et sur vos instructions textuelles. La part de l’original qui survit dépend d’un seul paramètre, appelé force de débruitage (parfois nommé force de guidage ou influence de l’image).
Ce que fait réellement une image de référence
Lorsque vous importez une photo de référence, l’IA ne se contente pas de la copier. Elle s’en sert pour fournir :
- La structure spatiale : l’emplacement des objets dans le cadre
- La température des couleurs : la chaleur ou la fraîcheur générale de la scène
- Le poids compositionnel : l’endroit où se concentre la masse visuelle dans l’image
- La répartition tonale : le rapport entre les zones claires, les tons moyens et les ombres
Tout cela devient une forme de conditionnement qui façonne le résultat, même lorsque ce dernier ne ressemble en rien à la source.
Bruit, débruitage et pourquoi c’est important
Le processus de diffusion consiste à ajouter un bruit gaussien à une image jusqu’à ce qu’elle devienne des parasites méconnaissables, puis à entraîner un modèle à inverser ce processus étape par étape. En img2img, vous choisissez à quel point de l’échelle de bruit démarrer. Une valeur de débruitage faible (0,2 à 0,4) perturbe à peine l’image, et le résultat reste très proche de l’original. Une valeur de débruitage élevée (0,8 à 1,0) la randomise presque entièrement, et le prompt textuel prend beaucoup plus d’importance.
Ce contrôle du niveau de bruit est ce qui rend l’img2img si souple. La même photo de référence peut donner un portrait de studio photoréaliste à faible intensité, ou une scène entièrement réinventée à forte intensité.
Les différents types d’image vers image par IA
Tous les pipelines img2img ne fonctionnent pas de la même manière. Au cours des deux dernières années, le domaine s’est divisé en plusieurs approches spécialisées, chacune adaptée à des objectifs créatifs différents.
Transfert de style
Le transfert de style classique prend le contenu d’une image et lui applique l’esthétique visuelle d’une autre, par exemple pour transformer une photographie en tableau sans perdre le sujet. Le transfert de style moderne, basé sur la diffusion, va bien plus loin : vous pouvez appliquer non seulement un style artistique, mais aussi une ambiance photographique précise, une époque ou une palette de couleurs issue de n’importe quelle image de référence.
Génération guidée par la profondeur
Les modèles guidés par la profondeur, comme Flux Depth Pro et Flux Depth Dev, extraient une carte de profondeur de votre image de référence et l’utilisent comme contrainte pendant la génération. Cela préserve la structure tridimensionnelle de la scène tout en remplaçant complètement les textures de surface et les styles. L’intérieur d’une pièce conserve la même forme architecturale, mais les murs, le mobilier et l’éclairage changent entièrement.
💡 L’img2img guidé par la profondeur est largement utilisé en visualisation architecturale et en design d’intérieur, où la précision spatiale est indispensable.
Contrôle des contours et de la structure (Canny)
Les modèles basés sur Canny fonctionnent en extrayant les lignes de contour de votre image de référence. Flux Canny Pro et Flux Canny Dev utilisent ces cartes de contours pour contrôler le résultat au niveau structurel. Chaque contour, chaque limite et chaque silhouette de l’image d’origine est préservé dans le résultat, tandis que la couleur, la texture et le style changent librement.
Cette approche est particulièrement précieuse pour convertir des croquis ou des dessins au trait en images photoréalistes, ou pour conserver une composition précise à travers plusieurs itérations de style.
Inpainting et outpainting
L’inpainting est une forme spécifique d’img2img dans laquelle vous masquez une partie d’une image et demandez à l’IA de la remplir avec un nouveau contenu. Flux Fill Pro et Flux Fill Dev sont conçus précisément pour cela : ils analysent le contexte entourant la zone masquée et génèrent un contenu qui s’y raccorde sans couture.
L’outpainting fait l’inverse. Il étend l’image au-delà de ses bordures d’origine, en générant un contenu qui prolonge naturellement la scène dans n’importe quelle direction.
Quels modèles d’IA alimentent l’img2img aujourd’hui
Le paysage des modèles img2img s’est consolidé autour de quelques architectures remarquables qu’il vaut la peine de connaître.
Flux Redux Dev : des variations d’image à grande échelle
Flux Redux Dev est conçu spécifiquement pour créer des variations contrôlées d’une image d’entrée. Contrairement à l’img2img basique, Redux encode l’image de référence dans un vecteur de caractéristiques riche, qui guide la génération à un niveau plus profond qu’un simple conditionnement par pixels. Le résultat donne des variations qui paraissent cohérentes avec la source, sans en être des copies directes.
Flux Redux Schnell est la variante la plus rapide, qui sacrifie un peu de fidélité aux détails contre des temps de génération nettement plus courts. Elle est pratique pour itérer rapidement lorsque vous devez tester de nombreuses variations.
Flux Canny et Depth : contrôle de la structure
Les familles de modèles Canny et Depth de Black Forest Labs représentent l’état de l’art actuel en génération d’images préservant la structure. Là où les premières approches ControlNet nécessitaient des pipelines de prétraitement distincts, ces modèles gèrent le conditionnement en interne.
| Modèle | Type de contrôle | Meilleur usage |
|---|
| Flux Canny Pro | Lignes de contour | Du croquis à la photo, style avec composition préservée |
| Flux Canny Dev | Lignes de contour | Travail créatif itératif |
| Flux Depth Pro | Carte de profondeur 3D | Architecture, intérieurs, produits |
| Flux Depth Dev | Carte de profondeur 3D | Travail spatial expérimental |
Flux Kontext Fast : édition d’image en contexte
Flux Kontext Fast représente une approche plus récente, dans laquelle les instructions textuelles et l’image de référence sont traitées ensemble dans une fenêtre de contexte unifiée. Au lieu de traiter le conditionnement par l’image et le prompt textuel comme deux signaux distincts, Kontext les fusionne, ce qui permet des modifications pilotées par le langage naturel, comme « rends ses cheveux roux » ou « remplace l’arrière-plan par une plage », tout en préservant mieux le reste du cadre.
Quelle est l’influence de l’image de référence
L’une des décisions les plus importantes dans tout flux de travail img2img consiste à déterminer le contrôle que vous laissez à l’image de référence sur le résultat final. Il est régi par le paramètre force de débruitage ou force de l’image, généralement une valeur comprise entre 0,0 et 1,0.
Faible force : rester proche de la source
Avec des valeurs de force comprises entre 0,15 et 0,40, le modèle apporte des changements subtils. Vous pouvez observer :
- Éclairage ajusté sans modifier la composition
- Étalonnage des couleurs déplacé vers une autre ambiance
- Ajouts ou suppressions mineurs d’objets
- Adoucissement ou accentuation des textures
Cette plage convient idéalement lorsque vous disposez d’une bonne photo de référence et que vous souhaitez l’affiner plutôt que la remplacer.
Forte intensité : laisser le prompt prendre le relais
Avec des valeurs de force comprises entre 0,65 et 0,90, le prompt textuel domine. Le modèle utilise l’image de référence surtout comme guide structurel approximatif. Vous verrez :
- Une scène entièrement repeuplée de nouveaux éléments
- Une identité du sujet largement modifiée
- Un environnement entièrement remplacé
- Un style complètement changé
💡 La plupart des utilisateurs expérimentés d’img2img travaillent dans la zone idéale de 0,45 à 0,65, où la référence et le prompt exercent une influence à peu près égale, ce qui produit des résultats qui paraissent voulus plutôt qu’aléatoires.
Cas d’usage concrets
La gamme des applications pratiques de l’img2img s’est considérablement élargie à mesure que les modèles se sont améliorés.
Retouche de photos de produits
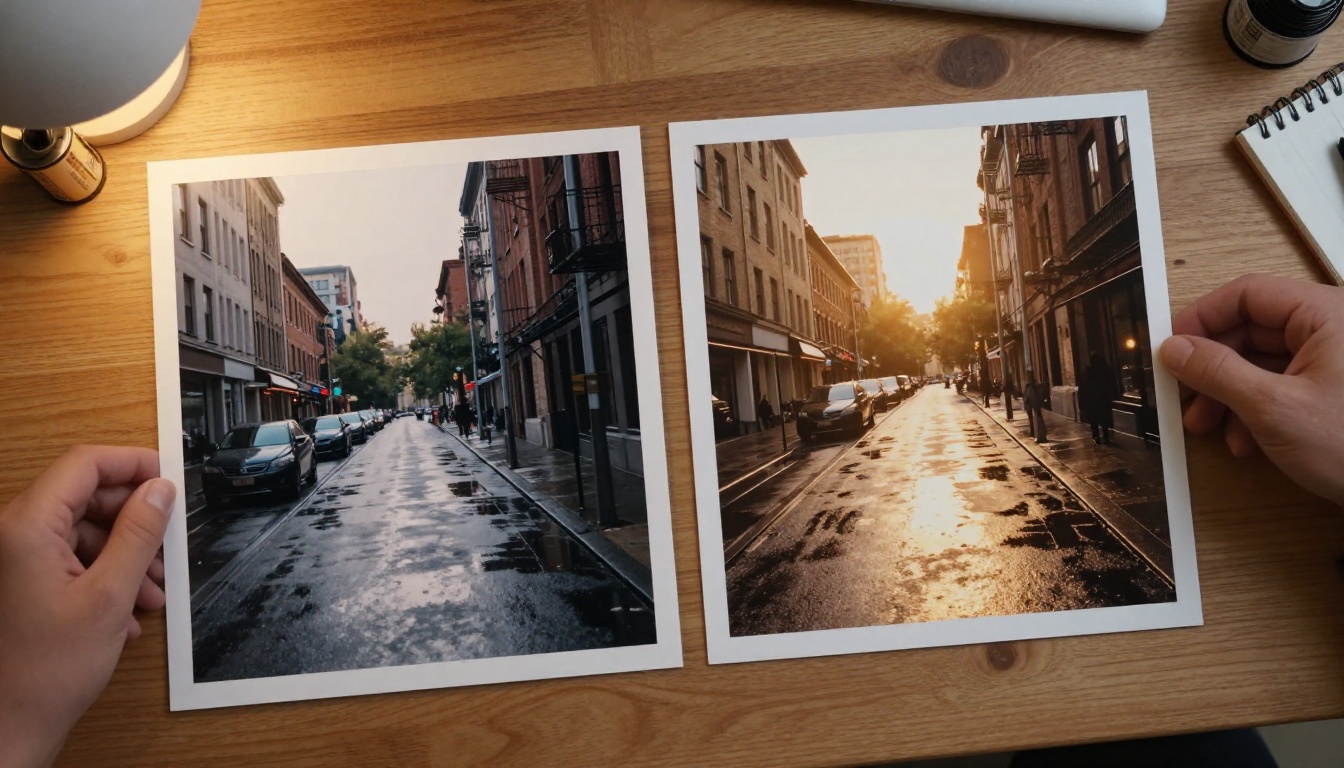
Les photographes e-commerce utilisent l’img2img pour générer rapidement d’autres prises de vue de produits à partir d’une seule photo de référence. Au lieu de refaire une séance sur différents fonds ou dans d’autres conditions d’éclairage, ils importent la photo du produit dans un modèle de profondeur ou Canny et décrivent le nouvel environnement dans le prompt. La forme et les proportions du produit restent constantes pendant que la scène change.
Retouche de portrait et de beauté
Les photographes de portrait haut de gamme et les retoucheurs utilisent des passes img2img à faible intensité pour affiner les teints, ajuster la direction de la lumière ou apporter de légères variations d’ambiance, sans perdre la ressemblance du sujet. Flux Redux Dev gère particulièrement bien les variations de portrait, car son conditionnement au niveau des caractéristiques préserve la structure du visage tout au long de la génération.
Visualisation en architecture et design d’intérieur
Les architectes utilisent des modèles guidés par la profondeur pour tester différentes finitions, matériaux et agencements de mobilier sur une même disposition spatiale. Une seule photographie d’architecture devient un modèle pour des dizaines de variations de design, chacune conservant des proportions spatiales exactes grâce à la carte de profondeur.
PicassoIA vous donne un accès direct aux meilleurs modèles img2img disponibles, sans aucune configuration, sans GPU local et sans connaissances techniques. Voici comment utiliser Flux Redux Dev pour créer des variations d’image :
Étape 1 : Rendez-vous sur Flux Redux Dev dans la collection de modèles de PicassoIA.
Étape 2 : Importez votre image de référence. Il peut s’agir d’une photographie, d’un rendu, d’un croquis ou de tout visuel que vous souhaitez utiliser comme base structurelle.
Étape 3 : Rédigez un prompt textuel décrivant le résultat souhaité. Soyez précis sur l’éclairage, l’ambiance et le style. Plus votre prompt est précis, mieux le modèle pourra l’équilibrer avec la référence.
Étape 4 : Ajustez le curseur de force de l’image. Partez de 0,5 comme base. Si le résultat est trop proche de l’original, augmentez-la. S’il perd la composition que vous voulez conserver, diminuez-la.
Étape 5 : Générez et itérez. Les flux de travail img2img impliquent presque toujours plusieurs passes. Utilisez le premier résultat comme nouvelle référence pour une seconde passe, afin d’affiner des zones précises.
💡 Pour les travaux où la structure est critique, comme les photos de produits ou la visualisation architecturale, essayez Flux Depth Pro plutôt que Redux. Le conditionnement par la profondeur préserve la géométrie spatiale avec bien plus de précision.
Les erreurs courantes
Même les utilisateurs expérimentés butent sur les mêmes problèmes lorsqu’ils débutent avec l’img2img.
Régler une force trop élevée
L’erreur la plus fréquente consiste à pousser la force de débruitage au-delà de 0,8 en espérant un changement spectaculaire tout en conservant la composition d’origine. À ce niveau, l’image de référence influence à peine le résultat. Vous obtenez une image qui suit votre prompt textuel, sans presque aucun souvenir de l’original. Si vous voulez un changement fort qui respecte tout de même la composition, utilisez un modèle de profondeur ou Canny à force moyenne, plutôt que de pousser Redux à son maximum.
Utiliser des images source en basse résolution
Le modèle se conditionne sur les caractéristiques qu’il peut extraire de votre référence. Une entrée floue et de basse résolution produit un conditionnement vague qui mène à des résultats incohérents. Partez toujours de la version la plus haute résolution de votre image de référence disponible. Si vous devez d’abord augmenter la résolution d’une image de faible définition, les outils de super-résolution de PicassoIA peuvent s’en charger avant de l’intégrer au pipeline img2img.
Négliger entièrement le prompt textuel
Certains utilisateurs importent une image de référence et laissent le prompt textuel vide ou minimal, en espérant que le modèle devine ce qu’ils veulent à partir de l’image seule. Sans prompt textuel pour guider la direction du débruitage, les résultats sont imprévisibles. Une simple description, comme « portrait photoréaliste, éclairage naturel, détails nets », améliore déjà nettement la cohérence.
Prêt à essayer
L’image vers image n’est pas une fonctionnalité de niche réservée aux utilisateurs techniques. C’est la manière la plus pratique de travailler avec des visuels d’IA une fois qu’on dépasse la génération basique texte vers image. Vous avez une photo existante qui est presque parfaite. Vous voulez changer l’ambiance, l’arrière-plan, l’éclairage ou le style. L’img2img est l’outil qu’il vous faut.
PicassoIA propose toute la famille de modèles img2img de Flux, prête à l’emploi, notamment Flux Redux Dev pour les variations, Flux Canny Pro pour la génération contrôlée par les contours, Flux Depth Pro pour la précision spatiale et Flux Fill Pro pour l’inpainting sans couture. Chaque modèle est accessible directement dans votre navigateur, sans installation.
Importez une photo. Rédigez un prompt. Observez ce qui se passe à une force de 0,5. Ajustez ensuite à partir de là.