Image to image AI उन फ़ीचर्स में से है जो सुनने में सरल लगते हैं, लेकिन जब आप इसे असल में इस्तेमाल करते हैं तो यह वह टूल बन जाता है जिसका इस्तेमाल आप लगातार करते हैं। खाली टेक्स्ट प्रॉम्प्ट से शुरू करने के बजाय, आप किसी मौजूदा फ़ोटो को AI मॉडल में डालते हैं और उसी इमेज के आधार पर कुछ नया बनाने को कहते हैं। नतीजा मूल इमेज का स्ट्रक्चर, कंपोज़िशन या स्टाइल अपने साथ रखता है, लेकिन पूरी तरह से कुछ अलग रूप में बदल जाता है।
यह कोई फ़िल्टर नहीं है। यह Photoshop भी नहीं है। यह AI-जनरेटेड विज़ुअल्स के साथ काम करने का बिल्कुल अलग तरीका है, और एक बार आप समझ जाएँगे कि यह कैसे काम करता है, तो आप जान जाएँगे कि प्रोफ़ेशनल फ़ोटोग्राफ़र, डिज़ाइनर और क्रिएटिव डायरेक्टर इसे रोज़ क्यों इस्तेमाल करते हैं।
img2img के पीछे का मूल विचार
सबसे सरल शब्दों में, image to image (जिसे अक्सर img2img लिखा जाता है) शुद्ध रैंडम नॉइज़ के बजाय एक मौजूदा इमेज को शुरुआती बिंदु के रूप में लेता है। पारंपरिक टेक्स्ट-टू-इमेज जनरेशन रैंडम स्टैटिक के एक क्षेत्र से शुरू होता है और उसे आपके टेक्स्ट प्रॉम्प्ट के मार्गदर्शन में धीरे-धीरे एक सुसंगत इमेज में बदलता है। Image to image भी इसी तरह काम करता है, बस शुरुआती बिंदु शुद्ध रैंडमनेस नहीं है। यह आपकी रेफ़रेंस फ़ोटो का नॉइज़ वाला वर्ज़न है।
मॉडल आपकी इनपुट इमेज में नॉइज़ जोड़कर उसे आंशिक रूप से नष्ट कर देता है, फिर इमेज के स्ट्रक्चर और आपके टेक्स्ट निर्देश, दोनों के मार्गदर्शन में उसे दोबारा बनाता है। मूल इमेज का कितना हिस्सा बचता है, यह denoise strength (जिसे कभी-कभी guidance strength या image influence भी कहा जाता है) नाम के एक पैरामीटर पर निर्भर करता है।
रेफ़रेंस इमेज असल में क्या करती है
जब आप रेफ़रेंस फ़ोटो अपलोड करते हैं, तो AI उसे बस कॉपी नहीं करता। वह इमेज का इस्तेमाल इन चीज़ों के लिए करता है:
- स्पेशल स्ट्रक्चर: फ़्रेम में चीज़ें कहाँ स्थित हैं
- कलर टेम्परेचर: दृश्य की सामान्य गर्माहट या ठंडापन
- कंपोज़िशनल वेट: इमेज में विज़ुअल मास कहाँ टिका है
- टोनल डिस्ट्रिब्यूशन: हाइलाइट्स, मिडटोन और शैडो का अनुपात
यह सब एक तरह की कंडीशनिंग बन जाता है जो आउटपुट को आकार देती है, भले ही अंतिम नतीजा सोर्स से बिल्कुल अलग दिखे।
नॉइज़, डीनॉइज़िंग, और इसका महत्व
डिफ़्यूज़न प्रक्रिया किसी इमेज में Gaussian नॉइज़ तब तक जोड़ती है जब तक वह पहचानी न जा सकने वाली स्टैटिक में न बदल जाए, और फिर एक मॉडल को चरण-दर-चरण इस प्रक्रिया को उलटना सिखाया जाता है। img2img में, आप चुनते हैं कि नॉइज़ स्केल पर कितनी दूर से शुरू करना है। कम denoise value (0.2-0.4) इमेज को मुश्किल से छेड़ता है और आउटपुट मूल के बहुत करीब रहता है। ज़्यादा denoise value (0.8-1.0) इमेज को लगभग पूरी तरह रैंडम कर देता है और टेक्स्ट प्रॉम्प्ट का असर कहीं ज़्यादा होता है।
नॉइज़ लेवल पर यही नियंत्रण img2img को इतना लचीला बनाता है। वही रेफ़रेंस फ़ोटो कम strength पर फ़ोटोरियलिस्टिक स्टूडियो पोर्ट्रेट बना सकती है, या ज़्यादा strength पर पूरी तरह से नया रूप लिया हुआ दृश्य।
Image to Image AI के अलग-अलग प्रकार
सभी img2img पाइपलाइन एक जैसे काम नहीं करतीं। पिछले दो सालों में यह क्षेत्र कई विशेष तरीकों में बँट गया है, और हर तरीका अलग क्रिएटिव लक्ष्यों के लिए उपयुक्त है।
स्टाइल ट्रांसफ़र
क्लासिक स्टाइल ट्रांसफ़र एक इमेज के कंटेंट को लेता है और उस पर किसी दूसरी इमेज की विज़ुअल एस्थेटिक लागू करता है, जैसे किसी फ़ोटो को विषय-वस्तु खोए बिना पेंटिंग में बदल देना। आधुनिक डिफ़्यूज़न-आधारित स्टाइल ट्रांसफ़र इससे भी आगे जाता है: आप सिर्फ़ आर्ट स्टाइल नहीं, बल्कि किसी भी रेफ़रेंस इमेज से एक खास फ़ोटोग्राफ़िक मूड, दौर या कलर पैलेट भी लागू कर सकते हैं।
Depth-Guided जनरेशन
Flux Depth Pro और Flux Depth Dev जैसे depth-guided मॉडल आपकी रेफ़रेंस इमेज से एक depth map निकालते हैं और जनरेशन के दौरान उसे एक बाधा (constraint) के रूप में इस्तेमाल करते हैं। इससे दृश्य की त्रि-आयामी संरचना बनी रहती है, जबकि सतह की टेक्सचर और स्टाइल पूरी तरह बदल जाते हैं। किसी कमरे के इंटीरियर का आर्किटेक्चरल आकार वही रहता है, लेकिन दीवारें, फ़र्नीचर और लाइटिंग पूरी तरह बदल जाते हैं।
💡 Depth-guided img2img का इस्तेमाल आर्किटेक्चर विज़ुअलाइज़ेशन और इंटीरियर डिज़ाइन में बड़े पैमाने पर होता है, जहाँ स्पेशल सटीकता से समझौता नहीं किया जा सकता।
Edge और स्ट्रक्चर कंट्रोल (Canny)
Canny-आधारित मॉडल आपकी रेफ़रेंस इमेज से edge lines निकालकर काम करते हैं। Flux Canny Pro और Flux Canny Dev इन edge maps का इस्तेमाल जनरेट हुए आउटपुट को स्ट्रक्चरल स्तर पर नियंत्रित करने के लिए करते हैं। मूल इमेज का हर कंटूर, हर सीमा और हर आउटलाइन नतीजे में बनी रहती है, जबकि रंग, टेक्सचर और स्टाइल खुलकर बदल सकते हैं।
यह तरीका स्केच या लाइन ड्रॉइंग को फ़ोटोरियलिस्टिक इमेज में बदलने के लिए, या कई स्टाइल वर्ज़न में एक सटीक कंपोज़िशन बनाए रखने के लिए खास तौर पर उपयोगी है।
इनपेंटिंग और आउटपेंटिंग
Inpainting img2img का एक खास रूप है, जिसमें आप इमेज के किसी हिस्से को मास्क करते हैं और AI से उसे नई सामग्री से भरने को कहते हैं। Flux Fill Pro और Flux Fill Dev खास तौर पर इसी के लिए बने हैं: वे मास्क वाले क्षेत्र के आसपास के संदर्भ को पढ़ते हैं और बिना जोड़ वाली, मेल खाती सामग्री बनाते हैं।
Outpainting इसका उल्टा करता है। यह इमेज को उसकी मूल सीमाओं से आगे बढ़ाता है, और किसी भी दिशा में दृश्य को स्वाभाविक रूप से आगे बढ़ाने वाली नई सामग्री बनाता है।
आज कौन से AI मॉडल img2img को चलाते हैं
img2img मॉडल का परिदृश्य कुछ प्रमुख आर्किटेक्चर के इर्द-गिर्द समेकित हो गया है, जिन्हें जानना उपयोगी है।
Flux Redux Dev: बड़े पैमाने पर इमेज वैरिएशन
Flux Redux Dev खास तौर पर किसी इनपुट इमेज के नियंत्रित वैरिएशन बनाने के लिए डिज़ाइन किया गया है। सामान्य img2img के विपरीत, Redux रेफ़रेंस इमेज को एक समृद्ध फ़ीचर वेक्टर में एन्कोड करता है, जो सिर्फ़ पिक्सेल कंडीशनिंग की तुलना में कहीं गहरे स्तर पर जनरेशन को दिशा देता है। नतीजा ऐसे वैरिएशन होते हैं जो स्रोत से सुसंगत रूप से जुड़े लगते हैं, बिना सीधी कॉपी बने।
Flux Redux Schnell इसका तेज़ वर्ज़न है, जो बारीक डिटेल की गुणवत्ता में कुछ समझौता करके जनरेशन को काफ़ी तेज़ कर देता है। जब आपको कई वैरिएशन जल्दी टेस्ट करने हों, तब यह रैपिड इटरेशन के लिए व्यावहारिक है।
Flux Canny और Depth: स्ट्रक्चर कंट्रोल
Black Forest Labs के Canny और Depth मॉडल परिवार स्ट्रक्चर-संरक्षित इमेज जनरेशन में इस समय सबसे उन्नत हैं। जहाँ पुराने ControlNet तरीकों को अलग प्रीप्रोसेसिंग पाइपलाइन की ज़रूरत होती थी, वहीं ये मॉडल कंडीशनिंग को अंदरूनी तौर पर संभालते हैं।
Flux Kontext Fast: इन-कॉन्टेक्स्ट इमेज एडिटिंग
Flux Kontext Fast एक नया तरीका दर्शाता है, जिसमें टेक्स्ट निर्देश और रेफ़रेंस इमेज को एक एकीकृत कॉन्टेक्स्ट विंडो में एक साथ प्रोसेस किया जाता है। इमेज कंडीशनिंग और टेक्स्ट प्रॉम्प्टिंग को अलग-अलग सिग्नल मानने के बजाय, Kontext इन्हें आपस में जोड़ देता है। इससे "make her hair red" या "change the background to a beach" जैसे प्राकृतिक भाषा वाले एडिट्स संभव होते हैं, और फ़्रेम की बाकी चीज़ें भी बेहतर तरीके से सुरक्षित रहती हैं।
रेफ़रेंस इमेज का प्रभाव कितना मज़बूत होना चाहिए
किसी भी img2img वर्कफ़्लो में सबसे महत्वपूर्ण फ़ैसलों में से एक यह है कि आप अंतिम आउटपुट पर रेफ़रेंस इमेज को कितना नियंत्रण देते हैं। इसे denoise strength या image strength पैरामीटर नियंत्रित करता है, जो आम तौर पर 0.0 से 1.0 के बीच का मान होता है।
कम strength: स्रोत के करीब रहें
0.15 से 0.40 की strength वैल्यू पर, मॉडल सूक्ष्म बदलाव करता है। आप ये चीज़ें देख सकते हैं:
- कंपोज़िशन बदले बिना लाइटिंग एडजस्ट की जाती है
- कलर ग्रेडिंग बदलकर अलग मूड दिया जाता है
- छोटी-मोटी ऑब्जेक्ट जोड़ने या हटाने की प्रक्रिया
- टेक्सचर को नरम या शार्प किया जाता है
यह रेंज तब आदर्श है जब आपके पास एक अच्छी रेफ़रेंस फ़ोटो हो और आप उसे बदलने के बजाय उसे निखारना चाहते हों।
ज़्यादा strength: प्रॉम्प्ट को नियंत्रण दें
0.65 से 0.90 की strength वैल्यू पर, टेक्स्ट प्रॉम्प्ट हावी हो जाता है। मॉडल रेफ़रेंस इमेज का इस्तेमाल मुख्य रूप से ढीले स्ट्रक्चरल मार्गदर्शन के लिए करता है। आप ये देखेंगे:
- दृश्य नए तत्वों से पूरी तरह भर दिया जाता है
- सब्जेक्ट की पहचान में काफ़ी बदलाव
- परिवेश का पूरी तरह बदल जाना
- स्टाइल का पूरी तरह बदल जाना
💡 ज़्यादातर अनुभवी img2img उपयोगकर्ता 0.45-0.65 के सबसे अच्छे दायरे में काम करते हैं, जहाँ रेफ़रेंस और प्रॉम्प्ट का लगभग बराबर प्रभाव होता है, और नतीजे रैंडम के बजाय सोचे-समझे लगते हैं।
असल दुनिया के उपयोग
मॉडल बेहतर होने के साथ img2img के व्यावहारिक उपयोगों का दायरा बहुत बढ़ गया है।
प्रोडक्ट फ़ोटोग्राफ़ी रीटचिंग
ई-कॉमर्स फ़ोटोग्राफ़र एक ही रेफ़रेंस फ़ोटो से वैकल्पिक प्रोडक्ट शॉट जल्दी बनाने के लिए img2img का इस्तेमाल करते हैं। अलग-अलग बैकग्राउंड या अलग लाइटिंग में दोबारा शूट करने के बजाय, वे प्रोडक्ट फ़ोटो को depth या canny मॉडल में डालते हैं और प्रॉम्प्ट में नया परिवेश बताते हैं। प्रोडक्ट का आकार और अनुपात सुसंगत रहता है, जबकि दृश्य बदल जाता है।
पोर्ट्रेट वर्क और ब्यूटी रीटचिंग
हाई-एंड पोर्ट्रेट फ़ोटोग्राफ़र और रीटचर कम-strength वाले img2img पास का इस्तेमाल स्किन टोन निखारने, लाइट की दिशा ठीक करने, या सब्जेक्ट की समानता खोए बिना सूक्ष्म मूड बदलने के लिए करते हैं। Flux Redux Dev पोर्ट्रेट वैरिएशन को खास तौर पर अच्छी तरह संभालता है, क्योंकि इसकी फ़ीचर-स्तर की कंडीशनिंग जनरेशन प्रक्रिया के दौरान चेहरे के स्ट्रक्चर को बनाए रखती है।
आर्किटेक्चर और इंटीरियर डिज़ाइन विज़ुअलाइज़ेशन
आर्किटेक्ट एक ही स्पेशल लेआउट पर अलग-अलग फ़िनिश, मटीरियल और फ़र्नीचर व्यवस्था आज़माने के लिए depth-guided मॉडल का इस्तेमाल करते हैं। एक आर्किटेक्चरल फ़ोटो दर्जनों डिज़ाइन वैरिएशन का टेम्पलेट बन जाती है, और हर वैरिएशन में depth map के ज़रिए सटीक स्पेशल अनुपात बना रहता है।
PicassoIA पर img2img कैसे इस्तेमाल करें
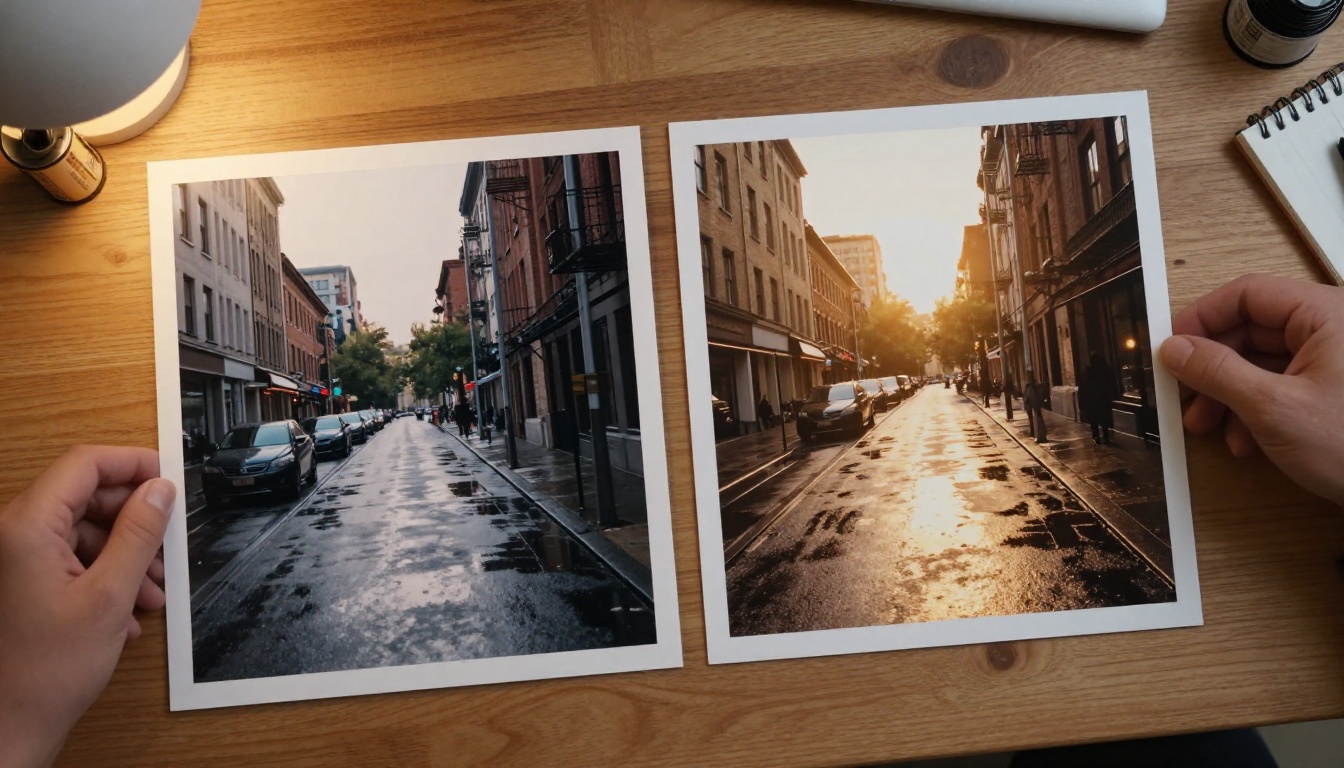
PicassoIA आपको बिना किसी सेटअप, लोकल GPU या तकनीकी जानकारी के सबसे अच्छे उपलब्ध img2img मॉडल तक सीधी पहुँच देता है। वैरिएशन के लिए Flux Redux Dev का इस्तेमाल ऐसे करें:
चरण 1: PicassoIA के मॉडल संग्रह में Flux Redux Dev पर जाएँ।
चरण 2: अपनी रेफ़रेंस इमेज अपलोड करें। यह फ़ोटो, रेंडर, स्केच, या कोई भी विज़ुअल हो सकता है जिसे आप स्ट्रक्चरल आधार के रूप में इस्तेमाल करना चाहते हैं।
चरण 3: आप जो आउटपुट चाहते हैं, उसका वर्णन करता टेक्स्ट प्रॉम्प्ट लिखें। लाइटिंग, मूड और स्टाइल के बारे में साफ़-साफ़ बताएँ। आपका प्रॉम्प्ट जितना सटीक होगा, मॉडल उसे रेफ़रेंस के साथ उतना ही बेहतर संतुलित कर पाएगा।
चरण 4: इमेज strength स्लाइडर समायोजित करें। बेसलाइन के रूप में 0.5 से शुरू करें। अगर आउटपुट मूल के बहुत करीब है, तो इसे बढ़ाएँ। अगर वह कंपोज़िशन खो रहा है जिसे आप बनाए रखना चाहते हैं, तो इसे घटाएँ।
चरण 5: जनरेट करें और इटरेट करें। img2img वर्कफ़्लो में लगभग हमेशा कई पास लगते हैं। पहले आउटपुट को दूसरे पास के लिए नई रेफ़रेंस के रूप में इस्तेमाल करें, ताकि कुछ खास हिस्सों को निखारा जा सके।
💡 प्रोडक्ट शॉट या आर्किटेक्चरल विज़ुअलाइज़ेशन जैसे स्ट्रक्चर-महत्वपूर्ण काम के लिए, Redux के बजाय Flux Depth Pro आज़माएँ। Depth कंडीशनिंग स्पेशल ज्यामिति को कहीं ज़्यादा सटीकता से बनाए रखती है।
लोग जो आम गलतियाँ करते हैं
img2img शुरू करते समय अनुभवी उपयोगकर्ता भी अक्सर इन्हीं समस्याओं में फँस जाते हैं।
strength को बहुत ज़्यादा रखना
सबसे आम गलती है denoise strength को 0.8 से ऊपर धकेलना, यह उम्मीद करते हुए कि मूल कंपोज़िशन बनी रहेगी और बदलाव भी नाटकीय होगा। इस स्तर पर रेफ़रेंस इमेज नतीजे पर मुश्किल से असर डालती है। आपको ऐसी इमेज मिलती है जो आपके टेक्स्ट प्रॉम्प्ट का पालन करती है, लेकिन मूल की लगभग कोई याद नहीं रखती। अगर आप कंपोज़िशन का सम्मान करते हुए बड़ा बदलाव चाहते हैं, तो Redux की strength को अधिकतम पर धकेलने के बजाय मध्यम strength पर depth या canny मॉडल का इस्तेमाल करें।
कम रिज़ॉल्यूशन वाली सोर्स इमेज का इस्तेमाल
मॉडल उन फ़ीचर्स पर कंडीशन होता है जो वह आपकी रेफ़रेंस से निकाल सकता है। धुंधली, कम रिज़ॉल्यूशन वाली इनपुट इमेज अस्पष्ट फ़ीचर कंडीशनिंग देती है, जिससे असंगत आउटपुट बनते हैं। हमेशा अपनी रेफ़रेंस इमेज का सबसे उच्च रिज़ॉल्यूशन वाला संस्करण इस्तेमाल करें। अगर आपको किसी कम-रेज़ इमेज को पहले अपस्केल करना है, तो PicassoIA के सुपर रिज़ॉल्यूशन टूल्स उसे img2img पाइपलाइन में डालने से पहले संभाल सकते हैं।
टेक्स्ट प्रॉम्प्ट को पूरी तरह नज़रअंदाज़ करना
कुछ उपयोगकर्ता रेफ़रेंस इमेज अपलोड करते हैं और टेक्स्ट प्रॉम्प्ट खाली या बहुत कम छोड़ देते हैं, यह उम्मीद करते हुए कि मॉडल सिर्फ़ इमेज से समझ जाएगा कि उन्हें क्या चाहिए। डीनॉइज़िंग की दिशा तय करने के लिए टेक्स्ट प्रॉम्प्ट के बिना, नतीजे अप्रत्याशित रहते हैं। "photorealistic portrait, natural lighting, sharp detail" जैसा संक्षिप्त विवरण भी सुसंगतता को काफ़ी बेहतर कर देता है।
आज़माने के लिए तैयार हैं
Image to image तकनीकी उपयोगकर्ताओं तक सीमित कोई खास फ़ीचर नहीं है। बेसिक टेक्स्ट-टू-इमेज जनरेशन से आगे बढ़ने के बाद, AI विज़ुअल्स के साथ काम करने का यह सबसे व्यावहारिक तरीका है। आपके पास एक मौजूदा फ़ोटो है जो लगभग सही है। आप उसका मूड, बैकग्राउंड, लाइटिंग या स्टाइल बदलना चाहते हैं। उसी के लिए img2img है।
PicassoIA के पास पूरा Flux img2img मॉडल परिवार इस्तेमाल के लिए तैयार है, जिसमें वैरिएशन के लिए Flux Redux Dev, edge-नियंत्रित जनरेशन के लिए Flux Canny Pro, स्पेशल सटीकता के लिए Flux Depth Pro, और सहज इनपेंटिंग के लिए Flux Fill Pro शामिल हैं। हर मॉडल सीधे आपके ब्राउज़र में उपलब्ध है, किसी इंस्टॉलेशन की ज़रूरत नहीं।
एक फ़ोटो अपलोड करें। एक प्रॉम्प्ट लिखें। 0.5 strength पर देखें कि क्या होता है। फिर वहीं से समायोजित करें।