ज़्यादातर AI इमेज जेनरेटर उसी पल बिखर जाते हैं जब आप एक ही फ़्रेम में दो लोगों को रखते हैं। शरीर आपस में मिल जाते हैं। चेहरे दोहराए जाते हैं। हाथ पहचान में न आने वाले धुंधले आकार बन जाते हैं। जिसने भी किसी स्टैंडर्ड टूल से +18 मल्टी-करैक्टर सीन बनाने की कोशिश की है, वह इस निराशा को जानता है: प्रॉम्प्ट में दो लोग लिखे होते हैं, लेकिन आउटपुट में मिलता है एक शारीरिक रूप से गड़बड़ नतीजा।
यह तब बदलता है जब आप सही मॉडल इस्तेमाल करते हैं।
एक ही सीन में कई किरदारों के लिए सबसे अच्छा +18 AI जेनरेटर को एक साथ कई काम करने होते हैं: हर आकृति की अलग पहचान बनाए रखना, स्पेशियल रिश्तों को सही समझना, दबाव में भी असली जैसी एनाटॉमी रेंडर करना, और आपके क्रिएटिव इरादे के प्रति वफ़ादार रहना। इस स्तर पर खरे उतरने वाले टूल ज़्यादा नहीं हैं। जो खरे उतरते हैं, उनके बारे में विस्तार से जानना फ़ायदेमंद है।
यह लेख बताता है कि कौन-से AI इमेज जेनरेटर +18 मल्टी-करैक्टर सीन में सच में अच्छा काम करते हैं, हर एक में क्या अलग है, और उनसे सबसे अच्छा आउटपुट कैसे निकाला जाए।
मल्टी-करैक्टर सीन मुश्किल क्यों हैं
वह तकनीकी दीवार जिससे ज़्यादातर मॉडल टकराते हैं
डिफ्यूज़न मॉडल पिक्सल के एक क्षेत्र को धीरे-धीरे डीनॉइज़ करके इमेज बनाते हैं। जब फ़्रेम में एक ही सब्जेक्ट होता है, तो मॉडल के पास काम करने के लिए अपेक्षाकृत साफ़ सिग्नल होता है। दूसरी आकृति जोड़ते ही वह सिग्नल जटिल हो जाता है। अब मॉडल को एनाटॉमी के दो सेट के प्रायर, त्वचा पर दो लाइट स्रोत, दो जोड़ी हाथ, दो चेहरे और उनके बीच का स्पेशियल रिश्ता संतुलित करना पड़ता है।
ज़्यादातर मॉडल ऐसे डेटासेट पर ट्रेन हुए हैं जिनमें अकेले सब्जेक्ट हावी हैं। जब उन्हें मल्टी-करैक्टर स्थिति में धकेला जाता है, तो वे औसत निकालकर काम चलाते हैं। नतीजा: शरीर के हिस्से आकृतियों के बीच रिसने लगते हैं, अलग-अलग किरदारों पर एक जैसे चेहरे दिखते हैं, या किसी एक व्यक्ति के तीन हाथ नज़र आते हैं।
जो मॉडल इसे अच्छी तरह संभालते हैं, वे या तो ज़्यादा समृद्ध मल्टी-फ़िगर डेटासेट पर ट्रेन हुए हैं, या अटेंशन सेपरेशन जैसे आर्किटेक्चर फ़ीचर सपोर्ट करते हैं, या ControlNet पोज़ रेफ़रेंस जैसे टूल्स के ज़रिए बाहरी कंट्रोल देते हैं।
एक सीन असल में कैसे काम करता है
एक सफल +18 मल्टी-करैक्टर इमेज में तीन चीज़ें एक साथ सही होनी चाहिए:
- साफ़ आकृति की सीमाएँ: हर व्यक्ति का शरीर एक स्वतंत्र एनाटॉमिकल इकाई की तरह दिखना चाहिए, आपस में मिला हुआ आकार नहीं।
- हर आकृति के लिए एक जैसी लाइटिंग: दोनों किरदार एक ही लाइट स्रोत के नीचे, भौतिक रूप से विश्वसनीय तरीके से होने चाहिए।
- सभी सब्जेक्ट पर प्रॉम्प्ट का पालन: अगर आप लिखते हैं "बाईं ओर ब्रूनेट महिला, दाईं ओर सुनहरे बालों वाली महिला", तो मॉडल को यह मानना चाहिए, न कि दोनों की जगह बदले या निर्देश को अनदेखा करे।
नीचे दिए गए मॉडल इन तीनों पर खरे उतरते हैं।
रैंकिंग के असली मापदंड
बड़े पैमाने पर एनाटॉमी की सटीकता
जैसे-जैसे किरदार बढ़ते हैं, एनाटॉमी जल्दी बिखरने लगती है। हाथ इसकी क्लासिक कमज़ोरी हैं, लेकिन कई आकृतियों के साथ आपको धड़ की लंबाई में गड़बड़ी, अंगों की गिनती की समस्याएँ और परस्पेक्टिव विकृतियाँ भी दिखती हैं, जहाँ एक ही गहराई पर खड़ी आकृतियाँ एक-सा स्केल नहीं रखतीं। इसके लिए सबसे अच्छे मॉडल उच्च-गुणवत्ता वाले मानव आकृति डेटासेट पर फ़ाइन-ट्यूनिंग के ज़रिए मज़बूत एनाटॉमिकल प्रायर अपने भीतर रखते हैं।
कई सब्जेक्ट के साथ प्रॉम्प्ट का पालन
जब दो या ज़्यादा किरदार हों, तब क्या मॉडल आपके सब्जेक्ट विवरण का सम्मान करता है? कमज़ोर मॉडल किरदारों के गुण आपस में मिला देते हैं। मज़बूत मॉडल हर जनरेशन में ब्रूनेट को ब्रूनेट और रेडहेड को रेडहेड बनाए रखते हैं। +18 कंटेंट के लिए यह ख़ास तौर पर अहम है, क्योंकि किरदार की पहचान और उनका अलग दिखना क्रिएटिव इरादे का हिस्सा है।
स्पीड बनाम क्वालिटी का समझौता
कुछ मॉडल हर इमेज के लिए 20-30 सेकंड लेते हैं। दूसरे 3-5 सेकंड में नतीजा दे देते हैं। ऐसे इटरेटिव क्रिएटिव काम के लिए, जहाँ आप प्रॉम्प्ट बदलते हैं और बार-बार रीजेनरेट करते हैं, स्पीड मायने रखती है। नीचे दिया ब्रेकडाउन बताता है कि हर मॉडल इस स्पेक्ट्रम पर कहाँ आता है।
+18 मल्टी-करैक्टर सीन के लिए शीर्ष मॉडल
💡 नीचे के सभी मॉडल सीधे PicassoIA पर उपलब्ध हैं। हर एक को मल्टी-करैक्टर आउटपुट क्वालिटी, एनाटॉमी हैंडलिंग और प्रॉम्प्ट के पालन के लिए परखा गया है।
फ़ोटोरियलिस्टिक मल्टी-करैक्टर सीन के लिए मौजूदा सबसे अच्छा मानक। Flux 1.1 Pro Ultra अल्ट्रा-हाई रेज़ोल्यूशन पर चलता है और ऐसे घने, डिटेल-भरे प्रॉम्प्ट के लिए बनाया गया है जिनकी मल्टी-फ़िगर सीन को ज़रूरत होती है। यह स्पेशियल भाषा को सटीकता से समझता है: "पीछे खड़ी", "एक-दूसरे की ओर मुँह करके" और "फ़्रेम की विपरीत तरफ़" जैसे वाक्यांश सुसंगत सीन ज्यामिति में बदल जाते हैं।
+18 कंटेंट के लिए इसकी ताकत स्किन टेक्सचर रेंडरिंग में है। रोमछिद्र, सबसर्फ़ेस स्कैटरिंग, व्यक्तियों के बीच प्राकृतिक रंगत का अंतर, ये सब उस स्तर पर संभाले जाते हैं जहाँ सस्ते मॉडल नहीं पहुँच पाते। कीमत है जनरेशन का समय: पूरी क्वालिटी पर प्रति इमेज 15-25 सेकंड की उम्मीद रखें। जब आउटपुट इतना साफ़ हो, तो हर सेकंड की कीमत चुकाना सार्थक लगता है।
सबसे अच्छा किसके लिए: ऐसे हाई-फ़िडेलिटी सीन जहाँ अंतिम आउटपुट लगभग फ़ोटो जैसा होना चाहिए। एडिटोरियल-स्टाइल मल्टी-करैक्टर शॉट्स, जटिल इनडोर लाइटिंग वाले परिदृश्य, और ऐसे कोई भी सीन जहाँ आप चाहते हैं कि दोनों आकृतियाँ किसी पेशेवर फ़ोटोग्राफ़र द्वारा खींचे गए असली लोगों जैसी दिखें।
दूसरी पीढ़ी के Flux मॉडल मल्टी-करैक्टर हैंडलिंग को और आगे ले जाते हैं। Flux 2 Pro स्पीड और आउटपुट क्वालिटी के बीच सबसे अच्छे संतुलन में बैठता है। Flux 2 Max थोड़ी जनरेशन स्पीड की कीमत पर ज़्यादा समृद्ध डिटेल और अधिक नियंत्रित एनाटॉमी देता है। दोनों मज़बूत आकृति-अलगाव बनाए रखते हैं और हर किरदार के कपड़ों, पोज़ और स्थिति के विस्तृत विवरणों पर अच्छी प्रतिक्रिया देते हैं।
वयस्क कंटेंट के लिए Flux 2 सीरीज़ इसलिए अलग दिखती है कि इसमें स्पेशियल रिश्तों की हैंडलिंग बेहतर है। किरदारों के बीच शारीरिक नज़दीकी वाले सीन, जैसे साथ बैठना, पास खड़ा होना, फ़्रेम में एक-दूसरे पर ओवरलैप करना, पिछली पीढ़ी के मॉडलों की तुलना में कहीं ज़्यादा बार ज्यामितीय रूप से सही बॉडी पोज़िशनिंग के साथ रेंडर होते हैं।
सबसे अच्छा किसके लिए: इटरेटिव क्रिएटिव वर्कफ़्लो, जहाँ कई जनरेशन में भरोसेमंद नतीजे चाहिए। दो आकृतियों वाले ऐसे सीन जिनमें नज़दीकी या शारीरिक इंटरैक्शन हो।
अगर फ़ोटोरियलिज़्म प्राथमिकता है और आपको स्पीड भी चाहिए, तो RealVisXL v3.0 Turbo वह मॉडल है जिसे चुनना चाहिए। SDXL आर्किटेक्चर पर बना और भारी फ़ोटोरियलिस्टिक फ़ाइन-ट्यूनिंग के साथ, इसे ख़ास तौर पर असली दुनिया की फ़ोटोग्राफ़ी डेटासेट पर ट्रेन किया गया है। इसके आउटपुट में किसी पेशेवर कैमरे जैसी टेक्सचर, लाइटिंग और रंग-विज्ञान होता है।
+18 मल्टी-करैक्टर सीन के लिए RealVisXL प्राकृतिक, लाइफ़स्टाइल-शैली की कंपोज़िशन के साथ ख़ास तौर पर अच्छा काम करता है: समुद्र तट पर समूह, कैंडिड इनडोर शॉट्स, एडिटोरियल फ़ोटोग्राफ़ी की नक़ल करने वाले सीन। "Turbo" वैरिएंट 3-8 सेकंड में जनरेट करता है, बिना उस क्वालिटी गिरावट के जिसकी आप डिस्टिल्ड मॉडल से उम्मीद कर सकते हैं।
सबसे अच्छा किसके लिए: तेज़ इटरेशन। लाइफ़स्टाइल और कैंडिड-शैली के मल्टी-फ़िगर सीन। जब आपको एनाटॉमी और स्किन टेक्सचर में विश्वसनीयता खोए बिना बड़ी मात्रा में आउटपुट चाहिए।
यह +18 मल्टी-करैक्टर कंटेंट के लिए पावर यूज़र का विकल्प है। SDXL Multi ControlNet LoRA आपको जनरेशन पाइपलाइन में सीधे रेफ़रेंस पोज़ डालने देता है, यानी आप नियंत्रित कर सकते हैं कि हर किरदार कहाँ स्थित है, कैसे खड़ा या बैठा है, और फ़्रेम में उसके शरीर एक-दूसरे से कैसे जुड़े हैं।
मल्टी-करैक्टर +18 सीन के लिए यह बदल देने वाला है। यह उम्मीद करने के बजाय कि मॉडल "वह उसकी ओर दाईं तरफ़ से झुकती है" को सही समझेगा, आप पोज़ स्केलेटन रेफ़रेंस देते हैं और मॉडल उसे सटीक रूप से फ़ॉलो करता है। किसी ख़ास एस्थेटिक स्टाइल के लिए LoRA फ़ाइन-ट्यूनिंग के साथ मिलाने पर यह ऐसा कंपोज़िशनल कंट्रोल देता है जो कोई केवल-प्रॉम्प्ट मॉडल नहीं दे सकता।
💡 मल्टी-करैक्टर सीन में बॉडी मर्ज होने की गलतियाँ ख़त्म करने का ControlNet सबसे कारगर टूल है। अगर आप इस तरह का कंटेंट गंभीरता से बना रहे हैं, तो इसे अपने वर्कफ़्लो में जोड़ें।
सबसे अच्छा किसके लिए: सटीक कंपोज़िशनल कंट्रोल। कस्टम किरदार पोज़िशनिंग। प्रो-ग्रेड मल्टी-फ़िगर सीन जहाँ पोज़ की सटीकता से समझौता नहीं हो सकता।
सालों से कम्युनिटी का पसंदीदा, Realistic Vision v5.1 मल्टी-करैक्टर आउटपुट में अपनी श्रेणी से कहीं ऊपर प्रदर्शन करता है। ख़ास तौर पर हाइपर-रियलिस्टिक मानव आकृतियों के लिए फ़ाइन-ट्यून किए जाने से वह नींव साफ़ दिखती है, जब फ़्रेम में दो या अधिक किरदार हों। शरीर का अनुपात बना रहता है। त्वचा के रंग अलग-अलग रहते हैं। चेहरे पूरी कंपोज़िशन में अपनी अलग पहचान बनाए रखते हैं।
यह इस सूची का सबसे तेज़ या सबसे ऊँचे रेज़ोल्यूशन वाला मॉडल नहीं है, लेकिन इसकी कंसिस्टेंसी उल्लेखनीय है। बिना ट्रेन किए गए बेस मॉडल की तुलना में आपको कहीं ज़्यादा प्रतिशत जनरेशन में इस्तेमाल लायक आउटपुट मिलेंगे। जो लोग जटिल सीन के लिए अपने प्रॉम्प्ट कौशल को निखार रहे हैं, उनके लिए यह एक बेहतरीन शुरुआती बिंदु है।
सबसे अच्छा किसके लिए: भरोसेमंद, विश्वसनीय मानव आकृतियाँ। ऐसे सीन जिन्हें जनरेशन के पूरे बैच में एनाटॉमिकल भरोसेमंदी चाहिए।
Stable Diffusion 3.5 Large ने एक मल्टीमोडल आर्किटेक्चर पेश किया जो पिछले SD वर्ज़न की तुलना में टेक्स्ट और विज़ुअल जानकारी को अधिक सुसंगत तरीके से प्रोसेस करता है। इसका सीधा फ़ायदा मल्टी-करैक्टर हैंडलिंग में मिलता है: मॉडल "एक-दूसरे की ओर मुँह किए दो महिलाएँ" जैसे रिश्ते बताने वाले वाक्यों को अलग-अलग असंबंधित सब्जेक्ट प्रॉम्प्ट नहीं, बल्कि एक स्पेशियल विवरण के रूप में पढ़ता है।
3.5 Large वैरिएंट में उच्च पैरामीटर संख्या है, जिससे उसके पास हर व्यक्तिगत आकृति के विवरण को एक-दूसरे में रिसने दिए बिना दर्शाने की ज़्यादा क्षमता है। जिन सीन में किरदारों के बीच कथात्मक रिश्ते हों, जैसे एक आकृति दूसरी को देख रही हो, या एक दूसरी की ओर हाथ बढ़ा रही हो, वे ज़्यादातर प्रतिस्पर्धी मॉडलों से बेहतर सुसंगति के साथ रेंडर होते हैं।
सबसे अच्छा किसके लिए: विशिष्ट स्पेशियल पोज़िशनिंग वाले जटिल सीन विवरण। ऐसे सीन जहाँ किरदारों के बीच का कथात्मक रिश्ता विज़ुअल जितना ही मायने रखता है।
और भी मॉडल जो आज़माने लायक हैं
Flux 1.1 Pro Ultra से ग्रुप सीन कैसे बनाएँ
चूँकि इस उपयोग के लिए Flux 1.1 Pro Ultra शीर्ष रैंकिंग वाला मॉडल है, यहाँ PicassoIA पर सबसे अच्छे नतीजे पाने के लिए चरण-दर-चरण ब्रेकडाउन है।
चरण 1: हर किरदार के लिए अलग विवरण लिखें
सबसे बड़ी प्रॉम्प्ट गलती है कई किरदारों को एक ही विवरण ब्लॉक मान लेना। इसके बजाय हर किरदार को अलग से संबोधित करें:
कमज़ोर प्रॉम्प्ट: समुद्र तट पर बिकिनी में दो महिलाएँ
मज़बूत प्रॉम्प्ट: महिला 1: लंबी, गहरे घुंघराले बाल, गहरी जैतूनी त्वचा, काली स्ट्रिंग बिकिनी, पानी के किनारे खड़ी। महिला 2: छोटे कद की, सुनहरे बालों का छोटा पिक्सी कट, फ़्रेकल्स वाली हल्की त्वचा, लाल बैंडो बिकिनी, महिला 1 के बाईं ओर तौलिये पर बैठी। दोनों हँसते हुए, एक-दूसरे की ओर मुँह किए हुए।
मॉडल डिस्क्रिप्टर को टोकन अनुक्रम के रूप में प्रोसेस करता है। जितने ज़्यादा विशिष्ट और अलग-अलग विवरण होंगे, मॉडल को उतने ही साफ़ इनपुट मिलेंगे और उतने ही अलग किरदार बनेंगे।
चरण 2: सीन की ज्यामिति तय करें
किरदारों का वर्णन करने के बाद, उस स्पेशियल फ़्रेम का वर्णन करें जिसमें वे मौजूद हैं:
- कैमरा पोज़िशन: घुटने की ऊँचाई से लो-एंगल शॉट
- सापेक्ष स्थिति: महिला 1 महिला 2 से तीन फ़ुट आगे खड़ी
- वातावरण: देर दोपहर का समुद्र तट, गीली रेत, पृष्ठभूमि में लहरें
- लाइटिंग: कैमरा-बाईं ओर से गोल्डन आवर की रोशनी, जो दोनों आकृतियों पर पड़ रही हो
यह मॉडल को एक सुसंगत स्पेशियल ढाँचा देता है जिसमें वह दोनों किरदारों को रख सके, बजाय इसके कि वह उन्हें बस उसके डिफ़ॉल्ट की जगहों पर रख दे।
चरण 3: तकनीकी फ़ोटोग्राफ़ी डिस्क्रिप्टर जोड़ें
Flux 1.1 Pro Ultra फ़ोटोग्राफ़ी-शैली की भाषा पर मज़बूती से प्रतिक्रिया देता है। अपने प्रॉम्प्ट के अंत में ऐसे डिस्क्रिप्टर लिखें:
Canon EOS R5 पर शूट, 85mm f/1.8 पोर्ट्रेट लेंस, प्राकृतिक स्किन टेक्सचर, Kodak Portra 400 फ़िल्म ग्रेन, RAW 8K फ़ोटोग्राफ़ी
ये टोकन मॉडल के आउटपुट को फ़ोटोरियलिस्टिक रेंडरिंग की ओर और जेनेरिक AI-आर्ट सौंदर्य से दूर ले जाते हैं।
प्रॉम्प्ट की रणनीतियाँ जो सच में काम करती हैं
हर किरदार को स्पष्ट रूप से टैग करें
कई अनुभवी उपयोगकर्ता अपने प्रॉम्प्ट में किरदारों को नंबर देते हैं: [Character 1: ...] [Character 2: ...]। इस ब्रैकेट संरचना का ज़्यादातर मॉडलों में कोई ख़ास सिंटैक्स अर्थ नहीं होता, लेकिन विज़ुअल अलगाव मॉडल के अटेंशन मैकेनिज़्म को जनरेशन के दौरान दोनों किरदार विवरणों को अलग रखने में मदद करता है।
एक विकल्प है दिशात्मक एंकर का इस्तेमाल: "बाईं ओर", "दाईं ओर", "अग्रभूमि में", "उसके पीछे" जैसे शब्द मॉडल को ज्यामितीय हुक देते हैं, जिनसे वह हर विवरण को फ़्रेम में किसी ख़ास स्थान से जोड़ सकता है।
लाइटिंग को लॉक करें
एनाटॉमी के आपस में मिल जाने के बाद, मल्टी-करैक्टर सीन में दूसरी सबसे आम विफलता असंगत लाइटिंग है। अगर आपके सीन में एक ही प्रमुख लाइट स्रोत है, तो उसे साफ़-साफ़ बताएँ:
खिड़की से ऊपर-बाईं ओर से आती वोल्यूमेट्रिक सुबह की रोशनी, जो दोनों आकृतियों पर पड़ रही हो। हर चेहरे की दाईं ओर नरम परछाइयाँ। गर्म 5600K कलर टेम्परेचर।
लाइट स्रोत को जितना सटीक परिभाषित करेंगे, उतनी ही संभावना होगी कि दोनों आकृतियाँ एक ही भौतिक रूप से सुसंगत लाइटिंग स्थिति में रेंडर हों।
"डायरेक्टोरियल" प्रॉम्प्ट तरीका
इमेज को पेंटिंग की तरह वर्णित करने के बजाय, सीन को ऐसे वर्णित करें जैसे कोई फ़िल्म डायरेक्टर निर्देश दे रहा हो:
कैमरा छाती की ऊँचाई पर है, हल्के ऊपर की ओर इशारा करता हुआ। दो महिलाएँ, 20 के दशक के मध्य में, एक सफ़ेद सोफ़े के विपरीत छोरों पर बैठी हैं। बाईं ओर वाली सीधे कैमरे में देख रही है। दाईं ओर वाली अपनी साथी को देख रही है। कैमरा-दाईं ओर से आती प्राकृतिक खिड़की की रोशनी दोनों को समान रूप से रोशन करती है।
यह तरीका उल्लेखनीय रूप से सुसंगत नतीजे देता है, क्योंकि यह मॉडल को दोनों एक परिप्रेक्ष्य एंकर (कैमरे की स्थिति) और एक कथात्मक एंकर (कौन किसे कहाँ और क्यों देख रहा है) देता है। मॉडल विज़ुअल डिटेल भरता है; दिशा आप तय करते हैं।
मॉडल की तुलना एक नज़र में
आम गलतियाँ जो मल्टी-करैक्टर आउटपुट बिगाड़ देती हैं
विवरण मिला देना: "दो खूबसूरत लंबे काले बालों वाली महिलाएँ" लिखना, बिना उनके बीच अलग पहचान वाले गुणों के, एक मिला-जुला, औसत नतीजा देगा। हर किरदार को कम से कम तीन अलग पहचानकर्ता दें: बालों का रंग, त्वचा का रंग, कपड़ों का रंग या स्टाइल।
नेगेटिव प्रॉम्प्ट छोड़ना: ज़्यादातर मॉडल नेगेटिव प्रॉम्प्ट सपोर्ट करते हैं। इनका खुलकर इस्तेमाल करें: extra limbs, duplicate faces, merged bodies, blurry features, disfigured, conjoined, extra arms मानक ब्लॉकर हैं, जो मॉडल को उसकी अपनी एनाटॉमिकल विफलता वाली राहों से दूर रखने में मदद करते हैं।
सीन को ज़रूरत से ज़्यादा भरना: एक सीन में तीन से ज़्यादा किरदार होने से सभी मॉडलों में त्रुटि दर काफ़ी बढ़ जाती है। चार या अधिक आकृतियों के लिए ControlNet पोज़ रेफ़रेंस इस्तेमाल करें, और अगर मॉडल सपोर्ट करता है तो स्टेप काउंट बढ़ाएँ।
लाइटिंग एंकर भूलना: साफ़ लाइटिंग के बिना मॉडल अक्सर हर आकृति को थोड़ी अलग रोशनी में रेंडर करेगा, जिससे सीन एकीकृत दिखने के बजाय जोड़ा हुआ, टुकड़ों जैसा दिखता है। एक अच्छी तरह वर्णित, अकेला लाइट स्रोत किसी भी मल्टी-करैक्टर प्रॉम्प्ट के लिए सबसे असरदार सुधारों में से एक है।
अस्पष्ट स्थिति वाली भाषा इस्तेमाल करना: "एक-दूसरे के पास" उपयोगी नहीं है। "महिला 1 बाईं ओर, कैमरे की ओर तीन-चौथाई कोण पर; महिला 2 दाईं ओर, महिला 1 की ओर मुँह करके" मॉडल को वह असली ज्यामिति देता है जिस पर वह काम कर सके।
+18 श्रेणी असल में क्या माँगती है
सुझावात्मक वयस्क कंटेंट और स्पष्ट कंटेंट में एक अर्थपूर्ण अंतर है। इस लेख में रैंक किए गए मॉडल एक विस्तृत स्पेक्ट्रम पर सक्षम हैं, लेकिन सुझावात्मक छोर पर मल्टी-करैक्टर नतीजे काफ़ी ज़्यादा सुसंगत आते हैं और उन्हें बहुत कम पोस्ट-प्रोसेसिंग सुधार की ज़रूरत होती है।
ऐसे सीन जिनमें:
- स्विमवियर और लिंजरी: सभी शीर्ष मॉडलों में उच्च सफलता दर। प्राकृतिक पोज़, समुद्र तट की सेटिंग, अंतरंग इनडोर माहौल। जब हर आकृति को अलग से वर्णित किया जाए, तो एनाटॉमी अच्छी तरह टिकती है।
- निहित अंतरंगता: दो किरदार पास-पास, उपयुक्त बॉडी लैंग्वेज, जानबूझकर आँखों का संपर्क। Flux 1.1 Pro Ultra और RealVisXL v3.0 Turbo के साथ सबसे अच्छा काम करता है।
- कलात्मक कंपोज़िशन: आंशिक रूप से कपड़ों में आकृतियाँ, सिल्हूट लाइटिंग, नाटकीय परछाइयाँ। SD 3.5 Large और Flux 2 Max इस श्रेणी को सबसे ज़्यादा सौंदर्य नियंत्रण के साथ संभालते हैं।
तीनों श्रेणियों में निर्णायक कारक विशिष्टता है। आप सीन, कपड़ों, लाइटिंग और हर किरदार की बॉडी लैंग्वेज को जितना सटीक वर्णित करेंगे, आउटपुट उतना ही साफ़ और उतना ही सोचा-समझा बनेगा।
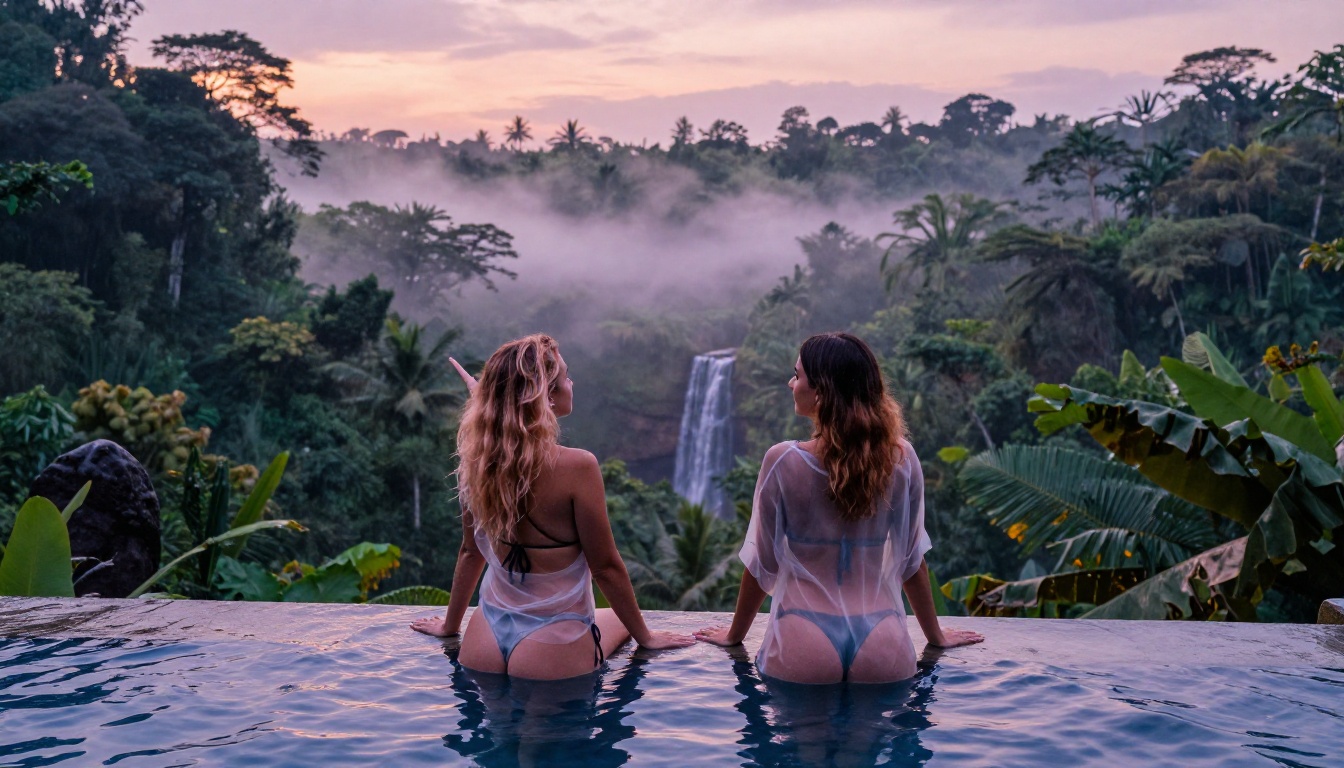
PicassoIA पर अपने खुद के मल्टी-करैक्टर सीन बनाएँ
इस लेख में बताया गया हर मॉडल सीधे PicassoIA के टेक्स्ट-टू-इमेज संग्रह में उपलब्ध है। किसी लोकल GPU सेटअप की ज़रूरत नहीं। कोई इंस्टॉल नहीं। हर मॉडल बस कुछ क्लिक दूर है और चलाने के लिए तैयार है।
जब आपको सबसे उच्च-गुणवत्ता वाला आउटपुट चाहिए, तो Flux 1.1 Pro Ultra से शुरुआत करें। जब आप कई प्रॉम्प्ट वेरिएशन में तेज़ी से इटरेट कर रहे हों, तो RealVisXL v3.0 Turbo इस्तेमाल करें। जैसे ही आपको यह सटीक नियंत्रण चाहिए कि हर किरदार कहाँ खड़ा है और फ़्रेम में उनके शरीर एक-दूसरे से कैसे जुड़ते हैं, SDXL Multi ControlNet LoRA की ओर बढ़ें।
इस लेख की प्रॉम्प्ट रणनीतियाँ, यानी किरदार टैगिंग, लाइटिंग एंकर और डायरेक्टोरियल तरीका, हर उस मॉडल पर लागू होती हैं जिसे आप आज़माएँगे। दो आकृतियों से किसी सरल सेटिंग में शुरू करें। प्रॉम्प्ट की संरचना सही करें। फिर ज़्यादा किरदारों, ज़्यादा लाइटिंग और ज़्यादा कथा वाले जटिल सीन की ओर बढ़ें। औज़ार तैयार हैं। उनसे क्या बनाते हैं, यह आप पर है।


