A maioria dos geradores de imagens por IA deixa de funcionar no momento em que você coloca duas pessoas no mesmo quadro. Os corpos se fundem. Os rostos se duplicam. As mãos viram borrões irreconhecíveis. Quem já tentou criar uma cena +18 com vários personagens usando uma ferramenta comum conhece a frustração: o prompt pede duas pessoas, e o resultado entrega uma catástrofe anatômica.
Isso muda quando você usa o modelo certo.
O melhor gerador de IA +18 para várias personagens em uma cena precisa fazer várias coisas ao mesmo tempo: manter identidades distintas para cada figura, interpretar corretamente as relações espaciais, renderizar anatomia realista sob pressão e permanecer fiel à sua intenção criativa. Poucas ferramentas atingem esse padrão. As que atingem merecem ser conhecidas em detalhe.
Este artigo analisa quais geradores de imagens por IA realmente entregam cenas +18 com várias personagens, o que diferencia cada um e como extrair o melhor resultado de cada um deles.
O muro técnico que a maioria dos modelos enfrenta
Modelos de difusão geram imagens removendo ruído de um campo de pixels de forma progressiva. Quando um único sujeito ocupa o quadro, o modelo tem um sinal relativamente limpo para trabalhar. Adicione uma segunda figura e esse sinal fica complexo. Agora o modelo precisa equilibrar dois conjuntos de prioridades anatômicas, duas fontes de luz sobre a pele, dois pares de mãos, dois rostos e uma relação espacial entre eles.
A maioria dos modelos foi treinada com conjuntos de dados dominados por sujeitos sozinhos. Quando são forçados a lidar com várias personagens, eles compensam fazendo médias. O resultado: partes do corpo que vazam entre as figuras, rostos idênticos em personagens diferentes ou uma pessoa que parece ter três braços.
Os modelos que lidam bem com isso foram treinados em conjuntos de dados mais ricos com várias figuras, oferecem recursos arquitetônicos como separação de atenção ou permitem controle externo por meio de ferramentas como as referências de pose do ControlNet.
O que faz uma cena realmente funcionar
Uma imagem +18 bem-sucedida com várias personagens precisa de três coisas trabalhando em harmonia:
- Limites de figura bem definidos: o corpo de cada pessoa deve ser lido como um sistema anatômico autocontido, não como uma forma fundida.
- Iluminação consistente por figura: as duas personagens devem estar sob a mesma fonte de luz de forma fisicamente crível.
- Aderência ao prompt entre os sujeitos: se você escreve "mulher morena à esquerda, mulher loira à direita", o modelo deve respeitar isso, e não trocá-las nem ignorar a instrução.
Os modelos ranqueados abaixo são os que entregam os três.
Os critérios reais para o ranking
Precisão anatômica em escala
A anatomia se desfaz rapidamente com mais personagens. As mãos são o ponto clássico de falha, mas com várias figuras também surgem erros no comprimento do tronco, problemas na quantidade de membros e distorções de perspectiva, em que figuras na mesma profundidade não compartilham a mesma escala. Os melhores modelos para isso têm fortes prioridades anatômicas incorporadas por meio de fine-tuning em conjuntos de dados de figuras humanas de alta qualidade.
Aderência ao prompt com vários sujeitos
O modelo respeita suas descrições dos sujeitos quando há dois ou mais? Modelos fracos misturam as características dos personagens. Modelos fortes mantêm a morena como morena e a ruiva como ruiva em todas as gerações. Isso é especialmente crítico em conteúdo +18, em que a identidade e a distinção dos personagens fazem parte da intenção criativa.
Velocidade ou qualidade: a contrapartida
Alguns modelos levam de 20 a 30 segundos por imagem. Outros entregam em 3 a 5 segundos. Para um trabalho criativo iterativo, em que você ajusta prompts e gera novamente com frequência, a velocidade importa. A análise abaixo indica onde cada modelo se situa nesse espectro.
💡 Todos os modelos abaixo estão acessíveis diretamente no PicassoIA. Cada um foi testado quanto à qualidade de saída com várias personagens, ao tratamento da anatomia e à aderência ao prompt.
O atual padrão-ouro para cenas fotorrealistas com várias personagens. O Flux 1.1 Pro Ultra opera em resolução ultra alta e foi criado para o tipo de prompt denso e cheio de detalhes que cenas com várias figuras exigem. Ele lida com a linguagem espacial com precisão: expressões como "de pé atrás", "de frente um para o outro" e "em lados opostos do quadro" se traduzem em uma geometria de cena coerente.
Para conteúdo +18, sua força está na renderização da textura da pele. Poros, dispersão subsuperficial, variação natural de tom entre indivíduos: tudo tratado em um nível que modelos mais baratos não alcançam. A contrapartida é o tempo de geração: espere de 15 a 25 segundos por imagem em qualidade máxima. Vale cada segundo quando o resultado é tão limpo.
Ideal para: cenas de alta fidelidade em que o resultado final precisa ser quase fotográfico. Fotos com várias personagens em estilo editorial, cenários de iluminação interna complexa e qualquer cena em que você queira que as duas figuras pareçam pessoas reais fotografadas por um profissional.
Os modelos Flux de segunda geração levam o tratamento de várias personagens ainda mais longe. O Flux 2 Pro fica no ponto ideal entre velocidade e qualidade de saída. O Flux 2 Max sacrifica um pouco da velocidade de geração em troca de mais detalhes e de uma anatomia mais controlada. Ambos mantêm boa separação entre as figuras e respondem bem a descrições detalhadas de roupa, pose e posicionamento de cada personagem.
Onde a série Flux 2 se destaca em conteúdo adulto é no tratamento aprimorado de relações espaciais. Cenas que envolvem proximidade física entre personagens (sentados juntos, em pé bem próximos, sobrepostos no quadro) são renderizadas com posicionamento corporal geometricamente correto com muito mais frequência do que em modelos de gerações anteriores.
Ideal para: fluxos de trabalho criativos iterativos, em que você precisa de resultados confiáveis ao longo de várias gerações. Cenas com duas figuras em proximidade ou interação física.
Se o fotorrealismo é a prioridade e você quer velocidade, o RealVisXL v3.0 Turbo é o modelo a escolher. Construído sobre a arquitetura SDXL, com um fine-tuning fotorrealista intenso, foi treinado especificamente com conjuntos de dados de fotografia do mundo real. O resultado tem a textura, a iluminação e a ciência de cor de uma câmera profissional.
Para cenas +18 com várias personagens, o RealVisXL se sai particularmente bem em composições naturais e de estilo lifestyle: grupos na praia, fotos internas espontâneas, cenas que imitam a fotografia editorial. A variante "Turbo" gera em 3 a 8 segundos sem a queda de qualidade que você esperaria de um modelo destilado.
Ideal para: iteração rápida. Cenas com múltiplas figuras em estilo lifestyle e espontâneo. Quando você precisa de volume sem abrir mão de credibilidade na anatomia e na textura da pele.
Esta é a opção para usuários avançados em conteúdo +18 com várias personagens. O SDXL Multi ControlNet LoRA permite alimentar referências de pose diretamente no pipeline de geração, o que significa que você pode controlar exatamente onde cada personagem está posicionada, como está em pé ou sentada e como os corpos se relacionam no espaço.
Para cenas +18 com várias personagens, isso é transformador. Em vez de torcer para que o modelo interprete corretamente "ela se inclina em direção a ele a partir da direita", você fornece uma referência de esqueleto de pose e o modelo a segue com precisão. Combinado com o LoRA de fine-tuning para estilos estéticos específicos, este modelo oferece um nível de controle de composição que nenhum modelo baseado apenas em prompt consegue igualar.
💡 O ControlNet é a ferramenta mais eficaz para eliminar erros de fusão corporal em cenas com várias personagens. Se você leva esse tipo de conteúdo a sério, inclua-o no seu fluxo de trabalho.
Ideal para: controle composicional preciso. Posicionamento personalizado de personagens. Cenas com várias figuras em qualidade profissional, em que a precisão da pose é inegociável.
Um favorito da comunidade há anos, o Realistic Vision v5.1 supera em muito o que se espera de sua categoria em resultados com várias personagens. Ajustado especificamente para produzir figuras humanas hiper-realistas, esse fundamento aparece com clareza quando você coloca duas ou mais personagens no quadro. As proporções do corpo se mantêm. Os tons de pele continuam distintos. Os rostos preservam a identidade individual em toda a composição.
Não é o mais rápido nem o de maior resolução desta lista, mas sua consistência é notável. Você obterá resultados utilizáveis em uma porcentagem significativamente maior de gerações em comparação com modelos base sem treinamento específico. Para quem está desenvolvendo habilidades de prompt para cenas complexas, este é um excelente ponto de partida.
Ideal para: figuras humanas consistentes e confiáveis. Cenas que precisam de confiabilidade anatômica ao longo de um lote de gerações.
O Stable Diffusion 3.5 Large introduziu uma arquitetura multimodal que processa texto e informação visual de forma mais coerente do que as versões anteriores do SD. Isso se traduz diretamente em um melhor tratamento de várias personagens: o modelo lê frases relacionais como "duas mulheres de frente uma para a outra" como uma descrição espacial, e não como dois prompts separados e sem relação entre si.
A variante 3.5 Large se beneficia de uma contagem alta de parâmetros, o que lhe dá mais capacidade de representar detalhes de cada figura sem que eles se misturem. Cenas com relações narrativas entre personagens (uma figura olhando para a outra, uma alcançando a outra) são renderizadas com mais coerência do que na maioria dos modelos concorrentes.
Ideal para: descrições de cena complexas com posicionamento relacional específico. Cenas em que a relação narrativa entre as personagens importa tanto quanto o visual.
Outros modelos que vale testar
| Modelo | Ponto forte | Velocidade |
|---|
| Flux Dev | Qualidade equilibrada, forte suporte a LoRA | Média |
| Flux Dev LoRA | Injeção de estilo personalizado nas cenas | Média |
| Flux Schnell | A variante mais rápida do Flux para rascunhos rápidos | Muito rápida |
| SDXL | Amplo ecossistema de fine-tunes da comunidade | Rápida |
| Flux Kontext Pro | Edição de cenas existentes por texto | Média |
| Ideogram v3 Quality | Renderização de cenas artísticas e muito detalhadas | Lenta |
Como usar o Flux 1.1 Pro Ultra para cenas em grupo
Como o Flux 1.1 Pro Ultra é o modelo mais bem ranqueado para este caso de uso, aqui está um passo a passo para obter os melhores resultados no PicassoIA.
Passo 1: escreva descrições separadas para cada personagem
O maior erro de prompt é tratar várias personagens como um único bloco de descrição. Em vez disso, descreva cada personagem separadamente:
Prompt fraco: Duas mulheres de biquíni na praia
Prompt forte: Mulher 1: alta, cabelo cacheado escuro, pele morena oliva, biquíni preto de tiras, de pé na beira da água. Mulher 2: baixa, cabelo curto loiro estilo pixie, pele clara com sardas, biquíni vermelho tomara que caia, sentada em uma toalha à esquerda da Mulher 1. Ambas rindo, de frente uma para a outra.
O modelo processa os descritores como sequências de tokens. Descrições mais específicas e mais separadas lhe dão entradas mais limpas e produzem personagens mais distintas.
Passo 2: ancore a geometria da cena
Depois de descrever suas personagens, descreva o quadro espacial em que elas existem:
- Posição da câmera: plano baixo, na altura dos joelhos
- Posicionamento relativo: Mulher 1 em pé a cerca de 90 centímetros à frente da Mulher 2
- Ambiente: praia no fim da tarde, areia molhada, ondas ao fundo
- Iluminação: luz dourada da hora mágica vinda da esquerda da câmera, incidindo sobre as duas figuras
Isso dá ao modelo um modelo espacial coerente no qual projetar as duas personagens, em vez de deixá-las onde o modelo as posiciona por padrão.
Passo 3: adicione descritores técnicos de fotografia
O Flux 1.1 Pro Ultra responde fortemente a uma linguagem de estilo fotográfico. Termine seu prompt com descritores como:
Fotografado com Canon EOS R5, lente de retrato 85mm f/1.8, textura natural da pele, granulação do filme Kodak Portra 400, fotografia RAW 8K
Esses tokens puxam a saída do modelo para a renderização fotorrealista e a afastam da estética genérica de arte por IA.
Estratégias de prompt que realmente funcionam
Marque cada personagem explicitamente
Muitos usuários experientes numeram suas personagens nos prompts: [Character 1: ...] [Character 2: ...]. Essa estrutura de colchetes não tem nenhum significado sintático especial na maioria dos modelos, mas a separação visual ajuda o mecanismo de atenção do modelo a manter as duas descrições de personagem distintas durante a geração.
Uma alternativa é usar âncoras direcionais: "à esquerda", "à direita", "em primeiro plano", "atrás dela" dão ao modelo ganchos geométricos para fixar cada descrição em uma posição específica do quadro.
Trave sua iluminação
A iluminação inconsistente é a segunda falha mais comum em cenas com várias personagens, depois da fusão anatômica. Se sua cena tem uma única fonte de luz dominante, declare-a com clareza:
Luz volumétrica da manhã vinda da janela superior esquerda, incidindo sobre as duas figuras. Sombras suaves no lado direito de cada rosto. Temperatura de cor de 5600K.
Quanto mais precisamente você definir a fonte de luz, mais provável é que as duas figuras sejam renderizadas sob as mesmas condições de iluminação fisicamente coerentes.
O método de prompt "diretorial"
Em vez de descrever a imagem como uma pintura, descreva a cena como um diretor de cinema dando instruções:
A câmera está na altura do peito, apontando levemente para cima. Duas mulheres, na faixa dos 20 e poucos anos, estão sentadas nas extremidades opostas de um sofá branco. A da esquerda olha diretamente para a câmera. A da direita olha para a companheira. A luz natural da janela, vinda da direita da câmera, ilumina as duas de forma uniforme.
Esse método produz resultados notavelmente consistentes porque oferece ao modelo uma âncora de perspectiva (a posição da câmera) e uma âncora narrativa (quem olha para onde e por quê). O modelo preenche os detalhes visuais; você controla a direção.
Comparação de modelos num relance
Mesclar descrições: escrever "duas mulheres lindas de cabelo comprido e escuro" sem características distintivas entre elas produzirá um resultado fundido e com média. Dê sempre a cada personagem pelo menos três diferenciais: cor do cabelo, tom de pele, cor ou estilo da roupa.
Não usar prompts negativos: a maioria dos modelos oferece suporte a prompts negativos. Use-os com firmeza: extra limbs, duplicate faces, merged bodies, blurry features, disfigured, conjoined, extra arms são bloqueadores padrão que ajudam a afastar o modelo de suas próprias falhas anatômicas.
Sobrecarregar a cena: mais de três personagens em uma cena aumentam significativamente a taxa de erro em todos os modelos. Para quatro ou mais figuras, use referências de pose do ControlNet e aumente o número de passos se o modelo permitir.
Esquecer a âncora de iluminação: sem iluminação explícita, o modelo muitas vezes renderizará cada figura sob condições de luz levemente diferentes, fazendo a cena parecer uma composição montada em vez de unificada. Uma única fonte de luz bem descrita é uma das correções mais eficazes que você pode aplicar a qualquer prompt com várias personagens.
Usar linguagem posicional vaga: "perto uma da outra" não é útil. "Mulher 1 à esquerda, a três quartos de ângulo em direção à câmera, Mulher 2 à direita, de frente para a Mulher 1" dá ao modelo uma geometria real para trabalhar.
O que a categoria +18 realmente exige
Existe uma diferença significativa entre conteúdo adulto sugestivo e conteúdo explícito. Os modelos ranqueados neste artigo são capazes de um amplo espectro, mas a ponta sugestiva produz resultados com várias personagens bem mais consistentes e exige muito menos correção na pós-produção.
Cenas que envolvem:
- Roupas de banho e lingerie: alta taxa de sucesso em todos os principais modelos. Poses naturais, cenários de praia, ambientes internos íntimos. A anatomia se mantém bem quando cada figura é descrita separadamente.
- Intimidade sugerida: duas personagens em proximidade, linguagem corporal apropriada, contato visual deliberado. Funciona melhor com o Flux 1.1 Pro Ultra e o RealVisXL v3.0 Turbo.
- Composição artística: figuras parcialmente vestidas, iluminação em silhueta, sombras dramáticas. O SD 3.5 Large e o Flux 2 Max lidam com essa categoria com o maior controle estético.
O fator decisivo nas três categorias é a especificidade. Quanto mais precisamente você descrever a cena, a roupa, a iluminação e a linguagem corporal de cada personagem, mais limpo e intencional se torna o resultado.
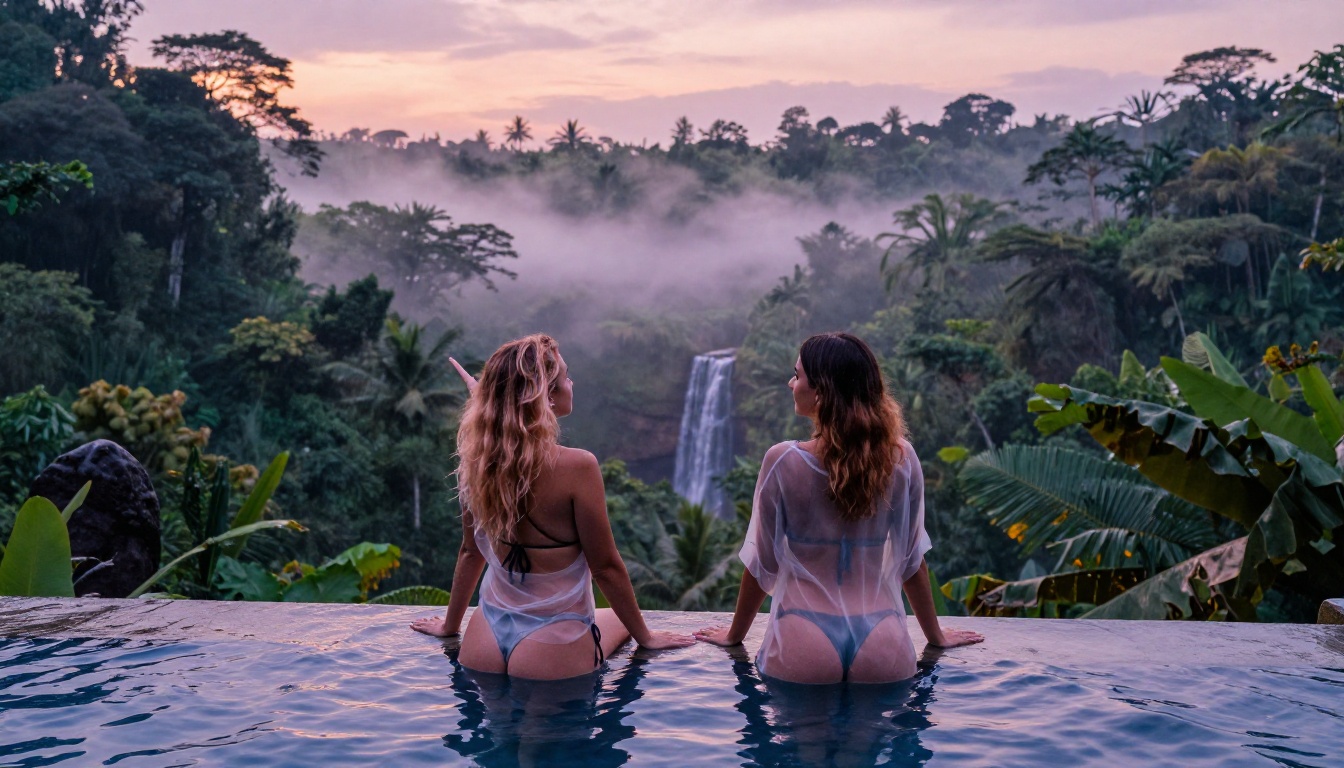
Todos os modelos descritos neste artigo estão disponíveis diretamente na coleção de texto para imagem do PicassoIA. Sem configuração de GPU local. Sem instalações. Cada modelo está a um clique de distância e pronto para rodar.
Comece com o Flux 1.1 Pro Ultra quando quiser a saída de maior qualidade possível. Use o RealVisXL v3.0 Turbo quando estiver iterando rapidamente em várias variações de prompt. Recorra ao SDXL Multi ControlNet LoRA no momento em que precisar de controle preciso sobre onde cada personagem fica e como seus corpos se relacionam no quadro.
As estratégias de prompt deste artigo, a marcação de personagens, as âncoras de iluminação e o método diretorial, se aplicam a todos os modelos que você testar. Comece com duas figuras em um cenário simples. Acerte a estrutura do prompt. Depois avance para cenas mais complexas, com mais personagens, mais iluminação e mais narrativa. As ferramentas estão prontas. O que você cria com elas fica por sua conta.


