लिप सिंक के लिए पहले एक प्रोफ़ेशनल डबिंग स्टूडियो, घंटों की री-रिकॉर्डिंग और एक कुशल साउंड इंजीनियर चाहिए था, ताकि ऑडियो को फ़्रेम-दर-फ़्रेम होंठों की हरकत से मिलाया जा सके। 2027 में यह पूरी प्रक्रिया एक ब्राउज़र टैब में समा जाती है। AI लिप सिंक टूल्स अब एक ऑडियो फ़ाइल, एक वीडियो, या एक स्थिर फ़ोटो लेकर कुछ ही सेकंड में सिंक्रोनाइज़्ड टॉकिंग वीडियो बना सकते हैं। न लिप-रीडिंग एक्सपर्ट चाहिए, न ADR सेशन, बस एक फ़ाइल अपलोड करें और ऐसा आउटपुट पाएँ जिसे आप सच में इस्तेमाल कर सकें।
पर पेंच यह है: ज़्यादातर मशहूर प्लेटफ़ॉर्म अच्छी चीज़ों को सब्सक्रिप्शन के पीछे छिपा देते हैं। यह आर्टिकल उस पर सीधी बात करता है और उन मॉडल्स पर केंद्रित है जो वाकई काम करते हैं, खासकर वे जिन्हें आप पहले दिन क्रेडिट कार्ड दिए बिना एक्सेस कर सकते हैं। ये सभी PicassoIA पर उपलब्ध हैं, जो 12+ लिप सिंक मॉडल एक ही जगह देता है, ताकि एक ही वर्कफ़्लो के लिए आपको छह अलग-अलग प्लेटफ़ॉर्म पर अकाउंट न संभालने पड़ें।
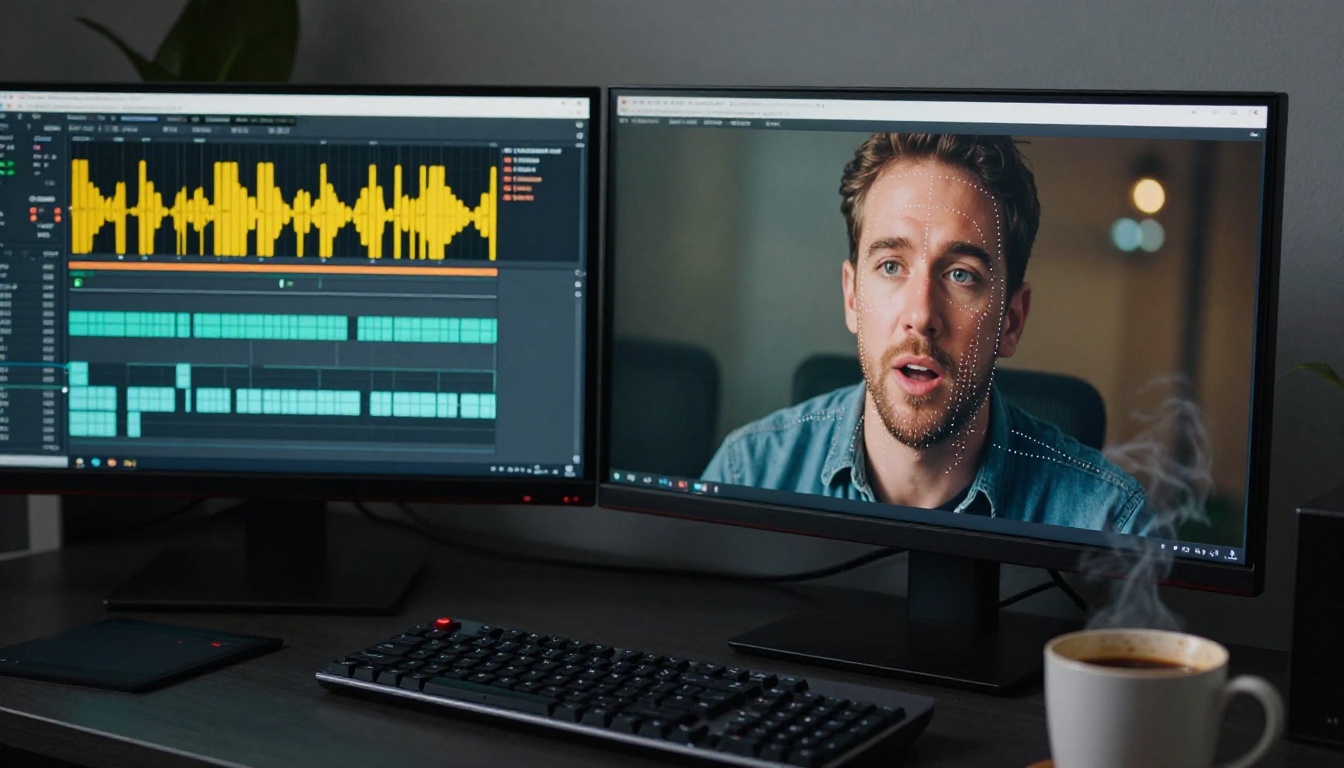
AI लिप सिंक असल में क्या करता है
कोई टूल चुनने से पहले यह जानना मददगार है कि आप उससे असल में क्या करवाना चाहते हैं। "लिप सिंक" कई अलग-अलग तकनीकी कामों के लिए इस्तेमाल होता है, और अलग-अलग मॉडल उन्हें अलग-अलग तरीके से संभालते हैं।
मौजूदा वीडियो में ऑडियो सिंक करना
सबसे आम इस्तेमाल: आपके पास किसी के बोलने का वीडियो है, और आप फ़ुटेज दोबारा रिकॉर्ड किए बिना ऑडियो बदलना या ओवरडब करना चाहते हैं। AI नए ऑडियो ट्रैक का विश्लेषण करता है, सही माउथ शेप का अनुमान लगाता है (फ़ोनीम मैपिंग), और फ़्रेम-दर-फ़्रेम वीडियो के मुँह वाले हिस्से को मोड़कर उससे मिलाता है। 2027 के सबसे अच्छे मॉडल यह जबड़े की रेखा पर बिना दिखने वाली गड़बड़ी के, होंठों की बनावट बिगाड़े बिना, और चेहरे के बाकी हिस्से पर असर डाले बिना करते हैं।
स्थिर फ़ोटो को एनिमेट करना
आप मॉडल को एक पोर्ट्रेट फ़ोटो और एक ऑडियो फ़ाइल देते हैं, और वह उस चेहरे का एक छोटा वीडियो बनाता है जो वे शब्द बोल रहा है। चुनौती रियलिज़्म की है: सस्ते मॉडल "पपेट माउथ" वाला असर देते हैं, जिसमें सिर्फ़ होंठ हिलते हैं। टॉप-टियर मॉडल जबड़े, गर्दन, सिर की छोटी-छोटी हरकतें एनिमेट करते हैं, और बोलने की लय के हिसाब से पलकें भी स्वाभाविक रूप से झपकाते हैं।
वीडियो डबिंग और अनुवाद
आप अंग्रेज़ी में एक वीडियो अपलोड करते हैं, और मॉडल स्पैनिश, फ़्रेंच, जापानी या 150+ अन्य भाषाओं में डब्ड वर्ज़न लौटाता है, जिसमें होंठों की हरकत अनुवादित ऑडियो से दोबारा सिंक की जाती है। यह सबसे जटिल पाइपलाइन है, और यह दिखता भी है: अलग-अलग प्रोवाइडर के बीच क्वालिटी में काफ़ी फ़र्क होता है।
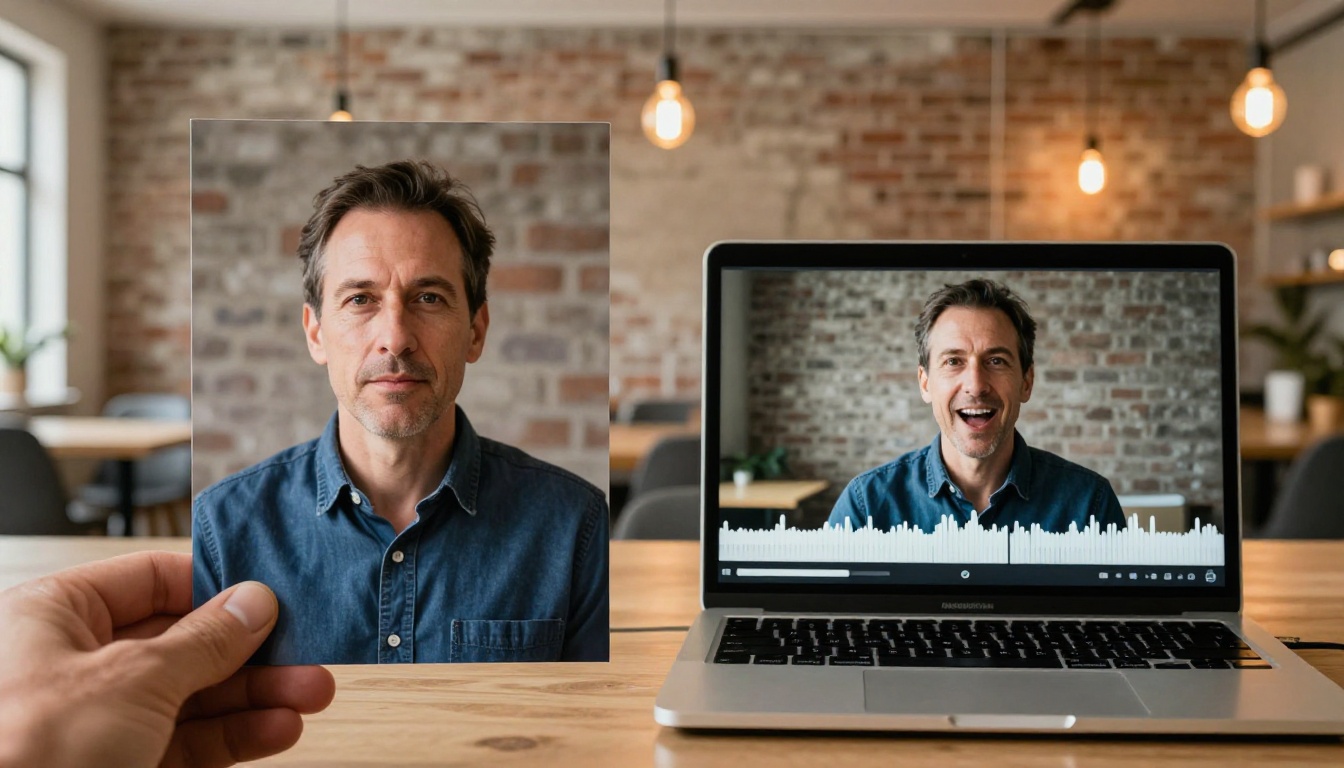
अभी के सबसे अच्छे मुफ़्त लिप सिंक मॉडल
ये वे मॉडल हैं जिन्हें आप सीधे PicassoIA पर चला सकते हैं, टेस्टिंग शुरू करने के लिए किसी पेड सब्सक्रिप्शन की ज़रूरत नहीं है।
Sync React 1
Sync Labs का React 1 ख़ास तौर पर मौजूदा वीडियो फ़ुटेज में रियलिस्टिक लिप सिंक जोड़ने के लिए बनाया गया है। यह दिखने वाले चेहरे वाला कोई भी वीडियो और एक ऑडियो फ़ाइल लेता है, फिर ऑडियो से मेल खाने के लिए मुँह वाले हिस्से को दोबारा रेंडर करता है। आउटपुट क्वालिटी सोशल कंटेंट और एक्सप्लेनर वीडियो के लिए काफ़ी अच्छी है। React 1 को ज़्यादातर प्रतिस्पर्धियों से जो अलग करता है वह है प्रोफ़ाइल एंगल और आंशिक रूप से दिखने वाले चेहरे को संभालने की क्षमता, ऐसी स्थितियाँ जहाँ कई दूसरे मॉडल साफ़ दिखने वाली गड़बड़ियाँ पैदा करते हैं।
किसके लिए सबसे अच्छा: मौजूदा टॉकिंग-हेड फ़ुटेज को ओवरडब करने के लिए, जहाँ आप ऑडियो ट्रैक बदलना चाहते हैं और वीडियो के बाकी हिस्से को अपरिवर्तित रखना चाहते हैं।
Lipsync 2 और Lipsync 2 Pro
Lipsync 2 Sync Labs की लाइनअप का सबसे भरोसेमंद रोज़मर्रा का मॉडल है। ठोस, तेज़, और कंप्रेस्ड फ़ोन फ़ुटेज सहित वीडियो क्वालिटी के कई स्तरों को संभालता है। Lipsync 2 Pro होंठ वाले हिस्से पर प्रिसिज़न रिफ़ाइनमेंट पास जोड़ता है, ताकि तेज़ व्यंजन (consonant) क्रमों में दिखने वाली माइक्रो-जिटर गड़बड़ियाँ खत्म हों। अगर आपका उपयोग क्लाइंट प्रेज़ेंटेशन या मार्केटिंग के लिए प्रोफ़ेशनल क्वालिटी आउटपुट का है, तो Pro सही विकल्प है।
💡 टिप: Lipsync 2 Pro के साथ साफ़ आउटपुट के लिए कंप्रेस्ड MP3 की जगह 44.1kHz WAV ऑडियो अपलोड करें। मॉडल रॉ वेवफ़ॉर्म से फ़ोनीम टाइमिंग पढ़ता है, और कंप्रेस्ड ऑडियो व्यंजन विस्फोटों पर टाइमिंग की गलतियाँ पैदा करता है।
Kling Lip Sync
KwaiVGI का Kling Lip Sync वीडियो कंटेंट पर स्वाभाविक दिखने वाली मुँह की एनिमेशन के लिए सबसे मज़बूत मॉडलों में से एक है। इसकी ताकत उन वीडियो को संभालने में है जहाँ चेहरा पूरी तरह सामने की ओर नहीं है: हल्का मुड़ना, सिर हिलाना, या चलते हुए बात करना। कई टूल तब बुरी तरह बिगड़ जाते हैं जब चेहरा बिल्कुल बीच में न हो, लेकिन Kling मध्यम सिर की हरकत के दौरान भी लगातार अच्छी क्वालिटी बनाए रखता है। यह इन्फ़्लुएंसर-स्टाइल कंटेंट और इंटरव्यू फ़ुटेज के लिए खास तौर पर उपयुक्त है।
PixVerse Lipsync
PixVerse Lipsync Sync Labs के मॉडलों से अलग तरीका अपनाता है। जहाँ Sync होंठ वाले हिस्से में सटीकता पर ध्यान देता है, वहीं PixVerse एक व्यापक, फ़ेस-अवेयर रेंडर चलाता है जो मुँह के साथ-साथ गालों का तनाव, ठोड़ी की स्थिति और गर्दन की मुद्रा भी थोड़ा बदलता है। क्लोज़-अप फ़ुटेज के लिए इसका नतीजा ज़्यादा समग्र और स्वाभाविक है, हालाँकि प्रोसेसिंग समय थोड़ा ज़्यादा लगता है।
तुलना: ऑडियो-टू-वीडियो लिप सिंक मॉडल
| मॉडल | सबसे अच्छा एंगल | स्पीड | ताकत |
|---|
| React 1 | सामने और प्रोफ़ाइल | तेज़ | प्रोफ़ाइल हैंडलिंग |
| Lipsync 2 | सामने | तेज़ | कंप्रेस्ड इनपुट की सहनशीलता |
| Lipsync 2 Pro | सामने | मध्यम | प्रिसिज़न रिफ़ाइनमेंट पास |
| Kling Lip Sync | कोई भी एंगल, हरकत के साथ | मध्यम | सिर की हरकत की सहनशीलता |
| PixVerse Lipsync | सामने और क्लोज़-अप | धीमा | पूरे चेहरे का रियलिज़्म |
HeyGen Lipsync Speed और Precision
HeyGen PicassoIA पर दो अलग लिप सिंक मॉडल देता है, जिनमें से हर एक अलग तरह की खूबी और कमी के संतुलन के लिए ऑप्टिमाइज़्ड है। Lipsync Speed वीडियो कुछ ही सेकंड में प्रोसेस करता है, जो तेज़ी से कई ऑडियो टेक लेकर परखने के लिए आदर्श है। Lipsync Precision ज़्यादा समय लेता है, पर बारीक फ़ोनीम-टू-वाइज़ेम मैपिंग के साथ ब्रॉडकास्ट-ग्रेड सिंक्रोनाइज़ेशन सटीकता देता है।
ज़्यादातर क्रिएटिव वर्कफ़्लो के लिए, ड्राफ़्ट पास के लिए Speed से शुरुआत करना और मंज़ूर किए गए अंतिम टेक पर Precision चलाना सबसे कारगर तरीका है। दोनों के बीच स्पीड का फ़र्क ड्राफ़्टिंग को सस्ता बनाता है, और अंतिम आउटपुट की क्वालिटी का फ़र्क लगातार अतिरिक्त प्रोसेसिंग समय के लायक निकलता है।
फ़ोटो को बोलवाना
इस क्षमता को अक्सर कम आँका जाता है। अगर आपके पास काम करने के लिए कोई वीडियो नहीं है, तो ये मॉडल एक ही फ़ोटो से शुरू करते हैं और उससे एक रियलिस्टिक बोलने वाला वीडियो बनाते हैं।
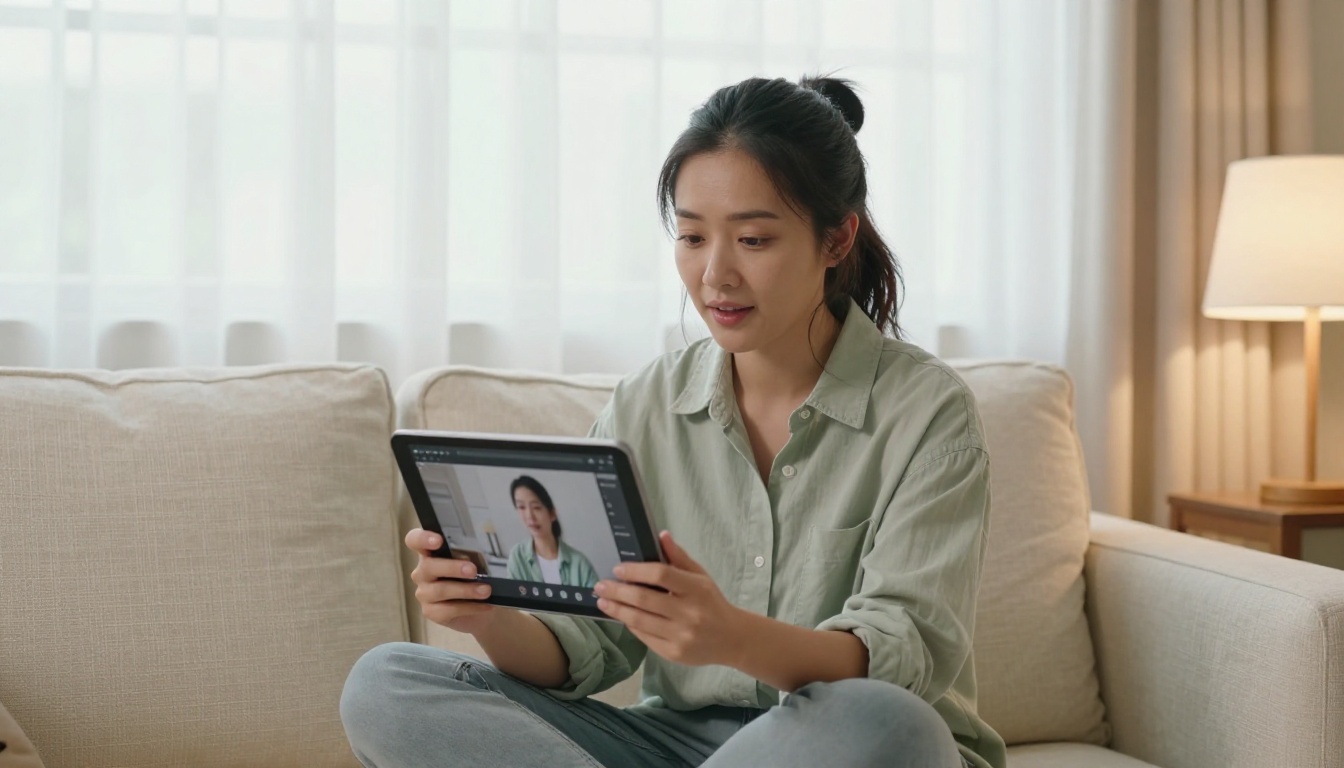
Omni Human 1.5
ByteDance का Omni Human 1.5 2027 में PicassoIA पर उपलब्ध सबसे सक्षम फ़ोटो-एनिमेशन लिप सिंक मॉडल है। जहाँ पहले के फ़ोटो-एनिमेशन टूल सख्त, मशीनी आउटपुट देते थे, वहीं Omni Human 1.5 सिर की छोटी-छोटी स्वाभाविक हरकतें, बोलने के ठहरावों से सिंक्रोनाइज़्ड पलक झपकाना, और हल्की कंधे की हरकतें बनाता है, जिससे नतीजा किसी हेरफेर वाली इमेज की बजाय असली फ़ुटेज जैसा लगता है। एक साफ़ पोर्ट्रेट अपलोड करें, ऑडियो फ़ाइल दें, और यह वीडियो लौटा देता है।
पुराना Omni Human उन तेज़, हल्के कामों के लिए उपलब्ध है जहाँ पूरा रियलिज़्म प्राथमिकता नहीं है। अगर आपको पूरी 1.5 प्रोसेसिंग चलाने से पहले टाइमिंग जाँचने के लिए जल्दी ड्राफ़्ट चाहिए, तो पुराना वाला तेज़ विकल्प है।
यह अलग कैसे है: इस मॉडल को ऐसे डेटासेट पर ट्रेन किया गया है जिसमें स्पष्ट रूप से गैर-फ़्रंटल, आंशिक रूप से ढके पोर्ट्रेट शामिल थे, इसलिए यह धूप के चश्मे, टोपियों, दाढ़ी और असामान्य रोशनी को प्रतिस्पर्धी मॉडलों से कहीं बेहतर संभालता है।
💡 टिप: Omni Human 1.5 के साथ सबसे रियलिस्टिक आउटपुट के लिए मुलायम, समान रोशनी और साफ़ बैकग्राउंड वाली पोर्ट्रेट फ़ोटो इस्तेमाल करें। जब बैकग्राउंड सरल होता है, तो मॉडल अपने प्रोसेसिंग बजट का ज़्यादा हिस्सा चेहरे की एनिमेशन पर लगाता है, और यह अंतिम आउटपुट में दिखता है।
P Video Avatar
PrunaAI का P Video Avatar एक ही फ़ोटो से पूरे टॉकिंग-अवतार वीडियो बनाता है। इसका फ़ोकस लंबे ऑडियो खंडों में अवतार की लगातार पहचान बनाए रखने पर है: अगर आप इसे 90 सेकंड का ऑडियो क्लिप देते हैं, तो अवतार पूरे समय एक जैसा दिखता है, बिना उन ड्रिफ़्ट गड़बड़ियों के जो दूसरे मॉडलों में लंबे क्लिप पर जमा होती हैं। इसलिए यह प्रोडक्ट ट्यूटोरियल, ऑनबोर्डिंग वीडियो और स्पोक्सपर्सन सेगमेंट जैसे लंबे फ़ॉर्मेट कंटेंट के लिए सही चुनाव है, जहाँ वीडियो 30 सेकंड से आगे जाता है।
Fabric 1.0
VEED का Fabric 1.0 सोशल-मीडिया फ़ॉर्मेट आउटपुट के लिए ऑप्टिमाइज़्ड है, ख़ासकर स्क्वेयर और वर्टिकल रेशियो में छोटे क्लिप। इसमें Instagram और TikTok के लिए प्री-सेट प्रोफ़ाइल हैं, जो अवतार फ़्रेमिंग को अपने-आप ऑप्टिमाइज़ करते हैं, जिससे फ़ोटो से प्लेटफ़ॉर्म-रेडी स्पोक्सपर्सन क्लिप तक का सबसे तेज़ रास्ता मिलता है। अगर आप एक ब्रांड अकाउंट चलाते हैं जिसे लगातार एक चेहरा चाहिए, पर आप खुद कैमरे पर नहीं आना चाहते, तो Fabric 1.0 प्रोडक्शन का काम साफ़-सुथरे तरीके से संभाल लेता है।
150+ भाषाओं में वीडियो डब करें
ट्रांसलेशन डबिंग वह जगह है जहाँ 2027 में लिप सिंक सच में प्रभावशाली बन जाता है। आप एक अंग्रेज़ी वीडियो अपलोड करते हैं और दूसरी भाषा में पूरी तरह डब्ड, लिप-सिंक्ड वर्ज़न वापस पाते हैं। इसके पीछे का ऑटोमेटेड पाइपलाइन ट्रांसक्रिप्शन, अनुवाद, वॉइस सिंथेसिस और लिप सिंक को एक के बाद एक संभालता है।
HeyGen Video Translate
HeyGen का Video Translate सबसे व्यापक रूप से इस्तेमाल होने वाली डबिंग पाइपलाइन है। यह 150+ भाषाओं को सपोर्ट करता है, वॉइस क्लोनिंग का इस्तेमाल करके अनुवादित वर्ज़न में मूल स्पीकर की आवाज़ की विशेषताएँ बनाए रखता है, और आउटपुट पर लिप सिंक अपने-आप चलाता है। फ़्री टियर में छोटे क्लिप पर पूरी पाइपलाइन टेस्ट करने जितने क्रेडिट मिलते हैं, जो किसी भी चीज़ पर पैसा लगाने से पहले यह परखने के लिए काफ़ी है कि क्वालिटी आपकी ज़रूरत पूरी करती है या नहीं।
एक सच में उपयोगी फ़ीचर: Video Translate पहचानता है कि क्लिप में कई स्पीकर हैं और हर आवाज़ को अलग से संभालता है, ताकि एक ही क्लोन की गई आवाज़ उस बातचीत को नैरेट न करे जो असल में दो लोगों की बातचीत थी। ज़्यादातर प्रतिस्पर्धी टूल इसे बिल्कुल नहीं संभालते।
ElevenLabs Dubbing
ElevenLabs Dubbing उपलब्ध सबसे मज़बूत वॉइस-सिंथेसिस इंजनों में से एक पर बना है, और यह डबिंग आउटपुट में दिखता है। अनुवादित आवाज़ की क्वालिटी ज़्यादातर प्रतिस्पर्धियों से उल्लेखनीय रूप से ऊँची है, ख़ासकर टोनल भाषाओं और अरबी या मैंडरिन जैसी जटिल ध्वनि-संरचना वाली भाषाओं के लिए। डब किए गए वीडियो पर लिप सिंक पास वॉइस जनरेशन के बाद अपने-आप होता है।
💡 टिप: ऐसे कंटेंट की डबिंग करते समय जहाँ स्पीकर की आवाज़ की पहचान मायने रखती है, जैसे CEO का संदेश या पर्सनल ब्रांड वीडियो, ElevenLabs Dubbing सबसे अच्छा प्रदर्शन करता है। इसका वॉइस-क्लोनिंग कंपोनेंट अनुवाद के दौरान पहचानने लायक आवाज़ की विशेषताएँ बनाए रखता है, इसलिए डब्ड वर्ज़न किसी सामान्य AI आवाज़ की बजाय उसी व्यक्ति जैसा लगता है।
डबिंग मॉडल एक नज़र में
लिप सिंक को AI वॉइस के साथ जोड़ें
लिप सिंक उतना ही अच्छा है जितना वह ऑडियो जो आप उसे देते हैं। अगर आप रिकॉर्ड किए ऑडियो की बजाय टेक्स्ट से शुरू कर रहे हैं, तो आपको पहले एक टेक्स्ट-टू-स्पीच मॉडल चाहिए। इस चरण पर वॉइस की क्वालिटी उससे ज़्यादा मायने रखती है जितना ज़्यादातर लोग समझते हैं: रोबोटिक TTS इनपुट से रोबोटिक लिप सिंक आउटपुट बनता है, चाहे लिप सिंक मॉडल कितना भी उन्नत क्यों न हो।
MiniMax Speech 2.8 HD
MiniMax का Speech 2.8 HD स्टूडियो-क्वालिटी वॉइसओवर बनाता है जिनमें स्वाभाविक प्रोसोडी होती है, और यह लिप सिंक मॉडलों के साथ बेहद अच्छी तरह जुड़ता है। यह लिप सिंक इनपुट के रूप में इतने साफ़ तरीके से काम करता है, इसका कारण इसकी स्वाभाविक गति है: यह जो ठहराव क्लॉज़ के बीच बनाता है वे मानव बोली की लय से मेल खाते हैं, जिससे लिप सिंक मॉडल को सही टाइमिंग संकेत मिलते हैं और मुँह की हरकतें स्वाभाविक दिखती हैं।
थोड़ी कम क्वालिटी वाले तेज़ वर्ज़न के लिए, Speech 2.8 Turbo अब भी साफ़ और उपयोगी लिप सिंक इनपुट बनाता है। ड्राफ़्ट पास के लिए इसका इस्तेमाल करें और अंतिम आउटपुट के लिए HD पर जाएँ।
ElevenLabs V3
ElevenLabs V3 उन भावनात्मक कंटेंट के लिए ख़ास तौर पर मज़बूत है जहाँ आवाज़ को सिर्फ़ जानकारी देने की बजाय भावना व्यक्त करनी होती है। ट्रेनिंग वीडियो, प्रोडक्ट डेमो और ब्रांड कंटेंट, जहाँ सपाट नैरेशन अटपटा लगता है, V3 की भावनात्मक रेंज से फ़ायदा उठाते हैं। V3 का आउटपुट Lipsync 2 Pro में डालने से आज उपलब्ध सबसे विश्वसनीय AI-जनरेटेड स्पोक्सपर्सन वीडियो में से कुछ बनते हैं।
अन्य वॉइस विकल्प जिन पर ध्यान देना चाहिए
- Qwen3 TTS: छोटे रेफ़रेंस क्लिप से मज़बूत वॉइस क्लोनिंग, कई वीडियो में एक जैसी वॉइस पहचान बनाए रखने के लिए उपयोगी
- Resemble AI Chatterbox: जनरेट की गई आवाज़ में खुशी, दुख और तात्कालिकता के लिए स्पष्ट इमोशन पैरामीटर
- Google Gemini 3.1 Flash TTS: 70+ भाषाओं में 30 वॉइस विकल्प, जब लक्ष्य लिप सिंक कंटेंट को किसी दूसरी भाषा में डब किया जाना हो तब एक मज़बूत शुरुआती बिंदु
PicassoIA पर Lipsync 2 Pro का इस्तेमाल
Lipsync 2 Pro प्रोफ़ेशनल फ़ुटेज पर साफ़, आर्टिफ़ैक्ट-मुक्त लिप सिंक के लिए सबसे भरोसेमंद मॉडलों में से एक है। इसे प्रभावी ढंग से चलाने का तरीका यहाँ है।
चरण 1: अपना वीडियो तैयार करें
ऐसा वीडियो अपलोड करें जिसमें चेहरा एक उचित रूप से स्थिर स्थिति में साफ़ दिखे। ऐसे फ़ुटेज से बचें जिनमें शॉट्स के बीच तेज़ कट हों: मॉडल क्लिप को एक इकाई की तरह प्रोसेस करता है, और कट टेम्पोरल अलाइनमेंट को बिगाड़ देते हैं। 10 से 60 सेकंड की क्लिप सबसे अच्छा काम करती हैं।
चरण 2: अपना ऑडियो तैयार करें
अपना ऑडियो 44.1kHz WAV फ़ाइल के रूप में एक्सपोर्ट करें या रिकॉर्ड करें। अगर आप TTS मॉडल से स्पीच बना रहे हैं, तो Lipsync 2 Pro पर अपलोड करने से पहले WAV आउटपुट डाउनलोड करें। मॉडल MP3 स्वीकार करता है, पर WAV फ़ोनीम-डिटेक्शन एल्गोरिदम को ज़्यादा साफ़ टाइमिंग मार्कर देता है।
चरण 3: मॉडल चलाएँ
PicassoIA पर Lipsync 2 Pro खोलें। अपना वीडियो और ऑडियो फ़ाइल अपलोड करें। पहली बार के लिए डिफ़ॉल्ट सेटिंग्स ही रखें: ऑटोमेटिक माउथ रीजन डिटेक्शन ज़्यादातर पोर्ट्रेट कॉन्फ़िगरेशन को मैन्युअल ट्यूनिंग के बिना संभाल लेता है।
चरण 4: आउटपुट देखें
मॉडल एक MP4 डाउनलोड लौटाता है। उन जगहों पर वीडियो स्क्रब करें जहाँ व्यंजन-भारी शब्द आते हैं। "p", "b" और "m" ध्वनियाँ सही सिंक करने में सबसे कठिन होती हैं। अगर उन फ़्रेम्स में गलत मेल दिखे, तो TTS आउटपुट थोड़ा धीमा करके दोबारा चलाएँ, जिससे फ़ोनीम-मैपर को हर ध्वनि घटना के लिए ज़्यादा फ़्रेम मिलते हैं।
चरण 5: दोहराएँ
क्लाइंट के लिए तैयार आउटपुट के लिए, अगर कुछ हिस्से थोड़े मशीनी लगें, तो वीडियो को दूसरे पास के रूप में React 1 से चलाएँ। React 1 की प्रोफ़ाइल हैंडलिंग अक्सर उन जबड़े की गड़बड़ियों को चिकना कर देती है जो Pro कभी-कभी थ्री-क्वार्टर एंगल फ़ुटेज में छोड़ देता है।
💡 प्रो टिप: अगर आप ऐसे ब्रांड के लिए कंटेंट बना रहे हैं जिसे कई वीडियो में एक जैसी स्पोक्सपर्सन पहचान चाहिए, तो लॉक किए गए रेफ़रेंस फ़ोटो के साथ P Video Avatar लंबे सत्रों में अवतार की एक जैसी उपस्थिति बनाए रखता है, जो प्लेटफ़ॉर्म पर अभी उपलब्ध किसी भी दूसरे मॉडल से बेहतर है।
खुद आज़माएँ
2027 में लिप सिंक कोई नई चीज़ नहीं, बल्कि एक प्रोडक्शन टूल है। कंटेंट टीमें वीडियो कंटेंट को 10 भाषाओं में लोकलाइज़ करने के लिए इसका इस्तेमाल करती हैं, उस समय में जो पहले एक डबिंग सेशन शेड्यूल करने में लगता था। शिक्षक एक ही रिकॉर्ड किए टेक से व्यक्तिगत एक्सप्लेनर वीडियो बनाते हैं। छोटे व्यवसाय ऑन-कैमरा टैलेंट को हायर किए बिना प्रोफ़ेशनल स्पोक्सपर्सन वीडियो बनाते हैं।
क्वालिटी का स्तर इतना ऊँचा हो गया है कि दर्शक अक्सर डब्ड और मूल भाषा के प्रोडक्शन में फ़र्क नहीं कर पाते। यह अंतर मिटना ही वह कारण है कि AI लिप सिंक टूल्स की यह पीढ़ी ध्यान देने लायक है, भले ही ये मुफ़्त हों।
PicassoIA सभी 12 लिप सिंक मॉडल एक ही जगह देता है: Lipsync 2 Pro, Omni Human 1.5, Kling Lip Sync, HeyGen Video Translate, React 1, PixVerse Lipsync, Fabric 1.0, Lipsync Speed, Lipsync Precision, और भी बहुत कुछ। एक ही वर्कफ़्लो चलाने के लिए आपको छह अलग-अलग प्लेटफ़ॉर्म पर अकाउंट संभालने की ज़रूरत नहीं है।
Omni Human 1.5 से शुरू करें: एक पोर्ट्रेट फ़ोटो और एक ऑडियो क्लिप अपलोड करें, और देखें कि पहला नतीजा कैसा दिखता है। ज़्यादातर लोग सच में हैरान रह जाते हैं। उसके बाद बस यह चुनना है कि आप जो बना रहे हैं उसके लिए सही मॉडल कौन-सा है। सभी उपलब्ध लिप सिंक और वॉइस मॉडल picassoia.com/en/all-models पर देखें।


