La synchronisation labiale exigeait autrefois un studio de doublage professionnel, des heures d’enregistrement et un ingénieur du son qualifié pour faire correspondre l’audio aux mouvements de la bouche image par image. En 2027, tout ce processus tient dans un onglet de navigateur. Les outils de lipsync IA peuvent désormais prendre un fichier audio, une vidéo, voire une simple photo, et produire une vidéo parlante synchronisée en quelques secondes. Pas besoin de spécialistes de la lecture labiale ni de séances d’ADR, juste un import de fichier et un résultat que vous pouvez réellement utiliser.
Le hic ? La plupart des plateformes connues cachent le meilleur derrière des abonnements. Cet article va droit au but et se concentre sur les modèles qui fonctionnent vraiment, en particulier ceux auxquels vous pouvez accéder sans donner de carte bancaire dès le premier jour. Tous sont disponibles sur PicassoIA, qui regroupe 12+ modèles de lipsync au même endroit, pour que vous n’ayez pas à jongler avec des comptes sur six plateformes pour un seul flux de travail.
Ce que fait réellement la synchronisation labiale IA
Avant de choisir un outil, il est utile de savoir ce que vous lui demandez réellement. « Lipsync » désigne plusieurs tâches techniques distinctes, que les différents modèles traitent de manières différentes.
Synchroniser l’audio sur une vidéo existante
Le cas d’usage le plus courant : vous avez une vidéo d’une personne qui parle, et vous voulez remplacer ou doubler l’audio sans refaire le tournage. L’IA analyse la nouvelle piste audio, prédit les formes de bouche correctes (correspondance des phonèmes) et déforme la zone de la bouche image par image pour la faire coïncider. Les meilleurs modèles de 2027 le font sans artefacts visibles au niveau de la mâchoire, sans effacer la texture des lèvres et sans affecter le reste du visage.
Animer une photo fixe
Vous fournissez au modèle un seul portrait et un fichier audio, et il génère une courte vidéo de ce visage qui prononce les mots. Le défi est le réalisme : les modèles bon marché produisent l’effet « bouche de marionnette », où seules les lèvres bougent. Les modèles haut de gamme animent la mâchoire, le cou, les micro-mouvements de la tête, et même le clignement des yeux, de façon naturelle, en réponse au rythme de la parole.
Doublage vidéo et traduction
Vous importez une vidéo en anglais, et le modèle renvoie une version doublée en espagnol, français, japonais ou dans plus de 150 autres langues, avec des mouvements de bouche resynchronisés sur l’audio traduit. C’est le flux le plus complexe, et cela se voit : la qualité varie fortement d’un fournisseur à l’autre.
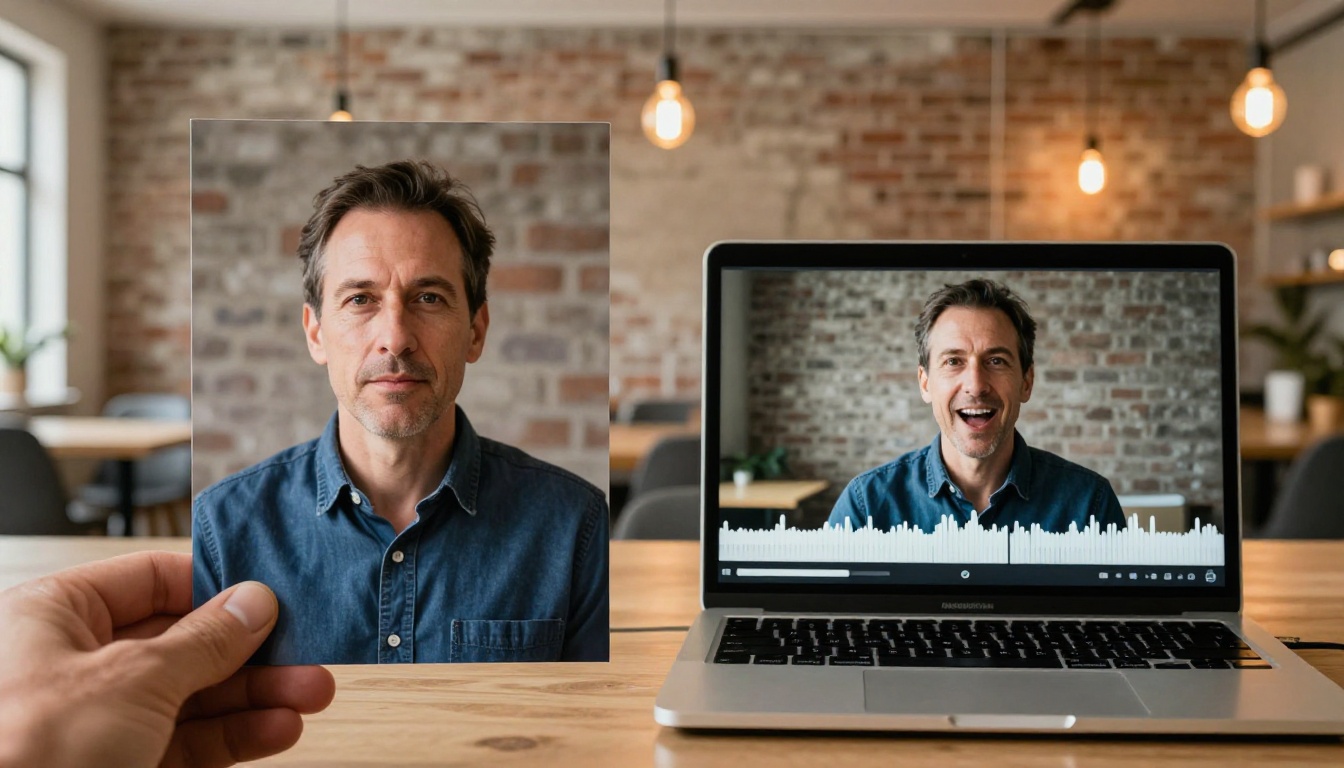
Les meilleurs modèles de lipsync gratuits du moment
Voici les modèles que vous pouvez utiliser directement sur PicassoIA, sans abonnement payant pour commencer à tester.
Sync React 1
React 1 de Sync Labs est conçu spécifiquement pour ajouter une synchronisation labiale réaliste à des séquences vidéo existantes. Il prend n’importe quelle vidéo avec un visage visible et un fichier audio, puis refait le rendu de la zone de la bouche pour la faire correspondre à l’audio. La qualité de sortie est suffisante pour les contenus sociaux et les vidéos explicatives. Ce qui distingue React 1 de la plupart de ses concurrents, c’est sa gestion des angles de profil et des visages partiellement visibles, des cas où beaucoup d’autres modèles produisent des défauts visibles.
Idéal pour : le doublage de séquences existantes en plan face caméra, lorsque vous voulez changer la piste audio et garder la vidéo telle quelle.
Lipsync 2 et Lipsync 2 Pro
Lipsync 2 est le modèle polyvalent de la gamme de Sync Labs. Solide et rapide, il gère un large éventail de qualités de vidéo d’entrée, y compris les vidéos compressées tournées avec un téléphone. Lipsync 2 Pro ajoute une passe de raffinement de précision sur la zone des lèvres pour éliminer les artefacts de micro-tremblements qui apparaissent dans les séquences rapides de consonnes. Si votre besoin concerne un rendu de qualité professionnelle pour des présentations clients ou du marketing, Pro est le bon choix.
💡 Astuce : pour un résultat plus propre avec Lipsync 2 Pro, importez l’audio en WAV 44,1 kHz plutôt qu’en MP3 compressé. Le modèle traite le timing des phonèmes à partir de la forme d’onde brute, alors que l’audio compressé introduit des erreurs de timing sur les explosions des consonnes.
Kling Lip Sync
Kling Lip Sync de KwaiVGI est l’un des modèles les plus performants pour une animation de bouche naturelle sur des contenus vidéo. Sa force : gérer les vidéos où le visage n’est pas totalement de face, avec de légers virages, des hochements de tête ou une prise de parole en marchant. Beaucoup d’outils se dégradent nettement quand le visage n’est pas parfaitement centré, mais Kling maintient une qualité de sortie constante malgré des mouvements de tête modérés. Il convient particulièrement aux contenus de style influenceur et aux séquences d’interview.
PixVerse Lipsync
PixVerse Lipsync adopte une approche différente de celle des modèles de Sync Labs. Là où Sync privilégie la précision chirurgicale dans la zone des lèvres, PixVerse effectue un rendu plus large, tenant compte du visage, qui ajuste subtilement la tension des joues, la position du menton et la posture du cou en plus de la bouche. Le résultat est plus global et naturel pour les séquences en gros plan, même si le temps de traitement est légèrement plus long.
Comparatif : modèles de lipsync audio vers vidéo
| Modèle | Meilleur angle | Vitesse | Point fort |
|---|
| React 1 | De face et de profil | Rapide | Gestion du profil |
| Lipsync 2 | De face | Rapide | Tolérance aux entrées compressées |
| Lipsync 2 Pro | De face | Moyenne | Passe de raffinement de précision |
| Kling Lip Sync | Tous angles, avec mouvement | Moyenne | Tolérance aux mouvements de tête |
| PixVerse Lipsync | De face et gros plan | Plus lente | Réalisme du visage complet |
HeyGen : Lipsync Speed et Lipsync Precision
HeyGen propose deux modèles de lipsync distincts sur PicassoIA, chacun optimisé pour un compromis différent. Lipsync Speed traite les vidéos en quelques secondes, ce qui le rend idéal pour itérer rapidement lorsque vous testez plusieurs prises audio. Lipsync Precision prend plus de temps, mais produit une précision de synchronisation de qualité télévisuelle, avec une correspondance phonème-viseme plus fine.
Pour la plupart des flux créatifs, commencer par Speed pour une passe de brouillon, puis lancer Precision sur la prise finale validée, est la méthode la plus efficace. L’écart de vitesse entre les deux rend le brouillon abordable, et la différence de qualité sur le résultat final vaut systématiquement le temps de traitement supplémentaire.
Faire parler une photo
Cette capacité est souvent sous-estimée. Si vous n’avez pas de vidéo sur laquelle travailler, ces modèles partent d’une seule photographie et en tirent une vidéo réaliste de quelqu’un qui parle.
Omni Human 1.5
Omni Human 1.5 de ByteDance est le modèle d’animation de photo avec lipsync le plus performant disponible sur PicassoIA en 2027. Là où les premiers outils d’animation de photo produisaient des résultats raides et mécaniques, Omni Human 1.5 génère des micro-mouvements naturels de la tête, des clignements d’yeux synchronisés sur les pauses de la parole et de légers mouvements d’épaules, qui donnent au résultat l’impression d’une vraie séquence filmée plutôt que d’une image manipulée. Importez un portrait net, fournissez un fichier audio, et il renvoie une vidéo.
L’ancien Omni Human reste disponible pour des tâches plus rapides et plus légères, lorsque le réalisme total n’est pas la priorité. Si vous avez besoin d’un brouillon rapide pour vérifier le timing avant de lancer le traitement complet de 1.5, l’original est le choix le plus rapide.
Ce qui le différencie : le modèle a été entraîné sur un jeu de données incluant explicitement des portraits non frontaux et partiellement occultés. Il gère donc bien mieux que les modèles concurrents les lunettes de soleil, les chapeaux, les barbes et les éclairages non standard.
💡 Astuce : pour obtenir le résultat le plus réaliste possible avec Omni Human 1.5, utilisez une photo de portrait avec un éclairage doux et uniforme et un arrière-plan épuré. Le modèle consacre davantage de son budget de traitement à l’animation du visage lorsque l’arrière-plan est simple, ce qui se voit dans le résultat final.
P Video Avatar
P Video Avatar de PrunaAI crée des vidéos d’avatars parlants complets à partir d’une seule photo. Il se concentre sur une identité d’avatar constante sur des segments audio plus longs : si vous lui donnez un clip audio de 90 secondes, l’avatar garde une apparence constante du début à la fin, sans les dérives qui s’accumulent dans d’autres modèles sur les clips longs. C’est donc le bon choix pour des contenus plus longs, comme les tutoriels produit, les vidéos d’intégration et les segments de porte-parole, lorsque la vidéo dépasse 30 secondes.
Fabric 1.0
Fabric 1.0 de VEED est optimisé pour les formats des réseaux sociaux, en particulier les courts clips en format carré et vertical. Il dispose de profils prédéfinis pour Instagram et TikTok qui optimisent automatiquement le cadrage de l’avatar, ce qui en fait le chemin le plus rapide d’une photo à un clip de porte-parole prêt pour la plateforme. Si vous gérez un compte de marque qui a besoin d’un visage constant sans vouloir apparaître à l’écran, Fabric 1.0 prend en charge proprement la partie production.
Doubler des vidéos en plus de 150 langues
Le doublage par traduction est le domaine où la synchronisation labiale impressionne vraiment en 2027. Vous importez une vidéo en anglais et récupérez une version entièrement doublée et synchronisée dans une autre langue. Le flux automatisé derrière cela gère dans l’ordre la transcription, la traduction, la synthèse vocale et la synchronisation labiale.
HeyGen Video Translate
Video Translate de HeyGen est le flux de doublage le plus utilisé. Il prend en charge plus de 150 langues, conserve les caractéristiques vocales de l’intervenant d’origine dans la version traduite grâce au clonage vocal, et lance automatiquement la synchronisation labiale sur le résultat. L’offre gratuite inclut suffisamment de crédits pour tester le flux complet sur de courts clips, ce qui permet d’évaluer si la qualité répond à vos besoins avant de vous engager.
Une fonctionnalité vraiment utile : Video Translate détecte lorsqu’un clip comporte plusieurs intervenants et traite chaque voix séparément, pour que vous ne vous retrouviez pas avec une seule voix clonée qui narre ce qui était à l’origine une conversation à deux. La plupart des outils concurrents ne gèrent pas du tout ce cas.
ElevenLabs Dubbing
ElevenLabs Dubbing repose sur l’un des moteurs de synthèse vocale les plus performants disponibles, ce qui se voit dans le résultat du doublage. La qualité de la voix traduite est nettement supérieure à celle de la plupart des concurrents, en particulier pour les langues tonales et les langues à phonologie complexe comme l’arabe ou le mandarin. La passe de synchronisation labiale sur la vidéo doublée est gérée automatiquement après la génération vocale.
💡 Astuce : pour le doublage d’un contenu où l’identité vocale de l’intervenant compte, comme un message de PDG ou une vidéo de marque personnelle, ElevenLabs Dubbing donne les meilleurs résultats. Son composant de clonage vocal conserve des empreintes vocales reconnaissables tout au long de la traduction, si bien que la version doublée sonne comme la même personne et non comme une voix d’IA générique.
Modèles de doublage en un coup d’œil
Associer la synchronisation labiale à une voix IA
La synchronisation labiale n’est aussi bonne que l’audio qu’on lui fournit. Si vous partez d’un texte plutôt que d’un enregistrement, vous avez d’abord besoin d’un modèle de synthèse vocale. La qualité de la voix à cette étape compte davantage que la plupart des gens ne le réalisent : une entrée TTS robotique produit une synchronisation robotique, quelle que soit la sophistication du modèle de lipsync.
MiniMax Speech 2.8 HD
Speech 2.8 HD de MiniMax produit des voix off de qualité studio, avec une prosodie naturelle qui se marie très bien avec les modèles de lipsync. Ce qui le rend si efficace comme entrée de lipsync, c’est son rythme naturel : les pauses qu’il génère entre les propositions correspondent au rythme de la parole humaine, ce qui donne au modèle de lipsync les bons repères temporels pour produire des mouvements de bouche naturels.
Pour une version plus rapide, à la qualité légèrement réduite, Speech 2.8 Turbo produit toujours une entrée de lipsync propre et exploitable. Utilisez-la pour les passes de brouillon et passez à HD pour le résultat final.
ElevenLabs V3
ElevenLabs V3 est particulièrement efficace pour les contenus expressifs, lorsque la voix doit transmettre une émotion et pas seulement délivrer une information. Les vidéos de formation, les démonstrations de produit et les contenus de marque, lorsqu’une narration plate sonne faux, profitent de la gamme émotionnelle de V3. Faire passer la sortie de V3 dans Lipsync 2 Pro produit certaines des vidéos de porte-parole IA les plus convaincantes réalisables actuellement.
Autres options vocales à connaître
- Qwen3 TTS : un clonage vocal solide à partir d’un court extrait de référence, utile pour conserver une identité vocale cohérente sur de nombreuses vidéos
- Resemble AI Chatterbox : des paramètres d’émotion explicites pour le bonheur, la tristesse et l’urgence dans la voix générée
- Google Gemini 3.1 Flash TTS : 30 options de voix dans plus de 70 langues, un bon point de départ lorsque le contenu de lipsync cible doit être doublé dans une autre langue
Utiliser Lipsync 2 Pro sur PicassoIA
Lipsync 2 Pro est l’un des modèles les plus fiables pour une synchronisation labiale propre et sans artefacts sur des séquences professionnelles. Voici comment l’utiliser efficacement.
Étape 1 : préparez votre vidéo
Importez une vidéo où le visage est clairement visible dans une position raisonnablement stable. Évitez les séquences avec des coupes franches entre les plans : le modèle traite le clip comme une unité unique, et les coupes perturbent l’alignement temporel. Les clips de 10 à 60 secondes donnent les meilleurs résultats.
Étape 2 : préparez votre audio
Exportez ou enregistrez votre audio en fichier WAV 44,1 kHz. Si vous générez la parole avec un modèle TTS, téléchargez la sortie WAV avant de l’importer dans Lipsync 2 Pro. Le modèle accepte le MP3, mais le WAV fournit à l’algorithme de détection des phonèmes des repères temporels plus propres.
Étape 3 : lancez le modèle
Ouvrez Lipsync 2 Pro sur PicassoIA. Importez votre vidéo et votre fichier audio. Conservez les réglages par défaut pour votre première exécution : la détection automatique de la zone de la bouche gère la plupart des configurations de portrait sans réglage manuel.
Étape 4 : vérifiez le résultat
Le modèle renvoie un téléchargement au format MP4. Faites défiler la vidéo aux moments où apparaissent des mots riches en consonnes. Les sons « p », « b » et « m » sont les plus difficiles à synchroniser correctement. Si vous constatez un décalage sur ces images, relancez avec une sortie TTS légèrement plus lente, ce qui donne au mappeur de phonèmes davantage d’images par son.
Étape 5 : itérez
Pour un résultat destiné à des clients, faites passer la vidéo dans React 1 comme deuxième passe si certaines sections paraissent légèrement mécaniques. La gestion du profil par React 1 lisse souvent les artefacts de la mâchoire que Pro laisse parfois dans les séquences en trois quarts.
💡 Astuce pro : si vous générez du contenu pour une marque qui a besoin d’une identité de porte-parole constante sur de nombreuses vidéos, P Video Avatar avec une photo de référence verrouillée maintient une apparence d’avatar constante sur de longues sessions, mieux que tout autre modèle actuellement disponible sur la plateforme.
Essayez par vous-même
En 2027, le lipsync n’est plus une nouveauté, c’est un outil de production. Les équipes de contenu l’utilisent pour localiser des vidéos en 10 langues dans le temps qu’il fallait autrefois pour programmer une seule session de doublage. Les formateurs créent des vidéos explicatives personnalisées à partir d’une seule prise enregistrée. Les petites entreprises produisent des vidéos de porte-parole professionnelles sans recruter de talents à l’écran.
Le niveau de qualité a atteint un seuil tel que le public ne peut souvent pas distinguer une production doublée d’une production dans la langue d’origine. C’est ce rapprochement qui rend cette génération d’outils de lipsync IA digne d’attention, même gratuitement.
PicassoIA réunit tous les 12 modèles de lipsync au même endroit : Lipsync 2 Pro, Omni Human 1.5, Kling Lip Sync, HeyGen Video Translate, React 1, PixVerse Lipsync, Fabric 1.0, Lipsync Speed, Lipsync Precision, et d’autres. Vous n’avez pas à jongler avec des comptes sur six plateformes différentes pour mener à bien un seul flux de travail.
Commencez par Omni Human 1.5 : importez une photo de portrait et un extrait audio, et voyez ce que donne le premier résultat. La plupart des gens sont franchement surpris. Ensuite, il suffit de choisir le bon modèle selon ce que vous créez. Parcourez tous les modèles de lipsync et de voix disponibles sur picassoia.com/en/all-models.


