Qwen Image Max उस समस्या को हल करता है जो AI इमेज जनरेशन के मुख्यधारा में आने के बाद से डिज़ाइनरों, मार्केटर्स और कंटेंट क्रिएटर्स को परेशान करती रही है। बाकी लगभग हर मॉडल जनरेट की गई इमेज के भीतर पढ़ने योग्य टेक्स्ट रेंडर करने में संघर्ष करते हैं। हेडलाइन धुंधली हो जाती है। प्रोडक्ट के नाम बिगड़ जाते हैं। नंबर के अंक बदल जाते हैं। Alibaba की Qwen रिसर्च टीम द्वारा बनाया गया Qwen Image Max खास तौर पर इसी को ठीक करने के लिए डिज़ाइन किया गया था, और यह किसी भी कीमत की रेंज में ज़्यादातर टूल्स से बेहतर काम करता है।
चाहे आपको पढ़ने योग्य हेडलाइन वाला पोस्टर चाहिए, साफ़ कॉपी वाला प्रोडक्ट लेबल, या सोशल मीडिया ग्राफ़िक जो सच में वही कहे जो आप चाहते हैं, यह मॉडल ऐसा टेक्स्ट बनाता है जो जानबूझकर लिखा गया लगता है, बिगड़ा हुआ नहीं। यहाँ हर फ़ीचर, हर असली दुनिया के उपयोग और इसे काम में लाने का सटीक तरीका पूरी तरह समझाया गया है।
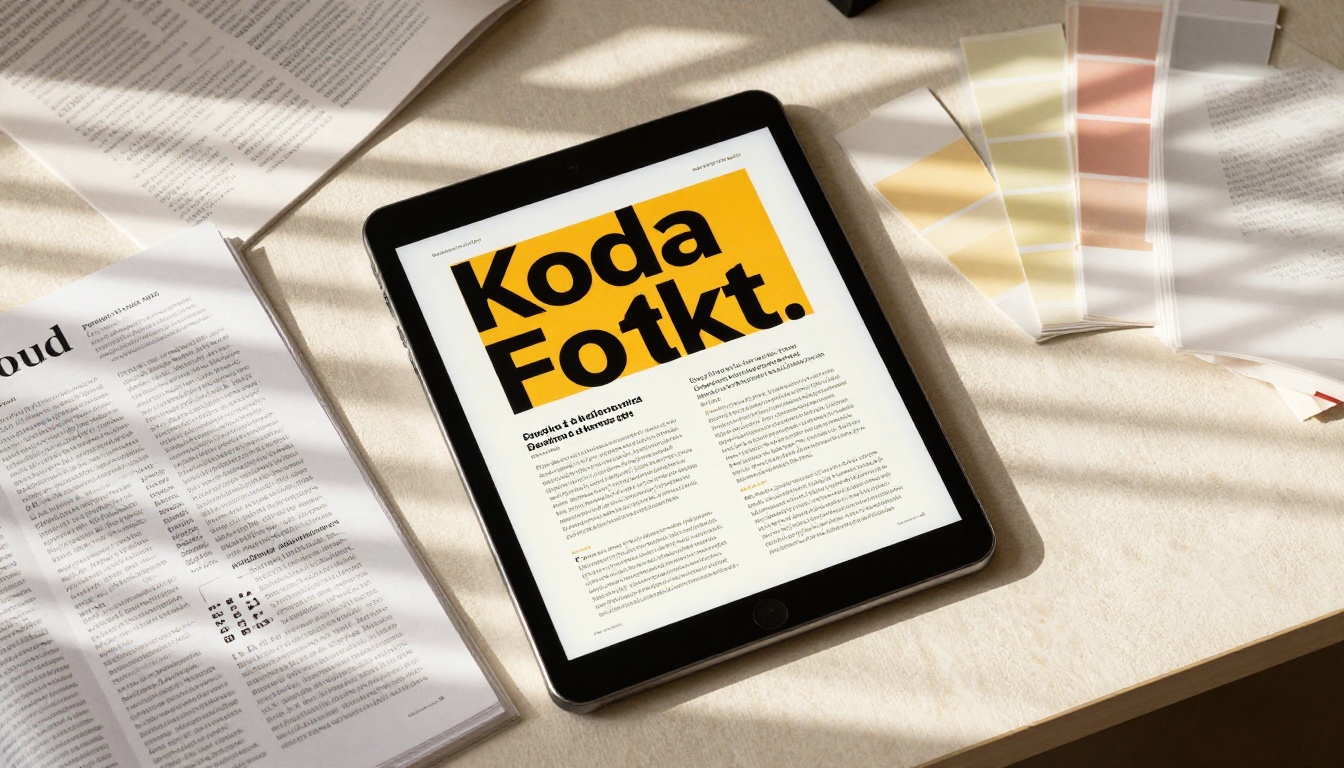
Qwen Image Max को अलग क्या बनाता है
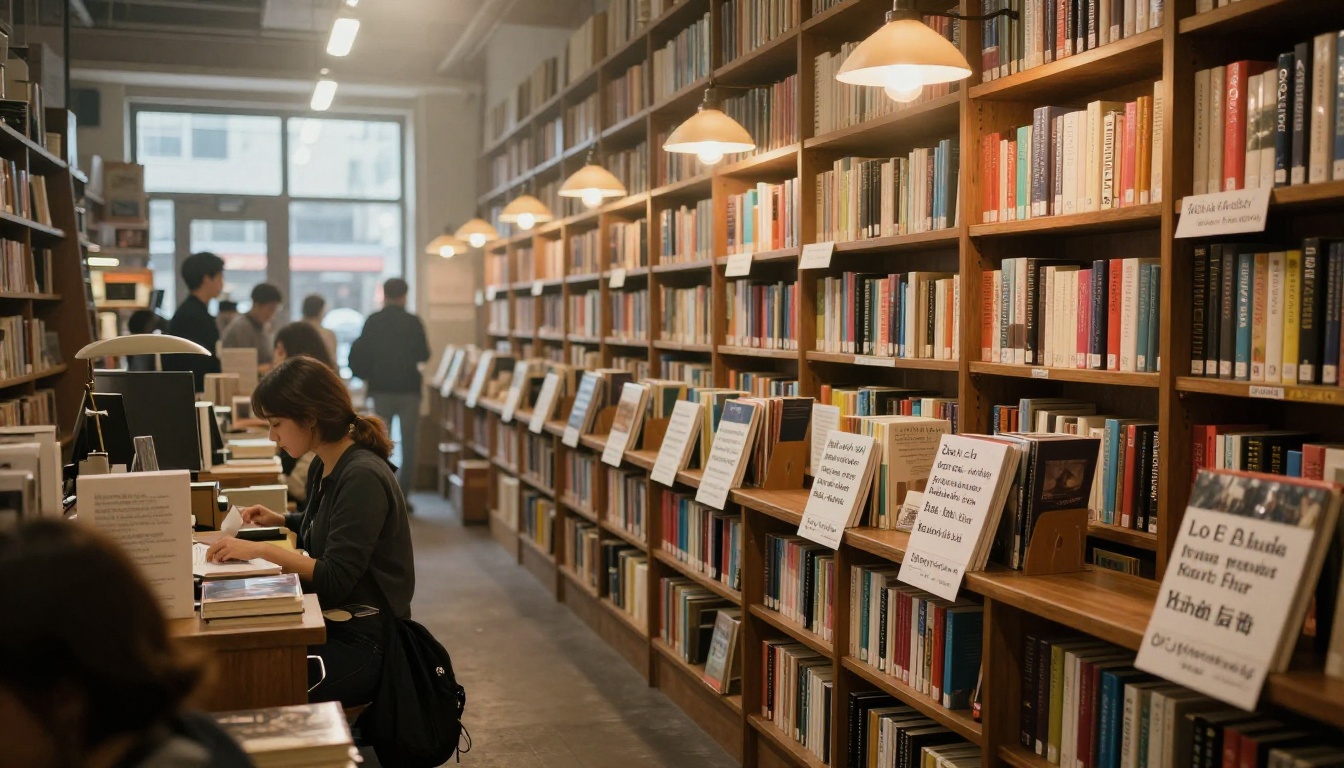
AI इमेज के ज़्यादातर मॉडल ऐसे डेटासेट पर प्रशिक्षित होते हैं जहाँ टेक्स्ट एक विज़ुअल टेक्सचर के रूप में दिखता है, सार्थक अक्षरों के रूप में नहीं। मॉडल समग्र रूप से यह सीखता है कि अक्षर कैसे दिखते हैं, लेकिन यह नहीं सीखता कि किन खास शब्दों को क्या कहना चाहिए। नतीजा वही जाने-पहचाने AI हैलुसिनेशन होते हैं: अक्षर उलझे हुए साइन बोर्ड, किताबों की स्पाइन पर गढ़े हुए शीर्षक, और बेतुकी चीज़ों वाले मेन्यू।
Qwen Image Max एक अलग आर्किटेक्चरल तरीका अपनाता है। टेक्स्ट को बस एक और विज़ुअल एलिमेंट मानने के बजाय, यह भाषा की समझ को सीधे इमेज जनरेशन पाइपलाइन में बनाता है। मॉडल जानता है कि आपने प्रॉम्प्ट में क्या लिखा है, और यह भी जानता है कि इमेज का टेक्स्ट उससे बिल्कुल मेल खाना चाहिए।
टेक्स्ट रेंडरिंग की समस्या, हल हो गई
यह कोई छोटा सुधार नहीं है। इससे बदल जाता है कि AI इमेज जनरेशन से आप असल में क्या कर सकते हैं। अचानक यह टूल इन कामों के लिए सच में उपयोगी हो जाता है:
- विज्ञापन मॉकअप जहाँ हेडलाइन की कॉपी पढ़ने योग्य होनी चाहिए
- प्रोडक्ट पैकेजिंग जहाँ इनग्रेडिएंट लिस्ट और ब्रांड के नाम सटीक होने चाहिए
- सोशल ग्राफ़िक्स जहाँ ओवरले टेक्स्ट ही पूरी इमेज का मकसद है
- प्रेज़ेंटेशन स्लाइड जिनमें पढ़ने योग्य इन्फ़ोग्राफ़िक टेक्स्ट हो
- किताब के कवर और मैगज़ीन लेआउट जिनमें असली शीर्षक और लेखकों के नाम हों
यह फ़र्क सबसे साफ़ तब दिखता है जब दृश्य में बहुत सारा टेक्स्ट हो। Qwen Image Max से चार खास किताबों के शीर्षक वाला बुकस्टोर डिस्प्ले बनवाइए, तो चारों शीर्षक सही-सही दिखेंगे। वही काम ज़्यादातर दूसरे मॉडलों से करवाइए, तो आपको शब्दों के लगभग सही आकार मिलेंगे, जो गौर से देखने पर बिखर जाते हैं।
Alibaba ने असली सटीकता के लिए बनाया
Alibaba की Qwen टीम ने इस मॉडल को अपने व्यापक मल्टीमॉडल AI सिस्टम के विस्तार के हिस्से के रूप में विकसित किया। जिस रिसर्च ग्रुप ने Qwen लार्ज लैंग्वेज मॉडल बनाए, वही यहाँ उस भाषा की समझ को विज़ुअल दुनिया में ले आता है। यह मॉडल लैटिन लिपियों और चीनी अक्षरों दोनों को बराबर सटीकता से संभालता है, जिससे यह बहुभाषी कंटेंट बनाने के लिए खास तौर पर मज़बूत बन जाता है।
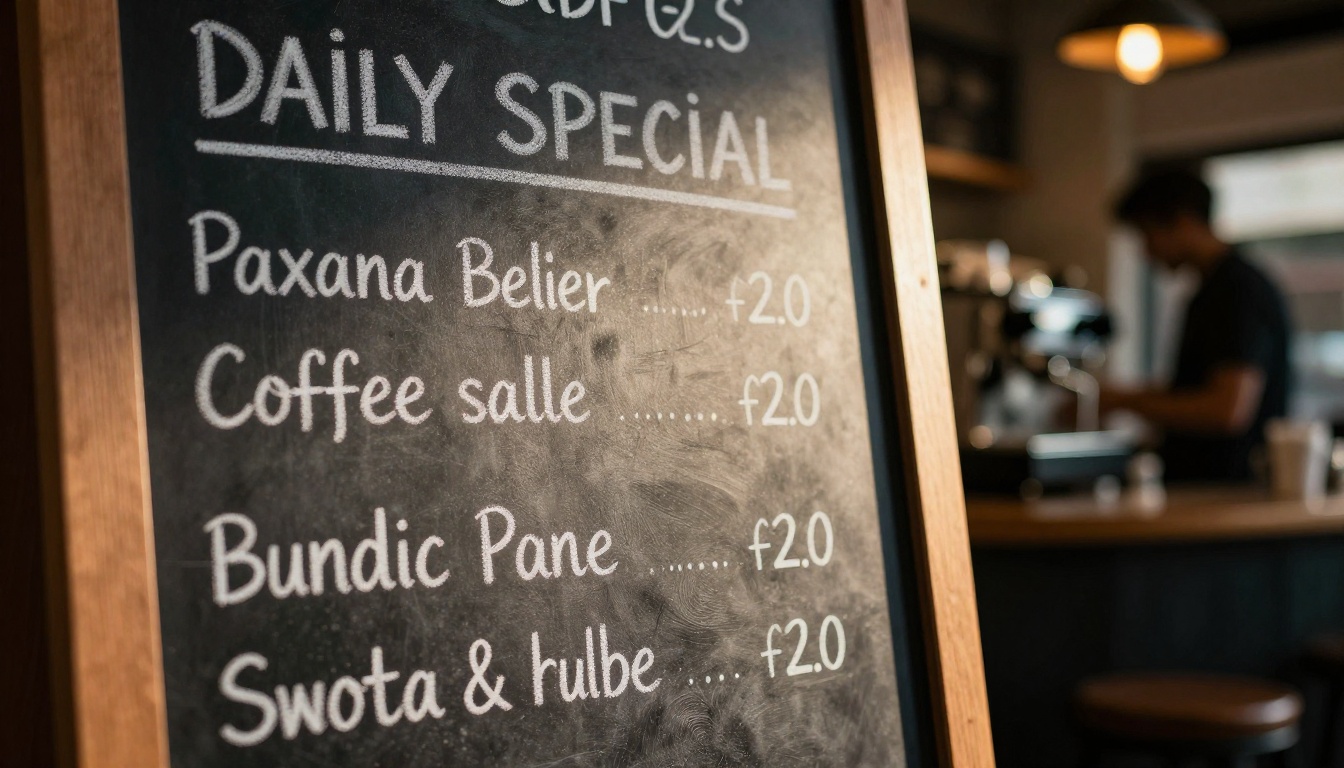
जानने योग्य मुख्य फ़ीचर
PicassoIA पर Qwen Image Max कई कंट्रोल्स के साथ आता है जो आउटपुट पर आपको सटीक नियंत्रण देते हैं। यहाँ बताया गया है कि हर एक कंट्रोल असल में क्या करता है।
किसी भी सीन में सटीक टाइपोग्राफ़ी
सबसे बड़ा फ़ीचर खुद टेक्स्ट रेंडरिंग है। आप ऐसा सीन बताते हैं जिसमें टेक्स्ट हो, ठीक-ठीक बताते हैं कि टेक्स्ट में क्या लिखा होना चाहिए, और मॉडल ऐसी इमेज बनाता है जिसमें वह टेक्स्ट पढ़ने योग्य और सही वर्तनी वाला हो। यह इन सभी तरह के मामलों में काम करता है:
- चॉकबोर्ड साइन और कैफ़े मेन्यू
- हेडलाइन कॉपी वाले पोस्टर और बैनर
- मल्टी-लाइन टाइपोग्राफ़ी वाले प्रोडक्ट लेबल
- हाथ से लिखे नोट और पत्र
- बुलेट कंटेंट वाली इन्फ़ोग्राफ़िक स्लाइड
- तारीख, समय और जगह वाले इवेंट फ़्लायर
मॉडल मिश्रित टेक्स्ट के मामलों को भी संभालता है: एक ही सीन में बड़ी डिस्प्ले हेडलाइन और छोटा बॉडी टेक्स्ट दोनों हो सकते हैं, और दोनों सही रेंडर होंगे।
इमेज-टू-इमेज पाइपलाइन
टेक्स्ट-टू-इमेज जनरेशन के अलावा, Qwen Image एक इमेज-टू-इमेज पाइपलाइन को सपोर्ट करता है। कोई संदर्भ फ़ोटो या डिज़ाइन अपलोड करें, और मॉडल उसे संरचनात्मक आधार की तरह इस्तेमाल करता है, जबकि उस पर आपका नया प्रॉम्प्ट लागू करता है। यह तब काम आता है जब आपके पास कोई मौजूदा लेआउट या कंपोज़िशन हो जिसे आप शून्य से शुरू किए बिना दोबारा बनाना चाहते हैं।
strength पैरामीटर नियंत्रित करता है कि मॉडल आपकी इनपुट इमेज से कितना हटता है। कम स्ट्रेंथ सेटिंग (लगभग 0.3 से 0.5) कंपोज़िशन को आपकी मूल इमेज के करीब रखती है। ऊँची स्ट्रेंथ सेटिंग (0.8 और उससे ऊपर) मॉडल को दोबारा व्याख्या करने की ज़्यादा आज़ादी देती है।
💡 जब आपके पास मोटा स्केच या वायरफ़्रेम लेआउट हो, तब इमेज-टू-इमेज इस्तेमाल करें। उसे संदर्भ इमेज के रूप में डालें, मध्यम स्ट्रेंथ रखें, और अंतिम संस्करण का वर्णन करें। मॉडल आपकी स्पेसिंग और कंपोज़िशन बनाए रखेगा और विज़ुअल डिटेल्स भर देगा।
LoRA स्टाइल कस्टमाइज़ेशन
सबसे शक्तिशाली फ़ीचरों में से एक LoRA वेट सपोर्ट है। आप URL से एक कस्टम .safetensors LoRA फ़ाइल लोड कर सकते हैं और मॉडल उस स्टाइल को आपकी सभी जनरेशन में लगातार लागू करेगा। कई इमेज में एक जैसी विज़ुअल ब्रांड पहचान बनाने का यही रास्ता है।
lora_scale पैरामीटर बताता है कि LoRA आउटपुट को कितनी मज़बूती से प्रभावित करता है, 0 (कोई प्रभाव नहीं) से 1 (पूरा प्रभाव) तक। ज़्यादातर स्टाइल के लिए 0.7 से 0.9 के बीच की वैल्यू LoRA के प्रॉम्प्ट कंटेंट पर हावी हुए बिना साफ़ नतीजा देती है।
सात आस्पेक्ट रेशियो
मॉडल सात प्रीसेट आस्पेक्ट रेशियो सपोर्ट करता है:
| रेशियो | सबसे अच्छा उपयोग |
|---|
| 1:1 | Instagram पोस्ट, प्रोफ़ाइल इमेज |
| 16:9 | YouTube थंबनेल, प्रेज़ेंटेशन, डेस्कटॉप वॉलपेपर |
| 9:16 | Stories, TikTok, Reels |
| 4:3 | पारंपरिक डिस्प्ले, ब्लॉग हेडर |
| 3:4 | Pinterest, पोर्ट्रेट प्रिंट |
| 3:2 | फ़ोटोग्राफ़ी प्रिंट का मानक |
| 2:3 | पोर्ट्रेट पोस्टर, किताब के कवर |
गाइडेंस स्केल कंट्रोल
guidance पैरामीटर बताता है कि मॉडल आपके प्रॉम्प्ट को कितनी शाब्दिक रूप से समझता है। कम वैल्यू (लगभग 2 से 2.5) ज़्यादा नैचुरल, थोड़े सपनीले आउटपुट देती हैं। ऊँची वैल्यू (3 से 4) मॉडल को प्रॉम्प्ट का ज़्यादा सटीकता से पालन करने पर मजबूर करती हैं, जो आमतौर पर तब चाहिए होता है जब सटीक टेक्स्ट रेंडरिंग मायने रखती हो।
टेक्स्ट-भारी प्रॉम्प्ट के लिए, 3.5 से 4 की गाइडेंस वैल्यू आमतौर पर सबसे तीखे और सबसे सटीक नतीजे देती है।
रचनाकारों के लिए असली उपयोग
ऊपर बताए फ़ीचर कई व्यावहारिक उपयोगों में बदल जाते हैं। यहाँ बताया गया है कि Qwen Image Max असली क्रिएटिव वर्कफ़्लो में कहाँ फ़िट होता है।
पोस्टर और फ़्लायर डिज़ाइन
इवेंट आयोजक, संगीतकार और वेन्यू प्रमोटर लगातार एक-बार के प्रमोशनल ग्राफ़िक्स चाहते हैं। पारंपरिक रूप से इसका मतलब या तो डिज़ाइनर को हायर करना है या टेम्पलेट टूल्स से जूझना। Qwen Image Max के साथ आप सीन और कॉपी का वर्णन करते हैं, और आपको सही टेक्स्ट पहले से लगा हुआ पूरा पोस्टर मिल जाता है।
"concert poster for an indie rock band called The Static Waves, show date Friday October 3rd, venue The Roxy Los Angeles, headliner text large at top" जैसा प्रॉम्प्ट एक असली पोस्टर बनाएगा, जिसमें यह सारी जानकारी सही-सही दिखाई देती है। यह आउटपुट या तो सीधे फ़ाइनल होता है या छोटे-मोटे मैन्युअल बदलावों के लिए एक मज़बूत शुरुआती बिंदु।
सोशल मीडिया ग्राफ़िक्स
सोशल कंटेंट टीमें हर हफ़्ते भारी मात्रा में ग्राफ़िक्स बनाती हैं। उनमें से ज़्यादातर में टेक्स्ट ओवरले होते हैं: कैप्शन, प्रमोशनल संदेश, प्रोडक्ट के दावे। Qwen Image Edit Plus एडिटिंग क्षमताओं के साथ इसे और आगे ले जाता है, लेकिन अकेला बेस Qwen Image मॉडल ही जनरेशन वाला हिस्सा कुशलता से संभाल लेता है।
9:16 रेशियो प्रीसेट Stories-फ़ॉर्मेट कंटेंट को आसानी से जनरेट करना संभव बनाता है, जहाँ विज़ुअल सीन और ओवरले टेक्स्ट दोनों प्रॉम्प्ट का हिस्सा हों। बाद में अलग से मैनुअल टेक्स्ट लेयर की ज़रूरत नहीं पड़ती।
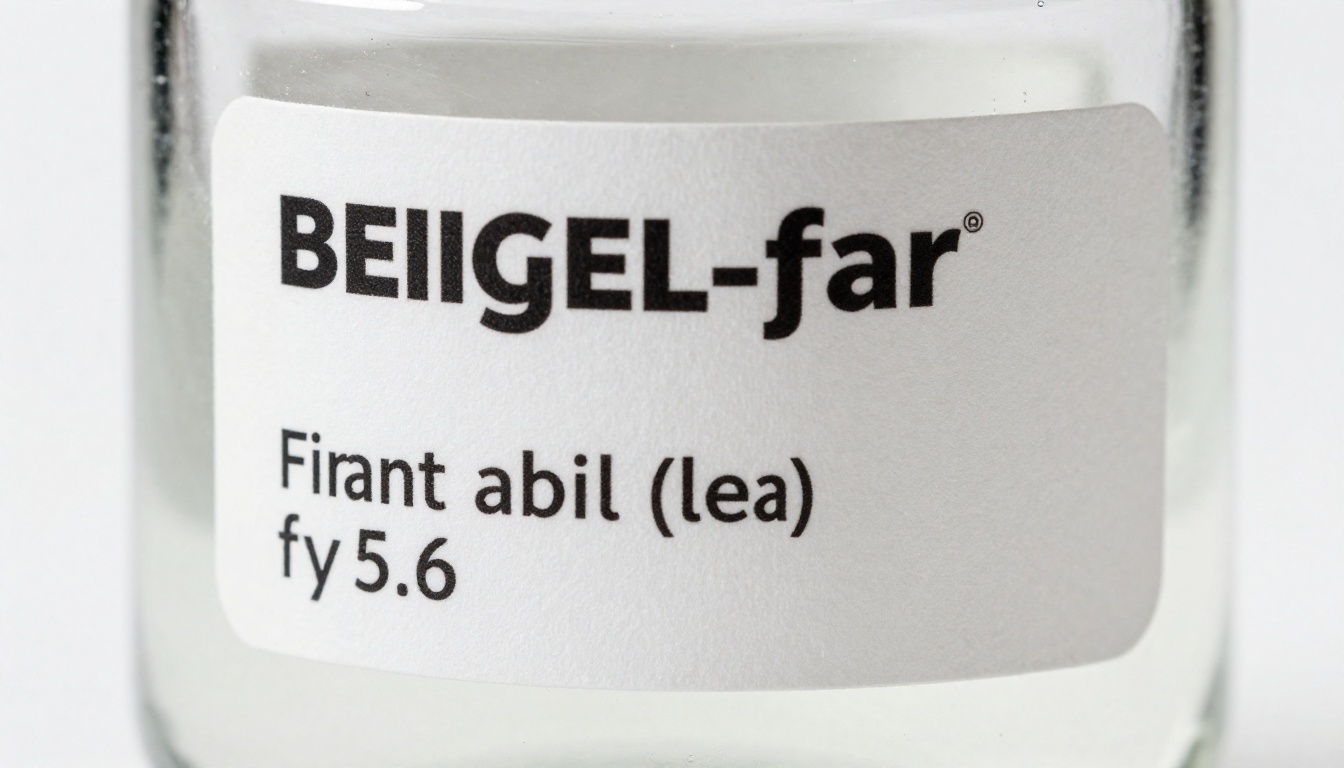
प्रोडक्ट लेबल मॉकअप
यह सबसे ज़्यादा मूल्य वाले उपयोगों में से एक है। शुरुआती चरण की प्रोडक्ट टीमों और ब्रांड डिज़ाइनरों को प्रिंट प्रोडक्शन से पहले लेबल मॉकअप चाहिए होते हैं। सटीक टेक्स्ट रेंडरिंग के साथ आप असली ब्रांड नाम, इनग्रेडिएंट लिस्ट और कोई भी दूसरी कॉपी सही जगह पर रखकर यथार्थवादी प्रोडक्ट पैकेजिंग मॉकअप जनरेट कर सकते हैं।
ये क्लाइंट प्रेज़ेंटेशन, इन्वेस्टर डेक के रूप में काम करते हैं, या बस डिज़ाइन टूल को छुए बिना लेबल डिज़ाइन कॉन्सेप्ट पर तेज़ी से दोहराने का तरीका हैं।
बड़े पैमाने पर ब्रांडेड कंटेंट
LoRA स्टाइल लोडिंग को लगातार प्रॉम्प्टिंग के साथ मिलाएँ, और आपके पास एक स्केलेबल ब्रांडेड कंटेंट सिस्टम की नींव है। ऐसा स्टाइल LoRA लोड करें जो आपकी ब्रांड सौंदर्य दृष्टि को दर्शाता हो, फिर अलग-अलग टेक्स्ट कंटेंट के साथ लेकिन एक जैसी विज़ुअल भाषा वाली दर्जनों वेरिएशन जनरेट करें। PicassoIA पर Qwen Image LoRA Trainer आपको अपनी मौजूदा ब्रांड एसेट्स से सीधे अपने स्टाइल LoRA ट्रेन करने देता है।
Qwen Image Max बनाम दूसरे मॉडल
यह दूसरे विकल्पों के मुकाबले कैसा है? टेक्स्ट-भारी इमेज जनरेशन के लिए सबसे ज़रूरी पहलुओं पर सीधी तुलना यहाँ है।
| फ़ीचर | Qwen Image Max | SDXL | Flux Schnell | DALL-E 3 |
|---|
| इमेज में टेक्स्ट की सटीकता | उत्कृष्ट | कमज़ोर | मध्यम | अच्छा |
| इमेज-टू-इमेज सपोर्ट | हाँ | हाँ | सीमित | नहीं |
| LoRA सपोर्ट | हाँ | हाँ | हाँ | नहीं |
| बहुभाषी टेक्स्ट | हाँ (लैटिन + चीनी) | कमज़ोर | सीमित | मध्यम |
| स्पीड मोड | हाँ (go_fast) | नहीं | नेटिव फ़ास्ट | N/A |
| आस्पेक्ट रेशियो प्रीसेट | 7 | अलग-अलग | 7 | 4 |
| PicassoIA पर मुफ़्त | हाँ | हाँ | हाँ | नहीं |
सबसे बड़ा फ़ायदा बहुभाषी टेक्स्ट रेंडरिंग है। जिन टीमों को अंग्रेज़ी और चीनी दोनों में कंटेंट बनाना है, या लैटिन और CJK लिपियों के किसी भी मेल में, उनके लिए Qwen Image Max अकेला ऐसा मॉडल है जो दोनों को बिना अतिरिक्त प्रॉम्प्ट इंजीनियरिंग की चालों के भरोसेमंद ढंग से संभालता है।
💡 Qwen Image Max हर काम के लिए हर मॉडल की जगह नहीं लेता। बिना टेक्स्ट वाले शुद्ध फ़ोटोरियलिस्टिक सीन के लिए Flux या Juggernaut जैसे मॉडल ज़्यादा फ़ोटोग्राफ़िक रियलिज़्म दे सकते हैं। लेकिन जैसे ही आपके ब्रीफ़ में इमेज के भीतर पढ़ने योग्य टेक्स्ट शामिल हो, Qwen Image Max सही विकल्प है।
PicassoIA पर Qwen Image कैसे इस्तेमाल करें
Qwen Image Max PicassoIA पर मुफ़्त उपलब्ध है। यहाँ सटीक वर्कफ़्लो है।
स्टेप 1: मॉडल खोलें
PicassoIA पर Qwen Image पेज पर जाएँ। अपनी पहली इमेज जनरेट करने के लिए किसी अकाउंट की ज़रूरत नहीं है।
स्टेप 2: अपना प्रॉम्प्ट लिखें
अपने प्रॉम्प्ट को तीन हिस्सों में बनाएँ:
- सीन: भौतिक वातावरण और मूड का वर्णन करें
- टेक्स्ट एलिमेंट: हर उस टेक्स्ट के बारे में साफ़-साफ़ बताएँ जो दिखना चाहिए, सटीक शब्दों सहित
- स्टाइल का विवरण: रोशनी, रंग पैलेट, और अगर ज़रूरी हो तो फ़ोटोग्राफ़िक स्टाइल
उदाहरण: "A vintage-style coffee shop menu board mounted on a brick wall, showing the text 'Morning Specials' as the header, with three items listed: 'Espresso $3', 'Cortado $4', 'Cold Brew $5', warm amber cafe lighting from the left, shallow depth of field"
स्टेप 3: अपने पैरामीटर सेट करें
- आस्पेक्ट रेशियो: अपने इच्छित आउटपुट फ़ॉर्मेट से मिलाएँ
- गाइडेंस: टेक्स्ट-भारी प्रॉम्प्ट के लिए 3.5 या 4 रखें
- इमेज साइज़: जब तक गति की ज़रूरत न हो,
optimize_for_quality इस्तेमाल करें
- स्टेप्स: अधिकतम गुणवत्ता के लिए 50, तेज़ प्रीव्यू के लिए 28
स्टेप 4: समीक्षा करें और दोहराएँ
आउटपुट में सबसे पहले टेक्स्ट की सटीकता जाँचें। अगर कोई शब्द गलत रेंडर हो, तो यह आज़माएँ:
- प्रॉम्प्ट में टेक्स्ट एलिमेंट को और साफ़ बनाएँ ("a sign that reads exactly: [your text]")
- गाइडेंस स्केल को थोड़ा बढ़ाएँ
- प्रॉम्प्ट में खास टेक्स्ट स्ट्रिंग्स के चारों ओर इनवर्टेड कॉमा लगाएँ
स्टेप 5: एक्सपोर्ट करें
WebP, JPG या PNG के रूप में डाउनलोड करें। आउटपुट क्वालिटी स्लाइडर 0 से 100 तक चलता है। वेब उपयोग के लिए 80 फ़ाइल साइज़ और शार्पनेस का अच्छा संतुलन देता है। प्रिंट मॉकअप के लिए इसे 100 पर रखें।
बेहतर नतीजों के लिए टिप्स
कुछ पैटर्न जो अलग-अलग प्रॉम्प्ट प्रकारों में आउटपुट की गुणवत्ता लगातार बेहतर करते हैं।
टेक्स्ट-भारी इमेज के लिए प्रॉम्प्ट लिखना
प्रॉम्प्ट के भीतर अपनी टेक्स्ट स्ट्रिंग्स को इनवर्टेड कॉमा में लपेटें। मॉडल उद्धृत टेक्स्ट को रेंडर करने वाली शाब्दिक स्ट्रिंग्स की तरह पढ़ता है, न कि व्याख्या करने वाली वर्णनात्मक भाषा की तरह। तुलना करें:
- कमज़ोर: "a sign showing the store name and hours"
- बेहतर: "a sign reading 'OPEN DAILY 9AM TO 9PM' with the store name 'Harbor Books' above it"
मल्टी-लाइन टेक्स्ट के लिए पदानुक्रम साफ़-साफ़ बताएँ: हेडर, सबहेडर, बॉडी टेक्स्ट। जब आप सिर्फ़ कंटेंट नहीं, बल्कि टेक्स्ट एलिमेंट्स के आपसी संबंध का वर्णन करते हैं, तो मॉडल टाइपोग्राफ़िक पदानुक्रम को बेहतर संभालता है।
गाइडेंस स्केल का प्रभावी उपयोग
गाइडेंस स्केल में रचनात्मकता और सटीकता के बीच संतुलन रखना पड़ता है: एक बढ़ता है तो दूसरा घटता है। खास तौर पर टेक्स्ट रेंडरिंग के लिए:
- गाइडेंस 2.0 से 2.5: ज़्यादा वायुमंडलीय, इम्प्रेशनिस्टिक सीन जहाँ सटीक टेक्स्ट कम अहम है
- गाइडेंस 3.0: संतुलित आउटपुट, आम रचनात्मक काम के लिए अच्छा
- गाइडेंस 3.5 से 4.0: अधिकतम सटीकता, लेबल या पोस्टर जैसे टेक्स्ट-क्रिटिकल आउटपुट के लिए सबसे अच्छा
4.0 से ऊपर जाने पर ओवरसैचुरेशन और थोड़े कृत्रिम दिखने वाले आउटपुट आ सकते हैं।
इमेज-टू-इमेज कब इस्तेमाल करें
Qwen Image में इमेज-टू-इमेज पाइपलाइन सबसे ज़्यादा मूल्यवान तब होती है जब:
- आपके पास कोई मोटा कंपोज़िशनल स्केच हो जिसे आप पूरा करना चाहते हैं
- आप पहले से बने जनरेटेड आउटपुट पर दोहराव कर रहे हों
- आप किसी फ़ोटो जैसे सीन में टेक्स्ट जोड़ना चाहते हों और बैकग्राउंड बनाए रखना चाहते हों
ज़्यादातर इमेज-टू-इमेज कामों के लिए स्ट्रेंथ 0.6 से 0.75 के बीच रखें। 0.5 से कम होने पर आउटपुट इनपुट जैसा ही लगेगा। 0.85 से ऊपर होने पर वह स्ट्रक्चरल संदर्भ खो जाएगा जिसे आप बचाना चाहते थे।
प्रॉम्प्ट की गुणवत्ता का अंतर
Qwen Image Max के साथ एक पैटर्न लगातार दिखता है: अस्पष्ट प्रॉम्प्ट से औसत दर्जे की टेक्स्ट रेंडरिंग मिलती है, और विशिष्ट प्रॉम्प्ट से उत्कृष्ट टेक्स्ट रेंडरिंग। यह मॉडल ज़्यादातर मॉडलों से ज़्यादा सटीकता को पुरस्कृत करता है।
इसका कारण आर्किटेक्चरल है। मॉडल अपनी भाषा की समझ का इस्तेमाल करके आपके बताए टेक्स्ट को विज़ुअल अक्षरों से मैप करता है। अगर प्रॉम्प्ट इस बारे में अस्पष्ट है कि कहाँ क्या दिखना चाहिए, तो मॉडल को अनुमान लगाने पड़ते हैं, और वे अनुमान गलतियाँ पैदा करते हैं।
Qwen Image Max के लिए प्रॉम्प्ट लिखने को उसी तरह सोचें जैसे आप डिज़ाइन ब्रीफ़ लिखते हैं। सटीक आयाम, सटीक कॉपी, साफ़ पदानुक्रम। आप विज़ुअल का जितना सटीक वर्णन करेंगे, मॉडल उसे उतनी ही सटीकता से लागू कर सकेगा।
💡 बहुभाषी टेक्स्ट के लिए, प्रॉम्प्ट में दोनों भाषा संस्करण लिखें और बताएँ कि कौन सा कहाँ दिखे। मॉडल चीनी अक्षरों को लैटिन लिपि जितनी ही सटीकता से संभालता है, जिससे यह उन ब्रांड्स के लिए सच में उपयोगी है जो दोनों भाषाओं में काम करते हैं।
अभी क्या बनाएँ
आपके पास सारी जानकारी है। अब इसके साथ असल में क्या करना है, यह यहाँ है।
एक ऐसी टेक्स्ट-भारी इमेज से शुरुआत करें जिसे आप इसलिए टालते रहे हैं क्योंकि टेक्स्ट वाली समस्या को संभालना बहुत मुश्किल लगा। एक मेन्यू। एक पोस्टर। एक प्रोडक्ट लेबल मॉकअप। एक प्रेज़ेंटेशन स्लाइड का विज़ुअल। PicassoIA पर Qwen Image Max खोलें, अपनी सटीक कॉपी को कोटेशन में रखकर एक विशिष्ट प्रॉम्प्ट लिखें, गाइडेंस 3.5 पर सेट करें और जनरेट करें।
अगर आप और आगे जाना चाहते हैं, तो मौजूदा इमेज को नए टेक्स्ट एलिमेंट्स के साथ एडिट करने के लिए Qwen Image Edit Plus मॉडल आज़माएँ, या अपने सारे टेक्स्ट-भारी कंटेंट में एक जैसी विज़ुअल स्टाइल बनाने के लिए Qwen Image LoRA Trainer आज़माएँ। ये तीनों PicassoIA पर उपलब्ध हैं, सभी आज़माने के लिए मुफ़्त हैं, और ऐसे आउटपुट बनाने में सक्षम हैं जिनके लिए कुछ साल पहले तक एक पेशेवर डिज़ाइनर की ज़रूरत पड़ती।
AI इमेज जनरेटर टेक्स्ट के साथ पहले क्या कर पाते थे और Qwen Image Max अब क्या करता है, इसके बीच का तकनीकी फ़ासला बहुत बड़ा है। ब्रांड एसेट्स, मार्केटिंग सामग्री, या ऐसा कोई भी क्रिएटिव कंटेंट बनाने वालों के लिए जहाँ इमेज के भीतर के शब्द सच में मायने रखते हैं, यह मॉडल पूरा हिसाब-किताब बदल देता है। इसे अपने अगले ब्रीफ़ पर आज़माएँ और देखें कि यह फ़ासला कितना कम हो चुका है।


