O Qwen Image Max resolve um problema que frustra designers, profissionais de marketing e criadores de conteúdo desde que a geração de imagens por IA se popularizou. Quase todos os outros modelos têm dificuldade para renderizar texto legível dentro de uma imagem gerada. Os títulos ficam borrados. Os nomes de produtos se distorcem. Os números trocam dígitos. O Qwen Image Max, criado pela equipe de pesquisa Qwen da Alibaba, foi projetado especificamente para corrigir isso, e faz isso melhor do que a maioria das ferramentas em qualquer faixa de preço.
Não importa se você precisa de um cartaz com um título legível, um rótulo de produto com textos nítidos ou uma arte para redes sociais que realmente diga o que você quer, este modelo produz textos que parecem intencionais, e não quebrados. Aqui está um detalhamento completo de cada recurso, cada caso de uso real e exatamente como colocar o modelo para trabalhar.
O que torna o Qwen Image Max diferente
A grande maioria dos modelos de geração de imagens por IA é treinada em conjuntos de dados nos quais o texto aparece como uma textura visual, e não como caracteres com significado. O modelo aprende como as letras se parecem em conjunto, mas não aprende o que palavras específicas deveriam dizer. O resultado são as conhecidas alucinações da IA: placas com letras embaralhadas, lombadas de livros com títulos inventados, cardápios com itens sem sentido.
O Qwen Image Max adota uma abordagem arquitetural diferente. Em vez de tratar o texto como apenas mais um elemento visual, ele incorpora a compreensão de linguagem diretamente no pipeline de geração de imagens. O modelo sabe o que você escreveu no prompt e sabe que o texto na imagem deve corresponder exatamente a ele.
O problema da renderização de texto, resolvido
Isso não é uma melhoria pequena. Muda o que você realmente consegue fazer com a geração de imagens por IA. De repente, a ferramenta se torna genuinamente útil para:
- Mockups publicitários em que o texto do título precisa ser legível
- Embalagens de produtos em que a lista de ingredientes e os nomes de marca precisam estar corretos
- Artes para redes sociais em que o texto sobreposto é o ponto central de toda a imagem
- Slides de apresentação com texto de infográfico legível
- Capas de livros e layouts de revistas com títulos e nomes de autores reais
A diferença aparece com mais clareza em cenas complexas e com muito texto. Peça ao Qwen Image Max para gerar a vitrine de uma livraria com quatro títulos de livros específicos, e todos os quatro vão aparecer corretamente. Peça a mesma coisa à maioria dos outros modelos e você recebe formas aproximadas de palavras que se dissolvem quando você olha de perto.
Criado pela Alibaba para ter precisão real
A equipe Qwen da Alibaba desenvolveu este modelo como parte de um esforço mais amplo em sistemas de IA multimodais. O mesmo grupo de pesquisa por trás dos modelos de linguagem (LLMs) Qwen leva essa compreensão de linguagem para o domínio visual. O modelo lida com escritas latinas e caracteres chineses com a mesma precisão, o que o torna especialmente forte para a criação de conteúdo multilíngue.
Recursos principais que valem a pena conhecer
O Qwen Image Max no PicassoIA vem com um conjunto de controles que dão a você comando preciso sobre o resultado. Veja o que cada um faz na prática.
Tipografia precisa em qualquer cena
O grande destaque é a própria renderização de texto. Você descreve uma cena que contém texto, especifica exatamente o que o texto deve dizer, e o modelo gera uma imagem em que esse texto está legível e com a grafia correta. Isso funciona em:
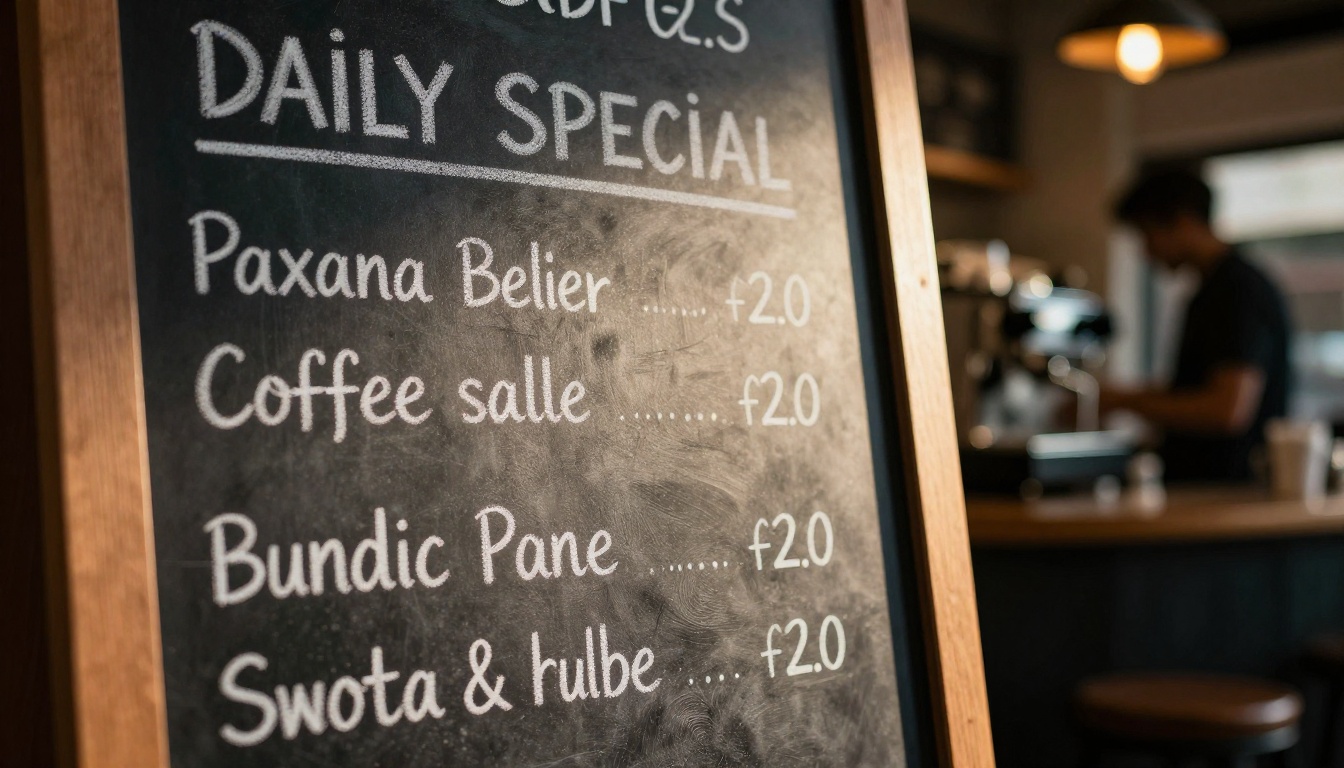
- Lousas e cardápios de cafeteria
- Cartazes e banners com textos de destaque
- Rótulos de produtos com tipografia em várias linhas
- Anotações e cartas manuscritas
- Slides de infográficos com conteúdo em tópicos
- Panfletos de eventos com datas, horários e locais
O modelo também lida com casos de texto misto: uma cena pode conter tanto um título grande de destaque quanto um texto menor de corpo, e ambos serão renderizados corretamente.
Pipeline de imagem para imagem
Além da geração de texto para imagem, o Qwen Image oferece suporte a um pipeline de imagem para imagem. Envie uma foto de referência ou um design e o modelo a usa como base estrutural enquanto aplica seu novo prompt por cima. Isso é útil quando você tem um layout ou uma composição existente que quer retrabalhar sem começar do zero.
O parâmetro strength controla o quanto o modelo se afasta da sua imagem de entrada. Uma configuração de força baixa (em torno de 0,3 a 0,5) mantém a composição próxima da original. Uma configuração de força alta (0,8 ou mais) dá ao modelo mais liberdade para reinterpretar.
💡 Use imagem para imagem quando você tiver um esboço rápido ou um layout de wireframe. Envie-o como imagem de referência, defina uma força média e descreva a versão final que você quer. O modelo preserva seus espaçamentos e a composição enquanto preenche os detalhes visuais.
Personalização de estilo com LoRA
Um dos recursos mais poderosos é o suporte a pesos de LoRA. Você pode carregar um arquivo LoRA .safetensors personalizado a partir de uma URL, e o modelo aplicará esse estilo de forma consistente em todas as suas gerações. Esse é o caminho para construir uma identidade visual consistente em várias imagens.
O parâmetro lora_scale ajusta a intensidade com que o LoRA influencia o resultado, de 0 (nenhuma influência) a 1 (influência total). Para a maioria das aplicações de estilo, valores entre 0,7 e 0,9 dão um resultado limpo, sem que o LoRA sobrepuje o conteúdo do prompt.
Sete proporções de imagem
O modelo oferece suporte a sete proporções predefinidas:
| Proporção | Melhor uso |
|---|
| 1:1 | Posts do Instagram, imagens de perfil |
| 16:9 | Miniaturas do YouTube, apresentações, papéis de parede para desktop |
| 9:16 | Stories, TikTok, Reels |
| 4:3 | Exibição tradicional, cabeçalhos de blog |
| 3:4 | Pinterest, impressões em retrato |
| 3:2 | Padrão de impressão fotográfica |
| 2:3 | Cartazes em retrato, capas de livros |
Controle da guidance scale
O parâmetro guidance controla o quanto o modelo interpreta seu prompt de forma literal. Valores mais baixos (em torno de 2 a 2,5) produzem resultados mais naturalistas e levemente oníricos. Valores mais altos (3 a 4) levam o modelo a seguir o prompt com mais precisão, o que geralmente é o que você quer quando a renderização exata do texto importa.
Para prompts com muito texto, um valor de guidance entre 3,5 e 4 normalmente produz os resultados mais nítidos e precisos.
Casos de uso reais para criadores
Os recursos acima se traduzem em um conjunto de aplicações genuinamente práticas. Veja onde o Qwen Image Max se encaixa em fluxos de trabalho criativos reais.
Design de cartazes e panfletos
Organizadores de eventos, músicos e promotores de casas de show precisam constantemente de artes promocionais avulsas. Tradicionalmente, isso significa contratar um designer ou lidar com ferramentas de template. Com o Qwen Image Max, você descreve a cena e o texto, e recebe um cartaz completo com o texto correto já no lugar.
Um prompt como "concert poster for an indie rock band called The Static Waves, show date Friday October 3rd, venue The Roxy Los Angeles, headliner text large at top" gera um cartaz de verdade, em que cada uma dessas informações aparece corretamente. O resultado é final ou um ótimo ponto de partida para pequenos ajustes manuais.
Artes para redes sociais
Equipes de conteúdo para redes sociais geram volumes enormes de artes toda semana. A maior parte desse conteúdo envolve textos sobrepostos: legendas, mensagens promocionais, alegações sobre produtos. O Qwen Image Edit Plus amplia isso com recursos de edição, mas o modelo base Qwen Image sozinho já cuida da geração de forma eficiente.
A predefinição de proporção 9:16 facilita gerar conteúdo no formato de Stories em que a cena visual e o texto sobreposto fazem parte do prompt. Não é preciso nenhuma camada de texto manual depois.
Mockups de rótulos de produtos
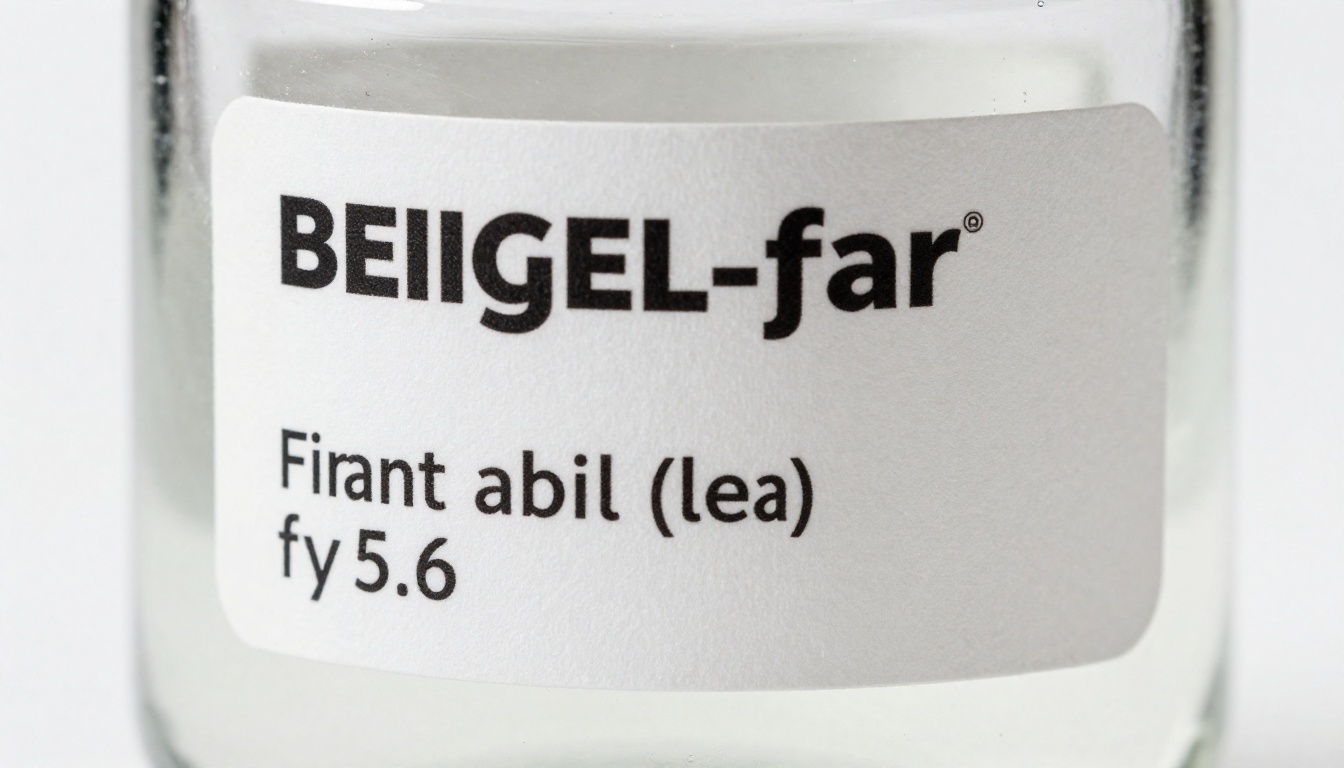
Este é um dos casos de uso de maior valor. Equipes de produtos em fase inicial e designers de marca precisam de mockups de rótulos antes de se comprometer com a produção gráfica. Com renderização precisa de texto, você pode gerar mockups realistas de embalagens com o nome de marca real, a lista de ingredientes e qualquer outro texto posicionado corretamente na imagem.
Esses mockups servem como apresentações para clientes, materiais para investidores ou simplesmente como uma forma de iterar rapidamente sobre conceitos de rótulos sem mexer em uma ferramenta de design.
Conteúdo de marca em escala
Combine o carregamento de LoRA de estilo com prompts consistentes e você terá a base para um sistema escalável de conteúdo de marca. Carregue um LoRA de estilo que reflita a estética da sua marca e, em seguida, gere dezenas de variações com conteúdos de texto diferentes, mas com uma linguagem visual consistente. O Qwen Image LoRA Trainer no PicassoIA permite treinar seus próprios LoRAs de estilo diretamente a partir dos ativos de marca que você já tem.
Como ele se compara às alternativas? Veja uma comparação direta nas dimensões mais importantes para a geração de imagens com muito texto.
| Recurso | Qwen Image Max | SDXL | Flux Schnell | DALL-E 3 |
|---|
| Precisão do texto nas imagens | Excelente | Fraca | Moderada | Boa |
| Suporte a imagem para imagem | Sim | Sim | Limitado | Não |
| Suporte a LoRA | Sim | Sim | Sim | Não |
| Texto multilíngue | Sim (latino + chinês) | Fraco | Limitado | Moderado |
| Modo de velocidade | Sim (go_fast) | Não | Rápido nativo | N/A |
| Predefinições de proporção | 7 | Varia | 7 | 4 |
| Grátis no PicassoIA | Sim | Sim | Sim | Não |
A grande vantagem é a renderização de texto multilíngue. Para equipes que produzem conteúdo em inglês e chinês, ou em qualquer combinação de escritas latinas e CJK, o Qwen Image Max é o único modelo que lida com ambas de forma confiável, sem truques adicionais de engenharia de prompt.
💡 O Qwen Image Max não substitui todos os modelos em todas as tarefas. Para cenas puramente fotorrealistas, sem texto, modelos como Flux ou Juggernaut podem oferecer mais realismo fotográfico. Mas no momento em que seu briefing inclui texto legível dentro da imagem, o Qwen Image Max é a escolha certa.
Como usar o Qwen Image no PicassoIA
O Qwen Image Max está disponível grátis no PicassoIA. Veja o fluxo exato.
Passo 1: Abra o modelo
Acesse a página do Qwen Image no PicassoIA. Não é preciso conta para gerar suas primeiras imagens.
Passo 2: Escreva seu prompt
Estruture seu prompt com três componentes:
- A cena: descreva o ambiente físico e o clima
- Os elementos de texto: seja explícito sobre cada texto que deve aparecer, incluindo a redação exata
- Detalhes de estilo: iluminação, paleta de cores, estilo fotográfico, se for relevante
Exemplo: "Um quadro de cardápio de cafeteria em estilo vintage, montado em uma parede de tijolos, mostrando o texto 'Morning Specials' como cabeçalho, com três itens listados: 'Espresso $3', 'Cortado $4', 'Cold Brew $5', iluminação quente âmbar de cafeteria vinda da esquerda, profundidade de campo rasa"
Passo 3: Defina seus parâmetros
- Proporção: combine com o formato de saída pretendido
- Guidance: defina 3,5 ou 4 para prompts com muito texto
- Tamanho da imagem: use
optimize_for_quality, a menos que você precise de velocidade
- Steps: 50 para qualidade máxima, 28 para prévias mais rápidas
Passo 4: Revise e itere
Verifique primeiro a precisão do texto no resultado. Se alguma palavra sair incorreta, experimente:
- Tornar o elemento de texto mais explícito no prompt ("uma placa que diz exatamente: [seu texto]")
- Aumentar um pouco a guidance scale
- Colocar aspas em volta das strings de texto específicas no seu prompt
Passo 5: Exporte
Baixe em WebP, JPG ou PNG. O controle de qualidade da saída vai de 0 a 100. Para uso na web, 80 oferece um bom equilíbrio entre tamanho do arquivo e nitidez. Para mockups de impressão, defina 100.
Dicas para resultados melhores
Alguns padrões que melhoram consistentemente a qualidade do resultado em diferentes tipos de prompt.
Como escrever prompts para imagens com muito texto
Coloque as strings de texto entre aspas dentro do prompt. O modelo interpreta o texto entre aspas como strings literais a serem renderizadas, e não como linguagem descritiva a ser interpretada. Compare:
- Mais fraco: "uma placa mostrando o nome da loja e o horário de funcionamento"
- Mais forte: "uma placa com os dizeres 'OPEN DAILY 9AM TO 9PM' e, acima, o nome da loja 'Harbor Books'"
Para texto em várias linhas, descreva a hierarquia de forma explícita: cabeçalho, subcabeçalho, texto de corpo. O modelo lida melhor com a hierarquia tipográfica quando você descreve a relação entre os elementos de texto, e não apenas o conteúdo.
Como usar a guidance scale com eficácia
A guidance scale funciona como uma contrapartida entre criatividade e precisão. Para a renderização de texto especificamente:
- Guidance 2,0 a 2,5: cenas mais atmosféricas e impressionistas, em que o texto exato é menos crítico
- Guidance 3,0: resultado equilibrado, bom para trabalhos criativos gerais
- Guidance 3,5 a 4,0: precisão máxima, ideal para resultados em que o texto é crítico, como rótulos ou cartazes
Passar de 4,0 pode introduzir cores saturadas demais e resultados com aparência levemente artificial.
Quando usar imagem para imagem
O pipeline de imagem para imagem no Qwen Image é mais valioso quando:
- Você tem um esboço de composição que quer finalizar
- Você está iterando sobre um resultado gerado anteriormente
- Você quer acrescentar texto a uma cena com aparência de foto preservando o fundo
Defina a força entre 0,6 e 0,75 para a maior parte dos trabalhos de imagem para imagem. Abaixo de 0,5, o resultado fica parecido demais com a entrada. Acima de 0,85, você perde a referência estrutural que queria preservar.
A diferença de qualidade do prompt
Um padrão que aparece de forma consistente com o Qwen Image Max: prompts vagos produzem renderização de texto medíocre, e prompts específicos produzem renderização de texto excelente. Este modelo recompensa a precisão mais do que a maioria.
O motivo é arquitetural. O modelo usa sua compreensão de linguagem para mapear o texto descrito em caracteres visuais. Se o prompt é ambíguo sobre o que deve aparecer e onde, o modelo precisa fazer inferências, e essas inferências introduzem erros.
Pense em escrever prompts para o Qwen Image Max da mesma forma que você escreveria um briefing de design. Dimensões específicas, texto exato, hierarquia clara. Quanto mais precisamente você descrever o visual, mais precisamente o modelo consegue executá-lo.
💡 Para texto multilíngue, escreva o texto nos dois idiomas no prompt e especifique onde cada uma deve aparecer. O modelo lida com caracteres chineses com a mesma precisão da escrita latina, o que o torna genuinamente útil para marcas que operam nos dois idiomas.
O que criar agora
Você tem todas as informações. Veja o que fazer de fato com elas.
Comece com uma única imagem com muito texto que você vinha adiando porque o problema do texto parecia difícil demais de contornar. Um cardápio. Um cartaz. Um mockup de rótulo de produto. Um visual de slide de apresentação. Abra o Qwen Image Max no PicassoIA, escreva um prompt específico com seu texto exato entre aspas, defina a guidance em 3,5 e gere.
Se você quer ir além, experimente o modelo Qwen Image Edit Plus para editar imagens existentes com novos elementos de texto, ou o Qwen Image LoRA Trainer para construir um estilo visual consistente em todo o seu conteúdo com muito texto. Os três estão disponíveis no PicassoIA, todos grátis para testar, e todos capazes de produzir resultados que exigiriam um designer profissional há poucos anos.
A distância técnica entre o que os geradores de imagens por IA faziam com texto e o que o Qwen Image Max faz hoje é significativa. Para quem cria ativos de marca, materiais de marketing ou qualquer conteúdo visual em que as palavras da imagem realmente importam, este modelo muda o cálculo. Teste no seu próximo briefing e veja exatamente o quanto a distância diminuiu.


