Você digita uma frase. Alguns segundos depois, uma imagem fotorrealista aparece na tela, correspondendo à sua descrição com detalhes que você não esperava. Sem Photoshop, sem câmera, sem habilidades de design. Essa é a essência do GPT Image 2.0, e ele está mudando a forma como pessoas de todos os níveis de experiência criam visuais.
Seja você um freelancer que quer reduzir custos de produção, um profissional de marketing que gera mockups de produtos em minutos ou simplesmente alguém curioso sobre o que a geração de imagens por IA consegue produzir de fato, este artigo explica tudo o que você precisa saber sobre o GPT Image 2.0, sem jargões nem suposições sobre conhecimento prévio.
O que é de fato o GPT Image 2.0
O GPT Image 2.0 é o modelo de geração de imagens mais capaz já lançado pela OpenAI. Lançado como parte da família GPT-4o, ele processa descrições em linguagem natural e produz imagens de alta fidelidade, com um nível de realismo que os modelos anteriores simplesmente não conseguiam igualar.
A designação "2.0" importa. Não se trata de uma atualização menor do pipeline original do DALL-E. Ela representa uma mudança arquitetônica significativa na forma como o modelo interpreta e renderiza prompts, resultando em imagens que lidam muito melhor do que as gerações anteriores com composições de cena complexas, anatomia humana precisa, iluminação realista e detalhes finos de textura.
O modelo por trás das imagens
Em sua essência, o GPT Image 2.0 é um modelo baseado em difusão combinado com as capacidades de processamento de linguagem que alimentam o GPT-4o. Essa combinação é o que o diferencia de modelos de imagem independentes. Em vez de tratar o texto como um conjunto solto de palavras-chave, o modelo interpreta os prompts com nuances contextuais, da mesma forma que um diretor de arte humano leria um briefing criativo.
Isso significa que você pode escrever um prompt como este:
"Um escritório de detetive de film noir dos anos 1970 à meia-noite, chuva escorrendo pela janela atrás da mesa, uma única luminária de mesa lançando sombras longas sobre uma pilha de pastas de casos, fotorrealista, 8K"
E o modelo não produz algo vagamente relacionado. Ele posiciona os objetos em relações espaciais lógicas, aplica iluminação direcional correta e renderiza materiais com as texturas que esses materiais realmente têm na vida real.
Como ele se diferencia das ferramentas de IA anteriores
Os modelos de imagem por IA anteriores, incluindo o DALL-E 2 e as primeiras versões do Stable Diffusion, tinham limitações bem documentadas:
- Mãos e rostos frequentemente apareciam distorcidos ou anatomicamente incorretos
- Textos dentro das imagens eram renderizados como caracteres embaralhados ou ilegíveis
- Cenas complexas com vários objetos produziam composições caóticas e espacialmente incoerentes
- O fotorrealismo era inconsistente, caindo com frequência em um "visual de IA" evidente
O GPT Image 2.0 resolve diretamente todos esses quatro problemas. As mãos agora são renderizadas com precisão. O texto incorporado nas imagens fica legível quando solicitado. Composições com vários sujeitos seguem uma lógica espacial natural. E o fotorrealismo é convincente a ponto de você precisar olhar de perto para notar artefatos de IA.
Como a tecnologia funciona
Você não precisa de formação em ciência da computação para usar o GPT Image 2.0 com eficiência, mas ter uma ideia básica de como ele processa sua entrada muda a forma como você escreve os prompts e os resultados que obtém.
Transformando palavras em pixels
O modelo funciona por meio de um processo chamado difusão com remoção de ruído. Em termos simples, ele começa a partir de um campo de ruído visual aleatório e refina esse ruído progressivamente até formar uma imagem coerente, guiado inteiramente pelo significado extraído do seu prompt de texto.
O processo acontece em múltiplas passagens iterativas. Cada passagem aguça detalhes, corrige proporções e alinha o resultado mais de perto ao que o prompt descreveu. O que aparece como imagem final é o resultado de centenas desses microajustes acontecendo em rápida sucessão.
O GPT Image 2.0 combina esse processo de difusão com a núcleo de modelo de linguagem do GPT-4o, o que significa que ele consegue interpretar prompts longos e nuançados, ponderar diferentes elementos descritivos entre si e inferir contexto implícito que você não declarou explicitamente.
Por que a qualidade do prompt importa
O modelo é poderoso, mas não é adivinho. A qualidade do seu resultado está diretamente ligada à especificidade da sua entrada.
| Prompt vago | Prompt específico | Resultado |
|---|
| "Uma mulher em uma mesa" | "Uma mulher de cabelo escuro em uma mesa de carvalho iluminada pelo sol, luz do fim da tarde vinda da esquerda, lente de 85mm, profundidade de campo rasa" | Composição específica e intencional |
| "Uma foto de produto" | "Um frasco de perfume sobre mármore branco, luz principal única vinda de cima à esquerda, gotas de condensação no vidro, lente macro de 100mm" | Qualidade comercial profissional |
| "Uma cidade à noite" | "Uma rua lateral de Tóquio na chuva, reflexos de neon no asfalto molhado, granulação de filme de 35mm, ângulo baixo, um pedestre em contraluz" | Imagem cinematográfica e dirigida |
💡 Regra prática: Se você diria isso a um fotógrafo ou cenógrafo em uma filmagem, coloque no seu prompt. Direção da luz, ângulo da câmera, textura de superfície, condições atmosféricas, tudo isso molda o resultado.
O que você pode criar
O alcance do que o GPT Image 2.0 consegue produzir é mais amplo do que a maioria dos iniciantes espera nas primeiras tentativas.
Retratos e cenas realistas
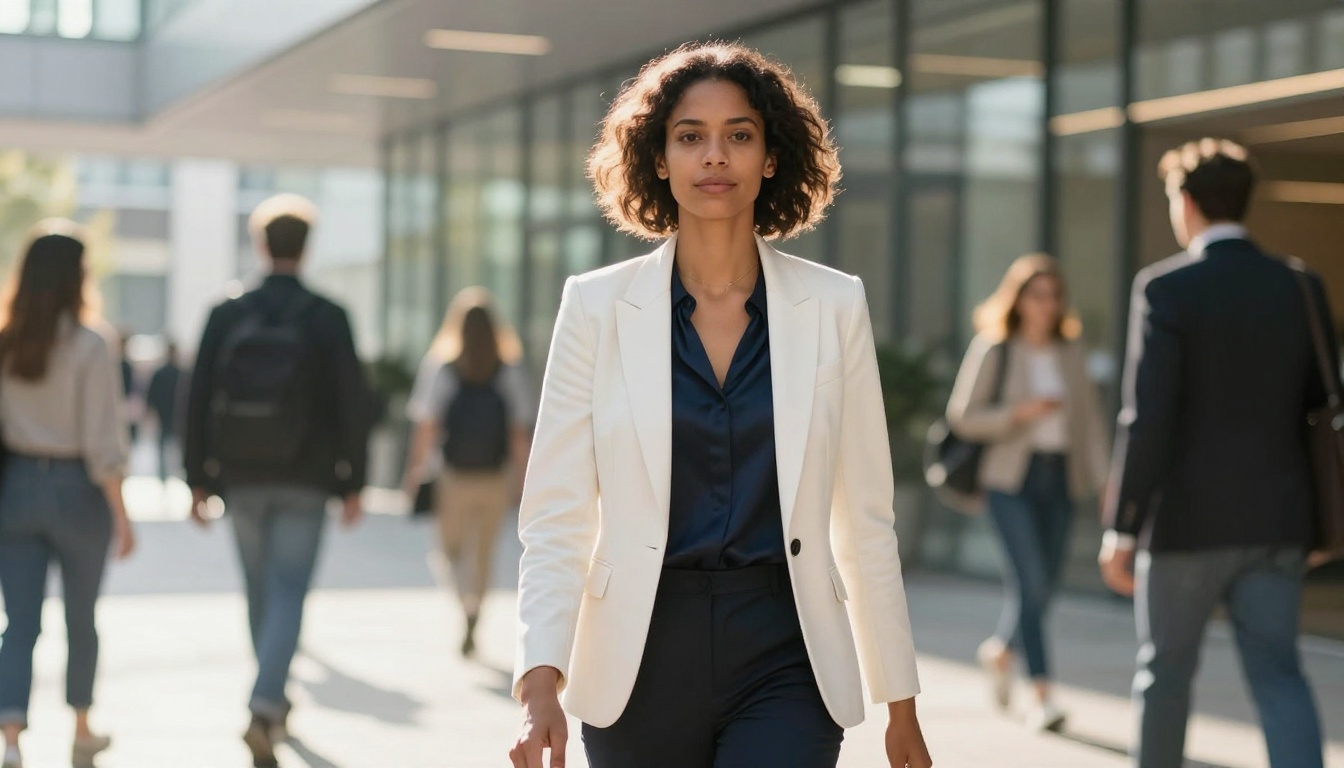
A fotografia de retrato é uma das capacidades mais fortes do modelo. Você pode gerar:
- Retratos de estilo de vida para cabeçalhos de blog, conteúdo para redes sociais e publicações editoriais
- Retratos profissionais de rosto e ombros em cenários específicos, com iluminação precisamente controlada
- Imagens com elenco diverso mostrando várias pessoas em interação natural
- Retratos ambientais que colocam o sujeito em um contexto rico em detalhes
A diferença entre um prompt de retrato fraco e um forte quase sempre está na especificação da iluminação e na escolha da lente. "Uma mulher sorrindo" produz algo genérico. "Uma mulher rindo naturalmente, momento espontâneo, luz da tarde filtrada por folhas, 85mm f/1.8" produz algo com caráter fotográfico real.
Mockups de produtos e fotos comerciais
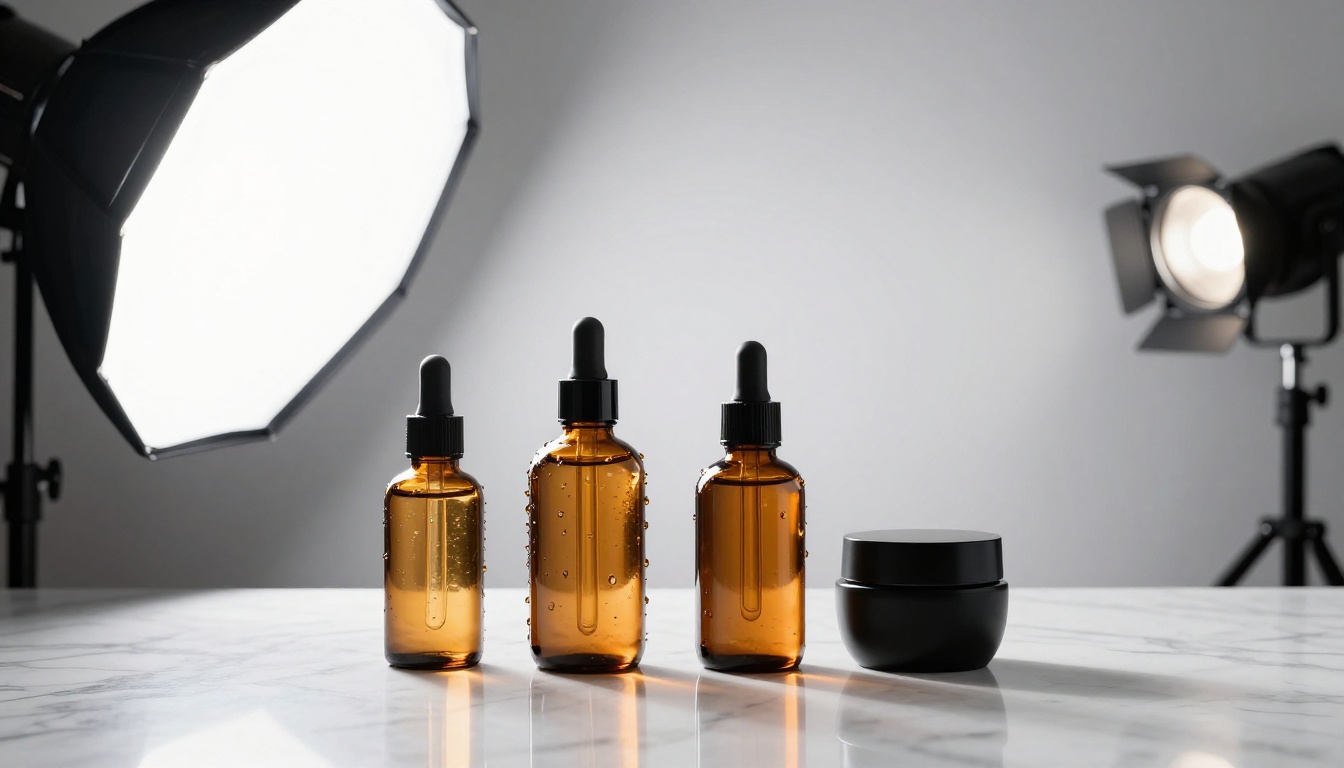
A fotografia de produto é um dos casos de uso de maior valor do GPT Image 2.0. Gerar uma foto de produto com qualidade comercial normalmente exige um estúdio, equipamento, um fotógrafo e tempo de pós-produção. Com um prompt bem escrito, você consegue o mesmo resultado em menos de um minuto.
O modelo lida com:
- Superfícies de vidro e reflexivas com comportamento realista da luz e reflexos precisos
- Separação entre sombra e realce que parece natural, não artificial
- Diferenciação de materiais entre tecido, metal, cerâmica e superfícies orgânicas
- Cenografia de fundo, de fundos brancos infinitos a ambientes de estilo de vida com textura
Para vendedores de e-commerce, profissionais de marketing em redes sociais e designers de marca, isso representa uma redução de custos substancial, sem uma perda visível de qualidade.
Ideias abstratas tornadas visíveis
Alguns dos resultados mais impressionantes do GPT Image 2.0 vêm de prompts que descrevem conceitos em vez de objetos literais. Você pode descrever uma emoção, uma metáfora, uma composição simbólica ou um clima atmosférico específico, e o modelo constrói um visual que o representa de forma coerente.
Isso o torna genuinamente útil para ilustração editorial, visualização de conceitos e direção criativa, em que o objetivo é uma imagem evocativa, e não um registro fotográfico literal.
GPT Image 2.0 ou outras ferramentas de imagem
Onde o GPT Image 2.0 se posiciona em relação a outros modelos de geração de imagens por IA? Aqui está uma comparação lado a lado e honesta.
| Modelo | Fotorrealismo | Profundidade do prompt | Texto nas imagens | Velocidade | Melhor uso |
|---|
| GPT Image 2.0 | Excelente | Excelente | Bom | Moderada | Cenas realistas, retratos |
| Flux Redux Dev | Muito bom | Muito bom | Razoável | Rápida | Resultados criativos e estilizados |
| Stable Diffusion XL | Bom | Bom | Fraco | Rápida | Fine-tuning personalizado |
| DALL-E 3 | Bom | Muito bom | Bom | Moderada | Uso geral |
| Juggernaut XL | Muito bom | Bom | Fraco | Rápida | Retratos fotorrealistas |
💡 Nenhum modelo vence em tudo. O GPT Image 2.0 se destaca em composições de cena complexas e realistas, com anatomia precisa. Modelos como o Flux Redux Dev são mais rápidos e produzem resultados estilizados marcantes. Saber qual ferramenta serve para cada tarefa é a habilidade que realmente importa.
Quando cada ferramenta vence
Use o GPT Image 2.0 quando:
- Você precisa de resultados fotorrealistas a partir de prompts complexos e detalhados
- Anatomia humana precisa importa: rostos, mãos, proporções do corpo
- Seu prompt envolve vários sujeitos ou objetos interagindo entre si
- Você quer texto legível incorporado na imagem
Use o Flux Redux Dev ou outros modelos rápidos quando:
- A velocidade importa mais do que o realismo extremo
- Você quer resultados estilizados, artísticos ou experimentais
- Você está iterando rapidamente por muitas variações de prompt
Como escrever prompts que funcionam
A maioria dos iniciantes escreve prompts curtos e vagos e depois culpa o modelo quando os resultados decepcionam. O modelo está fazendo exatamente o que foi pedido: interpretando uma descrição vaga e preenchendo as lacunas por conta própria. Se você não gosta do que ele preenche, preencha você mesmo.
A anatomia de um bom prompt
Um prompt bem estruturado para o GPT Image 2.0 cobre cinco elementos:
- Sujeito: quem ou o que é o ponto focal, com detalhes descritivos específicos, incluindo características físicas
- Ambiente: onde isso está acontecendo e como é o cenário, com detalhes concretos
- Iluminação: direção, qualidade (dura ou suave), temperatura de cor e tipo de fonte de luz
- Câmera: distância focal da lente, abertura, ângulo de visão, distância de disparo
- Atmosfera: granulação de filme, gradação de cor, humor, qualidade da textura dos materiais
Você não precisa dos cinco em todo prompt. Mas incluir mais deles deixa menos espaço para o modelo fazer escolhas que você não pretendia.
3 erros que os iniciantes sempre cometem
Erro 1: prompts curtos demais
Escrever "uma foto de pôr do sol" e esperar uma capa de revista. Acrescente ambiente, qualidade da luz, interesse no primeiro plano e uma especificação de câmera. Cada detalhe que você adiciona é uma escolha criativa que você faz, em vez de deixá-la ao acaso.
Erro 2: instruções contraditórias
Pedir "foto natural e espontânea, iluminação de estúdio profissional". Esses dois descritores puxam em direções opostas. Escolha uma direção visual e construa o restante do prompt em torno dela.
Erro 3: nenhuma especificação de câmera ou lente
A distância focal muda tudo na composição e na emoção. Uma lente grande angular de 24mm produz uma sensação completamente diferente de uma lente de retrato de 85mm com o mesmo sujeito. Declare a distância focal que você quer.
Como usar o GPT Image 2.0 no PicassoIA
O GPT Image 2 está disponível diretamente no PicassoIA, sem necessidade de assinatura de API, código ou qualquer configuração técnica.
Passo a passo
Passo 1: abra a página do modelo
Acesse a página do modelo GPT Image 2 no PicassoIA. Tudo roda no navegador, sem nenhuma instalação.
Passo 2: escreva seu prompt
No campo de prompt, digite a descrição da imagem seguindo a estrutura de cinco elementos acima. Seja específico sobre sujeito, ambiente, iluminação e câmera. Quanto mais detalhes você fornecer, mais controle terá sobre o resultado.
Passo 3: defina a proporção
Para a maioria dos usos em redes sociais e blogs, 16:9 funciona bem. O quadrado (1:1) combina com posts do Instagram e imagens de perfil. O vertical (9:16) é ideal para stories e conteúdo pensado primeiro para o celular.
Passo 4: execute a geração
Clique em gerar. O modelo normalmente produz resultados em 15 a 30 segundos, dependendo da complexidade do prompt e da carga do servidor.
Passo 5: avalie e itere
Se o primeiro resultado estiver próximo, mas não exatamente certo, refine um elemento específico do prompt em vez de reescrever tudo do zero. Isole a variável que você quer mudar e ajuste somente ela.
Configurações que mudam tudo
💡 Prompt Upsampling: a interface do PicassoIA inclui uma opção de enriquecimento de prompt que expande automaticamente prompts curtos e acrescenta detalhes antes de enviá-los ao modelo. Para iniciantes que ainda estão desenvolvendo o hábito de escrever prompts, vale a pena ativá-la como ponto de partida.
A configuração de proporção costuma ser negligenciada. Um quadro de 16:9 força uma composição horizontal larga no modelo. Um quadro quadrado de 1:1 força um arranjo centralizado e equilibrado. Essas não são apenas dimensões, são restrições de composição que moldam a forma como o modelo constrói a cena inteira.
Além da geração básica de imagens
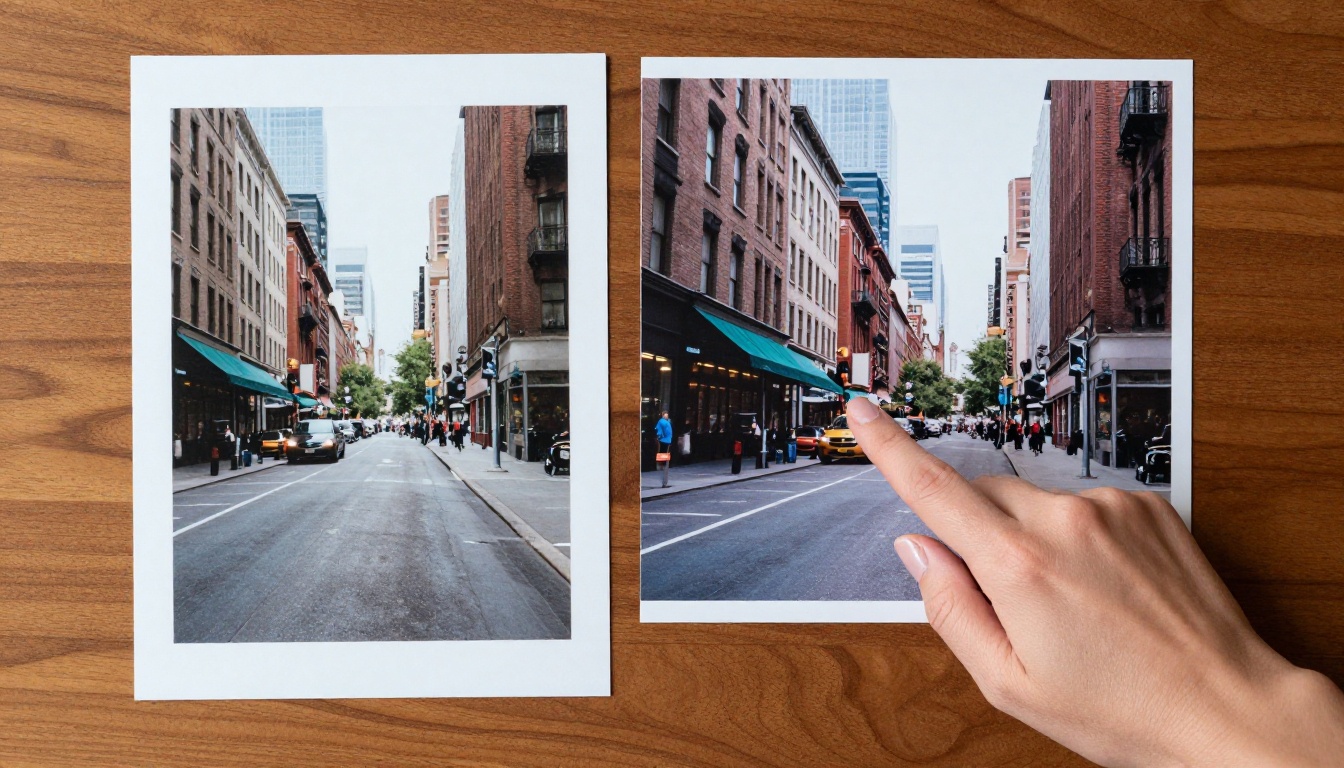
Quando você estiver confortável com o fluxo de trabalho básico de geração, as possibilidades criativas reais se abrem ao combinar o GPT Image 2.0 com outras ferramentas da plataforma.
Variações e edição
O PicassoIA oferece várias ferramentas que funcionam em combinação com os resultados da geração de imagens:
- Super Resolution: pegue uma imagem gerada e aumente sua resolução em 2x ou 4x para resultados prontos para impressão. Ideal quando uma imagem web de 1024px precisa virar um arquivo de alta resolução para impressão.
- Inpainting (substituição de objetos): gere uma imagem base e use a ferramenta de inpainting para substituir ou modificar regiões específicas sem regenerar toda a composição. Troque um fundo, substitua um objeto ou preencha um detalhe.
- Restauração de imagem por IA: corrija ruído, desfoque ou artefatos de compressão em qualquer imagem, seja ela gerada ou de origem fotográfica.
Combinando com outras ferramentas de IA
Os resultados do GPT Image 2.0 se conectam naturalmente com outros recursos da plataforma. Um retrato gerado pode alimentar diretamente um fluxo de troca de rosto por IA para personalização. Uma imagem de produto pode ter a resolução aumentada com o Super Resolution para materiais impressos. Uma cena pode ser estendida com o Outpainting para ampliar a tela em qualquer direção sem começar do zero.
Essa combinação de ferramentas cria um pipeline completo de produção visual que antes exigia software de design dedicado, hardware especializado e operadores treinados.
Comece a criar suas próprias imagens hoje
O GPT Image 2.0 não é uma ferramenta reservada a designers profissionais ou usuários técnicos. Ele é genuinamente acessível a qualquer pessoa disposta a gastar alguns minutos escrevendo um prompt claro e específico.
A melhor forma de ver o que ele consegue fazer é testar diretamente. Abra o GPT Image 2 no PicassoIA, escreva um prompt descrevendo algo que você realmente quer ver e execute. Observe o que o modelo produz. Ajuste um elemento. Execute de novo.
A distância entre "digitei algo e obtive uma imagem medíocre" e "criei algo de que me orgulho de verdade" está quase inteiramente na forma como o prompt é escrito. E essa distância diminui rapidamente com a prática.
O PicassoIA oferece acesso ao GPT Image 2 junto com dezenas de outros modelos de geração de imagens, tudo na mesma interface, para que você possa comparar resultados e escolher a ferramenta certa para cada projeto. Escreva seu primeiro prompt hoje e veja o que você consegue criar.


