ثعلب كرتوني ينظر إلى الكاميرا، يميل برأسه، ويقول نصّك بصوت يبدو وكأن استوديو اختاره بعناية. قبل عامين كان ذلك يتطلب رسامًا متحركًا وممثلًا صوتيًا وأسبوعًا كاملًا من المونتاج. اليوم يمكن لـ مولّد الكرتون بالذكاء الاصطناعي مع الصوت أن ينجز المهمة في مساء واحد، وبعض أجزائه مجاني للتجربة. لكن عبارة "مولّد الكرتون مع الصوت" ليست أداة واحدة، بل سلسلة من ثلاث مهام: رسم الشخصية، وإنتاج الصوت، وجعل الفم يطابق الصوت. وإذا ضعف أحد هذه الروابط، بدا المقطع كله غير مقنع.
يستعرض هذا المقال السلسلة حلقةً حلقة. ستتعرف على ما تحتاجه كل خطوة، وأي النماذج على PicassoIA تتولاها، وأين تكون الأدوات المجانية مفيدة، وما الأخطاء التي تجعل الشخصيات المتحدثة تبدو مخيفة بدلًا من أن تكون ساحرة.
ما الذي يفعله مولّد الصوت للشخصيات الكرتونية بالذكاء الاصطناعي
تخلط نتائج البحث عن هذه الكلمة المفتاحية بين عدة منتجات مختلفة. بعضها تطبيقات تحوّل صورة فوتوغرافية إلى بورتريه كرتوني، وبعضها أدوات لتحويل النص إلى كلام تضع في صفحتها الرئيسية شخصية كرتونية تمثل العلامة. أما ما يريده معظم الناس فعلًا فأبسط من ذلك: اكتب نصًا، فتحصل على شخصية تنطقه على الشاشة.
ثلاث مهام في مسار واحد
يمرّ كل فيديو كرتوني ناطق، بغض النظر عن التطبيق الذي أنشأه، عبر المراحل نفسها:
- الشخصية: صورة ثابتة أو مقطع متحرك قصير للشخصية.
- الصوت: مسار صوتي، إما مولّد من النص أو مسجّل بصوت شخص.
- مزامنة الشفاه: نموذج يحرّك فم الشخصية وفكها وأحيانًا الوجه كله ليطابق كل صوت.
تخفي التطبيقات الشاملة هذه المراحل خلف زر واحد. وهذا مريح، لكنه يحصرك في مكتبة صوتية واحدة وأسلوب تحريك واحد. أما العمل مرحلة بمرحلة فيتطلب بضع نقرات إضافية، لكنه يمنحك تحكمًا أكبر بكثير.
من يستخدم هذه الأداة فعلًا
الجمهور أوسع من الهواة. يصنع المعلمون مقاطع توضيحية قصيرة بمساعد ودود. وتسجّل المتاجر الصغيرة فيديوهات ترويجية دون تصوير شخص. ويصنع الآباء قصصًا قبل النوم تكون بطلتها رسمة طفلهم. ويدير صنّاع المحتوى على YouTube قنوات بلا وجه ظاهر، بشخصية متكررة. ويجرّب مطورو الألعاب المستقلة الحوارات قبل التعاقد مع ممثلين.
💡 نصيحة: قرر إن كانت شخصيتك ستتحدث مرة واحدة (تحية أو إعلان) أم مرات كثيرة (سلسلة). يمكن للمرة الواحدة أن تعتمد على أي أداة سريعة. أما السلسلة فتحتاج إلى تصميم ثابت وصوت ثابت، أي تخطيطًا أكثر منذ البداية.
اللبنات الأساسية الأربع
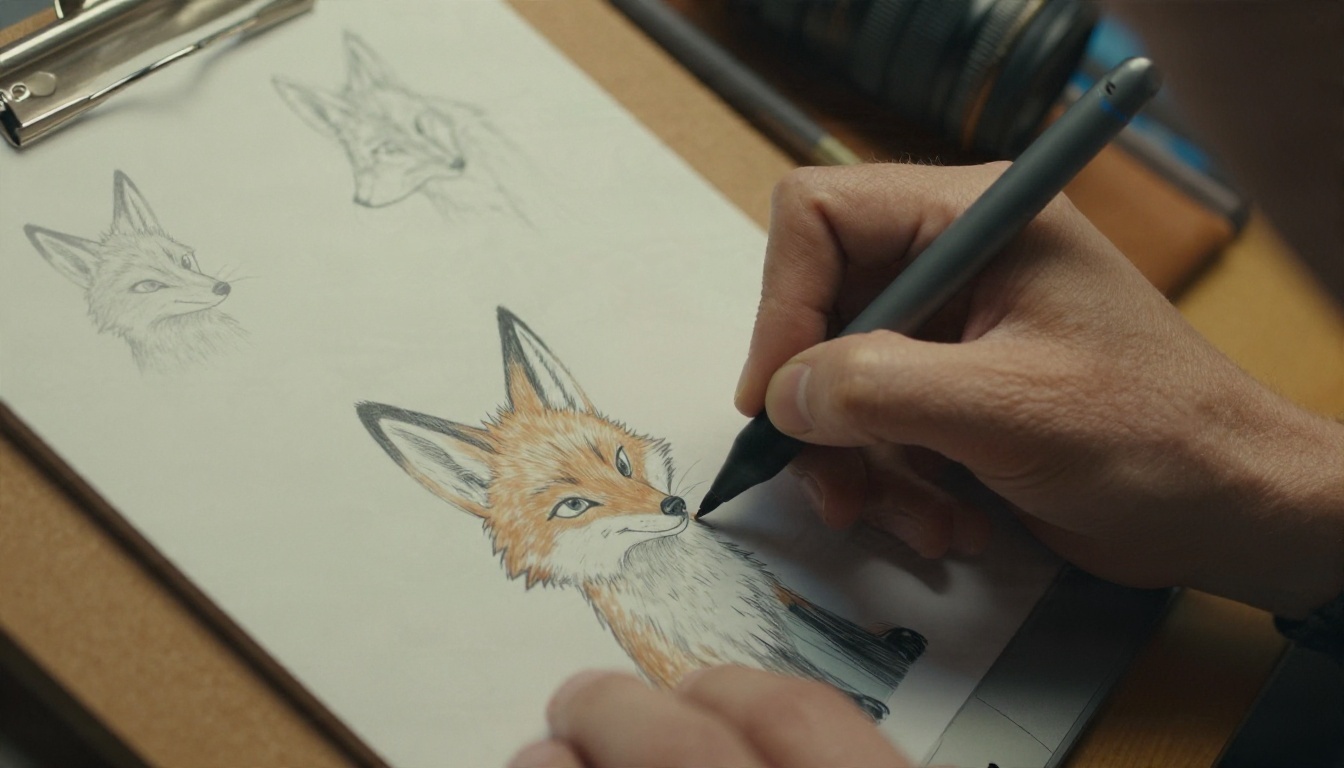
صورة الشخصية
كل شيء يبدأ بصورة واضحة من الأمام. تحتاج نماذج مزامنة الشفاه إلى رؤية الفم. أما الشخصية التي تغطي يدها وجهها، أو ترتدي قناعًا، أو تظهر من الجانب، فلا تمنح النموذج تقريبًا ما يعمل عليه.
أما العمل الفني نفسه، فيناسب نموذج تحويل النص إلى صورة مثل Seedream 4.5 الشخصيات المنمّطة، ويكون Seedream 5 Pro خيارًا جيدًا عندما تريد تفاصيل أدق. صِف التصميم بلغة بسيطة: النوع أو الفصيلة، والملابس، ولوحة الألوان، وأسلوب الرسم، والتعبير. واطلب فمًا محايدًا مفتوحًا قليلًا، ليكون لدى التحريك اللاحق شكل بداية طبيعي.
مسار الصوت
يحمل الصوت نصف الشخصية على الأقل. فالمساعد الصغير ذو الصوت الحاد، والقرصان الخشن، والراوي الهادئ قد يشتركون في أسلوب الرسم نفسه، ومع ذلك يبدون شخصيات مختلفة تمامًا بسبب الطبقة الصوتية والوتيرة والإيقاع.
لديك طريقان: توليد الصوت من النص، أو تسجيل صوتك. يشرح القسم التالي الطريقين.
طبقة مزامنة الشفاه
هذه الخطوة هي التي تجعل الشخصية تبدو حية. يقرأ نموذج مزامنة الشفاه الصوت، ويرصد الفونيمات، ويحرّك الفم ليطابقها. بعض النماذج تبدأ من صورة واحدة أو رسم واحد. وبعضها يأخذ فيديو موجودًا ويعيد ضبط حركة الفم على صوت جديد.
الحركة والكاميرا
الفم الذي يتحرك داخل جسم متجمد يبدو كدمية. وتضيف النتائج الأفضل ميلانات صغيرة للرأس، ورمشات، وحركة للكتفين، ودفعة بطيئة للكاميرا. ويمكن لنماذج الفيديو مثل Kling v3 Video أن تحرّك المشهد أولًا، ثم يمكن تطبيق نموذج مزامنة الشفاه فوق المقطع المتحرك.
اختيار صوت يناسب الشخصية
خيارات تحويل النص إلى كلام
إذا كنت لا تريد تسجيل أي شيء، فالأصوات المولّدة هي الطريق الأسرع. وفيما يلي بعض ما يناسب أعمال الشخصيات:
اكتب النص كما يتحدث الناس، لا كما يكتبون. جمل قصيرة. صيغ مختصرة. وقفة تُشار إليها بفاصلة أو نقطة. تتبع الأصوات المولّدة علامات الترقيم بدقة، لذلك تبدو جملة مثل "Wait. You did what?" مختلفة تمامًا عن "Wait you did what".
تسجيل صوتك الخاص
يمنحك التسجيل الحقيقي شيئًا نادرًا ما يضاهيه الصوت المولّد: توقيتًا يبدو بشريًا. لا تحتاج إلى استوديو. يكفيك ميكروفون USB، وخزانة مليئة بالملابس لتخفيف الصدى، وساعة هادئة.
أدِّ الجملة بوجهك. ابتسم حين تبتسم الشخصية. يفعل الممثلون الصوتيون ذلك لسبب: الانفعال يظهر في الصوت حتى حين لا يراك أحد.
إذا أردت صوتًا للشخصية لا يشبه نبرتك الطبيعية، فسجّل بشكل عادي ثم غيّر الطبقة الصوتية. أو سجّل صوتك الحقيقي ودع أداة كلام تعيد تمثيله بصوت آخر. اجعل الصوت النهائي نظيفًا دون موسيقى في الخلفية، لأن نماذج مزامنة الشفاه قد تخلط بين الصوت الخلفي والكلام.
مقارنة نماذج مزامنة الشفاه
تضم فئة مزامنة الشفاه على PicassoIA اثني عشر نموذجًا، وتنقسم إلى مجموعتين. تأخذ نماذج الصورة إلى فيديو ناطق صورة واحدة وملف صوت واحدًا. أما نماذج الفيديو إلى فيديو فتأخذ مقطعًا موجودًا وتصلح الفم ليطابق صوتًا جديدًا.
أيها تختار؟
توجد قاعدة بسيطة تنفع في معظم المشاريع:
- رسم واحد، وسطر صوتي واحد: ابدأ بنموذج Fabric 1.0. فهو أقصر طريق من الصورة إلى فيديو ناطق.
- شخصية تحتاج إلى حركة أكثر طبيعية للرأس والجسم: جرّب Omni Human 1.5.
- مشهد متحرك جرى تصييره بالفعل بنموذج فيديو: استخدم Kling Lip Sync أو Lipsync 2 Pro حتى يُصلَح الفم بعد أن تكتمل الحركة.
- المقطع نفسه بعدة لغات: مرّره عبر Video Translate ودع النموذج يعيد ضبط الفم لكل لغة.
💡 نصيحة: دُرّبت نماذج مزامنة الشفاه المعتمدة على الصور في معظمها على وجوه بشرية. تنجح الشخصيات المنمّطة ذات العيون الكبيرة والأفواه الصغيرة عادةً، لكن التصميم التجريدي جدًا الذي لا يحتوي فمًا واضحًا قد يفشل. شغّل اختبارًا مدته ثانيتان قبل أن تبني حلقة كاملة على تصميم ما.
كيفية استخدام Fabric 1.0 على PicassoIA
يُعد Fabric 1.0 أسهل مكان للبدء، لأن مدخلاته صورة وملف صوت فقط. ويصف صفحته النموذج بأنه متاح للتجربة مجانًا عبر الإنترنت دون الحاجة إلى البرمجة.
خطوة بخطوة
- افتح صفحة النموذج. اذهب إلى صفحة Fabric 1.0 على PicassoIA وابحث عن نموذج الإدخال.
- ارفع شخصيتك. استخدم صورة واضحة من الأمام يظهر فيها الفم. يعمل الاقتطاع المربع أو الأفقي الذي يكون فيه الوجه في الثلث الأوسط بأفضل شكل.
- أضف الصوت. ارفع تسجيلًا، أو ولّد الكلام أولًا بنموذج تحويل نص إلى كلام مثل Gemini 3.1 Flash TTS واستخدم هذا الملف.
- اختر الدقة. اختر 480p للمسودات السريعة، و720p للنسخة التي تنوي نشرها.
- شغّله وراجع. شاهد النتيجة مع تشغيل الصوت. تأكد من أن الفم ينفتح على المقاطع الصوتية العالية ويُغلق على المقاطع الهادئة.
الإعدادات المهمة
يُبقي Fabric 1.0 عناصر التحكم فيه بسيطة: الصورة والصوت والدقة. وهذا يعني أن الجودة التي تحصل عليها تعتمد تقريبًا كليًا على ما تغذّيه به.
| المدخل | ما الذي يجب فعله | ما الذي يجب تجنبه |
|---|
| الصورة | تعبير محايد، والفم مغلق قليلًا، وحواف حادة | ظلال كثيفة فوق الفم، أو أيدٍ أمام الوجه |
| الصوت | صوت نظيف، دون موسيقى، وبمستوى ثابت | الصدى، وأصوات الخلفية، وقمم الصوت المقطوعة |
| المدة | جمل قصيرة من 5 إلى 15 ثانية للاختبار الأول | دقيقة كاملة قبل أن تعرف إن كان المقطع ينجح |
| الدقة | 480p أثناء التجربة، و720p للنسخة النهائية | تصيير كل مسودة بأعلى إعداد |
بعد أن تحصل على مقطع ناطق يعجبك، يمكنك وضعه داخل فيديو أطول، أو إضافة موسيقى بنموذج توليد الموسيقى بالذكاء الاصطناعي، أو تشغيل عدة جمل متتالية لبناء مشهد.
الأدوات المجانية وحدودها
ماذا تعني كلمة "مجاني" عادةً
تتبع كل أداة "كرتون بالذكاء الاصطناعي مع الصوت مجاني" تقريبًا النمط نفسه: يمكنك تجربتها، لكن هناك شيء مقيّد. تشمل القيود الشائعة علامة مائية، أو حدًا لبضع ثوانٍ في كل مقطع، أو عددًا قليلًا من الأصوات، أو حدًا يوميًا للنقاط، أو تصديرًا بدقة منخفضة. لا يشكّل أي من ذلك مشكلة في التجربة، لكنه يصبح مشكلة حين يقترب الموعد النهائي.
بعض الفحوص العملية قبل أن تستثمر وقتك في أي أداة مجانية:
- هل يحتوي التصدير على علامة مائية؟ العلامة المائية مقبولة في المسودة، وعديمة الفائدة أمام عميل.
- هل يمكنك رفع صوتك الخاص؟ الأدوات التي تسمح فقط بأصواتها المدمجة تحدّ من خيارات شخصيتك.
- هل الاستخدام التجاري مسموح؟ اقرأ الشروط قبل نشر قناة تحقق أرباحًا.
- هل يمكنك إحضار شخصيتك الخاصة؟ الأدوات التي تفرض شخصيات من مكتبتها تجعل بناء هوية لسلسلة أمرًا صعبًا.
أين تنفق النقاط
إذا أردت أن تكون مجانيًا ومرنًا في الوقت نفسه، فوزّع العمل. استخدم نماذج سريعة ومنخفضة التكلفة للمسودات، وادّخر جهدك للتصيير النهائي. من جهة الفيديو، يُعرض Seedance 2.5 Lite بوصفه مولّد فيديو مجانيًا وغير محدود للمقاطع التي تصل مدتها إلى 10 ثوانٍ، ما يجعله ساحة تجربة مريحة لاختبار حركة الشخصية. وأما المقاطع التي يُولَّد فيها الصوت مع الصورة معًا، فينتج Veo 3.1 Lite فيديوًا بصوت أصلي، بحيث تستطيع الشخصية أن تتكلم داخل المشهد دون خطوة مزامنة شفاه منفصلة.
💡 نصيحة: أعدّ المسودة بأدنى دقة، ووافق على النص والصوت، ثم شغّل التمريرة النهائية بدقة 720p. معظم النقاط المهدورة تأتي من إعادة تصيير مقطع لم يُنهَ نصه بعد.
أخطاء تفسد الشخصيات المتحدثة
تشترك معظم المقاطع الفاشلة في مجموعة صغيرة من المشكلات. أصلحها، وستتحسن نتائجك أكثر مما يحسّنها أي ترقية للنموذج.
تجاهل فحص الصوت
استمع إلى مسار الصوت وحده، وأغمض عينيك، قبل أن تحرّك أي شيء. إذا بدت الجملة باهتة، فلن ينقذها أي تحريك. يزداد القطع والهسهسة وصدى الغرفة سوءًا حين يحاول النموذج قراءة الفونيمات منها.
شخصية بلا مساحة للوجه
الشخصيات المرسومة صغيرة جدًا داخل الإطار تترك للفم بضعة بكسلات فقط في العرض. عندئذ لا يجد نموذج مزامنة الشفاه تقريبًا ما يحركه. اقتطع الصورة بحيث يملأ الوجه جزءًا واسعًا من الكادر.
طاقة لا تتناسب مع الشخصية
سنجاب كرتوني شديد الحيوية يقرأ بصوت سردي بطيء ونعسان يبدو خاطئًا فورًا. طابق طاقة الصوت مع التصميم. التصاميم المرحة تحتاج إلى طبقة صوتية صاعدة وإيقاع سريع، والتصاميم الخشنة تحتاج إلى أداء أخفض وأبطأ.
المحاولات الأولى الطويلة
يلصق المستخدمون الجدد كثيرًا نصًا من دقيقتين في التمريرة الأولى. قطّعه إلى أسطر قصيرة، واختبر كل سطر، ثم اجمع المقاطع. من الأسرع أن تصلح لقطة واحدة سيئة مدتها خمس ثوانٍ من أن تصلح مشهدًا كاملًا فاشلًا.
تجاهل تنسيق النص
اكتب للأذن. اقرأ كل سطر بصوت مسموع. إذا نفد نَفَسك أو تعثّرت، سيفعل الصوت المولّد الشيء نفسه.
تمنع شبكة بسيطة للوحة القصصية في دفتر، بمربع واحد لكل سطر حوار، معظم هذه المشكلات. تُرى الإيقاعات قبل أن تنفق نقطة واحدة.
استخدامات حقيقية للشخصيات المتحدثة
قصص العائلة ومحتوى الأطفال
يستجيب الأطفال بقوة لشخصية تنظر إليهم وتتحدث معهم مباشرة. يحوّل الآباء رسم طفلهم إلى راوٍ لقصة قبل النوم، أو يبنون سلسلة قصيرة بصديق حيواني متكرر. اجعل المقاطع قصيرة، والصوت دافئًا، وراجع كل مقطع قبل أن يشاهده طفل.
الصفوف الدراسية والتدريب
يمكن لمقدّم كرتوني ناطق أن يبدأ درسًا، أو يقرأ قائمة مفردات، أو يشرح قاعدة سلامة. ولأن الصوت منفصل عن الرسوم المتحركة، يستطيع المعلم تبديل النص وإعادة تصيير الشخصية نفسها خلال دقائق. ومع نموذج ترجمة، يصبح الدرس نفسه متاحًا بلغات أخرى. يعيد Video Translate ضبط الفم لكل لغة كي لا تبدو الدبلجة ملصقة، ويقدّم ElevenLabs Dubbing ترجمة الفيديو إلى أكثر من 90 لغة.
المتاجر والعلامات الصغيرة
يمكن لمخبز أو ورشة صيانة دراجات أو طبيب أسنان أن يصنع مقدّمًا مرة واحدة، ثم يعيد استخدامه في كل حملة ترويجية. تتحول العروض الموسمية وساعات العمل وتهاني الأعياد إلى نص جديد وتصيير جديد، دون كاميرا ودون حجز ممثل. كما تمنح الشخصية المميزة العلامة الصغيرة وجهًا يتذكره الناس.
القنوات بلا وجه والألعاب
يستخدم صنّاع المحتوى الذين لا يريدون الظهور أمام الكاميرا شخصية بوصفها المقدّم. ويستخدم مطورو الألعاب شخصيات نائبة ناطقة لاختبار تدفق الحوار قبل تسجيل الأصوات النهائية. وفي الحالتين، يجعل التصميم الثابت والصوت الثابت الجمهور يرتبط بالشخصية.
سير عمل بسيط يمكنك تكراره
هذا روتين يحافظ على الجودة مع إبقاء النقاط منخفضة:
- اكتب النص في أسطر قصيرة، واقرأه بصوت عالٍ، واحذف كل ما يجعلك تتعثر.
- ولّد الشخصية بنموذج تحويل نص إلى صورة، ثم اختر النسخة ذات الوجه الأوضح.
- أنشئ الصوت بتحويل النص إلى كلام، أو سجّله بنفسك في غرفة هادئة.
- اختبر سطرًا واحدًا بنموذج صورة إلى فيديو ناطق مثل Fabric 1.0 بدقة 480p.
- أصلح أضعف حلقة: الصوت أو الاقتطاع أو النص. ثم أعد الاختبار.
- صيّر المقاطع النهائية بدقة 720p، واجمعها في محرّرك.
- أضف موسيقى وترجمات حتى يعمل الفيديو دون صوت، وهذه هي الطريقة التي يشاهد بها كثيرون المحتوى على وسائل التواصل الاجتماعي.
غالبًا ما تحتاج هذه الحلقة إلى محاولات عدة قبل أن تصيب من المرة الأولى. وبعدها تصبح الحلقة الجديدة في الغالب نصًا جديدًا.
أنشئ أول شخصية متحدثة لك
أسرع طريقة لفهم كل ما سبق هي صنع مقطع واحد. اختر فكرة لشخصية، واكتب ثلاثة أسطر قصيرة، ومرّرها عبر السلسلة. لا تحتاج إلى ميزانية كبيرة ولا إلى مهارات في الرسوم المتحركة، بل إلى وجه واضح وصوت لديه ما يقوله.
افتح Fabric 1.0 على PicassoIA، وارفع صورة شخصية ومقطع صوتيًا قصيرًا، وشاهد الفم يتحرك على كلماتك. ثم جرّب صوتًا مختلفًا، أو تصميمًا آخر، أو مشهدًا متحركًا كاملًا باستخدام Kling Lip Sync. كل نموذج ورد ذكره هنا على بعد نقرة واحدة في picassoia.com/en/all-models، فيمكنك المزج بينها حتى تبدو شخصيتك كما ينبغي أن تبدو.


