حققت OpenAI خطوة مهمة إلى الأمام في توليد الصور. يبني GPT Image 2.0 على كل ما جعل سلفه جذابًا، ويعالج الثغرات التي تركت المبدعين يطمحون إلى المزيد. سواء كنت مطورًا تدمجه في التطبيقات، أو مصمّمًا يستخدمه في النماذج الأولية للتصميم، أو مجرد فضولي بشأن وضع الصور بالذكاء الاصطناعي اليوم، تغطي هذه النظرة الأولى ما يهم فعلًا.
ما هو GPT Image 2.0
ليس مجرد تحديث تدريجي آخر
GPT Image 2.0 هو نموذج OpenAI المخصص لتوليد الصور من الجيل الثاني، ويعمل بشكل أصيل ضمن البنية التحتية نفسها لعائلة GPT-4o الأوسع. وعلى عكس نماذج DALL-E التي سبقته، صُمّم GPT Image 2.0 ليكون متعدد الوسائط منذ البداية. فهو يقرأ الصور كمدخلات، ويولّدها كمخرجات، ويعالج طلبات التعديل كجزء من محادثة موحدة واحدة، لا كمهام منفصلة.
كان الجيل الأول تحسينًا ملحوظًا على DALL-E 3 من حيث دقة تنفيذ الأوامر والواقعية الفوتوغرافية. ويعزز GPT Image 2.0 تلك المكاسب بشكل كبير، مع تحسينات خاصة في تصيير النصوص، والدقة في تكوين المشهد، ودعم التعديل المدمج.
موقعه ضمن منظومة OpenAI
| النموذج | الأفضل لاستخدام | القيد الرئيسي |
|---|
| DALL-E 2 | المفاهيم الفنية الأساسية | واقعية فوتوغرافية منخفضة |
| DALL-E 3 | الرسوم التوضيحية ذات الأسلوب المحدد | نصوص ضعيفة داخل الصور |
| GPT Image 1.0 | الأوامر الواقعية الفوتوغرافية | تعديل محدود |
| GPT Image 2.0 | صور عالية الدقة وقابلة للتعديل | تكلفة أعلى لكل صورة |
أصبح GPT Image 2.0 الآن الخيار الافتراضي لأي شخص يبني سير عمل للصور في تطبيقات الإنتاج عبر OpenAI API، ليحل محل DALL-E 3 في معظم مسارات المعالجة الجدية. والقفزة في جودة المخرجات من DALL-E 3 إلى GPT Image 2.0 هي أكبر تحسين فردي في توليد الصورة الواحدة تطلقه OpenAI في مجال الصور.
فرق الجودة واضح
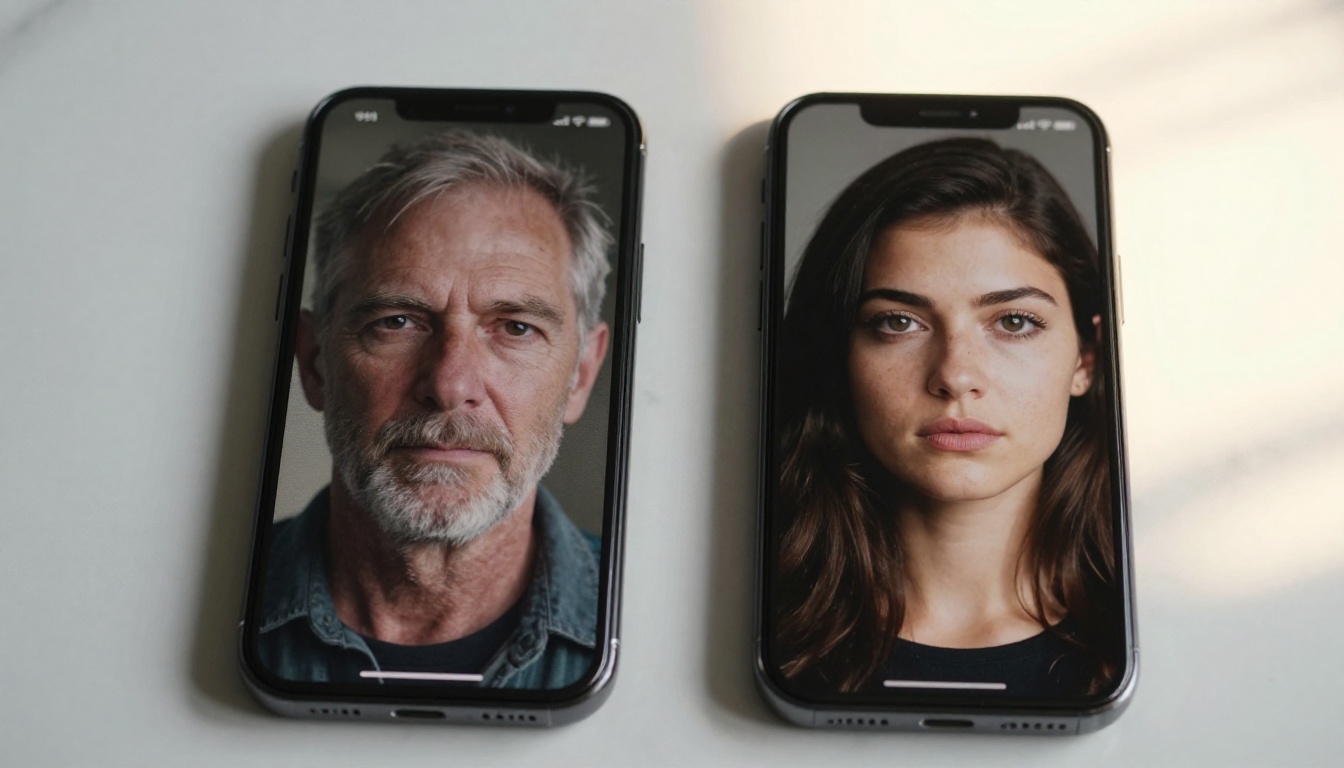
واقعية فوتوغرافية بلا اصطناع
أوضح تحسن يلاحظه المرء فورًا هو الواقعية الفوتوغرافية. تبدو مخرجات GPT Image 2.0 كصور فوتوغرافية لا كفن ينتجه الذكاء الاصطناعي. تُصيَّر درجات البشرة مع تشتت تحت السطحي. لا تلتصق خصلات الشعر ببعضها عند الصدغين. يتلاشى عمق الخلفية بشكل طبيعي مع ضبابية بصرية مقنعة تحاكي سلوك العدسات الحقيقية. وتُظهر الأقمشة أنماط النسيج بدلًا من التدرجات الناعمة.
كانت النماذج السابقة، بما فيها DALL-E 3، تعاني من نقاط إخفاق ثابتة تجعل توليد الذكاء الاصطناعي سهل التمييز من النظرة الأولى:
- الأيدي: أصابع زائدة، ومفاصل ملتصقة، ونسب خاطئة
- النصوص داخل الصور: حروف مشوشة، وتهجئة غير صحيحة، وخطوط غير متسقة
- الوجوه في الزوايا المختلفة: مناظر جانبية تشوّه البنية الوجهية أو تضيف عيوبًا
- الانعكاسات: أسطح مرآة وزجاج لا تعكس المشهد بشكل منطقي
- الحشود: أشخاص في الخلفية يتحولون إلى بقع كلما ابتعدوا
حسّن GPT Image 2.0 كل أنماط الإخفاق الخمسة هذه بشكل ملموس. وهو ليس مثاليًا، ومع المشاهد المعقدة بما يكفي ستلاحظ عيوبًا ما زالت موجودة. لكن تكرار هذه الإخفاقات أقل بشكل كبير، ما يعني توليدات مهدرة أقل وجهدًا أقل في التصحيح اليدوي.
💡 نصيحة: عند طلب وجوه واقعية، حدّد إعداد الإضاءة بدقة (مثلًا "إضاءة رامبرانت من اليسار، عدسة بورتريه 85 ملم، f/1.8") بدلًا من طلب "صورة واقعية" بشكل عام. التحديد ما زال مهمًا، والنموذج يكافئ الأوامر التفصيلية بمخرجات أفضل بوضوح.
دقة تنفيذ الأوامر تحت الضغط
من أبرز الشكاوى حول النماذج السابقة انحراف الأوامر، حيث يؤدي وصف مشهد معقد إلى أن يحذف النموذج العناصر أو يستبدلها ببساطة. اطلب "امرأة ترتدي فستانًا أحمر تقف بجانب دراجة صفراء أمام باب أزرق"، وغالبًا ما ستحصل على امرأة، وربما دراجة، لكن الألوان تنحرف ويختفي الباب أو يتحول إلى شيء آخر.
يحتفظ GPT Image 2.0 بعدد أكبر من العناصر المحددة في وقت واحد. ويأتي ذلك من ارتباط النموذج الأوثق بطبقة فهم اللغة، إذ يتعامل مع توليد الصور كمهمة استدلال يجب فيها حساب كل عنصر في الأمر، لا كبحث بمطابقة الأنماط يحاول إيجاد أقرب صورة من بيانات التدريب.
الأثر العملي هو أن محاولة التوليد الأولى لديك أكثر احتمالًا لأن تطابق قصدك، ما يقصّر دورات التكرار. وبالنسبة لسير العمل الذي يولّد بكميات كبيرة، فإن هذا يعني خفضًا ملموسًا في التكلفة لكل مخرج قابل للاستخدام.
ما الجديد في GPT Image 2.0
النصوص داخل الصور تعمل أخيرًا
هذه هي الميزة التي انتظرها المحترفون المبدعون لسنوات. يستطيع GPT Image 2.0 تصيير نصوص مقروءة ومتسقة أسلوبيًا داخل الصور المولّدة. الشعارات، واللافتات، والملصقات، ونماذج الواجهات، وتغليف المنتجات، وأغلفة الكتب، كلها تخرج الآن بتهجئة صحيحة وطباعة واضحة تصمد عند الدقة الكاملة.
يدعم النموذج:
- تصيير الخطوط العريضة والمائلة والخطوط ذات الزوائد (Serif)
- نصوص متطابقة الألوان مع الخلفيات المعقدة
- عدة عناصر نصية مختلفة في الصورة الواحدة
- محاكاة الخط اليدوي وأسلوب اللوح الطباشيري عند تحديدهما
- نصوص تتبع المنحنيات أو المستويات المنظورية في المشهد
💡 نصيحة: ضع أي نص تريد أن يظهر في الصورة بين علامتي اقتباس مزدوجتين في الأمر النصي. صِف نمط الخط إلى جانبه ("خط sans-serif عريض ومضغوط باللون الأبيض"، "خط طباشيري مكتوب بخط اليد على لوح داكن") للحصول على أفضل النتائج. يستجيب النموذج جيدًا للتوجيه الطباعي.
التعديل المدمج والأصيل
يدعم GPT Image 2.0 التعديل القائم على التعليمات دون أدوات خارجية أو إضافات. تمرّر صورة موجودة مع تعليمة نصية، فيعدّل النموذج المنطقة المحددة مع الحفاظ على بقية الصورة. ويغطي ذلك أربع عمليات تعديل مختلفة:
- التعديل الموضعي (Inpainting): ملء منطقة مقنّعة بمحتوى جديد يمتزج بشكل طبيعي مع المشهد الموجود
- توسيع الصورة (Outpainting): مدّ حدود اللوحة خارج الإطار الأصلي للصورة في أي اتجاه
- استبدال العناصر: استبدال عنصر بآخر مع الحفاظ على الإضاءة والظلال والسياق المحيط
- إعادة الإضاءة: تغيير مصدر الضوء الظاهر، أو وقت اليوم، أو حرارة اللون في صورة فوتوغرافية موجودة
يقرّب هذا GPT Image 2.0 من سير عمل تحرير صور متكامل من البداية إلى النهاية. فبدلًا من التوليد ثم التصدير إلى محرر خارجي ثم إجراء التعديلات ثم إعادة الاستيراد، يمكنك العمل في خيط محادثة واحد مع تحسينات متدرجة. وبالنسبة لفرق المحتوى ذات الإنتاجية العالية، يمثل هذا تبسيطًا كبيرًا لسير العمل.
إدخال صور متعددة لتركيب المرجع
ترقية بنيوية تميّز GPT Image 2.0 عن معظم المنافسين: يقبل الآن عدة صور كمراجع مدخلة، ويدمجها في مخرج واحد متماسك. مرّر ثلاث صور لمنتج من زوايا مختلفة، ويستطيع النموذج توليد زاوية جديدة أو لقطة نمط حياة مركّبة. ومرّر صورة مرجعية للأسلوب مع وصف مكتوب، وسيطبّق النموذج الجماليات البصرية للمرجع على المحتوى الجديد.
هذا مفيد بشكل خاص لاتساق العلامة التجارية، حيث تملك هوية بصرية موجودة وتريد أن يتطابق المحتوى المولّد معها بدلًا من البدء من وصف نصي فقط.
GPT Image 2.0 مقابل المنافسين
المقارنة الصريحة
فضاء الذكاء الاصطناعي لتحويل النص إلى صورة أصبح فيه منافسة حقيقية الآن. إليك تفصيلًا مباشرًا عبر الميزات الأهم للاستخدام العملي:
| القدرة | GPT Image 2.0 | Flux Redux Dev | Stable Diffusion XL |
|---|
| الواقعية الفوتوغرافية | ممتاز | جيد جدًا | جيد |
| النصوص داخل الصور | ممتاز | جيد | مقبول |
| دقة تنفيذ الأوامر | ممتاز | جيد جدًا | جيد |
| التعديل المدمج | نعم | محدود | عبر الإضافات |
| إدخال صور متعددة | نعم | لا | لا |
| الوصول عبر API | نعم | نعم | استضافة ذاتية |
| التكلفة لكل صورة | متوسطة | منخفضة | منخفضة جدًا |
| سرعة التوليد | سريع | سريع جدًا | سريع |
| الضبط الدقيق | لا | محدود | دعم كامل لتقنية LoRA |
Flux هو أقرب منافس من حيث الجودة الخام للصورة. مخرجاته أحيانًا أكثر مرونة في الأسلوب وسرعة التوليد أعلى، ما يجعله خيارًا قويًا للعمل الإبداعي التكراري. أما GPT Image 2.0 فيتفوق بوضوح في تصيير النصوص والدقة في الأوامر متعددة العناصر.
Stable Diffusion XL يبقى الخيار الأفضل للفرق التي تحتاج إلى النشر المحلي، أو التحكم الكامل في الضبط الدقيق، أو أدنى تكلفة ممكنة لكل صورة. لكنه يتطلب بنية تحتية وإعدادًا تقنيًا لا يفرضهما GPT Image 2.0 ببساطة، وهذا مهم للفرق الأصغر أو المشاريع ذات الجداول الزمنية الضيقة.
أين يعاني GPT Image 2.0
الصراحة حول القيود مهمة:
- ثبات الشخصيات: الأمر النصي نفسه لن ينتج الوجه أو الشخص نفسه مرتين، ما يسبب مشكلات للمحتوى المتسلسل أو المستمر
- الأوامر الطويلة جدًا: الأوامر التي تتجاوز 300 كلمة تسبب أحيانًا تعارضات بين العناصر أو تُسقط تفاصيل محددة
- التكلفة عند الحجم الكبير: للتطبيقات عالية الحجم، تتراكم تكلفة التسعير لكل صورة بسرعة مقارنة بالبدائل المستضافة ذاتيًا أو المحسّنة للمعالجة الدفعية
- لا يدعم الضبط الدقيق: لا يمكنك تدريب GPT Image 2.0 على مجموعة بياناتك الخاصة كما يمكنك أن تفعل مع سير عمل LoRA في Stable Diffusion
إذا كان ثبات الشخصيات أو التحكم في الميزانية عند الحجم الكبير هما قيدك الأساسي، فإن البدائل ما زالت تملك مزايا حقيقية.
للمطورين: ما الذي يهم هنا
بنية API والإعداد
GPT Image 2.0 متاح عبر OpenAI API. تقبل نقطة النهاية أوامر نصية فقط للتوليد القياسي، ونصًا مع صورة للتعديل والتوليد بالاستناد إلى مرجع، ونصًا مع عدة صور للتركيب متعدد المراجع.
تشمل تنسيقات الاستجابة الرابط المباشر وترميز base64. يستغرق التوليد عادةً من 10 إلى 25 ثانية حسب دقة المخرجات. تدعم API ثلاثة أحجام للمخرجات:
- 1024x1024: مربع، مثالي للقطات المنتجات وصور الملفات الشخصية
- 1792x1024: أفقي، الأفضل لأغلفة المدونات وترويسات وسائل التواصل الاجتماعي
- 1024x1792: عمودي، مناسب للصيغ المخصصة للهاتف أولًا والإعلانات العمودية
💡 نصيحة: بالنسبة لمعظم سير عمل التسويق بالمحتوى، اطلب 1792x1024 كخيار افتراضي. تمنح نسبة العرض الأوسع النموذجَ مساحة تكوين أكبر، وتميل المخرجات إلى امتلاك عمق مشهد أفضل من القصّات المربعة.
حالات استخدام تعمل بشكل جيد
استنادًا إلى اختبارات أجريت بشكل مباشر، يعمل GPT Image 2.0 بموثوقية في:
- النماذج الأولية للمنتجات: وضع صور المنتجات في سياقات نمط حياة أو بيئات دون الحاجة إلى تصوير استوديو كامل
- مرئيات التسويق بالمحتوى: صور أغلفة المدونات، ومنشورات وسائل التواصل الاجتماعي، وترويسات النشرات البريدية
- أصول النماذج الأولية لواجهة المستخدم وتجربته: لقطات شاشات التطبيقات، ومحتوى الواجهات، والأصول الرسومية للمتاجر
- استكشاف هوية العلامة التجارية: مفاهيم الشعارات، وتصور لوحات الألوان، ولوحات الاتجاه البصري
- الرسوم التوضيحية التحريرية: مرئيات المقالات الإخبارية، ورسوم شرح البيانات، وصور مقالات الرأي
- مفاهيم تصميم التغليف: تخطيطات الملصقات، وتصاميم العلب بنصوص حقيقية مقروءة
- مرئيات العقارات والديكور الداخلي: صور التجهيز، ومفاهيم التجديد، والمعاينات المعمارية
يجعل الجمع بين تصيير النصوص الموثوق والالتزام القوي بالتعليمات النموذج فعالًا بشكل خاص لأي شيء يتضمن تصميم نصوص فوق الصور، وهو ما يغطي حصة كبيرة من أعمال التسويق والنشر.
استخدام GPT Image 2.0 على PicassoIA
خطوة بخطوة مع المنصة
يعمل نموذج PicassoIA Image الخاص بمنصة PicassoIA بتقنية GPT Image، ويمنحك وصولًا مباشرًا إلى قدرات التوليد دون إعداد API أو ضبط للفوترة أو أي عمل تطويري. إليك كيفية استخدامه:
الخطوة 1: افتح النموذج
انتقل إلى PicassoIA Image من مجموعة تحويل النص إلى صورة. تُحمَّل الواجهة مع حقل أوامر نظيف وخيارات إعداد.
الخطوة 2: اكتب أمرًا نصيًا محددًا
كن دقيقًا فيما تريده. اشمل:
- وصف الشخص أو الموضوع (من أو ما هو، والتفاصيل الجسدية)
- المكان والبيئة (الموقع، وقت اليوم، الفصل)
- ظروف الإضاءة (الاتجاه، والجودة، وحرارة اللون)
- منظور الكاميرا وخصائص العدسة
- أي نص يجب أن يظهر في الصورة (ضعه بين علامتي اقتباس مزدوجتين)
الخطوة 3: اختر نسبة العرض إلى الارتفاع
بالنسبة للمحتوى الأفقي للمدونات ووسائل التواصل، تكون 16:9 الخيار الصحيح. والمربع يناسب صور الملفات الشخصية والصور المصغّرة جيدًا.
الخطوة 4: وَلِّد وكرّر
ستكون مخرجاتك الأولى غالبًا قريبة مما تريده. وعند التحسين، غيّر متغيرًا واحدًا في كل مرة بدلًا من إعادة كتابة الأمر بالكامل. فعزل المتغير يجعل من الأسهل معرفة ما يستجيب له النموذج.
الخطوة 5: حرّر باستخدام PicassoIA Image Editor Pro
بعد أن تحصل على صورة أساسية قوية، انتقل إلى Image Editor Pro لإجراء تعديلات مستهدفة، أو التعديل الموضعي لمناطق محددة، أو توسيع اللوحة. وهذا يحاكي طريقة عمل التعديل الأصيل في GPT Image 2.0، ويمنحك سير عمل كاملًا غير مدمّر دون مغادرة المنصة.
💡 نصيحة: بالنسبة لصور نمط الحياة التي تضم أشخاصًا، صِف الملابس وملمس البشرة بصراحة. الأوصاف العامة للشخص تنتج مخرجات عامة. التحديد على مستوى وصف الشخصية هو العامل الأكبر تأثيرًا على جودة المخرجات.
نماذج أخرى تستحق التجربة
تستضيف PicassoIA مجموعة واسعة من نماذج تحويل النص إلى صورة. إذا احتجت تنوعًا أسلوبيًا يتجاوز ما ينتجه GPT Image، فإن Flux Redux Dev يقدم توليدًا سريعًا بمدى إبداعي قوي. أما الفرق التي تريد التدريب على صورها المرجعية الخاصة وبناء أسلوب بصري موحّد، فإن P Image Trainer يتولى التدريب بأسلوب LoRA مخصص عبر واجهة المنصة.
للحصول على سير عمل يجمع التوليد والتعديل في أداة واحدة، يكون PicassoIA Image Editor Pro مفيدًا بشكل خاص عندما تكون سرعة التكرار مهمة. تولّد وتعدّل وتعيد التوليد وتصقل دون التبديل بين أدوات منفصلة أو تصدير الملفات في كل مرحلة.
الحكم بعد الاستخدام الأول
GPT Image 2.0 هو أكثر نموذج توليد صور جاهزًا للإنتاج أطلقته OpenAI. وتحسين تصيير النصوص وحده يجعله يستحق التقييم لأي سير عمل يتعامل مع صور تحمل كلمات، وهذا يشمل معظم التسويق بالمحتوى وتصميم المنتجات والنشر. وترقيات تنفيذ التعليمات تعني توليدات مهدرة أقل. والتكامل الأصيل للتعديل يعني عمليات تنقّل أقل بين البرامج الخارجية.
إنه ليس الخيار الأرخص. ولن يحل محل سير عمل Stable Diffusion المضبوط بدقة للفرق التي تحتاج إلى ثبات الشخصيات عبر سلسلة كاملة. لكن لتوليد المحتوى واسع الاستخدام بالحجم الكبير، فإن جودة المخرجات مقابل كل دولار من الجهد، بما في ذلك الجهد المبذول في تصحيح التوليدات السيئة، تُرجّح كفة GPT Image 2.0 في معظم السيناريوهات.
أسرع طريقة لتكوين تقييمك الخاص هي تشغيل أمر نصي استخدمته من قبل مع DALL-E 3 أو أداة توليد أقدم. وفارق جودة المخرجات الناتج عن أمر نصي جيد البناء سيكون واضحًا فورًا.
ابدأ التجربة مع PicassoIA Image واجلب الدقة نفسها في الأوامر التي تستخدمها لأي موجز إبداعي احترافي. النموذج يكافئ التحديد، والنتائج ستظهر ذلك.