La génération d’images d’OpenAI a franchi une étape importante. GPT Image 2.0 reprend tout ce qui faisait la force de son prédécesseur et comble les lacunes qui laissaient les créateurs sur leur faim. Que vous soyez développeur intégrant le modèle dans des applications, designer l’utilisant pour des maquettes ou simplement curieux de savoir où en sont les visuels générés par l’IA aujourd’hui, ce premier aperçu présente ce qui compte vraiment.
Ce qu’est GPT Image 2.0
Bien plus qu’une simple mise à jour
GPT Image 2.0 est le modèle de synthèse d’images dédié de deuxième génération d’OpenAI. Il fonctionne nativement au sein de la même infrastructure que la famille GPT-4o. Contrairement aux modèles DALL-E qui l’ont précédé, GPT Image 2.0 est conçu dès le départ comme multimodal. Il lit des images en entrée, en génère en sortie et traite les demandes de modification dans une seule conversation unifiée, plutôt que comme des tâches distinctes et séparées.
La première génération constituait déjà une nette amélioration par rapport à DALL-E 3 en matière de précision des prompts et de photoréalisme. GPT Image 2.0 renforce considérablement ces acquis, avec des progrès particuliers dans le rendu du texte, la fidélité de la composition et la prise en charge native de l’édition.
Sa place dans la gamme d’OpenAI
| Modèle | Idéal pour | Limite principale |
|---|
| DALL-E 2 | Concepts artistiques simples | Photoréalisme faible |
| DALL-E 3 | Illustrations stylisées | Texte peu fiable dans les images |
| GPT Image 1.0 | Prompts photoréalistes | Édition limitée |
| GPT Image 2.0 | Images haute fidélité et modifiables | Coût par image plus élevé |
GPT Image 2.0 s’impose désormais comme l’option par défaut pour toute personne intégrant des flux de travail d’images dans des applications de production via l’API d’OpenAI, en remplacement de DALL-E 3 dans la plupart des pipelines sérieux. Le saut de qualité entre DALL-E 3 et GPT Image 2.0 est la plus grande amélioration en une seule génération qu’OpenAI ait lancée dans le domaine de l’image.
La différence de qualité est visible
Un photoréalisme sans artifice
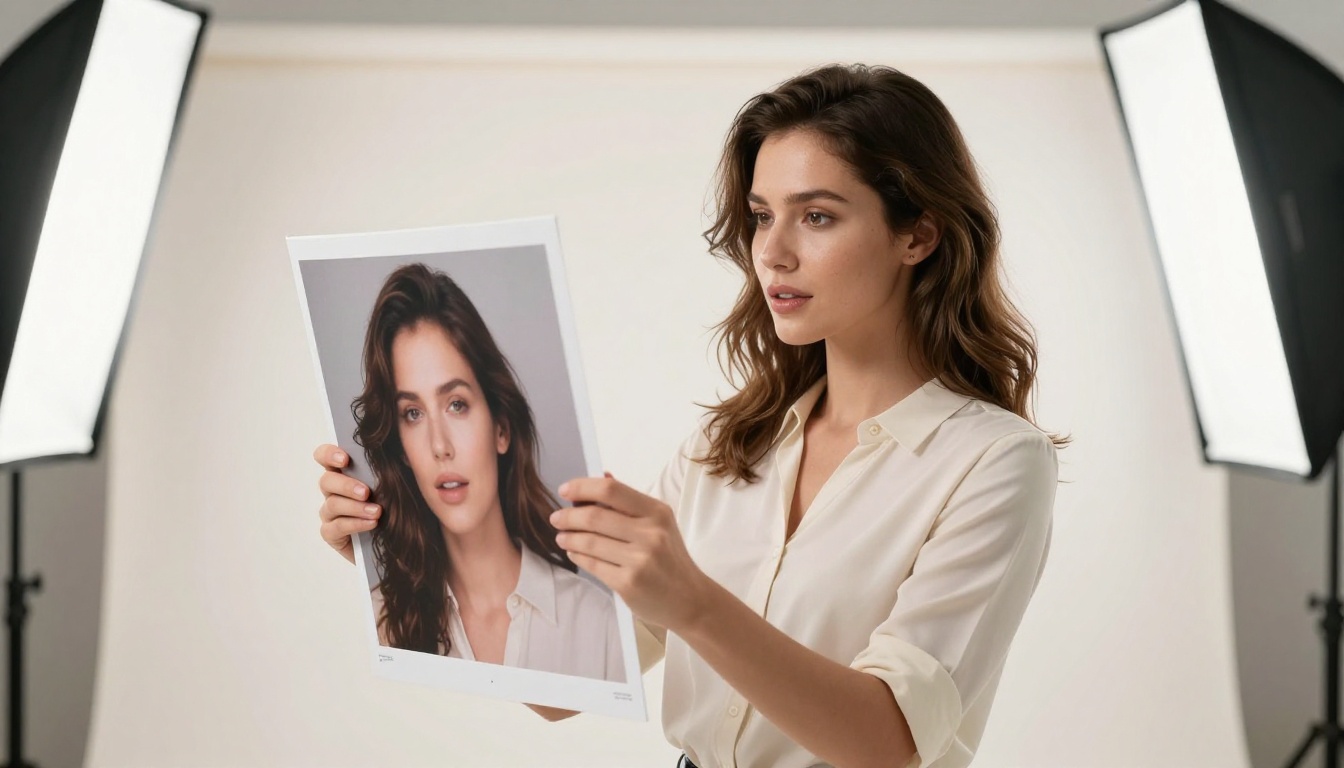
La première amélioration qui saute aux yeux est le photoréalisme. Les rendus de GPT Image 2.0 ressemblent à des photographies plutôt qu’à de l’art généré par IA. Les teints de peau présentent une diffusion sous-cutanée. Les mèches de cheveux ne forment plus de touffes compactes au niveau des tempes. La profondeur de l’arrière-plan s’estompe naturellement, avec un flou optique convaincant qui imite le comportement d’un véritable objectif. Les textures des tissus montrent le tissage plutôt que des dégradés lisses.
Les modèles précédents, DALL-E 3 compris, présentaient des points de défaillance récurrents qui permettaient de repérer d’un coup d’œil une génération par IA :
- Mains : doigts en trop, jointures fusionnées, proportions erronées
- Texte dans les images : caractères déformés, orthographe incorrecte, polices incohérentes
- Visages de profil : vues de profil qui déformaient la structure du visage ou ajoutaient des artefacts
- Reflets : surfaces miroir et vitrées qui ne reflétaient pas logiquement la scène
- Foules : silhouettes en arrière-plan qui se transformaient en taches à mesure qu’elles s’éloignaient
GPT Image 2.0 a nettement amélioré ces cinq types de défaillances. Il n’est pas parfait et, sur des scènes suffisamment complexes, vous verrez encore des artefacts. Mais la fréquence de ces échecs est nettement plus basse, ce qui signifie moins de générations gâchées et moins de retouches manuelles.
💡 Astuce : lorsque vous demandez des visages photoréalistes, précisez exactement le dispositif d’éclairage (par exemple « éclairage à la Rembrandt par la gauche, objectif portrait 85 mm, f/1.8 ») au lieu de demander vaguement « une photo réaliste ». La précision compte toujours, et le modèle récompense les prompts détaillés par des résultats nettement meilleurs.
La précision des prompts sous pression
L’une des principales critiques adressées aux modèles précédents concernait la dérive des prompts : une description de scène complexe aboutissait à ce que le modèle omette ou remplace des éléments. Demandez « une femme en robe rouge debout à côté d’un vélo jaune devant une porte bleue » et vous obteniez souvent une femme, peut-être un vélo, mais les couleurs dérivaient et la porte disparaissait ou se transformait en autre chose.
GPT Image 2.0 retient simultanément davantage d’éléments spécifiés. Cela tient au couplage plus étroit du modèle avec la couche de compréhension du langage, qui traite la génération d’images comme une tâche de raisonnement où chaque élément du prompt doit être pris en compte, plutôt que comme une recherche par correspondance de motifs cherchant l’image d’entraînement la plus proche.
Concrètement, votre première tentative de génération a plus de chances de correspondre à votre intention, ce qui raccourcit les cycles d’itération. Pour les flux de travail à grand volume, cela représente une réduction significative du coût par résultat utilisable.
Les nouveautés de GPT Image 2.0
Le texte dans les images fonctionne enfin
C’est la fonctionnalité que les professionnels de la création attendaient depuis des années. GPT Image 2.0 sait générer du texte lisible et cohérent sur le plan stylistique à l’intérieur des images. Logos, panneaux, affiches, maquettes d’interfaces, emballages de produits, couvertures de livres : tous sortent désormais avec une orthographe correcte et une typographie lisible qui tient à pleine résolution.
Le modèle prend en charge :
- le rendu de polices en gras, en italique et empattées
- du texte aux couleurs assorties sur des arrière-plans complexes
- plusieurs éléments de texte distincts dans une même image
- des styles simulés d’écriture à la main et de tableau noir à la craie, lorsqu’ils sont précisés
- du texte suivant des courbes ou des plans en perspective dans la scène
💡 Astuce : placez tout texte que vous souhaitez voir dans l’image entre guillemets doubles dans votre prompt. Décrivez le style de police à côté (« sans-serif condensée en gras, en blanc », « écriture manuscrite à la craie sur fond sombre ») pour de meilleurs résultats. Le modèle répond bien aux indications typographiques.
L’édition native intégrée
GPT Image 2.0 prend en charge l’édition par instructions, sans outils externes ni extensions. Vous transmettez une image existante accompagnée d’une instruction écrite, et le modèle modifie la zone indiquée tout en préservant le reste. Cela couvre quatre opérations d’édition distinctes :
- Inpainting : remplir une zone masquée avec un contenu nouveau qui se fond naturellement dans la scène existante
- Outpainting : étendre le cadre d’une image au-delà de ses bords d’origine, dans n’importe quelle direction
- Remplacement d’objet : échanger un élément contre un autre en préservant l’éclairage, les ombres et le contexte environnant
- Relighting : modifier la source de lumière apparente, l’heure de la journée ou la température de couleur d’une photographie existante
Cela rapproche GPT Image 2.0 d’un flux de travail complet d’édition d’images de bout en bout. Au lieu de générer, d’exporter vers un éditeur externe, d’effectuer des ajustements puis de réimporter, vous pouvez travailler dans un seul fil de conversation avec des raffinements successifs. Pour les équipes de contenu à fort débit, c’est une simplification significative du flux de travail.
Entrée multi-images pour la synthèse à partir de références
Une évolution structurelle qui distingue GPT Image 2.0 de la plupart de ses concurrents : il accepte désormais plusieurs images en entrée comme références et les synthétise en un seul résultat cohérent. Transmettez trois photos de produit prises sous des angles différents, et le modèle peut générer un nouvel angle ou une photo lifestyle composite. Transmettez une image de référence de style accompagnée d’une description écrite, et le modèle appliquera l’esthétique visuelle de la référence à un nouveau contenu.
C’est particulièrement utile pour la cohérence de marque, lorsque vous disposez d’une identité visuelle existante et souhaitez que le contenu généré s’y conforme plutôt que de partir d’une simple description textuelle.
GPT Image 2.0 face à la concurrence
La comparaison sans détour
L’espace de la génération de texte vers image compte désormais de vrais concurrents. Voici une analyse directe des fonctions les plus importantes pour un usage concret :
| Capacité | GPT Image 2.0 | Flux Redux Dev | Stable Diffusion XL |
|---|
| Photoréalisme | Excellent | Très bon | Bon |
| Texte dans les images | Excellent | Bon | Passable |
| Précision des prompts | Excellente | Très bonne | Bonne |
| Édition native | Oui | Limitée | Via des extensions |
| Entrée multi-images | Oui | Non | Non |
| Accès à l’API | Oui | Oui | Auto-hébergé |
| Coût par image | Moyen | Faible | Très faible |
| Vitesse de génération | Rapide | Très rapide | Rapide |
| Fine-tuning | Non | Limité | Prise en charge complète des LoRA |
Flux est le concurrent le plus proche en matière de qualité d’image brute. Ses rendus sont parfois plus souples sur le plan stylistique et sa vitesse de génération est plus élevée, ce qui en fait un choix solide pour un travail créatif itératif. GPT Image 2.0 l’emporte nettement en matière de rendu de texte et de précision des prompts à plusieurs éléments.
Stable Diffusion XL reste la meilleure option pour les équipes qui ont besoin d’un déploiement en local, d’un contrôle total du fine-tuning ou du coût par image le plus bas possible. Mais il exige une infrastructure et une configuration technique que GPT Image 2.0 ne demande tout simplement pas, ce qui compte pour les petites équipes ou les projets aux délais serrés.
Les points faibles de GPT Image 2.0
Il est important d’être honnête sur ses limites :
- Cohérence des personnages : le même prompt ne produira pas deux fois le même visage ni la même personne, ce qui pose problème pour les contenus en série ou au long cours
- Prompts très longs : les prompts dépassant 300 mots provoquent parfois des conflits entre éléments ou font disparaître certains détails précis
- Coût à grande échelle : pour les applications à fort volume, la tarification à l’image s’accumule rapidement par rapport aux alternatives auto-hébergées ou optimisées par lots
- Pas de fine-tuning : vous ne pouvez pas entraîner GPT Image 2.0 sur votre propre jeu de données, comme c’est possible avec les flux de travail LoRA de Stable Diffusion
Si la cohérence des personnages ou la maîtrise du budget à grand volume sont vos contraintes principales, les alternatives présentent toujours de véritables avantages.
Pour les développeurs : ce qui compte ici
Structure de l’API et configuration
GPT Image 2.0 est accessible via l’API d’OpenAI. Le point d’accès accepte des prompts en texte seul pour une génération standard, du texte accompagné d’une image pour l’édition et la génération à partir de références, et du texte accompagné de plusieurs images pour la synthèse multi-références.
Les formats de réponse incluent l’URL directe et l’encodage base64. La génération se termine généralement en 10 à 25 secondes, selon la résolution de sortie. L’API prend en charge trois tailles de sortie :
- 1024x1024 : carré, idéal pour les photos de produits et les images de profil
- 1792x1024 : paysage, parfait pour les couvertures de blog et les bannières de réseaux sociaux
- 1024x1792 : portrait, adapté aux formats pensés d’abord pour le mobile et aux publicités verticales
💡 Astuce : pour la plupart des flux de travail de marketing de contenu, demandez 1792x1024 par défaut. Le format plus large laisse davantage de marge de composition au modèle, et les rendus ont tendance à offrir une meilleure profondeur de scène que les recadrages carrés.
Cas d’usage qui donnent de bons résultats
D’après nos tests directs, GPT Image 2.0 fonctionne de manière fiable pour :
- Maquettes de produits : placer des images de produits dans des contextes lifestyle ou environnementaux sans séance photo en studio complète
- Visuels de marketing de contenu : images de couverture de blog, publications sur les réseaux sociaux, bannières de newsletters par e-mail
- Éléments de maquettes UI et UX : captures d’écran d’applications, contenus d’interface, éléments graphiques de boutique d’applications
- Exploration d’identité de marque : concepts de logos, visualisation de palettes de couleurs, planches de direction artistique
- Illustration éditoriale : visuels d’articles d’actualité, infographies explicatives, images d’articles d’opinion
- Concepts de design d’emballage : mises en page d’étiquettes, designs de boîtes avec du texte réel et lisible
- Visuels immobiliers et d’aménagement intérieur : images de home staging, concepts de rénovation, aperçus architecturaux
La combinaison d’un rendu de texte fiable et d’un bon respect des instructions le rend particulièrement efficace pour tout ce qui implique du design texte-sur-image, ce qui couvre une grande part du travail de marketing et d’édition.
Utiliser GPT Image 2.0 sur PicassoIA
Étape par étape avec la plateforme
Le modèle PicassoIA Image repose sur la technologie GPT Image, ce qui vous donne un accès direct à ses capacités de génération, sans configuration d’API, sans paramétrage de facturation ni développement. Voici comment l’utiliser :
Étape 1 : ouvrez le modèle
Rendez-vous sur PicassoIA Image depuis la collection texte vers image. L’interface s’ouvre avec un champ de prompt épuré et des options de configuration.
Étape 2 : rédigez un prompt précis
Soyez précis sur ce que vous voulez. Incluez :
- la description du sujet (qui ou quoi, détails physiques)
- le cadre et l’environnement (lieu, moment de la journée, saison)
- les conditions d’éclairage (direction, qualité, température de couleur)
- la perspective de la caméra et les caractéristiques de l’objectif
- tout texte qui doit apparaître dans l’image (entre guillemets doubles)
Étape 3 : choisissez votre format
Pour les contenus horizontaux de blog et de réseaux sociaux, le format 16:9 est le bon choix. Le carré convient bien aux images de profil et aux miniatures.
Étape 4 : générez et itérez
Votre premier résultat sera souvent proche de ce que vous voulez. Lors des raffinements, modifiez une variable à la fois plutôt que de réécrire tout le prompt. Isoler la variable permet de mieux voir à quoi le modèle réagit.
Étape 5 : éditez avec PicassoIA Image Editor Pro
Une fois que vous disposez d’une bonne image de base, passez à Image Editor Pro pour des ajustements ciblés, de l’inpainting sur des zones précises ou une extension du cadre. Cela reproduit le fonctionnement de l’édition native de GPT Image 2.0 et vous offre un flux de travail complet et non destructif, sans quitter la plateforme.
💡 Astuce : pour les images lifestyle mettant en scène des personnes, décrivez explicitement les vêtements et la texture de la peau. Les descriptions génériques du sujet donnent des résultats génériques. La précision au niveau de la description du personnage est le levier le plus important pour la qualité du rendu.
D’autres modèles à tester
PicassoIA propose une large gamme de modèles de texte vers image. Si vous recherchez une variété de styles au-delà de ce que produit GPT Image, Flux Redux Dev offre une génération rapide avec une grande liberté créative. Pour les équipes qui souhaitent s’entraîner sur leurs propres images de référence et construire un style maison cohérent, le P Image Trainer gère l’entraînement de type LoRA personnalisé via l’interface de la plateforme.
Pour un flux combinant génération et édition dans un seul outil, PicassoIA Image Editor Pro est particulièrement utile lorsque la vitesse d’itération compte. Vous générez, ajustez, régénérez et affinez sans changer d’outil ni exporter de fichiers à chaque étape.
Le verdict après une première utilisation
GPT Image 2.0 est le modèle de génération d’images le plus prêt pour la production qu’OpenAI ait lancé. L’amélioration du rendu de texte justifie à elle seule de l’évaluer pour tout flux de travail impliquant des images avec du texte, ce qui couvre la plupart du marketing de contenu, du design de produits et de l’édition. Les progrès dans le respect des instructions signifient moins de générations gâchées. L’intégration native de l’édition signifie moins d’allers-retours avec des logiciels externes.
Ce n’est pas l’option la moins chère. Il ne remplacera pas les flux Stable Diffusion avec fine-tuning pour les équipes qui ont besoin d’une identité de personnage persistante sur une série. Mais pour la création de contenus à usage général et à grande échelle, le rapport entre la qualité des rendus et l’effort fourni, y compris l’effort consacré à corriger les mauvaises générations, joue en faveur de GPT Image 2.0 dans la plupart des cas.
La manière la plus rapide de vous faire votre propre avis est de lancer un prompt que vous avez déjà utilisé avec DALL-E 3 ou un outil de génération antérieur. La différence de qualité obtenue avec un prompt bien construit sera immédiatement visible.
Commencez à expérimenter avec PicassoIA Image et appliquez la même précision dans vos prompts que pour n’importe quel brief créatif professionnel. Le modèle récompense la précision, et les résultats le montreront.