A geração de imagens da OpenAI deu um passo significativo à frente. O GPT Image 2.0 se apoia em tudo o que tornava seu antecessor interessante e corrige as lacunas que deixavam criadores querendo mais. Seja você um desenvolvedor que integra o modelo a aplicativos, um designer que o usa para mockups ou apenas alguém curioso sobre o estágio atual das imagens geradas por IA, este primeiro olhar cobre o que realmente importa.
O que é o GPT Image 2.0
Não é só mais uma atualização incremental
O GPT Image 2.0 é o modelo de síntese de imagens dedicado de segunda geração da OpenAI, rodando nativamente na mesma infraestrutura da família GPT-4o, mais ampla. Diferentemente dos modelos DALL-E que vieram antes, o GPT Image 2.0 foi construído para ser multimodal desde a base. Ele lê imagens como entrada, gera imagens como saída e trata pedidos de edição como parte de uma única conversa unificada, e não como tarefas separadas.
A primeira geração já era uma melhoria notável em relação ao DALL-E 3 em termos de precisão do prompt e fotorrealismo. O GPT Image 2.0 aprofunda esses ganhos de forma considerável, com melhorias particulares na renderização de texto, na fidelidade de composição e no suporte nativo à edição.
Onde ele se encaixa na linha da OpenAI
| Modelo | Melhor para | Principal limitação |
|---|
| DALL-E 2 | Arte conceitual básica | Fotorrealismo baixo |
| DALL-E 3 | Ilustrações estilizadas | Texto fraco nas imagens |
| GPT Image 1.0 | Prompts fotorrealistas | Edição limitada |
| GPT Image 2.0 | Imagens de alta fidelidade e editáveis | Custo por imagem mais alto |
O GPT Image 2.0 agora é posicionado como a opção padrão para quem monta fluxos de trabalho de imagem em aplicativos de produção via API da OpenAI, substituindo o DALL-E 3 na maioria dos pipelines sérios. O salto na qualidade da saída do DALL-E 3 para o GPT Image 2.0 é a maior melhoria de uma única geração que a OpenAI já lançou na área de imagens.
A diferença de qualidade está visível
Fotorrealismo sem artificialidade
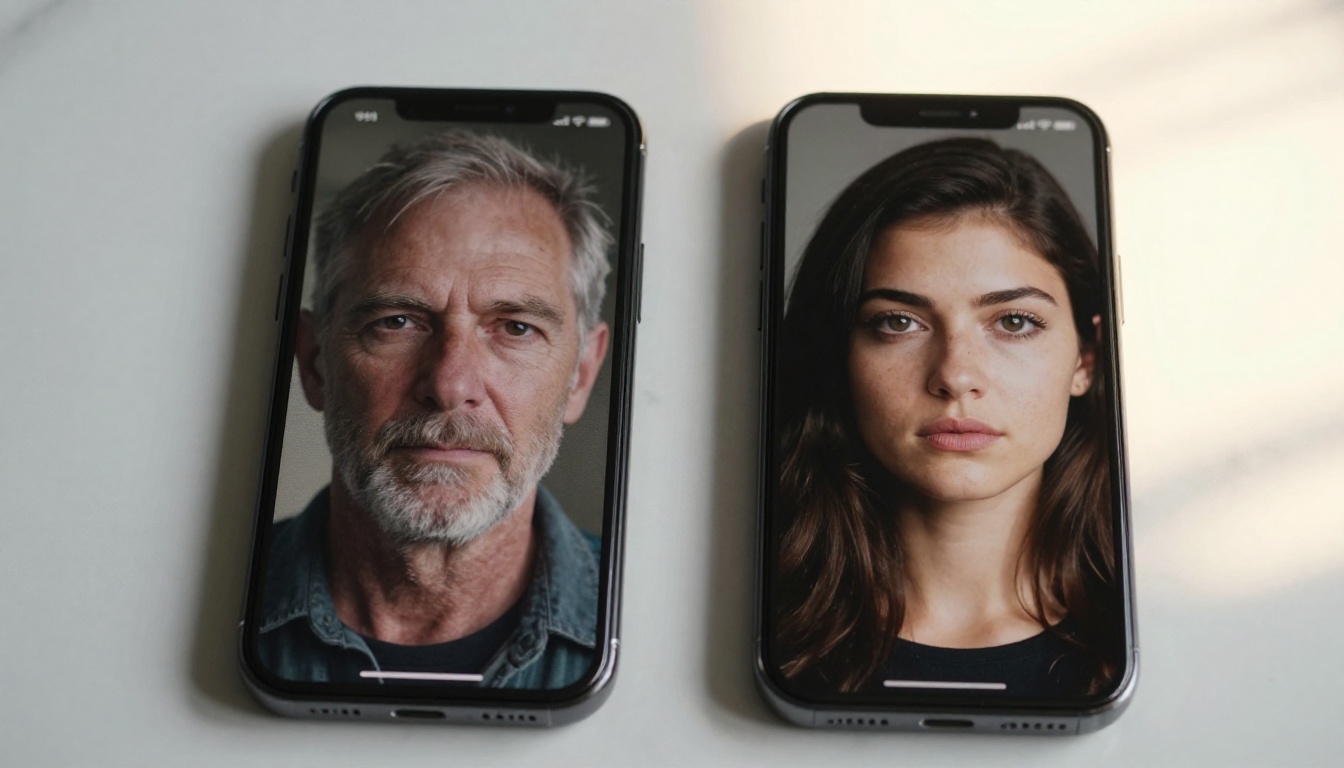
A melhoria mais imediatamente perceptível é o fotorrealismo. As saídas do GPT Image 2.0 parecem fotografias, e não arte de IA. Os tons de pele são renderizados com dispersão subsuperficial. Os fios de cabelo não se fundem em mechas nas têmporas. A profundidade do fundo cai de forma natural, com um desfoque óptico convincente que imita o comportamento de lentes reais. As texturas de tecido mostram padrões de trama em vez de degradês lisos.
Modelos anteriores, incluindo o DALL-E 3, tinham pontos de falha recorrentes que tornavam a geração por IA fácil de identificar à primeira vista:
- Mãos: dedos extras, nós dos dedos fundidos, proporções erradas
- Texto nas imagens: caracteres embaralhados, grafia incorreta, fontes inconsistentes
- Rostos em ângulos: vistas de perfil que distorciam a estrutura facial ou adicionavam artefatos
- Reflexos: superfícies de espelho e vidro que não refletiam a cena de forma lógica
- Multidões: figuras no fundo que se degradavam em manchas conforme se afastavam
O GPT Image 2.0 avançou muito em todos esses cinco modos de falha. Ele não é perfeito, e com cenas suficientemente complexas você ainda verá artefatos. Mas a frequência dessas falhas é substancialmente menor, o que significa menos gerações desperdiçadas e menos trabalho de correção manual.
💡 Dica: ao pedir rostos fotorrealistas, especifique com precisão a montagem de iluminação (por exemplo, "iluminação de Rembrandt pela esquerda, lente de retrato de 85mm, f/1.8") em vez de pedir vagamente "uma foto realista". A especificidade ainda importa, e o modelo recompensa prompts detalhados com resultados visivelmente melhores.
Precisão do prompt sob pressão
Uma das principais queixas sobre os modelos anteriores era a deriva do prompt, em que uma descrição de cena complexa acabava fazendo o modelo simplesmente omitir ou substituir elementos. Peça "uma mulher de vestido vermelho ao lado de uma bicicleta amarela em frente a uma porta azul" e você frequentemente recebia uma mulher, talvez uma bicicleta, mas as cores se desviavam e a porta desaparecia ou se transformava em outra coisa.
O GPT Image 2.0 mantém mais elementos especificados ao mesmo tempo. Isso vem do acoplamento mais estreito do modelo com a camada de compreensão de linguagem, tratando a geração de imagens como uma tarefa de raciocínio em que cada elemento do prompt precisa ser levado em conta, e não como uma busca por correspondência de padrões que tenta encontrar a imagem de treinamento mais próxima.
O efeito prático é que sua primeira tentativa de geração tem mais chances de corresponder à sua intenção, o que encurta os ciclos de iteração. Para fluxos de trabalho em que você gera em volume, isso representa uma redução significativa no custo por saída utilizável.
O que há de novo no GPT Image 2.0
Texto nas imagens finalmente funciona
Este é o recurso que profissionais criativos esperavam há anos. O GPT Image 2.0 consegue renderizar texto legível e consistente no estilo dentro das imagens geradas. Logotipos, placas, cartazes, mockups de interface, embalagens de produtos, capas de livros: tudo isso agora sai com grafia correta e tipografia legível que se sustenta em resolução máxima.
O modelo oferece suporte a:
- Renderização de tipografias em negrito, itálico e serifada
- Texto com cores combinadas ao fundo complexo
- Vários elementos de texto distintos em uma única imagem
- Letra manuscrita simulada e estilos de lousa de giz quando especificados
- Texto seguindo curvas ou planos de perspectiva na cena
💡 Dica: coloque qualquer texto que você queira na imagem entre aspas duplas no seu prompt. Descreva o estilo da fonte junto com ele ("sans-serif condensada em negrito, na cor branca", "letra de giz manuscrita sobre quadro escuro") para obter melhores resultados. O modelo responde bem a direções tipográficas.
Edição nativa de imagens já incluída
O GPT Image 2.0 oferece suporte à edição baseada em instruções sem ferramentas externas ou plugins. Você envia uma imagem existente junto com uma instrução de texto, e o modelo modifica a área especificada preservando o restante. Isso cobre quatro operações de edição distintas:
- Inpainting: preenche uma região mascarada com conteúdo novo que se mistura naturalmente à cena existente
- Outpainting: estende a tela de uma imagem além de suas bordas originais, em qualquer direção
- Substituição de objeto: troca um elemento por outro preservando iluminação, sombra e o contexto ao redor
- Reiluminação: altera a fonte de luz aparente, a hora do dia ou a temperatura de cor de uma fotografia existente
Isso aproxima o GPT Image 2.0 de um fluxo de edição de imagens completo, de ponta a ponta. Em vez de gerar, exportar para um editor externo, fazer ajustes e reimportar, você pode trabalhar em uma única thread de conversa com refinamentos progressivos. Para equipes de conteúdo com necessidades de alto volume, isso é uma simplificação significativa do fluxo de trabalho.
Entrada de várias imagens para síntese de referência
Uma atualização estrutural que diferencia o GPT Image 2.0 da maioria dos concorrentes: ele agora aceita várias imagens como referências de entrada e as sintetiza em uma única saída coerente. Envie três fotos de produto de ângulos diferentes e o modelo pode gerar um novo ângulo ou uma foto de estilo de vida composta. Envie uma imagem de referência de estilo junto com uma descrição escrita e o modelo aplicará a estética visual da referência ao novo conteúdo.
Isso é especialmente útil para a consistência de marca, quando você já tem uma identidade visual e quer que o conteúdo gerado combine com ela, em vez de partir apenas de uma descrição em texto.
GPT Image 2.0 ou a concorrência
A comparação honesta
O espaço de texto para imagem com IA agora tem concorrência real. Aqui está um resumo direto dos recursos que mais importam para o uso prático:
| Capacidade | GPT Image 2.0 | Flux Redux Dev | Stable Diffusion XL |
|---|
| Fotorrealismo | Excelente | Muito bom | Bom |
| Texto nas imagens | Excelente | Bom | Razoável |
| Precisão do prompt | Excelente | Muito bom | Bom |
| Edição nativa | Sim | Limitada | Via plugins |
| Entrada de várias imagens | Sim | Não | Não |
| Acesso à API | Sim | Sim | Autohospedado |
| Custo por imagem | Médio | Baixo | Muito baixo |
| Velocidade de geração | Rápida | Muito rápida | Rápida |
| Fine-tuning | Não | Limitado | Suporte completo a LoRA |
O Flux é o concorrente mais próximo na qualidade bruta da imagem. Suas saídas são às vezes mais flexíveis em estilo, e a velocidade de geração é maior, o que o torna uma boa escolha para trabalho criativo iterativo. Onde o GPT Image 2.0 vence com clareza é na renderização de texto e na precisão do prompt com vários elementos.
O Stable Diffusion XL continua sendo a melhor opção para equipes que precisam de implantação local, controle total de fine-tuning ou o menor custo possível por imagem. Mas ele exige infraestrutura e configuração técnica que o GPT Image 2.0 simplesmente não demanda, o que importa para equipes menores ou projetos com prazos apertados.
Onde o GPT Image 2.0 tem dificuldades
Ser honesto sobre as limitações é importante:
- Consistência de personagem: o mesmo prompt não produzirá o mesmo rosto ou pessoa duas vezes, o que cria problemas para conteúdo seriado ou contínuo
- Prompts muito longos: prompts com mais de 300 palavras às vezes causam conflitos entre elementos ou deixam de lado detalhes específicos
- Custo em escala: para aplicações de alto volume, o preço por imagem se acumula rapidamente em comparação com alternativas autohospedadas ou otimizadas em lote
- Sem fine-tuning: você não pode treinar o GPT Image 2.0 com seu próprio conjunto de dados como se faz com fluxos de trabalho de LoRA no Stable Diffusion
Se a consistência de personagem ou o controle de orçamento em volume forem suas principais restrições, as alternativas ainda têm vantagens reais.
Para desenvolvedores: o que importa aqui
Estrutura e configuração da API
O GPT Image 2.0 é acessível pela API da OpenAI. O endpoint aceita prompts somente de texto para geração padrão, texto mais imagem de entrada para edição e geração de referência, e texto mais várias imagens para síntese multirreferência.
Os formatos de resposta incluem URL direta e codificação base64. A geração normalmente termina em 10 a 25 segundos, dependendo da resolução de saída. A API oferece suporte a três tamanhos de saída:
- 1024x1024: quadrado, ideal para fotos de produto e imagens de perfil
- 1792x1024: paisagem, melhor para capas de blog e cabeçalhos de redes sociais
- 1024x1792: retrato, indicado para formatos pensados primeiro para o celular e anúncios verticais
💡 Dica: para a maioria dos fluxos de trabalho de marketing de conteúdo, peça 1792x1024 como padrão. A proporção mais larga dá ao modelo mais espaço de composição, e as saídas tendem a ter melhor profundidade de cena do que recortes quadrados.
Casos de uso que funcionam bem
Com base em testes próprios, o GPT Image 2.0 tem bom desempenho de forma confiável em:
- Mockups de produto: colocar imagens de produtos em contextos de estilo de vida ou ambientes sem um ensaio completo em estúdio
- Imagens para marketing de conteúdo: capas de blog, posts de redes sociais, cabeçalhos de newsletter por e-mail
- Ativos de mockup de UI e UX: capturas de tela de aplicativos, conteúdo de interface, gráficos para lojas de aplicativos
- Exploração de identidade de marca: conceitos de logotipo, visualização de paleta de cores, painéis de direção visual
- Ilustração editorial: imagens para matérias de notícias, gráficos explicativos de dados, imagens de artigos de opinião
- Conceitos de design de embalagem: layouts de rótulos, designs de caixas com texto real e legível
- Visuais imobiliários e de interiores: imagens de home staging, conceitos de reforma, prévias arquitetônicas
A combinação de renderização confiável de texto e forte seguimento de instruções o torna particularmente eficaz para qualquer coisa que envolva design de texto sobre imagem, o que cobre uma grande parte do trabalho de marketing e publicação.
Usando o GPT Image 2.0 na PicassoIA
Passo a passo com a plataforma
O modelo PicassoIA Image da PicassoIA é alimentado pela tecnologia GPT Image, dando a você acesso direto aos seus recursos de geração sem nenhuma configuração de API, configuração de cobrança ou trabalho de desenvolvedor. Veja como colocá-lo em uso:
Passo 1: abra o modelo
Acesse o PicassoIA Image na coleção de texto para imagem. A interface carrega com um campo de prompt limpo e opções de configuração.
Passo 2: escreva um prompt específico
Seja preciso sobre o que você quer. Inclua:
- Descrição do sujeito (quem ou o quê, detalhes físicos)
- Cenário e ambiente (local, hora do dia, estação)
- Condições de iluminação (direção, qualidade, temperatura de cor)
- Perspectiva da câmera e características da lente
- Qualquer texto que deva aparecer na imagem (entre aspas duplas)
Passo 3: escolha sua proporção
Para conteúdo horizontal de blog e redes sociais, 16:9 é a escolha certa. Quadrado funciona bem para imagens de perfil e miniaturas.
Passo 4: gere e itere
Sua primeira saída muitas vezes ficará próxima do que você quer. Ao refinar, mude uma variável por vez em vez de reescrever o prompt inteiro. Isolar a variável facilita ver a que o modelo está respondendo.
Passo 5: edite com o PicassoIA Image Editor Pro
Quando você tiver uma imagem-base forte, passe para o Image Editor Pro para ajustes direcionados, inpainting de áreas específicas ou expansão de tela. Isso espelha como a edição nativa do GPT Image 2.0 funciona e oferece um fluxo de trabalho completo e não destrutivo sem sair da plataforma.
💡 Dica: para imagens de estilo de vida com pessoas, descreva explicitamente a roupa e a textura da pele. Descrições genéricas do sujeito produzem resultados genéricos. A especificidade na descrição do personagem é o fator de maior impacto na qualidade do resultado.
Outros modelos que valem a pena testar
A PicassoIA hospeda uma ampla gama de modelos de texto para imagem. Se você precisa de variedade de estilo além do que o GPT Image produz, o Flux Redux Dev oferece geração rápida com boa amplitude criativa. Para equipes que querem treinar com as próprias imagens de referência e construir um estilo visual próprio e consistente, o P Image Trainer cuida do treinamento personalizado no estilo LoRA pela interface da plataforma.
Para um fluxo combinado de geração e edição em uma única ferramenta, o PicassoIA Image Editor Pro é especialmente útil quando a velocidade de iteração importa. Você gera, ajusta, regenera e refina sem alternar entre ferramentas separadas ou exportar arquivos em cada etapa.
O veredito após o primeiro uso
O GPT Image 2.0 é o modelo de geração de imagens mais pronto para produção que a OpenAI já lançou. A melhoria na renderização de texto, sozinha, justifica avaliá-lo para qualquer fluxo de trabalho que envolva imagens com palavras, o que inclui a maior parte do marketing de conteúdo, do design de produtos e da publicação. As melhorias em seguimento de instruções significam menos gerações desperdiçadas. A integração nativa de edição significa menos idas e vindas com softwares externos.
Não é a opção mais barata. Ele não substituirá fluxos de trabalho de Stable Diffusion com fine-tuning para equipes que precisam de identidade de personagem persistente em uma série. Mas, para a criação de conteúdo de uso amplo em escala, a qualidade de saída por unidade de esforço, incluindo o trabalho para corrigir gerações ruins, favorece o GPT Image 2.0 na maioria dos cenários.
A forma mais rápida de formar sua própria avaliação é rodar um prompt que você já usou com o DALL-E 3 ou com uma ferramenta de geração anterior. A diferença de qualidade de um prompt bem construído ficará visível de imediato.
Comece a experimentar com o PicassoIA Image e traga para ele a mesma precisão de prompt que você usaria em qualquer briefing criativo profissional. O modelo recompensa a especificidade, e os resultados vão mostrar isso.