La generación de imágenes de OpenAI ha dado un paso importante hacia delante. GPT Image 2.0 se basa en todo lo que hacía atractivo a su predecesor y corrige las carencias que dejaban a los creadores con ganas de más. Tanto si eres desarrollador y lo integras en aplicaciones, como diseñador que lo usa para maquetas, o simplemente tienes curiosidad por el punto en el que están hoy los visuales con IA, este primer vistazo cubre lo que realmente importa.
Qué es GPT Image 2.0
No es solo una actualización más
GPT Image 2.0 es el modelo de síntesis de imágenes dedicado de segunda generación de OpenAI, y funciona de forma nativa dentro de la misma infraestructura que la familia GPT-4o más amplia. A diferencia de los modelos DALL-E que lo precedieron, GPT Image 2.0 está diseñado desde cero para ser multimodal. Lee imágenes como entrada, las genera como salida y gestiona las peticiones de edición como parte de una única conversación unificada, en lugar de como tareas independientes.
La primera generación ya supuso una mejora notable frente a DALL-E 3 en precisión de los prompts y fotorrealismo. GPT Image 2.0 perfecciona esos avances de forma considerable, con mejoras especialmente destacadas en la renderización de texto, la fidelidad compositiva y el soporte de edición nativa.
Dónde encaja en la oferta de OpenAI
| Modelo | Ideal para | Limitación clave |
|---|
| DALL-E 2 | Arte conceptual básico | Fotorrealismo bajo |
| DALL-E 3 | Ilustraciones con estilo | Texto poco fiable en las imágenes |
| GPT Image 1.0 | Prompts fotorrealistas | Edición limitada |
| GPT Image 2.0 | Imágenes de alta fidelidad y editables | Costo por imagen más alto |
GPT Image 2.0 se posiciona ahora como la opción predeterminada para quienes integran flujos de trabajo de imágenes en aplicaciones de producción a través de la API de OpenAI, y reemplaza a DALL-E 3 en la mayoría de los pipelines serios. El salto en calidad de salida de DALL-E 3 a GPT Image 2.0 es la mayor mejora en una sola generación que OpenAI ha lanzado en el ámbito de las imágenes.
La diferencia de calidad se nota
Fotorrealismo sin artificialidad
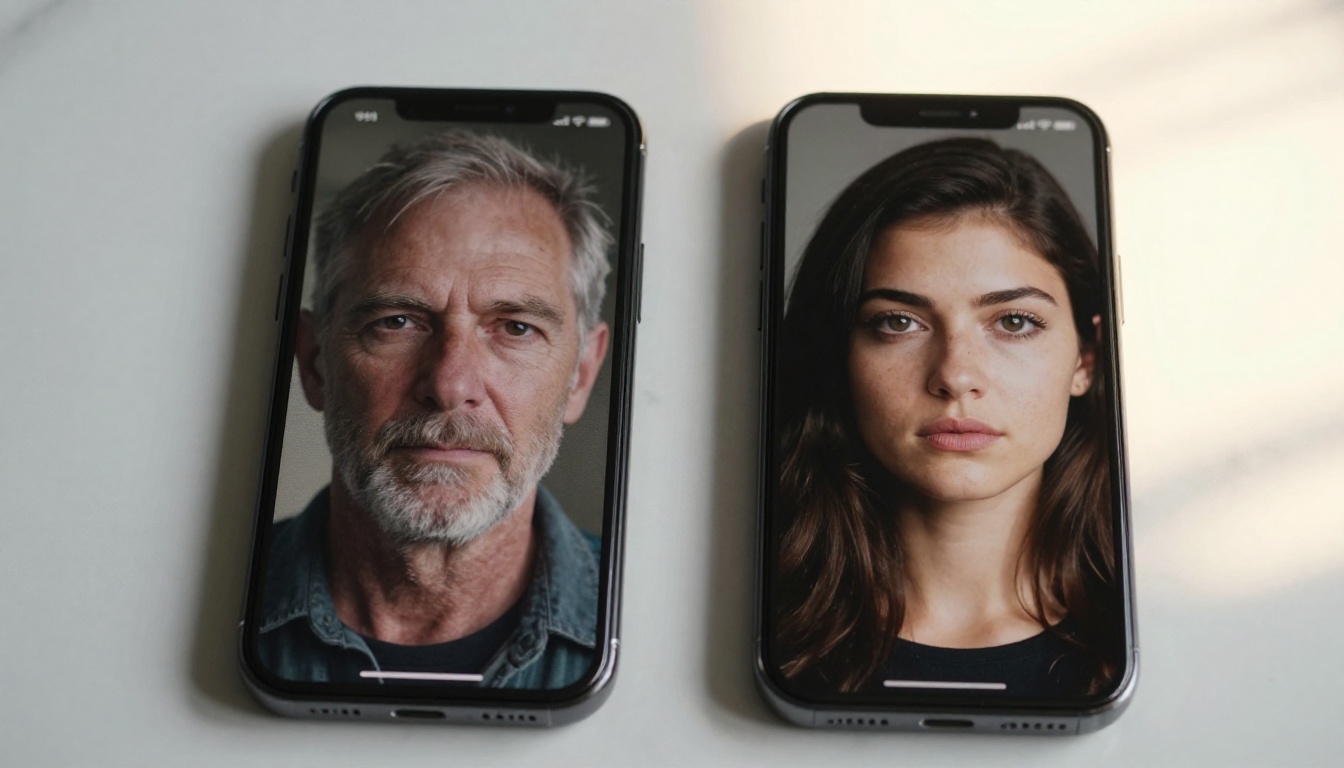
La mejora más evidente de inmediato es el fotorrealismo. Los resultados de GPT Image 2.0 parecen fotografías y no arte de IA. Los tonos de piel se renderizan con dispersión subsuperficial. Los mechones de pelo no se fusionan en masas en las sienes. La profundidad del fondo se desvanece de forma natural, con un desenfoque óptico convincente que imita el comportamiento de una lente real. Las texturas de las telas muestran patrones de tejido en lugar de degradados lisos.
Los modelos anteriores, incluido DALL-E 3, tenían puntos de fallo recurrentes que hacían fácil identificar la generación con IA con solo mirarla:
- Manos: dedos de más, nudillos fusionados, proporciones incorrectas
- Texto en las imágenes: caracteres ilegibles, ortografía incorrecta, tipografías irregulares
- Rostros de perfil: vistas laterales que deformaban la estructura facial o añadían artefactos
- Reflejos: superficies de espejo y cristal que no reflejaban la escena de forma lógica
- Multitudes: figuras de fondo que se convertían en manchas a medida que se alejaban
GPT Image 2.0 ha mejorado de forma notable los cinco modos de fallo. No es perfecto, y con escenas suficientemente complejas seguirás viendo artefactos. Pero la frecuencia de estos fallos es considerablemente menor, lo que significa menos generaciones desperdiciadas y menos trabajo de corrección manual.
💡 Consejo: Al pedir rostros fotorrealistas, especifica con precisión la configuración de iluminación (por ejemplo, "iluminación Rembrandt desde la izquierda, objetivo de retrato de 85 mm, f/1.8") en lugar de pedir vagamente "una foto realista". La especificidad sigue importando, y el modelo premia los prompts detallados con resultados notablemente mejores.
Precisión en los prompts bajo presión
Una de las quejas principales sobre los modelos anteriores era la deriva de los prompts: una descripción de escena compleja acababa con el modelo omitiendo o sustituyendo elementos. Pide "una mujer con un vestido rojo de pie junto a una bicicleta amarilla frente a una puerta azul" y con frecuencia obtendrás una mujer, quizá una bicicleta, pero los colores se desvían y la puerta desaparece o se transforma en otra cosa.
GPT Image 2.0 mantiene a la vez más elementos especificados. Esto se debe a que el modelo está más estrechamente acoplado a la capa de comprensión del lenguaje, y trata la generación de imágenes como una tarea de razonamiento en la que cada elemento del prompt debe tenerse en cuenta, en lugar de como una búsqueda por coincidencia de patrones que intenta encontrar la imagen de entrenamiento más parecida.
En la práctica, tu primera generación tiene más probabilidades de coincidir con lo que pretendes, lo que acorta los ciclos de iteración. En flujos de trabajo en los que generas en volumen, esto supone una reducción significativa del costo por resultado utilizable.
Lo nuevo en GPT Image 2.0
Por fin funciona el texto en las imágenes
Esta es la función que los profesionales creativos llevaban años esperando. GPT Image 2.0 puede renderizar texto legible y coherente en estilo dentro de las imágenes generadas. Logotipos, letreros, carteles, maquetas de interfaces, envases de productos, portadas de libros: todo esto ya sale con la ortografía correcta y una tipografía legible que aguanta a resolución completa.
El modelo admite:
- Renderizado de tipografías en negrita, cursiva y con serifa
- Texto con colores ajustados al fondo en escenas complejas
- Varios elementos de texto distintos en una misma imagen
- Caligrafía manual simulada y estilos de pizarra con tiza cuando se especifica
- Texto que sigue curvas o planos de perspectiva en la escena
💡 Consejo: Escribe entre comillas dobles cualquier texto que quieras que aparezca en la imagen dentro de tu prompt. Describe el estilo de la fuente junto a él ("sans-serif condensada en negrita en blanco", "letras escritas a mano con tiza sobre una pizarra oscura") para obtener mejores resultados. El modelo responde bien a las indicaciones tipográficas.
Edición de imágenes nativa integrada
GPT Image 2.0 admite la edición basada en instrucciones sin herramientas externas ni complementos. Pasas una imagen existente junto con una instrucción de texto, y el modelo modifica la zona indicada mientras conserva el resto. Esto cubre cuatro operaciones de edición distintas:
- Inpainting: rellena una zona enmascarada con contenido nuevo que se integra de forma natural con la escena existente
- Outpainting: amplía el lienzo de una imagen más allá de sus bordes originales en cualquier dirección
- Sustitución de objetos: cambia un elemento por otro manteniendo la iluminación, las sombras y el contexto que lo rodea
- Reiluminación: modifica la fuente de luz aparente, la hora del día o la temperatura de color de una fotografía existente
Esto acerca GPT Image 2.0 a un flujo de trabajo de edición de imágenes completo, de principio a fin. En lugar de generar, exportar a un editor externo, hacer ajustes y volver a importar, puedes trabajar en un único hilo de conversación con refinamientos progresivos. Para los equipos de contenido con necesidades de alto volumen, esto supone una simplificación importante del flujo de trabajo.
Entrada de varias imágenes como referencia
Una mejora estructural que distingue a GPT Image 2.0 de la mayoría de los competidores: ahora acepta varias imágenes como referencias de entrada y las sintetiza en un único resultado coherente. Si le pasas tres fotos de producto desde distintos ángulos, el modelo puede generar un ángulo nuevo o una toma de estilo de vida compuesta. Si pasas una imagen de referencia de estilo junto con una descripción escrita, el modelo aplicará la estética visual de la referencia a un contenido nuevo.
Esto resulta especialmente útil para la coherencia de marca, cuando ya tienes una identidad visual y quieres que el contenido generado se ajuste a ella en lugar de partir solo de una descripción de texto.
GPT Image 2.0 frente a la competencia
La comparativa sin adornos
El espacio de la IA de texto a imagen tiene ahora competencia real. Aquí tienes un desglose directo de las funciones que más importan en el uso práctico:
| Capacidad | GPT Image 2.0 | Flux Redux Dev | Stable Diffusion XL |
|---|
| Fotorrealismo | Excelente | Muy bueno | Bueno |
| Texto en las imágenes | Excelente | Bueno | Aceptable |
| Precisión en los prompts | Excelente | Muy bueno | Bueno |
| Edición nativa | Sí | Limitada | Mediante complementos |
| Entrada de varias imágenes | Sí | No | No |
| Acceso por API | Sí | Sí | Autoalojado |
| Costo por imagen | Medio | Bajo | Muy bajo |
| Velocidad de generación | Rápida | Muy rápida | Rápida |
| Ajuste fino | No | Limitado | Soporte LoRA completo |
Flux es el competidor más cercano en calidad de imagen pura. Sus resultados son a veces más flexibles en cuanto al estilo, y su velocidad de generación es mayor, lo que lo convierte en una opción sólida para el trabajo creativo iterativo. Donde GPT Image 2.0 gana con claridad es en la renderización de texto y en la precisión de los prompts con varios elementos.
Stable Diffusion XL sigue siendo la mejor opción para los equipos que necesitan despliegue local, control total del ajuste fino o el costo por imagen más bajo posible. Pero requiere infraestructura y una configuración técnica que GPT Image 2.0 simplemente no exige, lo que importa a equipos pequeños o a proyectos con plazos ajustados.
Dónde tiene dificultades GPT Image 2.0
Ser honesto con las limitaciones es importante:
- Coherencia de personajes: el mismo prompt no producirá dos veces el mismo rostro o la misma persona, lo que genera problemas en contenido seriado o continuo
- Prompts muy largos: los prompts que superan las 300 palabras a veces provocan conflictos entre elementos o pierden detalles concretos
- Costo a escala: en aplicaciones de alto volumen, el precio por imagen se acumula rápido frente a alternativas autoalojadas u optimizadas por lotes
- Sin ajuste fino: no puedes entrenar GPT Image 2.0 con tu propio conjunto de datos como sí puedes hacerlo con los flujos LoRA de Stable Diffusion
Si tu principal restricción es la coherencia de personajes o el control del presupuesto a gran volumen, las alternativas siguen teniendo ventajas reales.
Para desarrolladores: lo que importa aquí
Estructura y configuración de la API
GPT Image 2.0 es accesible a través de la API de OpenAI. El endpoint acepta prompts solo de texto para la generación estándar, texto más una imagen para la edición y la generación con referencias, y texto más varias imágenes para la síntesis con múltiples referencias.
Los formatos de respuesta incluyen URL directa y codificación base64. La generación suele completarse en 10 a 25 segundos, según la resolución de salida. La API admite tres tamaños de salida:
- 1024x1024: cuadrado, ideal para fotos de producto e imágenes de perfil
- 1792x1024: horizontal, perfecto para portadas de blog y cabeceras de redes sociales
- 1024x1792: vertical, pensado primero para formatos de dispositivos móviles y anuncios verticales
💡 Consejo: Para la mayoría de los flujos de trabajo de marketing de contenidos, pide 1792x1024 como tamaño predeterminado. La relación de aspecto más ancha da al modelo más espacio compositivo, y los resultados suelen tener mejor profundidad de escena que los recortes cuadrados.
Casos de uso que funcionan bien
Según pruebas propias, GPT Image 2.0 funciona de forma fiable para:
- Maquetas de producto: colocar imágenes de producto en contextos de estilo de vida o ambientales sin necesidad de una sesión de fotos en estudio completa
- Elementos visuales de marketing de contenidos: portadas de blog, publicaciones en redes sociales, cabeceras de boletines por correo electrónico
- Recursos para maquetas de UI y UX: capturas de apps, contenido de interfaces, recursos gráficos para tiendas de aplicaciones
- Exploración de identidad de marca: conceptos de logotipo, visualización de paletas de color, tableros de dirección visual
- Ilustración editorial: visuales para artículos de noticias, gráficos explicativos de datos, imágenes para artículos de opinión
- Conceptos de diseño de envases: diseños de etiquetas, cajas con texto real legible
- Visuales inmobiliarios y de interiorismo: imágenes de home staging, conceptos de reforma, previsualizaciones arquitectónicas
La combinación de una renderización de texto fiable y un buen seguimiento de instrucciones lo hace especialmente eficaz para cualquier trabajo que combine texto e imagen, lo que abarca buena parte del marketing y de la industria editorial.
Usar GPT Image 2.0 en PicassoIA
Paso a paso con la plataforma
El modelo PicassoIA Image funciona con tecnología GPT Image, lo que te da acceso directo a sus capacidades de generación sin configurar ninguna API, ninguna facturación ni ningún trabajo de desarrollo. Así se usa, paso a paso:
Paso 1: Abre el modelo
Ve a PicassoIA Image dentro de la colección de texto a imagen. La interfaz se carga con un campo de prompt limpio y opciones de configuración.
Paso 2: Escribe un prompt específico
Sé preciso sobre lo que quieres. Incluye:
- Descripción del sujeto (quién o qué, detalles físicos)
- Escenario y entorno (lugar, hora del día, estación)
- Condiciones de iluminación (dirección, calidad, temperatura de color)
- Perspectiva de cámara y características del objetivo
- Cualquier texto que deba aparecer en la imagen (entre comillas dobles)
Paso 3: Elige tu relación de aspecto
Para contenido horizontal de blog y redes sociales, 16:9 es la opción correcta. El cuadrado funciona bien para imágenes de perfil y miniaturas.
Paso 4: Genera e itera
Tu primer resultado a menudo se parecerá bastante a lo que buscas. Al refinarlo, cambia una variable cada vez en lugar de reescribir todo el prompt. Aislar la variable facilita ver a qué está respondiendo el modelo.
Paso 5: Edita con PicassoIA Image Editor Pro
Una vez que tengas una imagen base sólida, pasa a Image Editor Pro para hacer ajustes concretos, inpainting de zonas específicas o ampliación del lienzo. Esto refleja cómo funciona la edición nativa de GPT Image 2.0 y te da un flujo de trabajo completo y no destructivo sin salir de la plataforma.
💡 Consejo: En las imágenes de estilo de vida con personas, describe de forma explícita la ropa y la textura de la piel. Las descripciones genéricas del sujeto producen resultados genéricos. La especificidad en la descripción del personaje es la palanca más importante para la calidad del resultado.
Otros modelos que vale la pena probar
PicassoIA aloja una amplia gama de modelos de texto a imagen. Si necesitas más variedad de estilos de la que produce GPT Image, Flux Redux Dev ofrece generación rápida con una gran amplitud creativa. Para los equipos que quieren entrenar con sus propias imágenes de referencia y crear un estilo de casa coherente, el P Image Trainer gestiona el entrenamiento personalizado de tipo LoRA desde la interfaz de la plataforma.
Para un flujo de trabajo combinado de generación y edición en una sola herramienta, PicassoIA Image Editor Pro resulta especialmente útil cuando importa la velocidad de iteración. Generas, ajustas, vuelves a generar y refinas sin cambiar de herramienta ni exportar archivos en cada etapa.
El veredicto tras el primer uso
GPT Image 2.0 es el modelo de generación de imágenes más preparado para producción que OpenAI ha lanzado. La mejora en la renderización de texto, por sí sola, justifica evaluarlo en cualquier flujo de trabajo que incluya imágenes con palabras, que es buena parte del marketing de contenidos, el diseño de producto y la edición. Las mejoras en el seguimiento de instrucciones significan menos generaciones desperdiciadas. La integración nativa de la edición significa menos idas y vueltas por software externo.
No es la opción más barata. No sustituirá a los flujos de Stable Diffusion con ajuste fino para equipos que necesitan una identidad de personaje persistente en una serie. Pero para la creación de contenido de uso general a escala, la calidad de salida en relación con el esfuerzo invertido, incluido el que se dedica a corregir las malas generaciones, favorece a GPT Image 2.0 en la mayoría de los escenarios.
La forma más rápida de formarte tu propia opinión es probar un prompt que ya hayas usado con DALL-E 3 o con una herramienta de generación anterior. La diferencia de calidad de un prompt bien construido se verá de inmediato.
Empieza a experimentar con PicassoIA Image y aplica la misma precisión en los prompts que usarías para cualquier brief creativo profesional. El modelo premia la especificidad, y los resultados lo demostrarán.