تبدو الصورة كأنها التُقطت بكاميرا Canon في ضوء بعد الظهر. ملمس البشرة حقيقي. الظل تحت الذقن يقع بشكل طبيعي. لكن لم يكن هناك أي مصوّر، ولم يقف أي عارض أمام الكاميرا، ولم يُستأجر أي استوديو. صنعتها آلة، في ثوانٍ، من سطر نصي واحد.
هذا ما تفعله مولّدات الصور بالذكاء الاصطناعي اليوم، وقد تجاوزت النتائج عتبة تجعل الناس يتوقفون فعلًا ويتساءلون عمّا ينظرون إليه. ومعرفة كيفية حدوث ذلك أكثر إثارة للاهتمام من النتائج نفسها.
ماذا يحدث فعليًا عندما تكتب أمرًا نصيًا
يعتقد معظم الناس أن الذكاء الاصطناعي "يرسم" شيئًا عند تلقّيه أمرًا نصيًا. الواقع أكثر رياضية، وأكثر شاعرية بطريقة غريبة.
عندما تكتب "امرأة تقف بجوار نافذة في الساعة الذهبية"، لا يبحث النظام في مكتبة من الصور، ولا يعيد مزج صور موجودة بكسلًا بكسل. بل يحوّل كلماتك إلى متجهات عددية، ويفسّر هذه المتجهات كشروط في فضاء رياضي عالي الأبعاد، ثم ينحت صورة من الضوضاء، شيئًا فشيئًا، حتى تقترب من ما يطابق تلك الشروط.
من الكلمات إلى الأرقام
تتمثل الخطوة الأولى في مشفّر النصوص، وعادةً ما يكون CLIP (Contrastive Language-Image Pretraining) أو نموذج محوّلات (transformer) مشابه. تدرّب CLIP على مئات الملايين من أزواج الصور والنصوص، فتعلّم أي الكلمات والعبارات تميل إلى الظهور بجانب أي أنواع من المحتوى البصري.
عندما يدخل أمرك النصي إلى المشفّر، تُربط كل كلمة وعبارة بنقطة في فضاء متجهات عالي الأبعاد. تساهم "نافذة"، و"الساعة الذهبية"، و"امرأة"، و"تقف" جميعًا بقيم موضعية تشكّل معًا إشارة الشرط، وهي بصمة رقمية لنيتك الإبداعية.
💡 كلما كان أمرك النصي أغنى وأكثر تحديدًا، أصبحت هذه البصمة أدق. فعبارة "عدسة بورتريه 85mm f/1.4، بوكيه ناعم، Kodak Portra 400" ليست مجرد زخرفة لغوية. إنها تحرّك إشارة الشرط نحو منطقة محددة في الفضاء البصري.
مفهوم الفضاء الكامن
بدلًا من العمل على البكسلات بدقتها الكاملة، تعمل مولّدات الصور الحديثة بالذكاء الاصطناعي في الفضاء الكامن، وهو تمثيل رياضي مضغوط للصور. قد تُشفَّر صورة بحجم 512×512 إلى موتر كامن بحجم 64×64 مع 4 قنوات. هذا يخفّض التكلفة الحاسوبية بنحو 64 مرة مع الحفاظ على البنية الأساسية للصورة.
يتولى هذا الضغط المشفّر التلقائي المتغيّر (VAE)، وله جزءان: مشفّر يضغط الصور الحقيقية إلى موترات كامنة، وفكّ تشفير يحوّل الموترات الكامنة مجددًا إلى صور بدقة كاملة. يجري كل العمل الثقيل للتوليد في هذا الفضاء الكامن المدمج، ثم يُفكّ تشفيره في النهاية.
نماذج الانتشار بتبسيط
يبدو مصطلح "نموذج الانتشار" معقدًا، لكن الفكرة الأساسية بديهية بشكل مدهش بمجرد أن ترى ما يفعله فعلًا.
إضافة الضوضاء ثم إزالتها
أثناء التدريب، يرى النموذج صورة فوتوغرافية حقيقية. ثم، في عملية مضبوطة، يضيف نظام التدريب ضوضاء غاوسية عشوائية إلى الصورة، خطوة بعد خطوة، عبر مئات الخطوات الزمنية، حتى تُدفن الصورة الأصلية تمامًا تحت ضجيج خالص. مهمة النموذج أن يتعلم كيفية عكس هذه العملية، أي أن يتنبأ بما أُزيل في كل خطوة.
بعد التدريب على مليارات أزواج الصورة والضوضاء، يصبح النموذج بارعًا جدًا في شيء واحد: التنبؤ بالضوضاء التي يجب طرحها من صورة مشوّشة لتبدو أقرب قليلًا إلى شيء حقيقي.
💡 هذه هي الفكرة الجوهرية. النموذج لا "يتخيّل" الصور من الصفر. يبدأ من ضوضاء عشوائية ويزيل الضوضاء خطوة بعد خطوة، موجَّهًا بشروط نصك. كل خطوة تجعل الصورة أكثر تماسكًا قليلًا.
حلقة إزالة الضوضاء
عند التشغيل، حين تولّد صورة، تسير العملية بالاتجاه المعاكس:
- ابدأ بضوضاء غاوسية خالصة
- أدخل الضوضاء مع الخطوة الزمنية الحالية وشروط النص إلى النموذج
- يتنبأ النموذج بالضوضاء الواجب إزالتها
- اطرح تلك الضوضاء لتحصل على موتر كامن أنظف قليلًا
- كرّر العملية من 20 إلى 50 مرة حتى تظهر صورة واضحة
- فكّ تشفير الموتر الكامن النهائي عبر VAE
يؤثر عدد الخطوات، وجدول الضوضاء (أي مدى قوة إزالة الضوضاء)، ومقياس التوجيه في النتيجة النهائية. الخطوات الأقل تنتج صورًا أسرع لكنها أحيانًا أقل تماسكًا. أما مقياس التوجيه الأعلى فيقرّب الصورة من الأمر النصي، لكنه قد يقلل من الطبيعية.
كيف يتحكم نصك في الصورة
عملية إزالة الضوضاء وحدها ستنتج صورًا تبدو عشوائية. سرّ المخرجات الواقعية يكمن في طريقة نسج شروط النص في كل خطوة.
CLIP ومشفّرات النصوص
ينتج مشفّر النص متجهات تضمين تسافر مع الصورة طوال عملية إزالة الضوضاء. في كل خطوة، يستطيع النموذج أن "يتحقق" من شكل الموتر الكامن المشوّش الحالي مقارنةً بتضمين النص، ثم يعدّل وفقًا لذلك.
تستخدم البنى الأحدث، مثل تلك المعتمدة في Flux Dev وStable Diffusion 3.5 Large، مشفّرات نصوص مزدوجة أو ثلاثية. فهي تجمع بين CLIP وT5، وهو مشفّر من نماذج لغوية كبيرة، ما يمنح النظام فهمًا أعمق بكثير للغة. لهذا تتعامل النماذج الأحدث مع الأوامر المعقدة التي تتضمن عدة أشخاص وعلاقات بينهم بشكل أفضل بكثير من الإصدارات السابقة من Stable Diffusion.
الانتباه المتقاطع في العمل
الآلية التي تربط النص بالصورة تُسمّى الانتباه المتقاطع. داخل شبكة إزالة الضوضاء، يستطيع كل موضع مكاني في الموتر الكامن للصورة أن "ينتبه" إلى أجزاء مختلفة من تضمين النص.
تخيّل الأمر كأن النموذج يسأل، عند كل موضع بكسل: "بالنظر إلى شكل هذه المنطقة الآن، وبالنظر إلى ما يقوله الأمر النصي، أي ضوضاء ينبغي أن أزيل هنا؟"
تميل خرائط الانتباه المتقاطع إلى التوافق بديهيًا. المنطقة المقابلة لكلمة "امرأة" في الأمر النصي تنشط بقوة فوق الوجه والجسم في الصورة، والمنطقة المقابلة لكلمة "نافذة" تنشط فوق الخلفية. هذا التوافق المكاني هو ما ينتج صورًا تظهر فيها العناصر في أماكنها الصحيحة بدلًا من توزيعها عشوائيًا على الإطار.
لماذا تبدو بعض المخرجات أكثر واقعية
ليست كل النماذج تنتج الدرجة نفسها من الواقعية الفوتوغرافية. هناك عدة عوامل تفسّر هذا الفارق.
لحجم بيانات التدريب أهمية
النموذج الذي يُدرَّب على 2 مليار زوج من الصور والنصوص سينتج مخرجات أكثر واقعية من نموذج دُرِّب على 100 مليون، بافتراض أن البنية متقاربة. فالبيانات الأكثر تعني أن النموذج رأى حالات أطراف أكثر، وظروف إضاءة أكثر، وألوان بشرة أكثر، وعيوبًا تقنية أكثر للكاميرات، وملمسًا أكثر من العالم الحقيقي.
يمثّل Imagen 4 Ultra وFlux 1.1 Pro Ultra الطرف ذا حجم البيانات الكبير في هذا الطيف. تُظهر مخرجاتهما بدقة 4 ميغابكسل مستوى من تفاصيل الملمس الدقيقة، بما في ذلك خيوط الأقمشة الفردية، والتشتت الضوئي تحت سطح البشرة بواقعية، وبوكيه العدسة الأصيل، وهي أمور لم تستطع النماذج السابقة إنتاجها.
الضبط الدقيق للواقعية الفوتوغرافية
حتى بعد التدريب الأساسي، تخضع نماذج كثيرة لضبط دقيق إضافي على مجموعات مختارة من الصور الفوتوغرافية عالية الجودة. Realistic Vision v5.1 هو نسخة مضبوطة من Stable Diffusion دُرّبت خصيصًا على تصوير البورتريه الفوتوغرافي الواقعي. أما RealVisXL v3.0 Turbo فيوسّع SDXL بتدريب موجَّه مشابه.
يتيح الضبط الدقيق للنموذج أن يوجّه توزيع مخرجاته نحو خصائص الصور الفوتوغرافية الحقيقية: الضوضاء الطبيعية، وعمق الميدان الضحل، والتدرجات اللونية الأصيلة، والعيوب الدقيقة التي تجعل الصورة تبدو مُلتقطة لا مُصنّعة.
تقنية أخرى، هي DPO (التحسين المباشر للتفضيل) أو RLHF (التعلم المعزز من التغذية الراجعة البشرية)، وتقوم على تدريب النموذج على تقييمات بشرية لجودة الصور. النماذج المدرّبة بهذه الطريقة تتعلم تفضيل المخرجات التي يصنّفها البشر على أنها أكثر واقعية وأكثر جاذبية بصريًا، ما يخلق حلقة تغذية راجعة تضيّق الفجوة مع التصوير الفوتوغرافي الحقيقي.
أفضل نماذج الذكاء الاصطناعي الواقعية حاليًا
ينقسم الجيل الحالي من النماذج الواقعية إلى فئتين عريضتين: نماذج عامة الغرض تنتج مخرجات واقعية ضمن أنماط أخرى، ونماذج مضبوطة بدقة ومحسّنة خصيصًا لنتائج تشبه التصوير الفوتوغرافي.
عامة الغرض مع قوة في الواقعية:
- Flux 2 Pro يتعامل مع الإدخال النصي والتوليد المعتمد على صورة مرجعية، وينتج مخرجات ذات تماسك فوتوغرافي قوي. ممتاز للموضوعات التي تحمل ملمسًا من العالم الحقيقي.
- Ideogram v3 Quality ينتج شخصيات بشرية واقعية بتشريح موثوق بشكل خاص، وهو أحد أصعب المشكلات بالنسبة إلى النماذج السابقة.
- Seedream 4 ينتج مخرجات بدقة 4K أصلية، ما يجعل الصور ذات الطابع الفوتوغرافي للمناظر الطبيعية والعمارة تبدو كبيرة الحجم فعلًا.
مضبوطة بدقة للتصوير الفوتوغرافي:
- Realistic Vision v5.1 ما زال من أكثر النماذج موثوقية لتصوير البورتريه الواقعي، خصوصًا ملمس البشرة وتفاصيل الشعر.
- RealVisXL v3.0 Turbo يضيف السرعة إلى الواقعية، ما يجعله عمليًا للتكرار السريع. المخرجات بدقة SDXL مقنعة باستمرار.
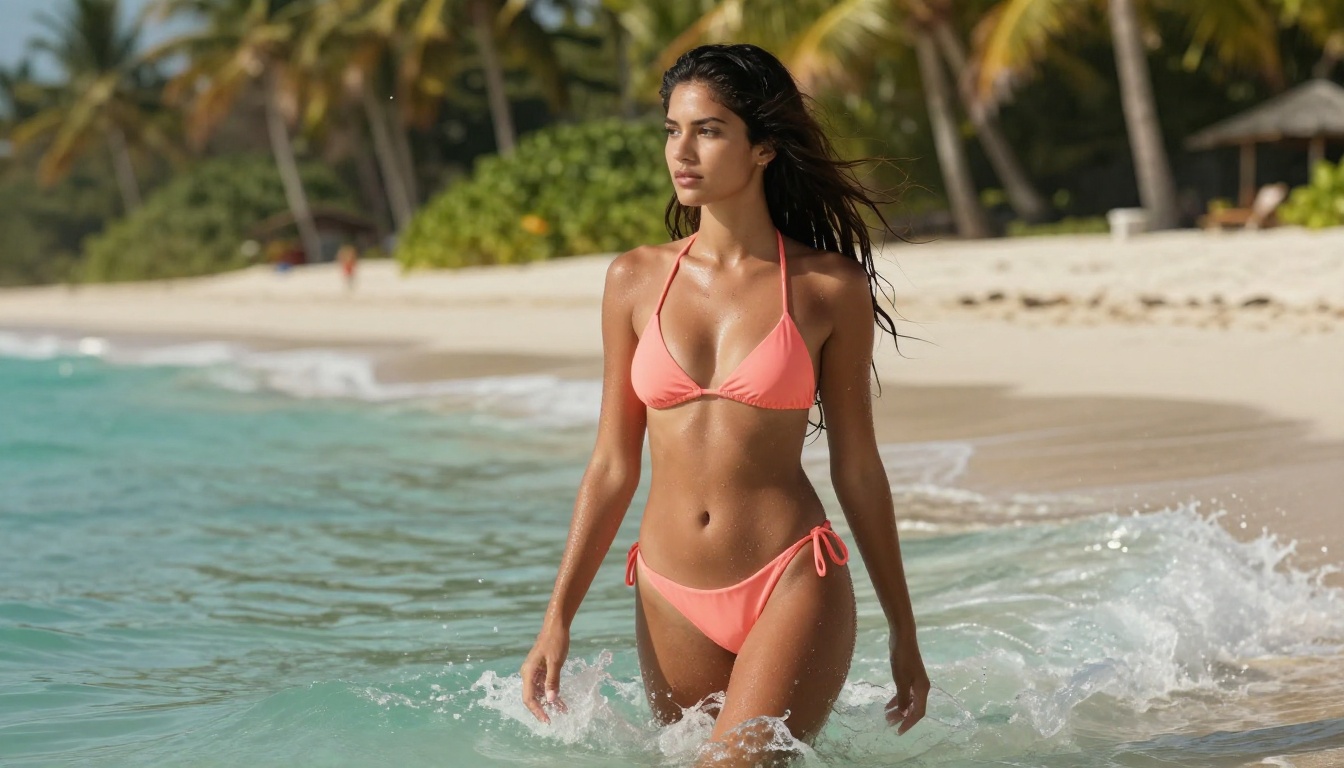
بالنسبة إلى من يريدون رفع الدقة أكثر بعد التوليد، يمكن لدمج أي من هذه النماذج مع معالجة لاحقة لرفع الدقة أن يحوّل مخرجات 1024 بكسل إلى جودة صالحة للطباعة. ويستحق Flux Schnell الإشارة هنا أيضًا: فتوليده بأربع خطوات يجعله سريعًا بما يكفي لتجربة الأفكار التكوينية قبل الالتزام بتشغيل كامل الجودة على نموذج أثقل.
أوامر نصية تنتج صورًا تبدو حقيقية
معرفة طريقة عمل التقنية توضّح لماذا تنتج أنماط معينة من الأوامر النصية نتائج أكثر واقعية باستمرار.
للكاميرا والعدسة تفاصيل تؤثر
عندما تكتب "Canon EOS R5، 85mm f/1.4، فتحة f/2.0" في أمر نصي، فأنت لا تزيّن طلبك. أنت تحرّك إشارة الشرط نحو منطقة من توزيع النموذج المتعلَّم المرتبطة بتصوير الكاميرات الحقيقي. تحتوي بيانات التدريب على عدد لا يُحصى من الصور التي تتضمن أوصاف بيانات EXIF في تعليقاتها، لذا تؤثر هذه المصطلحات فعلًا في المخرجات.
أوصاف العدسات التي تساعد باستمرار:
- البعد البؤري: 35mm (أوسع، لتصوير البيئة)، و85mm (للبورتريه، مع ضغط خفيف)، و135mm (تليفوتو، مع فصل قوي عن الخلفية)
- الفتحة: من f/1.4 إلى f/2.8 تُنتج عمق ميدان ضحلًا واضحًا
- نوع الفيلم: Kodak Portra 400 وFujifilm Pro 400H وKodak Ektar 100، وكل منها يدفع لوحة الألوان في اتجاه مختلف
تعليمات الإضاءة التي تساعد
واصفات الإضاءة من أقوى الأدوات للواقعية الفوتوغرافية. تعلّم النموذج أن يربط عبارات محددة بجودة ضوء محددة:
| عبارة الإضاءة | التأثير |
|---|
| "ضوء صباحي حجمي من اليسار" | اتجاهي، بجودة الساعة الذهبية مع أشعة مرئية |
| "ضوء ناعم منتشر بسبب الغيوم" | تعريض مسطح ومتساوٍ دون ظلال حادة |
| "ضوء عملي من شاشة الحاسوب المحمول" | إضاءة تعبئة زرقاء باردة، محيطية داخلية |
| "ضوء خلفي (Rim light)" | توهج لصورة الشخص الظلية، يفصله عن الخلفية |
| "ضوء النافذة، مع خط ظل حاد" | إضاءة جانبية درامية، تباين قوي |
💡 كلما وصفت اتجاه الضوء، ودرجة حرارة اللون، وجودته (حادّ أم ناعم) بدقة أكبر، استطاع نظام الانتباه المتقاطع لدى النموذج أن يوائم الإضاءة المكانية في صورتك مع تلك الشروط.
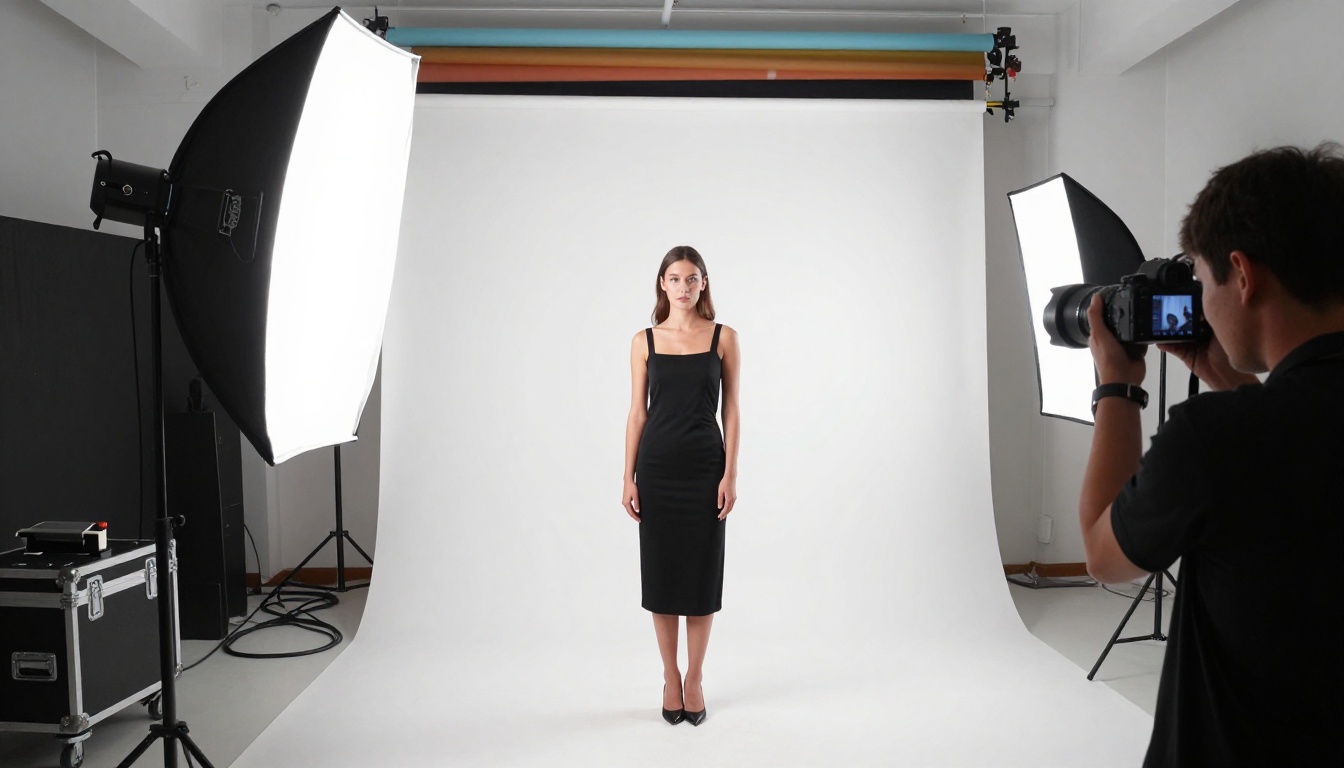
الأمر النصي السلبي لا يقل أهمية. فإخبار النموذج صراحةً بتجنّب "رسم توضيحي، كرتون، فن رقمي، CGI، تصيير ثلاثي الأبعاد، لوحة" يدفعه بعيدًا عن التفسيرات الفنية ونحو التفسيرات الفوتوغرافية. بعض النماذج، مثل Flux 1.1 Pro Ultra والإصدارات الأحدث من Flux، قوية بما يكفي لتقليل تأثير الأوامر السلبية الخاصة بالأسلوب، لكنها أساسية بالنسبة إلى نماذج SD الأقدم.
ما الذي ما زال يكشف صور الذكاء الاصطناعي
رغم التقدم، لا تزال نماذج الذكاء الاصطناعي الحالية تعاني من نقاط ضعف مستمرة. ومعرفتها مهمة سواء لتحسين أوامرك النصية أو لاكتشاف الصور المولّدة.
نقاط الفشل الشائعة:
- الأيدي: أخطاء في عدد الأصابع وزوايا مفاصل غير طبيعية ما زالت شائعة في النماذج الأدنى مستوى
- النص داخل الصور: تميل الكلمات إلى أن تكون مشوّهة أو أحرفًا مخترعة، رغم أن نماذج مثل Ideogram v3 Quality حلّت هذه المشكلة إلى حد كبير
- الخلفيات المعقدة: مشاهد الشوارع المزدحمة أو الحشود غالبًا ما تُظهر تناقضات بنيوية عند الفحص المدقق
- الانعكاسات: المرايا والنظارات وانعكاسات الماء كثيرًا ما تحتوي على محتوى مستحيل فيزيائيًا
- التماثل: قد ينحرف التماثل الثنائي في الوجوه والأشياء أحيانًا، فتبدو إحدى العينين مختلفة قليلًا عن الأخرى
لا شيء من هذه القيود متأصل في المنهج نفسه. فقد تراجع كل منها بشكل كبير عبر أجيال النماذج، والعديد من النماذج المتخصصة تعالج نقاط ضعف بعينها بكفاءة الآن. والاتجاه العام يسير نحو صور تحتاج إلى تحليل جنائي لكي تُعرف بأنها مولّدة بالذكاء الاصطناعي.
أنشئ صورك الواقعية الخاصة
الآليات التي تقف وراء كل هذا معقدة، لكن استخدام هذه النماذج لا يتطلب معالجة أي شيء منها. الأهم هو الوصول إلى نماذج مدرّبة جيدًا ومعرفة ما تطلبه.
كل نموذج ذُكر في هذا المقال متاح على PicassoIA، حيث يمكنك التبديل بينها فورًا دون أي إعداد. هل تريد جودة التصوير الوثائقي في Realistic Vision v5.1؟ بدّل. هل تريد سقف الدقة البالغ 4 ميغابكسل في Flux 1.1 Pro Ultra؟ نقرة واحدة. تضم مجموعة تحويل النص إلى صورة 91 نموذجًا، تشمل خيارات فائقة السرعة مثل Flux Schnell للتكرار السريع، وخيارات عالية الدقة للمخرجات النهائية.
ابدأ بمشهد بسيط قد تلتقط صورته فعلًا لو كانت لديك المعدات. أضف تفاصيل الإضاءة. حدّد الكاميرا والعدسة. اذكر نوع الفيلم. شغّله على Flux Dev أو RealVisXL v3.0 Turbo وقارن. ثم شغّل الأمر النصي نفسه على Imagen 4 Ultra وانظر كيف يبدو سقف بيانات التدريب لنموذج بحجم Google.
السؤال عن كيفية إنشاء مولّدات الصور بالذكاء الاصطناعي لصور واقعية له جواب مُرضٍ: هي لا تخلق من العدم. إنها تتعلم الشكل الإحصائي للواقع من مليارات الأمثلة، ثم تتتبع طريقها عائدةً من الضوضاء إلى شيء يطابق الأنماط التي تعلّمتها. كلما زادت البيانات، وتحسّنت البنية، وازداد تحديد أمرك النصي، اقتربت النتيجة من أن تصبح غير قابلة للتمييز عن الشيء الحقيقي.


