L’image ressemble à une photo prise avec un appareil Canon, en lumière d’après-midi. La texture de la peau est réaliste. L’ombre sous le menton tombe naturellement. Pourtant, aucun photographe n’était là, aucun modèle n’a posé, aucun studio n’a été loué. Une machine l’a créée en quelques secondes, à partir d’une simple ligne de texte.
C’est ce que font aujourd’hui les générateurs d’images IA, et les résultats ont franchi un seuil qui pousse les gens à s’arrêter vraiment et à se demander ce qu’ils regardent. Comprendre comment cela se produit est plus intéressant que les résultats eux-mêmes.
Ce qui se passe vraiment quand vous tapez un prompt
La plupart des gens pensent que l’IA « dessine » quelque chose lorsqu’on lui donne un prompt textuel. La réalité est plus mathématique et, d’une certaine manière, plus poétique.
Quand vous tapez « une femme debout devant une fenêtre à l’heure dorée », le système ne cherche pas dans une bibliothèque de photos et ne remixe pas des images existantes pixel par pixel. Il encode vos mots sous forme de vecteurs numériques, interprète ces vecteurs comme des conditions dans un espace mathématique à haute dimension, puis sculpte une image à partir du bruit en la faisant évoluer progressivement vers quelque chose qui correspond à ces conditions.
Des mots aux nombres
La première étape repose sur un encodeur de texte, généralement CLIP (Contrastive Language-Image Pretraining) ou un modèle transformer similaire. CLIP a été entraîné sur des centaines de millions de paires image-texte, apprenant quels mots et expressions ont tendance à apparaître avec quels types de contenu visuel.
Lorsque votre prompt entre dans l’encodeur, chaque mot et chaque expression est projeté en un point d’un espace vectoriel à haute dimension. « Fenêtre », « heure dorée », « femme » et « debout » apportent chacun des valeurs de position qui forment ensemble un signal de conditionnement, une empreinte numérique de votre intention créative.
💡 Plus votre prompt est riche et précis, plus cette empreinte devient précise. « Objectif portrait 85 mm f/1.4, bokeh doux, Kodak Portra 400 » n’est pas un simple habillage. Cela déplace le signal de conditionnement vers une zone précise de l’espace visuel.
Le concept d’espace latent
Plutôt que de travailler avec des pixels en pleine résolution, les générateurs d’images IA modernes opèrent dans un espace latent, une représentation mathématique compressée des images. Une image de 512x512 peut être encodée dans un tenseur latent de 64x64 avec 4 canaux. Cela réduit le coût de calcul d’environ 64 fois tout en préservant la structure essentielle de l’image.
Cette compression est gérée par un auto-encodeur variationnel (VAE), qui comporte deux parties : un encodeur qui compresse les images réelles en tenseurs latents, et un décodeur qui reconvertit ces tenseurs latents en images en pleine résolution. Tout le travail de génération lourd se fait dans cet espace latent compact, puis le résultat est décodé à la fin.
Les modèles de diffusion expliqués simplement
L’expression « modèle de diffusion » semble complexe, mais l’idée centrale est étonnamment intuitive une fois qu’on voit ce qu’il fait réellement.
Ajouter du bruit, puis l’enlever
Pendant l’entraînement, le modèle voit une photographie réelle. Ensuite, dans un processus contrôlé, le système d’entraînement ajoute un bruit gaussien aléatoire à cette image, étape par étape, sur des centaines de pas de temps, jusqu’à ce que l’image originale soit complètement enfouie sous un pur bruit blanc. La tâche du modèle est d’apprendre à inverser ce processus, c’est-à-dire à prédire ce qui a été retiré à chaque étape.
Après un entraînement sur des milliards de paires image-bruit, le modèle devient extrêmement efficace dans une seule tâche : prédire quel bruit soustraire d’une image bruitée pour la rendre un peu plus proche de quelque chose de réel.
💡 C’est le principe central. Le modèle n’« imagine » pas les images à partir de rien. Il part d’un bruit aléatoire et retire du bruit, étape par étape, tout en étant guidé par votre conditionnement textuel. Chaque étape rend l’image un peu plus cohérente.
La boucle de débruitage
Au moment de l’inférence, lorsque vous générez une image, le processus se déroule à l’envers :
- Partir d’un bruit gaussien pur
- Transmettre au modèle le bruit, le pas de temps courant et le conditionnement textuel
- Le modèle prédit le bruit à retirer
- Soustraire ce bruit pour obtenir un latent un peu plus propre
- Répéter de 20 à 50 fois jusqu’à l’apparition d’une image nette
- Décoder le latent final via le VAE
Le nombre d’étapes, le calendrier de bruit (la vitesse à laquelle vous retirez le bruit) et le guidance scale influencent tous le résultat final. Moins d’étapes donnent des images plus rapides mais parfois moins cohérentes. Un guidance scale plus élevé rapproche l’image du prompt, mais peut réduire son naturel.
Le processus de débruitage seul ne produirait que des images d’apparence aléatoire. La magie du rendu réaliste vient de la façon dont le conditionnement textuel est intégré à chaque étape.
CLIP et encodeurs de texte
L’encodeur de texte produit des vecteurs d’embedding qui accompagnent l’image tout au long du processus de débruitage. À chaque étape, le modèle peut « vérifier » à quoi ressemble le latent bruité actuel par rapport à l’embedding textuel, et ajuster en conséquence.
Des architectures plus récentes, comme celles utilisées dans Flux Dev et Stable Diffusion 3.5 Large, utilisent deux ou trois encodeurs de texte. Elles combinent CLIP avec T5, un encodeur de grand modèle de langage, ce qui offre au système un traitement du langage beaucoup plus profond. C’est pourquoi les modèles récents gèrent bien mieux les prompts complexes, avec plusieurs sujets et relations, que les versions antérieures de Stable Diffusion.
L’attention croisée en action
Le mécanisme qui relie le texte à l’image s’appelle attention croisée. Dans le réseau de débruitage, chaque zone spatiale du latent de l’image peut « prêter attention » à différentes parties de l’embedding textuel.
Imaginez le modèle se demandant, à chaque position de pixel : « Compte tenu de l’apparence actuelle de cette zone et de ce que dit le prompt, quel bruit dois-je retirer ici ? »
Les cartes d’attention croisée tendent à s’aligner de façon intuitive. La zone correspondant à « femme » dans le prompt s’active fortement sur le visage et le corps de l’image. La zone de « fenêtre » s’active sur l’arrière-plan. Cet alignement spatial permet d’obtenir des images où les éléments apparaissent au bon endroit, et non répartis au hasard dans le cadre.
Pourquoi certains rendus paraissent plus réels
Tous les modèles n’offrent pas la même qualité de photoréalisme. Plusieurs facteurs expliquent l’écart.
Le volume des données d’entraînement compte
Un modèle entraîné sur 2 milliards de paires image-texte produira un rendu plus réaliste qu’un modèle entraîné sur 100 millions, à architecture comparable. Plus de données signifient que le modèle a vu davantage de cas limites, davantage de conditions d’éclairage, davantage de teintes de peau, davantage d’artefacts d’appareils photo et davantage de textures du monde réel.
Imagen 4 Ultra et Flux 1.1 Pro Ultra représentent l’extrémité à fort volume de données de ce spectre. Leurs rendus en 4 MP montrent un niveau de détail fin, avec des fils de tissu individuels, une diffusion sous-cutanée réaliste de la peau et un bokeh d’objectif authentique, que les modèles précédents ne pouvaient pas produire.
Le fine-tuning pour le photoréalisme
Même après l’entraînement de base, de nombreux modèles passent par un fine-tuning supplémentaire sur des jeux de données sélectionnés de photographies de haute qualité. Realistic Vision v5.1 est une version affinée de Stable Diffusion, entraînée spécifiquement sur des photographies de portraits photoréalistes. RealVisXL v3.0 Turbo étend SDXL avec un entraînement ciblé similaire.
Le fine-tuning permet au modèle d’orienter sa distribution de sortie vers les caractéristiques des photographies réelles : bruit naturel, faible profondeur de champ, dominantes de couleur authentiques et micro-imperfections qui donnent à une image l’impression d’avoir été prise plutôt que fabriquée.
Une autre technique, DPO (Direct Preference Optimization) ou RLHF (Reinforcement Learning from Human Feedback), consiste à entraîner le modèle sur des évaluations humaines de la qualité des images. Les modèles entraînés ainsi apprennent à privilégier les rendus que les humains jugent plus réalistes et plus agréables à regarder, créant une boucle de rétroaction qui réduit l’écart avec la photographie réelle.
Les meilleurs modèles d’IA réalistes du moment
La génération actuelle de modèles photoréalistes se divise en deux grandes catégories : les modèles polyvalents capables de produire du photoréalisme parmi d’autres styles, et les modèles affinés, optimisés spécifiquement pour des résultats proches de la photographie.
Polyvalents avec un point fort en photoréalisme :
- Flux 2 Pro accepte à la fois un texte en entrée et une génération à partir d’une image de référence, avec un rendu à forte cohérence photographique. Excellent pour les sujets à texture réelle.
- Ideogram v3 Quality produit des figures humaines réalistes avec une anatomie particulièrement fiable, l’un des problèmes les plus difficiles pour les modèles précédents.
- Seedream 4 génère en 4K natif, ce qui donne aux photos de paysage et d’architecture une vraie allure de grand format.
Affinés pour la photographie :
- Realistic Vision v5.1 reste l’un des modèles les plus fiables pour la photographie de portrait réaliste, en particulier pour la texture de la peau et le détail des cheveux.
- RealVisXL v3.0 Turbo ajoute de la rapidité au photoréalisme, ce qui le rend pratique pour itérer rapidement. Le rendu à la résolution SDXL reste constamment convaincant.
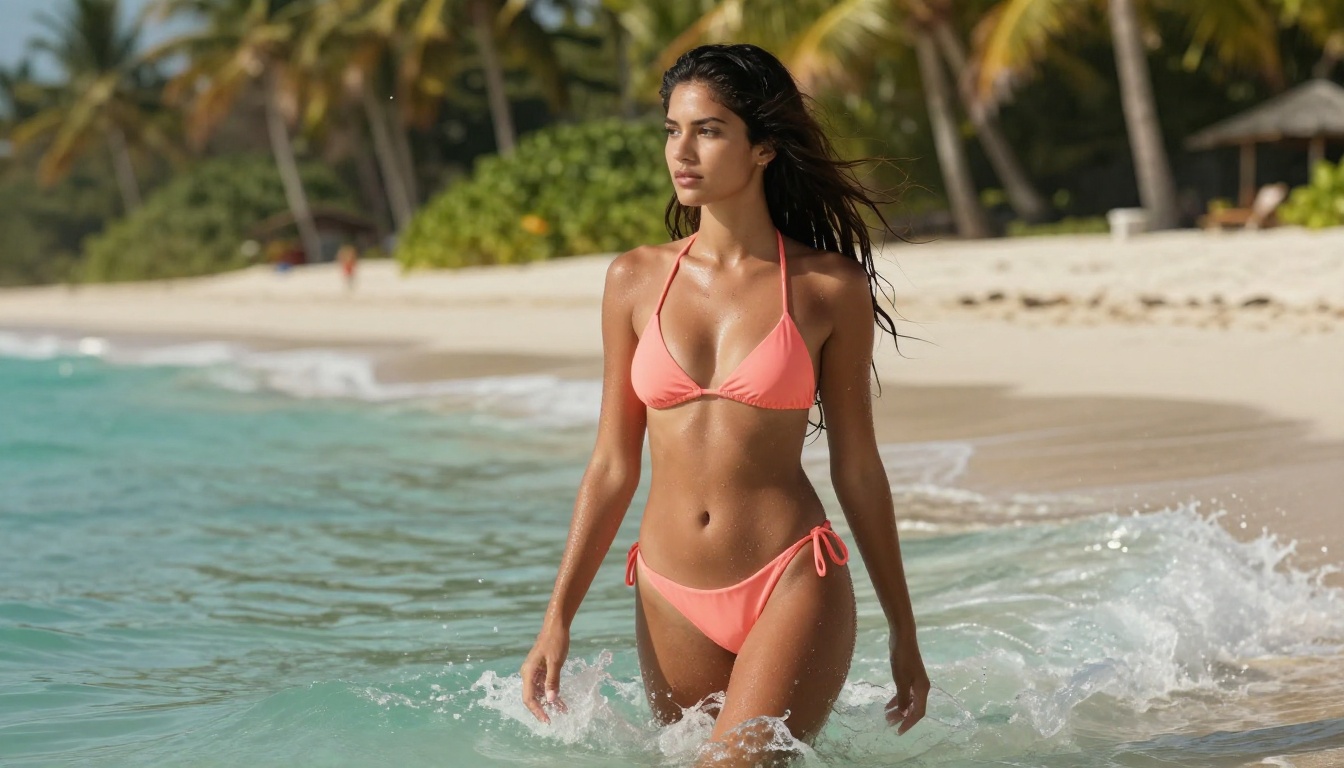
Pour les utilisateurs qui veulent pousser la résolution plus loin après la génération, combiner l’un de ces modèles avec un post-traitement de super-résolution peut porter une sortie de 1024 px à une qualité d’impression. Flux Schnell mérite aussi d’être signalé : sa génération en 4 étapes le rend assez rapide pour explorer des idées de composition avant de lancer un rendu complet sur un modèle plus lourd.
Des prompts qui produisent des photos d’apparence réelle
Comprendre le fonctionnement de la technologie permet de voir pourquoi certains schémas de prompts produisent systématiquement des résultats plus photoréalistes.
Les spécifications de l’appareil et de l’objectif fonctionnent
Lorsque vous écrivez « Canon EOS R5, 85 mm f/1.4, ouverture f/2.0 » dans un prompt, vous ne décorez pas votre demande. Vous déplacez le signal de conditionnement vers une zone de la distribution apprise par le modèle, associée aux photographies prises avec de vrais appareils. Les données d’entraînement contiennent d’innombrables images dont les légendes décrivent des métadonnées EXIF, de sorte que ces termes influencent réellement le résultat.
Descripteurs d’objectif qui aident de façon fiable :
- Focale : 35 mm (plus large, environnemental), 85 mm (portrait, légère compression), 135 mm (téléobjectif, forte séparation de l’arrière-plan)
- Ouverture : de f/1.4 à f/2.8 produit une faible profondeur de champ visible
- Type de pellicule : Kodak Portra 400, Fujifilm Pro 400H, Kodak Ektar 100 orientent chacun la palette de couleurs dans des directions distinctes
Des instructions d’éclairage utiles
Les descripteurs d’éclairage sont parmi les outils les plus puissants pour le photoréalisme. Le modèle a appris à associer certaines expressions à une qualité de lumière précise :
| Expression d’éclairage | Effet |
|---|
| « Lumière volumétrique du matin venant de la gauche » | Qualité directionnelle, d’heure dorée, avec des rayons visibles |
| « Lumière douce et diffuse par temps couvert » | Exposition plate et uniforme, sans ombres dures |
| « Lumière pratique de l’écran d’ordinateur » | Lumière d’appoint froide et bleutée, ambiance d’intérieur |
| « Contre-jour en lumière de contour » | Halo sur la silhouette du sujet, le détache de l’arrière-plan |
| « Lumière de fenêtre, ligne d’ombre marquée » | Éclairage latéral dramatique, fort contraste |
💡 Plus vous décrivez avec précision la direction de la lumière, la température de couleur et sa qualité (dure ou douce), plus le système d’attention croisée peut aligner l’éclairage spatial de votre image sur ces conditions.
Le prompt négatif est tout aussi important. Demander explicitement au modèle d’éviter « illustration, dessin animé, art numérique, CGI, rendu 3D, peinture » l’éloigne des interprétations artistiques pour le rapprocher des rendus photographiques. Certains modèles, comme Flux 1.1 Pro Ultra et les variantes récentes de Flux, sont suffisamment solides pour que les prompts négatifs de style aient moins d’impact, mais pour les anciens modèles basés sur SD, ils sont indispensables.
Ce qui trahit encore les photos IA
Malgré les progrès, les modèles d’IA actuels présentent des faiblesses persistantes. Les connaître est utile à la fois pour améliorer vos prompts et pour repérer les images générées.
Points de défaillance courants :
- Les mains : les erreurs de nombre de doigts et les angles d’articulation peu naturels restent fréquents dans les modèles d’entrée de gamme
- Le texte dans les images : les mots sont souvent déformés ou remplacés par des caractères inventés, même si des modèles comme Ideogram v3 Quality ont largement résolu ce problème
- Les arrière-plans complexes : les scènes de rue animées ou les foules présentent souvent des incohérences structurelles à l’examen attentif
- Les reflets : miroirs, lunettes et reflets sur l’eau contiennent fréquemment des éléments physiquement impossibles
- La symétrie : la symétrie bilatérale des visages et des objets peut parfois dériver, un œil étant légèrement différent de l’autre
Aucune de ces limites n’est inhérente à l’approche. Chacune a été nettement réduite d’une génération de modèles à l’autre, et plusieurs modèles spécialisés gèrent désormais bien des faiblesses précises. La tendance générale va vers des images qui nécessitent une analyse forensique pour être identifiées comme générées par IA.
Créez vos propres images photoréalistes
Les mécanismes qui sous-tendent tout cela sont sophistiqués, mais utiliser ces modèles ne demande pas de maîtriser ce fonctionnement. L’essentiel est d’avoir accès à des modèles bien entraînés et de savoir ce que vous demandez.
Tous les modèles mentionnés dans cet article sont disponibles sur PicassoIA, où vous pouvez passer de l’un à l’autre instantanément, sans configuration. Vous voulez la qualité de photographie documentaire de Realistic Vision v5.1 ? Changez de modèle. Vous voulez le plafond de résolution de 4 MP de Flux 1.1 Pro Ultra ? Un clic suffit. Les 91 modèles de la collection texte vers image incluent des options ultra-rapides comme Flux Schnell pour itérer vite, ainsi que des options haute fidélité pour le rendu final.
Commencez par une scène simple que vous photographieriez vraiment si vous aviez le matériel. Ajoutez des détails d’éclairage. Précisez un appareil et un objectif. Mentionnez un type de pellicule. Lancez le tout sur Flux Dev ou RealVisXL v3.0 Turbo et comparez. Puis lancez le même prompt sur Imagen 4 Ultra et voyez à quoi ressemble le plafond de données d’entraînement d’un modèle de l’envergure de Google.
La question de savoir comment les générateurs d’images IA créent de vraies photos a une réponse satisfaisante : ils ne créent pas à partir de rien. Ils apprennent la forme statistique de la réalité à partir de milliards d’exemples, puis remontent du bruit vers quelque chose qui correspond aux motifs appris. Plus il y a de données, meilleure est l’architecture, et plus votre prompt est précis, plus le résultat se rapproche de ce qui est impossible à distinguer du vrai.


