यह इमेज ऐसी लगती है मानो दोपहर की रोशनी में किसी Canon कैमरे से खींची गई हो। त्वचा की बनावट असली लगती है। ठुड्डी के नीचे की परछाई स्वाभाविक रूप से पड़ती है। लेकिन वहाँ कोई फ़ोटोग्राफ़र नहीं था, कोई मॉडल पोज़ नहीं दे रहा था, और कोई स्टूडियो किराए पर नहीं लिया गया था। एक मशीन ने टेक्स्ट की एक पंक्ति से, कुछ ही सेकंड में, इसे बनाया।
आज AI इमेज जनरेटर यही करते हैं, और उनके नतीजे उस सीमा को पार कर चुके हैं जहाँ लोग सचमुच रुककर सोचने लगते हैं कि वे जो देख रहे हैं वह असली है या नहीं। यह कैसे होता है, यह जानना नतीजों से भी ज़्यादा दिलचस्प है।
जब आप प्रॉम्प्ट टाइप करते हैं तो असल में क्या होता है
ज़्यादातर लोग मानते हैं कि टेक्स्ट प्रॉम्प्ट मिलने पर AI कुछ "बनाता" है। असल में प्रक्रिया ज़्यादा गणितीय है और एक अजीब तरह से ज़्यादा काव्यात्मक भी।
जब आप लिखते हैं "गोल्डन आवर में एक खिड़की के पास खड़ी एक महिला", तो सिस्टम फ़ोटो की कोई लाइब्रेरी नहीं खंगालता और न ही मौजूदा इमेज को पिक्सेल-दर-पिक्सेल मिलाता है। इसके बजाय, वह आपके शब्दों को संख्यात्मक वेक्टर में बदलता है, उन वेक्टरों को एक उच्च-आयामी गणितीय स्पेस में शर्तों के रूप में समझता है, और फिर नॉइज़ से धीरे-धीरे एक इमेज गढ़ता है जो उन शर्तों से मेल खाए।
शब्दों से संख्याओं तक
पहले चरण में एक टेक्स्ट एनकोडर लगता है, आम तौर पर CLIP (Contrastive Language-Image Pretraining) या कोई मिलता-जुलता ट्रांसफ़ॉर्मर मॉडल। CLIP को सैकड़ों मिलियन इमेज-टेक्स्ट जोड़ियों पर ट्रेन किया गया था, ताकि वह सीखे कि कौन से शब्द और वाक्यांश किस तरह के विज़ुअल कंटेंट के साथ आम तौर पर आते हैं।
जब आपका प्रॉम्प्ट एनकोडर में जाता है, तो हर शब्द और वाक्यांश एक उच्च-आयामी वेक्टर स्पेस के किसी बिंदु पर मैप होता है। "Window", "golden hour", "woman" और "standing" सभी स्थितिगत मान देते हैं, जो मिलकर एक कंडीशनिंग सिग्नल बनाते हैं, यानी आपके रचनात्मक इरादे की एक संख्यात्मक पहचान।
💡 आपका प्रॉम्प्ट जितना समृद्ध और विशिष्ट होगा, वह पहचान उतनी ही सटीक बनेगी। "85mm f/1.4 portrait lens, soft bokeh, Kodak Portra 400" सिर्फ़ सजावटी शब्द नहीं हैं। ये कंडीशनिंग सिग्नल को विज़ुअल स्पेस के एक खास हिस्से की ओर मोड़ देते हैं।
लेटेंट स्पेस की अवधारणा
पूरे रिज़ॉल्यूशन के पिक्सेल पर काम करने के बजाय, आधुनिक AI इमेज जनरेटर लेटेंट स्पेस में काम करते हैं, जो इमेज का एक संकुचित गणितीय प्रतिनिधित्व है। 512x512 की इमेज को 4 चैनल वाले 64x64 लेटेंट टेंसर में एन्कोड किया जा सकता है। इससे कम्प्यूटेशनल लागत लगभग 64 गुना घट जाती है, और इमेज की मूल संरचना बनी रहती है।
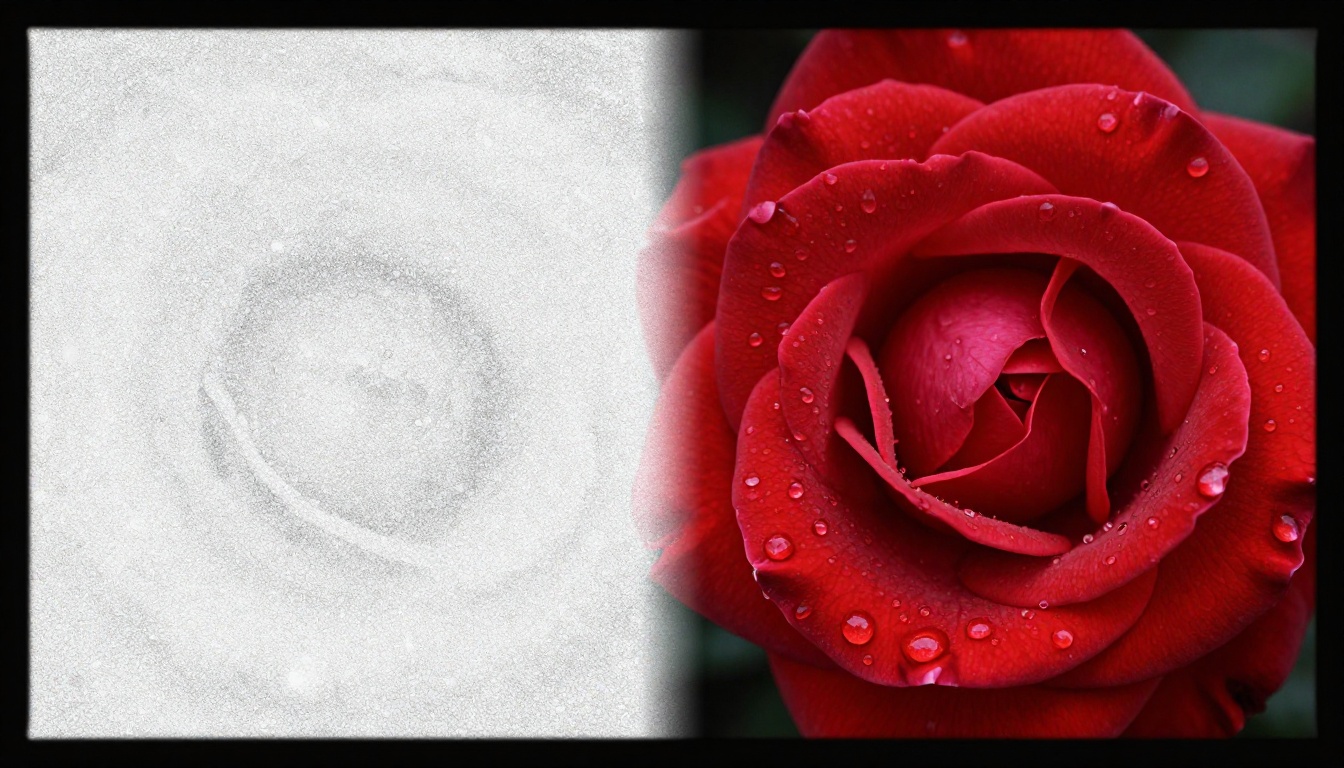
यह संपीड़न एक Variational Autoencoder (VAE) करता है, जिसके दो हिस्से हैं: एक एन्कोडर जो असली इमेज को लेटेंट टेंसर में संपीड़ित करता है, और एक डिकोडर जो लेटेंट टेंसर को वापस पूरे रिज़ॉल्यूशन की इमेज में बदलता है। सारा भारी जनरेशन काम इसी संक्षिप्त लेटेंट स्पेस में होता है, और अंत में उसे डिकोड किया जाता है।
डिफ्यूज़न मॉडल को सरल भाषा में समझें
"डिफ्यूज़न मॉडल" सुनने में जटिल लगता है, लेकिन जब आप देखते हैं कि यह असल में क्या करता है, तो इसका मूल विचार हैरानी की हद तक सहज लगता है।
नॉइज़ जोड़ना, फिर हटाना
ट्रेनिंग के दौरान, मॉडल एक असली फ़ोटो देखता है। फिर एक नियंत्रित प्रक्रिया में, ट्रेनिंग सिस्टम उस इमेज में रैंडम गाउसियन नॉइज़ जोड़ता है, कदम-दर-कदम, सैकड़ों टाइमस्टेप्स में, जब तक मूल इमेज पूरी तरह शुद्ध स्टैटिक में दब न जाए। मॉडल का काम इस प्रक्रिया को उलटना सीखना है, यानी हर कदम पर हटाए गए नॉइज़ का अनुमान लगाना।
अरबों इमेज-नॉइज़ जोड़ियों पर ट्रेनिंग के बाद, मॉडल एक चीज़ में बेहद माहिर हो जाता है: यह अनुमान लगाना कि किसी नॉइज़ वाली इमेज से कौन सा नॉइज़ घटाया जाए, ताकि वह थोड़ी और असली जैसी दिखे।
💡 यही मूल अंतर्दृष्टि है। मॉडल इमेज को शून्य से "कल्पना" नहीं करता। वह रैंडम नॉइज़ से शुरू करता है और आपके टेक्स्ट कंडीशनिंग के मार्गदर्शन में कदम-दर-कदम नॉइज़ हटाता है। हर कदम इमेज को थोड़ा और सुसंगत बनाता है।
डीनॉइज़िंग लूप
इनफ़रेंस के समय, जब आप इमेज जनरेट करते हैं, तो यही प्रक्रिया उल्टी दिशा में चलती है:
- शुद्ध गाउसियन नॉइज़ से शुरू करें
- नॉइज़, मौजूदा टाइमस्टेप और टेक्स्ट कंडीशनिंग को मॉडल में डालें
- मॉडल वह नॉइज़ अनुमानित करता है जिसे हटाना है
- वह नॉइज़ घटाएँ ताकि थोड़ा साफ़ लेटेंट मिले
- तब तक 20 से 50 बार दोहराएँ जब तक एक साफ़ इमेज न उभरे
- अंतिम लेटेंट को VAE से डिकोड करें
स्टेप्स की संख्या, नॉइज़ शेड्यूल (नॉइज़ कितनी आक्रामक तरह से हटाया जाए) और गाइडेंस स्केल, ये सब अंतिम नतीजे को प्रभावित करते हैं। कम स्टेप्स से इमेज जल्दी बनती है, लेकिन कभी-कभी वह कम सुसंगत होती है। ज़्यादा गाइडेंस स्केल इमेज को प्रॉम्प्ट के करीब ले जाता है, लेकिन इससे स्वाभाविकता घट सकती है।
आपका टेक्स्ट इमेज को कैसे नियंत्रित करता है
अकेले डीनॉइज़िंग प्रक्रिया बस अव्यवस्थित दिखने वाली इमेज बनाएगी। फोटोरियलिस्टिक आउटपुट का जादू इस बात में है कि टेक्स्ट कंडीशनिंग हर कदम में कैसे बुनी जाती है।
CLIP और टेक्स्ट एनकोडर
टेक्स्ट एनकोडर एम्बेडिंग वेक्टर बनाता है, जो पूरी डीनॉइज़िंग प्रक्रिया में इमेज के साथ चलते हैं। हर कदम पर मॉडल यह "जाँच" सकता है कि मौजूदा नॉइज़ वाला लेटेंट टेक्स्ट एम्बेडिंग से कैसे मेल खाता है, और उसी के अनुसार समायोजन कर सकता है।
Flux Dev और Stable Diffusion 3.5 Large जैसे आधुनिक आर्किटेक्चर डुअल या ट्रिपल टेक्स्ट एनकोडर इस्तेमाल करते हैं। वे CLIP को T5 के साथ जोड़ते हैं, जो एक लार्ज लैंग्वेज मॉडल एनकोडर है, और इससे सिस्टम को कहीं गहरी भाषा प्रोसेसिंग मिलती है। इसी वजह से नए मॉडल कई सब्जेक्ट और संबंधों वाले जटिल प्रॉम्प्ट को Stable Diffusion के पुराने वर्ज़न से कहीं बेहतर संभालते हैं।
क्रॉस-अटेंशन कैसे काम करता है
वह तंत्र जो टेक्स्ट को इमेज से जोड़ता है, क्रॉस-अटेंशन कहलाता है। डीनॉइज़िंग नेटवर्क के भीतर, इमेज लेटेंट का हर स्पेशियल हिस्सा टेक्स्ट एम्बेडिंग के अलग-अलग हिस्सों पर "अटेंड" कर सकता है।
इसे ऐसे समझें कि मॉडल हर पिक्सेल स्थिति पर खुद से पूछ रहा है: "यह हिस्सा अभी जैसा दिख रहा है, और प्रॉम्प्ट जो कहता है, उसे देखते हुए यहाँ कौन सा नॉइज़ हटाना चाहिए?"
क्रॉस-अटेंशन मैप अक्सर सहज रूप से मेल खाते हैं। प्रॉम्प्ट में "woman" से जुड़ा हिस्सा इमेज के चेहरे और शरीर वाले क्षेत्र पर ज़ोरदार ढंग से सक्रिय होता है। "window" वाला हिस्सा पृष्ठभूमि पर सक्रिय होता है। यही स्पेशियल अलाइनमेंट उन इमेज को बनाता है जिनमें चीज़ें सही जगह पर दिखती हैं, न कि फ्रेम में बेतरतीब बिखरी हुई।
कुछ आउटपुट ज़्यादा असली क्यों लगते हैं
सभी मॉडल एक जैसी फोटोरियलिज़्म की गुणवत्ता नहीं देते। इस अंतर के पीछे कई कारण हैं।
ट्रेनिंग डेटा की मात्रा मायने रखती है
समान आर्किटेक्चर मानें तो, 2 बिलियन इमेज-टेक्स्ट पेयर्स पर ट्रेन किया गया मॉडल, 100 मिलियन पर ट्रेन किए गए मॉडल से ज़्यादा वास्तविक आउटपुट देगा। ज़्यादा डेटा का मतलब है कि मॉडल ने ज़्यादा एज केस, ज़्यादा लाइटिंग कंडीशन, ज़्यादा स्किन टोन, ज़्यादा कैमरा आर्टिफ़ैक्ट और ज़्यादा असली दुनिया के टेक्सचर देखे हैं।
Imagen 4 Ultra और Flux 1.1 Pro Ultra इस हाई-डेटा-वॉल्यूम छोर का प्रतिनिधित्व करते हैं। 4MP रिज़ॉल्यूशन पर उनके आउटपुट में बारीक टेक्सचर डिटेल दिखती है, जिसमें अलग-अलग कपड़े के धागे, त्वचा में असली सबसरफ़ेस स्कैटरिंग और प्रामाणिक लेंस बोकेह शामिल हैं, जो पिछले मॉडल नहीं बना पाते थे।
फोटोरियलिज़्म के लिए फाइन-ट्यूनिंग
बेस ट्रेनिंग के बाद भी, कई मॉडल उच्च गुणवत्ता वाली फ़ोटोग्राफ़ी के चुने हुए डेटासेट पर अतिरिक्त फाइन-ट्यूनिंग से गुज़रते हैं। Realistic Vision v5.1 Stable Diffusion का एक फाइन-ट्यून्ड वर्ज़न है, जिसे खास तौर पर फोटोरियलिस्टिक पोर्ट्रेट फ़ोटोग्राफ़ी पर ट्रेन किया गया है। RealVisXL v3.0 Turbo SDXL को इसी तरह की लक्षित ट्रेनिंग के साथ आगे बढ़ाता है।
फाइन-ट्यूनिंग मॉडल को उसके आउटपुट डिस्ट्रीब्यूशन को असली फ़ोटो की विशेषताओं की ओर झुकाने देती है: स्वाभाविक नॉइज़, उथली डेप्थ ऑफ़ फ़ील्ड, प्रामाणिक रंग-कास्ट और वे सूक्ष्म अपूर्णताएँ जो किसी चीज़ को बनाई गई नहीं, बल्कि खींची गई जैसा दिखाती हैं।
एक और तकनीक, DPO (Direct Preference Optimization) या RLHF (Reinforcement Learning from Human Feedback), में मॉडल को इंसानों की दी हुई इमेज-गुणवत्ता रेटिंग पर ट्रेन किया जाता है। इस तरह ट्रेन किए गए मॉडल ऐसे आउटपुट को प्राथमिकता देना सीखते हैं जिन्हें इंसान ज़्यादा असली और दृश्य रूप से आकर्षक मानते हैं। इससे एक फीडबैक लूप बनता है जो असली फ़ोटोग्राफ़ी से फ़ासले को कम करता है।
अभी सबसे अच्छे रियलिस्टिक AI मॉडल
फोटोरियलिस्टिक मॉडलों की मौजूदा पीढ़ी को दो बड़ी श्रेणियों में बाँटा जा सकता है: जनरल-पर्पस मॉडल जो दूसरी शैलियों के साथ फोटोरियलिस्टिक आउटपुट भी दे सकते हैं, और फ़ोटोग्राफ़ी जैसे नतीजों के लिए खास तौर पर अनुकूलित फाइन-ट्यून्ड मॉडल।
फोटोरियलिज़्म की ताकत वाले जनरल-पर्पस मॉडल:
- Flux 2 Pro टेक्स्ट इनपुट और इमेज-रेफ़रेंस्ड जनरेशन, दोनों संभालता है, और मज़बूत फोटोग्राफ़िक सुसंगति वाले आउटपुट देता है। असली दुनिया की बनावट वाले सब्जेक्ट के लिए बेहतरीन है।
- Ideogram v3 Quality असली जैसी मानव आकृतियाँ बनाता है, जिसमें शरीर की संरचना (एनाटॉमी) खास तौर पर भरोसेमंद रहती है, और यह पिछले मॉडलों के लिए सबसे कठिन समस्याओं में से एक थी।
- Seedream 4 नेटिव 4K रिज़ॉल्यूशन में आउटपुट देता है, जिससे लैंडस्केप और आर्किटेक्चरल फ़ोटोग्राफ़ी जैसी इमेज सचमुच बड़े फ़ॉर्मेट जैसी लगती हैं।
फ़ोटोग्राफ़ी के लिए फाइन-ट्यून्ड:
- Realistic Vision v5.1 असली जैसे पोर्ट्रेट फ़ोटोग्राफ़ी के लिए अब भी सबसे भरोसेमंद मॉडलों में से एक है, खासकर त्वचा की बनावट और बालों की डिटेल के लिए।
- RealVisXL v3.0 Turbo फोटोरियलिज़्म में रफ़्तार जोड़ता है, जिससे तेज़ी से प्रयोग करना व्यावहारिक हो जाता है। SDXL रिज़ॉल्यूशन पर आउटपुट लगातार विश्वसनीय लगता है।
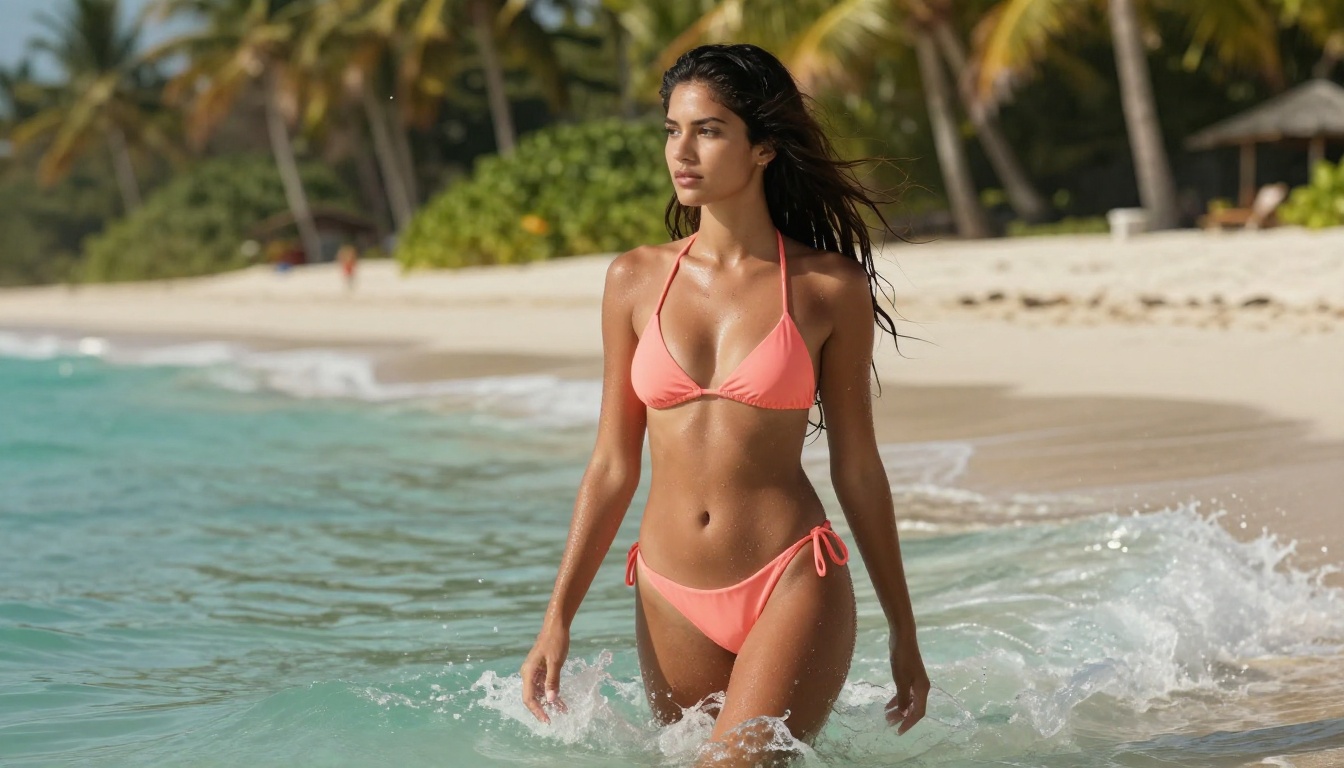
जो उपयोगकर्ता जनरेशन के बाद रिज़ॉल्यूशन को और आगे बढ़ाना चाहते हैं, वे इन मॉडलों में से किसी के साथ सुपर-रिज़ॉल्यूशन पोस्ट-प्रोसेसिंग जोड़ सकते हैं, जिससे 1024px का आउटपुट प्रिंट क्वालिटी तक पहुँच सकता है। Flux Schnell का ज़िक्र यहाँ भी ध्यान देने लायक है: इसकी 4-स्टेप जनरेशन इसे इतना तेज़ बनाती है कि किसी भारी मॉडल पर पूरी क्वालिटी का रन करने से पहले कंपोज़िशन के विचारों को जाँचना आसान हो जाता है।
ऐसे प्रॉम्प्ट जो असली दिखने वाली फ़ोटो बनाते हैं
तकनीक कैसे काम करती है, यह जानने से साफ़ हो जाता है कि कुछ प्रॉम्प्ट पैटर्न लगातार ज़्यादा फोटोरियलिस्टिक नतीजे क्यों देते हैं।
कैमरा और लेंस की विशिष्टताएँ काम करती हैं
जब आप प्रॉम्प्ट में "Canon EOS R5, 85mm f/1.4, f/2.0 aperture" लिखते हैं, तो आप अपने अनुरोध को सजा नहीं रहे होते। आप कंडीशनिंग सिग्नल को मॉडल के उस सीखे हुए डिस्ट्रीब्यूशन के हिस्से की ओर मोड़ रहे होते हैं जो असली कैमरा फ़ोटोग्राफ़ी से जुड़ा है। ट्रेनिंग डेटा में ऐसी अनगिनत इमेज हैं जिनके कैप्शन में EXIF मेटाडेटा का विवरण है, इसलिए ये शब्द सचमुच आउटपुट को प्रभावित करते हैं।
लेंस से जुड़े ऐसे डिस्क्रिप्टर जो भरोसेमंद ढंग से मदद करते हैं:
- फ़ोकल लेंथ: 35mm (चौड़ा, परिवेश वाला), 85mm (पोर्ट्रेट, हल्का कम्प्रेशन), 135mm (टेलीफ़ोटो, बैकग्राउंड से मज़बूत अलगाव)
- एपर्चर: f/1.4 से f/2.8 दिखाई देने वाली उथली डेप्थ ऑफ़ फ़ील्ड बनाता है
- फ़िल्म स्टॉक: Kodak Portra 400, Fujifilm Pro 400H, Kodak Ektar 100, हर एक रंग पैलेट को अलग दिशा में खींचता है
रोशनी के निर्देश जो मदद करते हैं
लाइटिंग डिस्क्रिप्टर फोटोरियलिज़्म के सबसे शक्तिशाली उपकरणों में से हैं। मॉडल ने खास वाक्यांशों को खास रोशनी की गुणवत्ता से जोड़ना सीखा है:
| लाइटिंग वाक्यांश | प्रभाव |
|---|
| "Volumetric morning light from the left" | दिशात्मक, दिखने वाली किरणों के साथ गोल्डन आवर जैसी गुणवत्ता |
| "Overcast soft diffused light" | कठोर परछाइयों के बिना सपाट, समान एक्सपोज़र |
| "Practical light from laptop screen" | नीली-ठंडी फ़िल, इंटीरियर का परिवेशी प्रकाश |
| "Rim light from behind" | सब्जेक्ट की सिल्हूट में चमक, पृष्ठभूमि से अलगाव |
| "Window light, hard shadow line" | नाटकीय साइड लाइटिंग, मज़बूत कंट्रास्ट |
💡 आप रोशनी की दिशा, कलर टेम्परेचर और गुणवत्ता (कठोर बनाम नरम) जितनी सटीकता से बताएँगे, मॉडल का क्रॉस-अटेंशन सिस्टम इमेज की स्पेशियल रोशनी को उन स्थितियों के साथ उतना ही बेहतर मिला पाएगा।
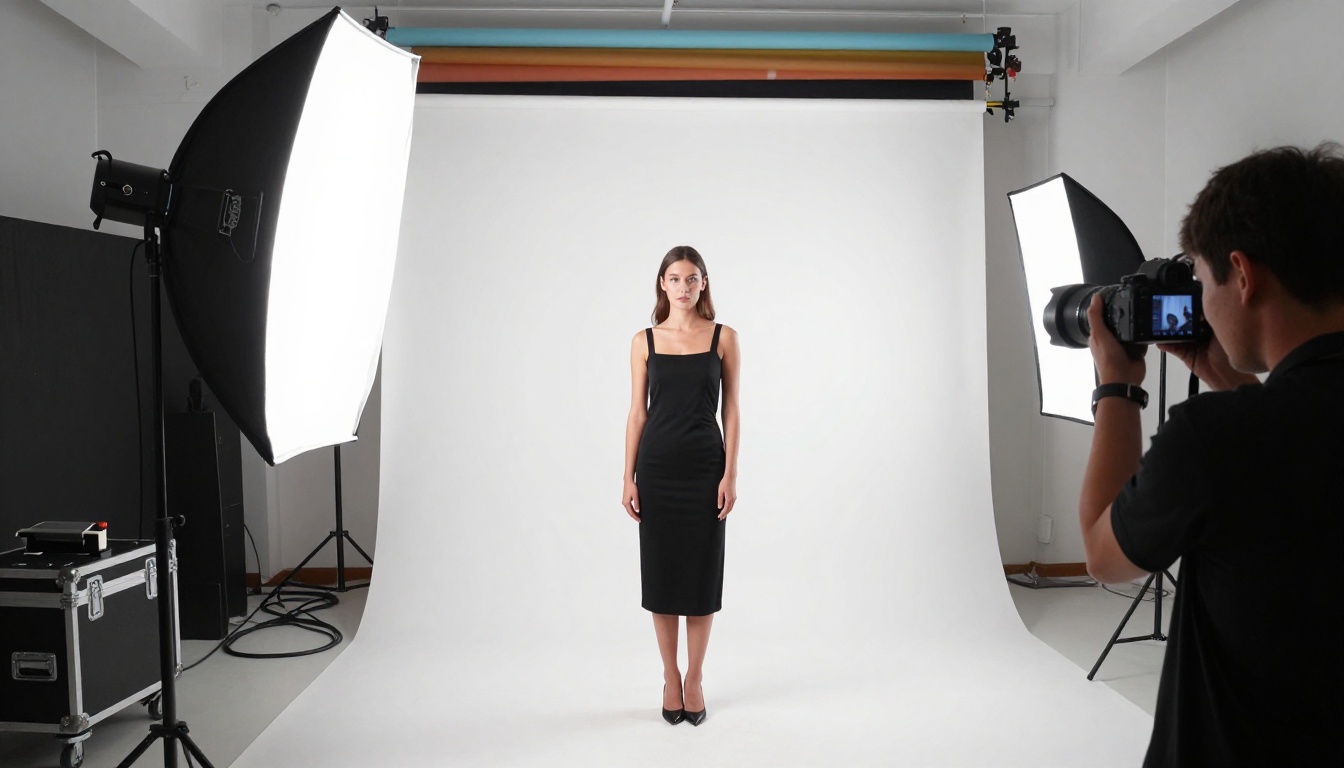
नेगेटिव प्रॉम्प्टिंग भी उतनी ही ज़रूरी है। मॉडल को साफ़ तौर पर "illustration, cartoon, digital art, CGI, 3D render, painting" से बचने को कहना उसे कलात्मक व्याख्याओं से दूर और फ़ोटोग्राफ़िक व्याख्याओं की ओर धकेलता है। कुछ मॉडल, जैसे Flux 1.1 Pro Ultra और नए Flux वर्ज़न, इतने मज़बूत हैं कि स्टाइल के लिए नेगेटिव प्रॉम्प्ट का असर कम होता है, लेकिन पुराने SD-आधारित मॉडलों के लिए ये ज़रूरी हैं।
अभी भी कौन सी चीज़ AI फ़ोटो को पकड़वा देती है
इतनी प्रगति के बावजूद, मौजूदा AI मॉडलों में कुछ लगातार कमज़ोरियाँ हैं। इन्हें जानना अपने प्रॉम्प्ट सुधारने और जनरेट की गई इमेज पहचानने, दोनों के लिए ज़रूरी है।
आम विफलता के बिंदु:
- हाथ: निचले स्तर के मॉडलों में उंगलियों की गिनती की गलतियाँ और अस्वाभाविक जोड़ों के कोण अब भी आम हैं
- इमेज के भीतर टेक्स्ट: शब्द अक्सर बिगड़े हुए या गढ़े हुए अक्षरों वाले होते हैं, हालाँकि Ideogram v3 Quality जैसे मॉडलों ने इसे काफ़ी हद तक सुलझा लिया है
- जटिल पृष्ठभूमि: व्यस्त सड़क के दृश्य या भीड़ में करीब से देखने पर संरचनात्मक असंगतियाँ अक्सर दिखती हैं
- रिफ़्लेक्शन: शीशे, चश्मे और पानी के रिफ़्लेक्शन में अक्सर भौतिक रूप से असंभव सामग्री होती है
- समरूपता: चेहरों और वस्तुओं की द्विपक्षीय समरूपता कभी-कभी बिगड़ सकती है, जैसे एक आँख दूसरी से थोड़ी अलग दिखना
इनमें से कोई भी इस तरीके की अंतर्निहित सीमा नहीं है। मॉडल की हर पीढ़ी के साथ इनमें से हर एक में काफ़ी सुधार हुआ है, और कई विशेष मॉडल अब खास कमज़ोरियों को अच्छी तरह संभालते हैं। आम दिशा यह है कि इमेज इतनी असली होती जा रही हैं कि उन्हें AI-जनित पहचानने के लिए फ़ॉरेंसिक विश्लेषण की ज़रूरत पड़े।
अपनी खुद की फोटोरियलिस्टिक इमेज बनाएँ
इन सबके पीछे की तकनीक जटिल है, लेकिन इन मॉडलों का उपयोग करने के लिए इसे प्रोसेस करने की ज़रूरत नहीं है। ज़रूरी यह है कि आपके पास अच्छी तरह ट्रेन किए गए मॉडलों तक पहुँच हो और आपको पता हो कि क्या माँगना है।
इस लेख में बताया गया हर मॉडल Picasso IA पर उपलब्ध है, जहाँ आप बिना किसी सेटअप के तुरंत उनके बीच स्विच कर सकते हैं। Realistic Vision v5.1 की डॉक्यूमेंट्री फ़ोटोग्राफ़ी वाली क्वालिटी चाहिए? स्विच करें। Flux 1.1 Pro Ultra की 4MP रिज़ॉल्यूशन सीमा चाहिए? एक क्लिक। टेक्स्ट-टू-इमेज कलेक्शन के 91 मॉडलों में Flux Schnell जैसे अल्ट्रा-फ़ास्ट विकल्प शामिल हैं, जो तेज़ प्रयोग के लिए अच्छे हैं, और अंतिम आउटपुट के लिए हाई-फ़िडेलिटी विकल्प भी हैं।
किसी ऐसे साधारण दृश्य से शुरू करें जिसे आप उपकरण होने पर सचमुच खींचते। रोशनी का विवरण जोड़ें। कैमरा और लेंस बताएँ। फ़िल्म स्टॉक का ज़िक्र करें। इसे Flux Dev या RealVisXL v3.0 Turbo पर चलाकर तुलना करें। फिर वही प्रॉम्प्ट Imagen 4 Ultra पर चलाएँ और देखें कि Google-स्केल मॉडल की ट्रेनिंग डेटा की सीमा कैसी दिखती है।
AI इमेज जनरेटर असली फ़ोटो कैसे बनाते हैं, इस सवाल का एक संतोषजनक जवाब है: वे शून्य से कुछ नहीं बनाते। वे अरबों उदाहरणों से वास्तविकता का सांख्यिकीय आकार सीखते हैं, फिर नॉइज़ से वापस उस चीज़ तक पहुँचते हैं जो उन सीखे हुए पैटर्न से मेल खाती है। जितना ज़्यादा डेटा, जितना बेहतर आर्किटेक्चर, और जितना विशिष्ट आपका प्रॉम्प्ट, नतीजा असली चीज़ से अलग न पहचाने जाने के उतना ही करीब पहुँचता है।


