La imagen parece tomada con una cámara Canon con luz de la tarde. La textura de la piel es real. La sombra bajo la barbilla cae de forma natural. Pero no había ningún fotógrafo, ninguna modelo posó y no se alquiló ningún estudio. Una máquina la hizo en segundos, a partir de una línea de texto.
Eso es lo que hacen hoy los generadores de imágenes con IA, y los resultados han cruzado un umbral que hace que la gente se detenga de verdad y se pregunte qué está mirando. Entender cómo ocurre eso resulta más interesante que los propios resultados.
Qué ocurre realmente cuando escribes un prompt
La mayoría de la gente cree que la IA "dibuja" algo cuando recibe un prompt de texto. La realidad es más matemática y, de una forma extraña, más poética.
Cuando escribes "una mujer de pie junto a una ventana al atardecer dorado", el sistema no busca en una biblioteca de fotos ni mezcla imágenes existentes píxel a píxel. En su lugar, codifica tus palabras como vectores numéricos, interpreta esos vectores como condiciones en un espacio matemático de alta dimensión y luego esculpe una imagen a partir del ruido, dándole forma poco a poco hasta que coincida con esas condiciones.
De las palabras a los números
El primer paso lo realiza un codificador de texto, normalmente CLIP (Contrastive Language-Image Pretraining) u otro modelo transformer similar. CLIP se entrenó con cientos de millones de pares imagen-texto, aprendiendo qué palabras y frases tienden a aparecer junto a qué tipos de contenido visual.
Cuando tu prompt entra en el codificador, cada palabra y cada frase se asigna a un punto en un espacio vectorial de alta dimensión. "Ventana", "atardecer dorado", "mujer" y "de pie" aportan valores posicionales que juntos forman una señal de condicionamiento, una huella numérica de tu intención creativa.
💡 Cuanto más rico y específico sea tu prompt, más precisa será esa huella. "Objetivo de retrato de 85 mm f/1.4, bokeh suave, Kodak Portra 400" no es solo texto decorativo. Desplaza la señal de condicionamiento hacia una región concreta del espacio visual.
El concepto de espacio latente
En lugar de trabajar con píxeles a resolución completa, los generadores de imágenes con IA modernos operan en un espacio latente, una representación matemática comprimida de las imágenes. Una imagen de 512x512 puede codificarse en un tensor latente de 64x64 con 4 canales. Esto reduce el costo computacional unas 64 veces y conserva la estructura esencial de la imagen.
Esta compresión la gestiona un autoencoder variacional (VAE), que tiene dos partes: un codificador que comprime las imágenes reales en tensores latentes y un decodificador que convierte los tensores latentes de nuevo en imágenes a resolución completa. Todo el trabajo pesado de generación ocurre en ese espacio latente compacto y, al final, se decodifica.
El término "modelo de difusión" suena complejo, pero la idea central resulta sorprendentemente intuitiva cuando ves lo que hace en realidad.
Añadir ruido y después quitarlo
Durante el entrenamiento, el modelo ve una fotografía real. Después, en un proceso controlado, el sistema de entrenamiento añade ruido gaussiano aleatorio a esa imagen, paso a paso, a lo largo de cientos de pasos temporales, hasta que la imagen original queda completamente enterrada bajo estática pura. La tarea del modelo es aprender a revertir este proceso, es decir, predecir qué se eliminó en cada paso.
Tras entrenar con miles de millones de pares imagen-ruido, el modelo se vuelve extremadamente bueno en una sola cosa: predecir qué ruido debe restar de una imagen con ruido para que se parezca un poco más a algo real.
💡 Esta es la idea clave. El modelo no "imagina" las imágenes desde cero. Parte de ruido aleatorio y elimina ruido paso a paso, guiado por el condicionamiento de tu texto. Cada paso hace que la imagen sea un poco más coherente.
El bucle de eliminación de ruido
En el momento de la inferencia, cuando generas una imagen, el proceso ocurre en sentido inverso:
- Comenzar con ruido gaussiano puro
- Introducir en el modelo el ruido, el paso temporal actual y el condicionamiento del texto
- El modelo predice el ruido que debe eliminarse
- Restar ese ruido para obtener un latente algo más limpio
- Repetir de 20 a 50 veces hasta que surja una imagen clara
- Decodificar el latente final a través del VAE
El número de pasos, el calendario de ruido (lo agresivamente que se elimina el ruido) y el guidance scale (CFG) afectan al resultado final. Menos pasos producen imágenes más rápidas pero a veces menos coherentes. Un guidance scale más alto acerca la imagen al prompt, pero puede reducir la naturalidad.
Cómo controla tu texto la imagen
El proceso de eliminación de ruido por sí solo produciría imágenes de aspecto aleatorio. La magia del resultado realista viene de cómo se entreteje el condicionamiento de texto en cada paso.
CLIP y los codificadores de texto
El codificador de texto produce vectores de embedding que viajan junto a la imagen durante todo el proceso de eliminación de ruido. En cada paso, el modelo puede "comprobar" cómo se ve el latente ruidoso actual frente al embedding del texto y ajustarse en consecuencia.
Arquitecturas más modernas, como las que usan Flux Dev y Stable Diffusion 3.5 Large, emplean codificadores de texto dobles o triples. Combinan CLIP con T5, un codificador de modelo de lenguaje (LLM), lo que da al sistema un procesamiento del lenguaje mucho más profundo. Por eso los modelos nuevos manejan prompts complejos con varios sujetos y relaciones mucho mejor que las versiones anteriores de Stable Diffusion.
La atención cruzada en acción
El mecanismo que conecta el texto con la imagen se llama atención cruzada. Dentro de la red de eliminación de ruido, cada región espacial del latente de la imagen puede "prestar atención" a distintas partes del embedding del texto.
Imagínalo como si el modelo se preguntara, en cada posición de píxel: "Dado cómo se ve esta región ahora y dado lo que dice el prompt, ¿qué ruido debo eliminar aquí?"
Los mapas de atención cruzada tienden a alinearse de forma intuitiva. La región que corresponde a "mujer" en el prompt se activa con fuerza sobre la cara y el cuerpo de la imagen. La región de "ventana" se activa sobre el fondo. Esta alineación espacial es lo que produce imágenes en las que los elementos aparecen en el lugar correcto, en lugar de repartirse al azar por el encuadre.
Por qué algunos resultados parecen más reales
No todos los modelos producen la misma calidad de fotorrealismo. Varios factores explican la diferencia.
El volumen de datos de entrenamiento importa
Un modelo entrenado con 2000 millones de pares imagen-texto producirá resultados más realistas que uno entrenado con 100 millones, siempre que la arquitectura sea comparable. Más datos significan que el modelo ha visto más casos límite, más condiciones de iluminación, más tonos de piel, más artefactos de cámara y más texturas del mundo real.
Imagen 4 Ultra y Flux 1.1 Pro Ultra representan el extremo de alto volumen de datos de este espectro. Sus resultados a 4MP muestran un nivel de detalle de textura fina, con hilos de tela individuales, dispersión subsuperficial realista de la piel y bokeh de lente auténtico, que los modelos anteriores no podían producir.
Ajuste fino para el fotorrealismo
Incluso tras el entrenamiento base, muchos modelos pasan por un ajuste fino adicional con conjuntos de datos seleccionados de fotografía de alta calidad. Realistic Vision v5.1 es una versión con ajuste fino de Stable Diffusion, entrenada específicamente con fotografía de retratos fotorrealistas. RealVisXL v3.0 Turbo amplía SDXL con un entrenamiento específico similar.
El ajuste fino permite que el modelo oriente su distribución de salida hacia las características de las fotografías reales: ruido natural, profundidad de campo poco profunda, dominantes de color auténticas y las microimperfecciones que hacen que algo parezca tomado y no creado.
Otra técnica, DPO (Direct Preference Optimization) o RLHF (Reinforcement Learning from Human Feedback), consiste en entrenar el modelo con valoraciones humanas de la calidad de la imagen. Los modelos entrenados así aprenden a preferir los resultados que las personas valoran como más realistas y agradables a la vista, creando un bucle de retroalimentación que reduce la distancia con la fotografía real.
Los mejores modelos de IA realistas en este momento
La generación actual de modelos fotorrealistas se divide en dos grandes categorías: modelos de propósito general que pueden producir resultados fotorrealistas junto a otros estilos, y modelos con ajuste fino optimizados específicamente para resultados similares a la fotografía.
De propósito general con fuerza en el fotorrealismo:
- Flux 2 Pro admite tanto texto como imágenes de referencia, y genera resultados con una gran coherencia fotográfica. Ideal para sujetos con textura real.
- Ideogram v3 Quality genera figuras humanas realistas con una anatomía especialmente fiable, uno de los problemas más difíciles para los modelos anteriores.
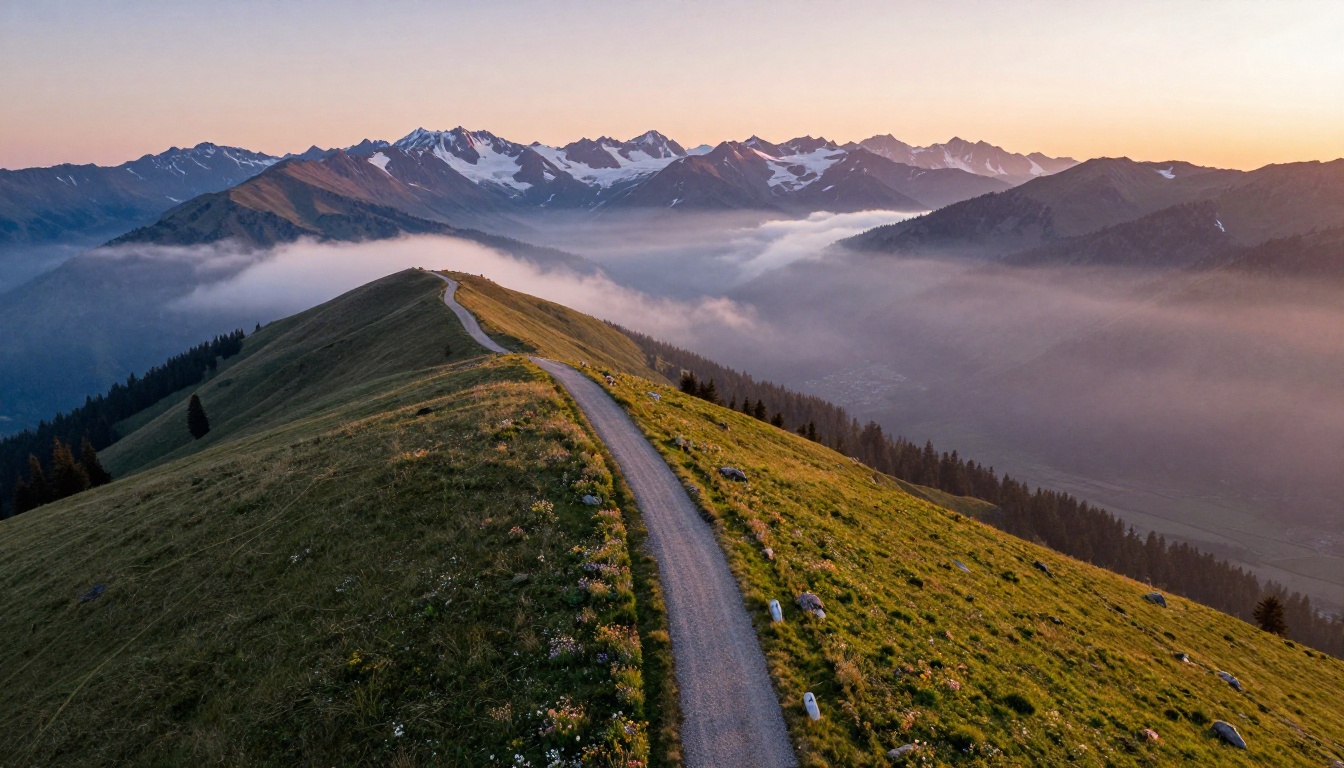
- Seedream 4 genera en resolución 4K nativa, lo que hace que las imágenes de paisaje y arquitectura con estilo fotográfico parezcan de formato grande de verdad.
Con ajuste fino para la fotografía:
- Realistic Vision v5.1 sigue siendo uno de los modelos más fiables para la fotografía de retratos realistas, sobre todo en la textura de la piel y el detalle del cabello.
- RealVisXL v3.0 Turbo añade velocidad al fotorrealismo, lo que lo hace práctico para iterar con rapidez. La salida a resolución SDXL siempre resulta convincente.
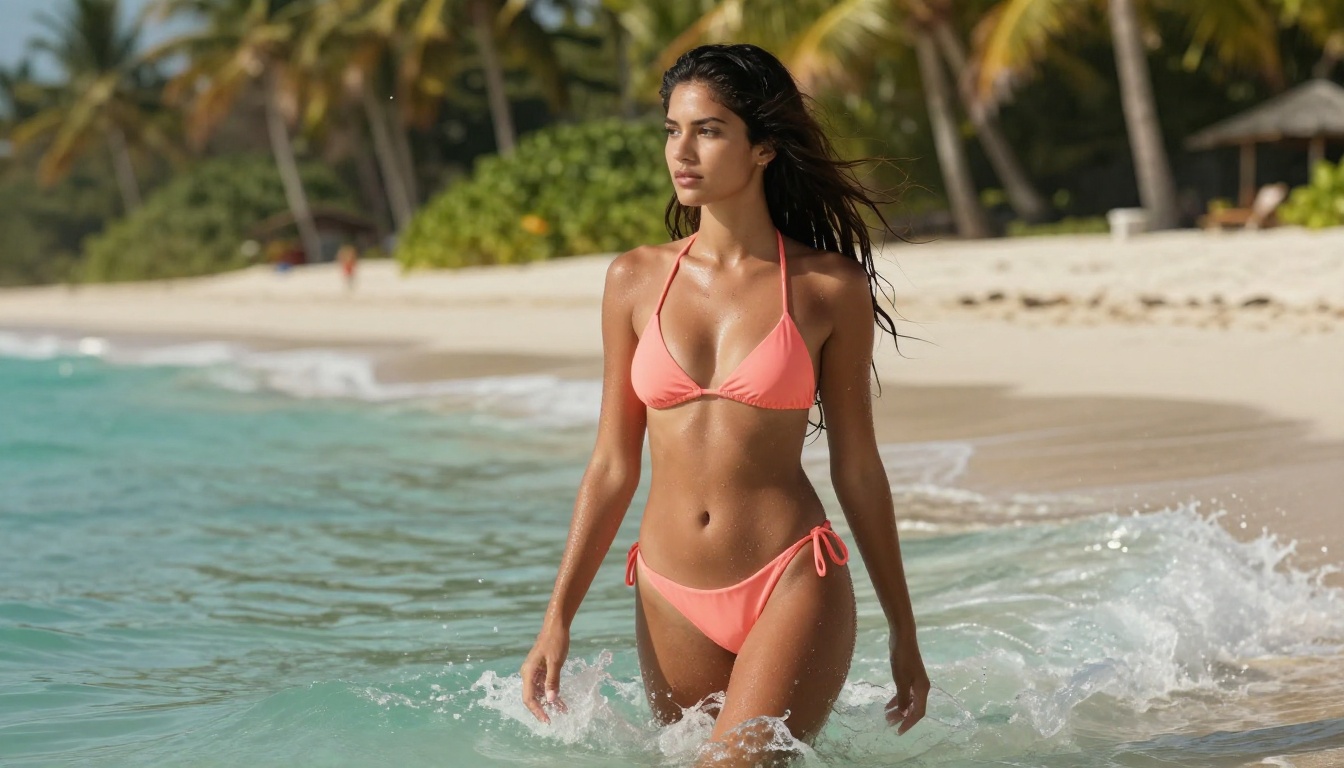
Para quienes quieran aumentar la resolución después de generar la imagen, combinar cualquiera de estos modelos con un posprocesado de superresolución puede llevar un resultado de 1024 px a calidad de impresión. Flux Schnell también merece mención aquí: su generación en 4 pasos lo hace lo bastante rápido para probar ideas de composición antes de lanzar una versión de máxima calidad en un modelo más pesado.
Prompts que producen fotos con aspecto real
Entender cómo funciona la tecnología deja claro por qué ciertos patrones de prompt producen con regularidad resultados más fotorrealistas.
Los detalles de cámara y objetivo funcionan
Cuando escribes "Canon EOS R5, 85 mm f/1.4, apertura f/2.0" en un prompt, no estás adornando tu petición. Estás desplazando la señal de condicionamiento hacia una región de la distribución aprendida por el modelo asociada con la fotografía de cámara real. Los datos de entrenamiento incluyen innumerables imágenes con descripciones de metadatos EXIF en sus pies, así que estos términos influyen de verdad en el resultado.
Descriptores de objetivo que ayudan de forma fiable:
- Distancia focal: 35 mm (gran angular, ambiental), 85 mm (retrato, compresión leve), 135 mm (teleobjetivo, separación marcada del fondo)
- Apertura: f/1.4 a f/2.8 produce una profundidad de campo poco profunda visible
- Tipo de película: Kodak Portra 400, Fujifilm Pro 400H y Kodak Ektar 100 orientan cada uno la paleta de color en direcciones distintas
Instrucciones de iluminación que ayudan
Los descriptores de iluminación son de las herramientas más potentes para el fotorrealismo. El modelo ha aprendido a asociar frases concretas con una calidad de luz determinada:
| Frase de iluminación | Efecto |
|---|
| "Luz volumétrica de la mañana desde la izquierda" | Dirigida, con calidad de hora dorada y rayos visibles |
| "Luz suave y difusa de día nublado" | Exposición plana y uniforme, sin sombras duras |
| "Luz práctica de la pantalla del equipo portátil" | Relleno frío azulado, ambiente interior |
| "Contraluz desde atrás" | Brillo en la silueta del sujeto, lo separa del fondo |
| "Luz de ventana, línea de sombra dura" | Iluminación lateral dramática, contraste fuerte |
💡 Cuanto más describas con precisión la dirección de la luz, la temperatura de color y la calidad (dura o suave), más podrá el sistema de atención cruzada alinear la iluminación espacial de tu imagen con esas condiciones.
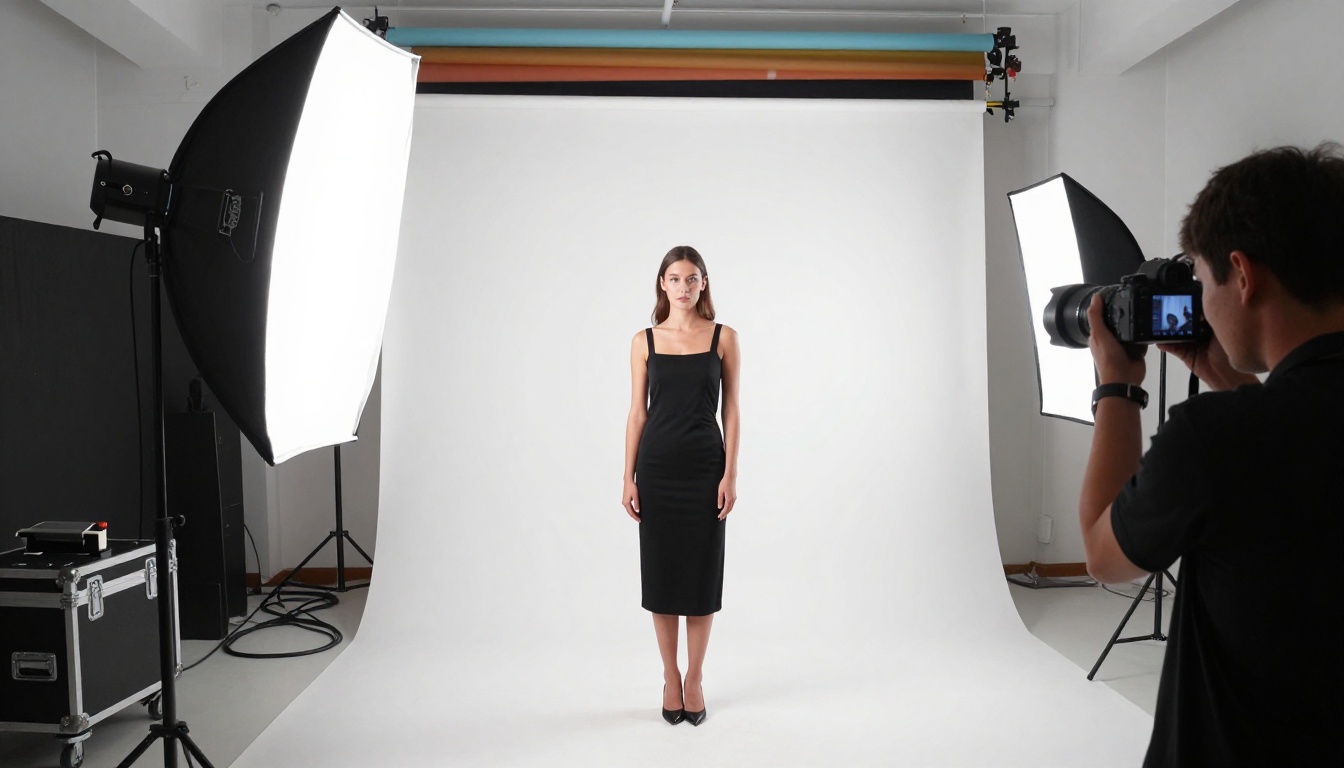
El prompt negativo es igual de importante. Pedir explícitamente al modelo que evite "ilustración, dibujos animados, arte digital, CGI, render 3D, pintura" lo aleja de las interpretaciones artísticas y lo acerca a las fotográficas. Algunos modelos, como Flux 1.1 Pro Ultra y las variantes más nuevas de Flux, son lo bastante sólidos como para que los prompts negativos de estilo tengan menos impacto, pero en los modelos antiguos basados en SD son esenciales.
Lo que todavía delata a las fotos de IA
A pesar del progreso, los modelos de IA actuales tienen debilidades persistentes. Conocerlas importa tanto para mejorar tus prompts como para detectar imágenes generadas.
Puntos de fallo habituales:
- Manos: Los errores en el número de dedos y los ángulos de articulación poco naturales siguen siendo comunes en los modelos de gama baja
- Texto dentro de las imágenes: Las palabras tienden a salir deformadas o con caracteres inventados, aunque modelos como Ideogram v3 Quality lo han resuelto en gran medida
- Fondos complejos: Las escenas de calle concurridas o las multitudes a menudo muestran incoherencias estructurales al mirarlas de cerca
- Reflejos: Los espejos, las gafas y los reflejos en el agua contienen con frecuencia contenido físicamente imposible
- Simetría: La simetría bilateral en rostros y objetos puede desviarse de vez en cuando, con un ojo ligeramente distinto del otro
Ninguno de estos es un límite inherente al enfoque. Cada uno se ha reducido de forma notable de una generación de modelos a otra, y varios modelos especializados ya manejan bien debilidades concretas. La tendencia general apunta a imágenes que requieren un análisis forense para identificarlas como generadas por IA.
Crea tus propias imágenes fotorrealistas
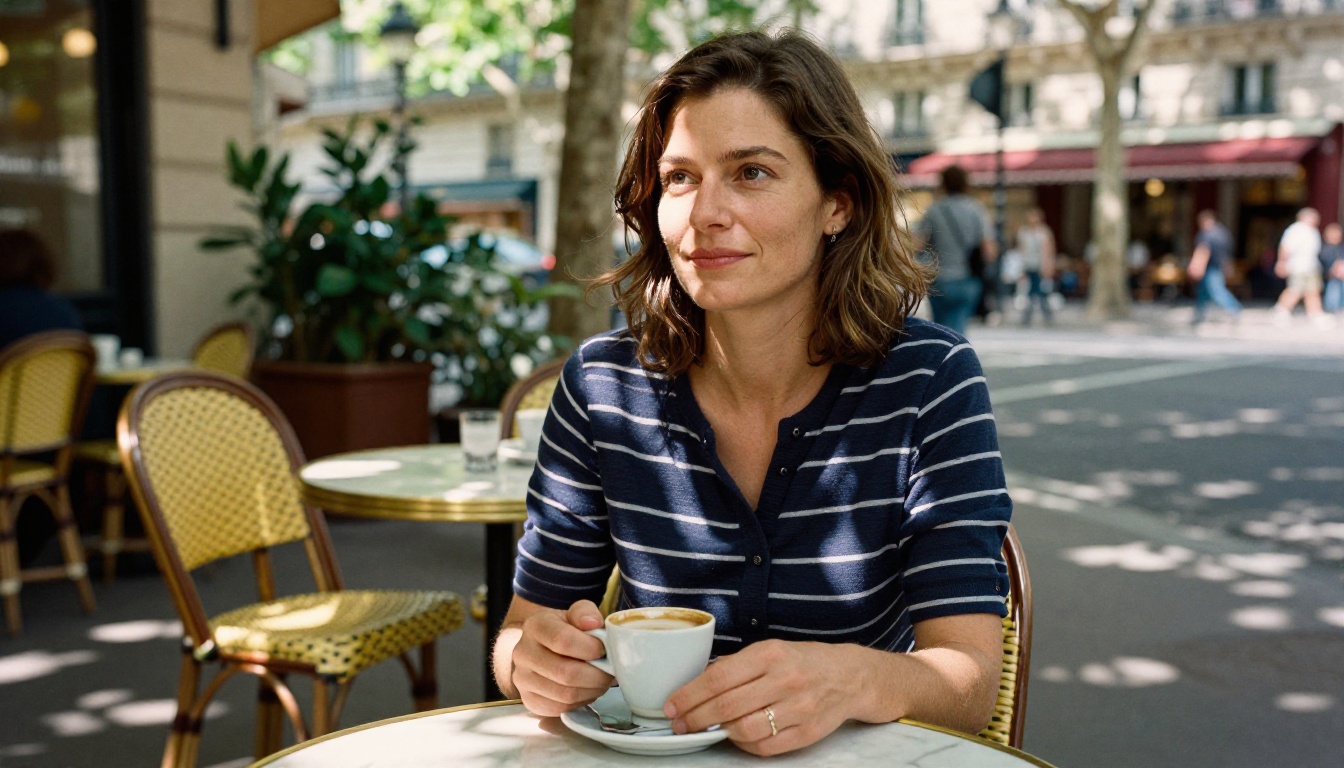
La mecánica que hay detrás de todo esto es sofisticada, pero usar estos modelos no exige procesar nada de eso. Lo que importa es tener acceso a modelos bien entrenados y saber qué pedirles.
Todos los modelos mencionados en este artículo están disponibles en PicassoIA, donde puedes cambiar entre ellos al instante sin configuración. ¿Quieres la calidad de fotografía documental de Realistic Vision v5.1? Cambia. ¿Quieres el techo de resolución de 4MP de Flux 1.1 Pro Ultra? Un clic. Los 91 modelos de la colección de texto a imagen incluyen opciones ultrarrápidas como Flux Schnell para iterar con rapidez y opciones de alta fidelidad para el resultado final.
Empieza con una escena sencilla que de verdad fotografiarías si tuvieras el equipo. Añade detalles de iluminación. Especifica una cámara y un objetivo. Menciona un tipo de película. Ejecútalo en Flux Dev o en RealVisXL v3.0 Turbo y compara. Después lanza el mismo prompt en Imagen 4 Ultra y mira cómo es el techo de datos de entrenamiento de un modelo a escala de Google.
La pregunta de cómo los generadores de imágenes con IA crean fotos reales tiene una respuesta satisfactoria: no crean desde la nada. Aprenden la forma estadística de la realidad a partir de miles de millones de ejemplos y luego recorren el camino de vuelta desde el ruido hasta algo que coincide con los patrones aprendidos. Cuantos más datos, mejor arquitectura y más específico sea el prompt, más se acerca el resultado a ser indistinguible de lo real.


