لا تحتاج إلى كاميرا أو شاشة خضراء أو استوديو تسجيل لنشر فيديو رأس متحدث متقن في 2027. صورة واحدة وسطر واحد من الصوت يكفيان. وصلت نماذج مزامنة الشفاه بالذكاء الاصطناعي إلى مستوى يجعل حركة الفم وحركة الرأس وتوقيت الرمش مقنعة بما يكفي، بحيث لا يستطيع معظم المشاهدين التمييز بينها وبين مقطع مسجّل. يشرح هذا المقال بالتفصيل كيف تولّد رؤوسًا متحدثة مجانًا، وأي النماذج تعطي أكثر النتائج واقعية، وما الذي يجب الانتباه إليه قبل النشر.
ما هو فيديو الرأس المتحدث فعليًا
فيديو الرأس المتحدث هو أي مقطع يملأ فيه الوجه معظم الإطار، ويبدو كأنه يخاطب الجمهور مباشرة. فكّر في مذيع الأخبار، أو درس شرح على YouTube، أو شرح منتج، أو مقدمة دورة إلكترونية. هذا الشكل موجود منذ عقود، لكن الذكاء الاصطناعي غيّر أمرين: لم تعد بحاجة إلى شخص حقيقي في موقع التصوير، وانخفضت التكلفة إلى الصفر.
تعمل مولّدات الرؤوس المتحدثة بالذكاء الاصطناعي اليوم عن طريق تحريك صورة مصدر باستخدام ملف صوتي. يتنبأ النموذج بكيفية تحرك الشفتان والفك والخدّان والعينان، استنادًا إلى الفونيمات الموجودة في الصوت، ثم يُصيّر هذه الحركات فوق الصورة الأصلية بثبات زمني كافٍ ليبدو الأمر حركةً طبيعية.
لماذا يتخلّى صنّاع المحتوى عن الفيديو التقليدي
المزايا العملية لا يمكن إنكارها:
- لا قلق من الكاميرا. يستطيع من يكرهون الظهور أمام الكاميرا أن يبنوا قناة تعتمد على الفيديو.
- التوسع في اللغات. يمكنك دبلجة الأفاتار نفسه إلى الإسبانية أو الفرنسية أو اليابانية دون توظيف ممثلين في كل سوق.
- السرعة. مقطع مدته 60 ثانية كان سيستغرق يوم تصوير كامل يمكن أن يكون جاهزًا في أقل من 5 دقائق.
- التكلفة. معظم النماذج التي يغطيها هذا المقال مجانية أو تقدم مستويات مجانية سخية.
العوامل الثلاثة التي تجعله يبدو واقعيًا
قبل اختيار أداة، من المفيد أن تعرف ما الذي يفصل الرأس المتحدث المقنع عن الرأس المزعج:
- دقة مزامنة الشفاه على مستوى الفونيم، لا على مستوى المقطع الصوتي فقط. يجب أن تنطبق الشفتان تمامًا عند نطق صوتي "P" و"B".
- حركة رأس طبيعية. الوجه الذي لا يتحرك أبدًا يبدو ميتًا. الإيماءات الخفيفة والميلان والحركات الدقيقة مهمة.
- سلوك العينين. توقيت الرمش واتجاه النظر والانحرافات الطبيعية للعين تصنع الواقعية أو تهدمها.
تُتقن أفضل النماذج المجانية في 2027 العناصر الثلاثة كلها. أما الأضعف فيتقن الأول فقط.
الأدوات التي تعمل فعلًا (مجانية أو بنظام فريميوم)
مجال مزامنة الشفاه والأفاتارات مزدحم، لكن قلّة من النماذج تستحق وقتك إذا كان الهدف هو الواقعية. فيما يلي تفصيل لما هو متاح، وما الذي يجيده كل نموذج.
نماذج مزامنة الشفاه التي تحرّك صورة
تأخذ هذه النماذج صورة ثابتة مع صوت، وتُخرج فيديو يبدو فيه الوجه وهو يتكلم. لا حاجة إلى تمثيل، ولا إلى إضاءة استوديو.
Omni Human 1.5 من ByteDance هو أقوى خيار مجاني حاليًا. يُنتج حركة رأس طبيعية إلى جانب مزامنة الشفاه، ويتعامل مع الصور الأمامية والصور المائلة قليلًا، ويتعامل بشكل جيد مع درجات البشرة المختلفة. النموذج الأصلي Omni Human متاح أيضًا، ويعمل جيدًا مع المقاطع القصيرة.
Fabric 1.0 من VEED مصمَّم خصيصًا لتحريك صورة واحدة. تكمن قوته في الحفاظ على الطابع الجمالي للصورة الأصلية، فلا تبدو النتيجة كأنها شخص آخر.
React 1 من Sync يضيف مزامنة شفاه واقعية إلى فيديو موجود، وهو مفيد إذا كنت تريد إعادة ضبط توقيت لقطات لديك أو إعادة تسجيل صوتها. أما Lipsync 2 و**Lipsync 2 Pro** من الفريق نفسه، فيركّزان على مطابقة الفونيمات بدقة، ويستحقان التجربة إذا كنت تحتاج إلى مزامنة محكمة للكلام السريع أو للمصطلحات التقنية.
Kling Lip Sync من Kwaivgi و**Pixverse Lipsync** يتعاملان بشكل جيد مع مطابقة حركة الفم للصوت، ويتكاملان بسلاسة مع منظومة تحويل النص إلى فيديو الخاصة بكل منهما.
أدوات الأفاتار التي تستغني عن الكاميرا تمامًا
إذا كنت تريد أفاتارًا كاملًا بالذكاء الاصطناعي بدلًا من تحريك صورة حقيقية، يبرز نموذجان:
Avatar IV من HeyGen يُنشئ فيديوهات أفاتار متحدثة متقنة يقدّم فيها المقدّم الذكي نصّك مباشرة. تزوّد النموذج بالنص، وتختار أسلوب الأفاتار، ويتولى النموذج الباقي. أما Video Agent من الفريق نفسه، فيذهب أبعد من ذلك، إذ يجمع الأفاتار في فيديو منظم بقطعات ولقطات مساندة (b-roll).
Kling Avatar v2 من Kwaivgi يركّز على تحريك الوجه إلى فيديو، مع ثبات حركي قوي عبر المقاطع الأطول.
Dreamactor M2.0 من ByteDance مصمَّم لتحريك شخصيات بحركة الجسم كاملة، لكن جودة تحريك وجهه تنتقل بشكل جيد إلى حالات الرأس المتحدث أيضًا.
كيفية استخدام Omni Human 1.5 على PicassoIA
Omni Human 1.5 هو نقطة البداية المُوصى بها لأي شخص يولّد رؤوسًا متحدثة مجانًا. إليك سير العمل الدقيق.
الخطوة 1: اختر الصورة الأساسية
جودة الصورة تحدد 80% من النتيجة النهائية. اتبع هذه الإرشادات:
- الدقة: 512 بكسل على الأقل في الضلع القصير. 1024 بكسل أو أكثر هو المثالي.
- الزاوية: وجه أمامي أو ميل يصل إلى 30 درجة عن المركز. الوضعيات الجانبية الحادة تعطي نتائج ضعيفة.
- الإضاءة: ضوء متساوٍ ومنتشر. تجنّب الظلال القاسية على الأنف أو الذقن.
- التعبير: محايد أو ابتسامة خفيفة. الأفواه المفتوحة على اتساعها في الصورة الأصلية تُربك النموذج.
- الخلفية: بسيطة أو ضبابية قليلًا. الخلفيات المزدحمة تُحفظ لكنها قد تشتّت الانتباه.
نصيحة احترافية: إذا لم تكن لديك صورة ترضيك، فاستخدم أولًا نموذج تحويل النص إلى صورة لتوليد بورتريه واقعي كالصور الفوتوغرافية، ثم أدخله إلى Omni Human 1.5. النموذج لا يهتم بما إذا كان الوجه حقيقيًا أو مُولَّدًا بالذكاء الاصطناعي.
الخطوة 2: جهّز الصوت
ملف الصوت هو ما يقود الحركة كلها. هناك بعض القواعد غير البديهية:
- الصيغة: MP3 أو WAV، والصوت أحادي أو ستيريو، كلاهما مقبول.
- المدة: أبقِ الاختبارات الأولية أقل من 30 ثانية أثناء ضبط المظهر.
- الوضوح: الموسيقى الخلفية والصدى والضجيج كلها تُضعف دقة مزامنة الشفاه. استخدم مسارًا صوتيًا نظيفًا وجافًا.
- السرعة: الكلام بالسرعة المحادثية المعتادة يعطي أفضل النتائج. الكلام السريع جدًا أو الهمس قد يُربك اكتشاف الفونيمات.
إذا لم يكن لديك صوت مسجّل، فاستخدم أولًا نموذج تحويل النص إلى كلام. ثم اجمعه مع نموذج مزامنة الشفاه لاحقًا للحصول على خط إنتاج اصطناعي بالكامل دون أي تسجيل.
الخطوة 3: شغّل النموذج
- افتح Omni Human 1.5 على PicassoIA.
- ارفع صورة المصدر في حقل الإدخال Image.
- ارفع ملف الصوت في حقل الإدخال Audio.
- أبقِ قوة الحركة الافتراضية على المستوى المتوسط في تشغيلك الأول.
- انقر على Generate وانتظر. المقاطع التي تقل عن 30 ثانية تُعالَج عادةً في دقيقتين إلى 4 دقائق.
- عاين النتيجة. راقب زوايا الشفتين، لا مركز الفم فقط.
ماذا تفعل إذا بدا الأمر غير صحيح
| المشكلة | السبب المحتمل | الحل |
|---|
| الشفتان لا تنطبقان على أصوات "B" و"P" | صوت فيه ضجيج | نظّف مسار الصوت وأعد التشغيل |
| الرأس ثابت تمامًا | قوة الحركة منخفضة جدًا | ارفع قوة الحركة إلى 0.7 أو أعلى |
| الوجه يتشوه عند أطراف الفم | زاوية حادة في صورة المصدر | استخدم صورة أكثر أمامية |
| الخلفية تومض | النموذج يواجه خلفية معقدة | اقتصّ الصورة لتضييق إطار الوجه |
| الصوت وحركة الفم متباعدان قليلًا | الصوت يبدأ بصمت | قصّ الصمت قبل الكلمة الأولى |
نصيحة: شغّل مقطعًا تجريبيًا مدته 5 ثوانٍ قبل الالتزام بتوليد مدته 2 دقيقة. يوفر هذا الوقت ويتيح لك إصلاح المشكلات قبل أن تتفاقم.
مقارنة أفضل نماذج مزامنة الشفاه المجانية
ليست كل النماذج مصمَّمة لنفس الاستخدام. إليك كيف تقف أفضل الخيارات أمام بعضها:
الخلاصة: Omni Human 1.5 هو أفضل نقطة بداية لتوليد الرأس المتحدث الخالص. أما Lipsync 2 Pro فهو الخيار الأفضل عندما تعيد تسجيل الصوت لفيديو موجود أو تدبلجه، وتكون دقة الفونيمات حاسمة.
5 أوامر نصية تنتج رؤوسًا متحدثة رائعة
إذا كنت تولّد البورتريه الأساسي بنموذج صور بالذكاء الاصطناعي قبل تحريكه، فإن هذه البنى للأوامر النصية تنتج باستمرار صورًا تعمل جيدًا مع نماذج مزامنة الشفاه:
-
مقدّم محترف: "Portrait of a [ethnicity] woman in her 30s، ابتسامة خفيفة، وجه أمامي، إضاءة استوديو ناعمة، خلفية رمادية محايدة، واقعي كالصور الفوتوغرافية، عدسة 85 ملم، عمق ميدان ضحل"
-
صانع محتوى غير رسمي: "شاب بقميص غير رسمي، تواصل بصري مباشر، ضوء نافذة طبيعي دافئ من اليسار، خلفية مكتب منزلي ضبابية بلطف، بأسلوب Kodak Portra 400، بورتريه بوجه أمامي"
-
متحدث باسم الشركة: "رجل محترف بسترة زرقاء داكنة، تعبير محايد واثق، زاوية 15 درجة خفيفة، خلفية بيضاء نظيفة، بورتريه تحريري، واقعي كالصور الفوتوغرافية بدقة 8K"
-
معلّم أو مدرّب: "امرأة في عمر 40s بنظارة، تعبير دافئ ودود، رفوف كتب ضبابية بلطف خلفها، ضوء نهار طبيعي، صورة شخصية بوجه أمامي"
-
أفاتار علامة تجارية: "شخص محايد الجنس، بشرة ناعمة ومتساوية، نظرة مباشرة إلى الكاميرا، خلفية متدرجة بسيطة باللون الأزرق الفاتح، أسلوب بورتريه تجاري نظيف، واقعي كالصور الفوتوغرافية وعالي التفاصيل"
ملاحظة: تعليمة "وجه أمامي" هي الإضافة الأكثر تأثيرًا على الإطلاق. هي وحدها تقلّل مخرجات مزامنة الشفاه الرديئة إلى النصف.
كيف تبدو حدود المستوى المجاني
الوصول المجاني حقيقي، لكنه ليس غير محدود. معرفة ما يمكن توقعه تمنع الإحباط في منتصف المشروع.
الدقة والمدة
معظم المستويات المجانية تحدّ المخرجات عند 720p وتقصر طول المقطع على 30 إلى 60 ثانية لكل توليد. بالنسبة إلى مقاطع وسائل التواصل الاجتماعي أو YouTube Shorts أو معاينات الدورات، يكفي هذا عادةً وأكثر. أما فيديوهات الشرح الأطول أو المحتوى البثّي عالي الدقة، فتتطلب عادةً خطة مدفوعة.
العلامات المائية والنقاط
تضيف بعض النماذج علامة مائية خفيفة على المخرجات المجانية. تحقّق من المعاينة بالدقة الكاملة قبل أن تلتزم بالمونتاج النهائي. النماذج التي تصل إليها عبر PicassoIA تميل إلى أن تكون مخرجاتها المجانية أنظف من التطبيقات المستقلة، لأن طبقة API تُخفي معظم قيود العلامات التجارية.
تختلف أنظمة النقاط. معظم النماذج على PicassoIA تستهلك عددًا صغيرًا من النقاط لكل توليد، وتحصل الحسابات الجديدة على نقاط كافية لتشغيل 10 إلى 20 مقطع اختبار كامل الطول قبل الحاجة إلى إعادة التعبئة.
متى تستخدم أي نموذج
يعتمد اختيار الأداة المناسبة على ما تبدأ به وما تحتاجه في النهاية:
إذا كنت تبدأ من صورة وملف صوتي: استخدم Omni Human 1.5 أولًا. فإذا احتاجت النتيجة إلى دقة أعلى في الشفتين، فانتقل إلى Lipsync 2 Pro.
إذا كنت تبدأ من نص مكتوب فقط: استخدم نموذج تحويل النص إلى كلام لتوليد الصوت أولًا، ثم مرّره إلى Omni Human 1.5 أو Fabric 1.0.
إذا كنت تدبلج فيديو موجودًا إلى لغة أخرى: استخدم Lipsync Precision من HeyGen أو Video Translate، وكلاهما يدعم أكثر من 150 لغة.
إذا كنت تبني مقدّمًا كاملًا بأفاتار ذكي دون صورة حقيقية: ابدأ بالنموذج Avatar IV أو Dreamactor M2.0 لإنشاء الشخصية الأساسية، ثم حرّكها بنموذج مزامنة شفاه.
إذا كنت تزامن صوتًا مع فيديو لديك بالفعل: فإن React 1 أو Kling Lip Sync هما الخياران الأكثر موثوقية.
نصيحة سير العمل: أكثر خط إنتاج كفاءة هو: توليد البورتريه بنموذج تحويل النص إلى صورة، وتوليد الصوت بنموذج تحويل النص إلى كلام، ثم التحريك بنموذج مزامنة الشفاه. يمكن إنجاز الخطوات الثلاث مجانًا ضمن المنصة نفسها. لا نقل ملفات، ولا تبديل بين الحسابات.
فجوة الواقعية تضيق بسرعة
قبل ثمانية عشر شهرًا، كانت الرؤوس المتحدثة المجانية بالذكاء الاصطناعي تحمل علامات واضحة: رقبة متصلّبة، ومعدلات رمش غير طبيعية، وزوايا فم مشوّشة. أما اليوم، فنماذج مثل Omni Human 1.5 وKling Avatar v2 تُخرج نتائج تجتاز الفحص العابر للمشاهد. الفجوة بين المجاني والمدفوع أصبحت تتعلق في معظمها بطول المقطع والدقة، لا بالجودة البصرية.
بالنسبة إلى صنّاع المحتوى الفرديين والفرق الصغيرة، وأي شخص يريد إنتاج محتوى فيديو احترافي دون أعباء التصوير، فإن المستوى المجاني خيار عملي فعلًا. الأدوات موجودة. ومسار العمل قصير. والعائق الوحيد هو معرفة من أين تبدأ.
جرّبه الآن
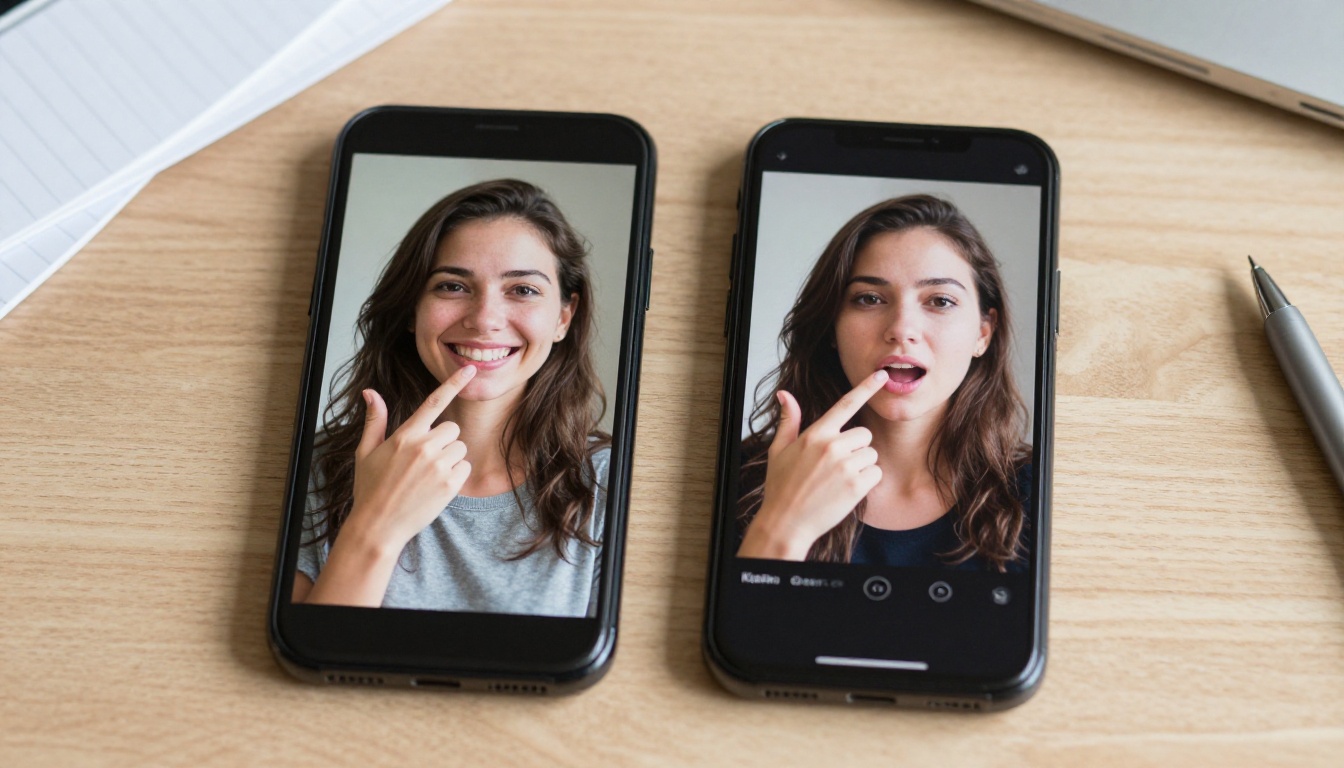
أسرع طريقة لفهم ما تستطيع هذه النماذج فعله هي تشغيل أحدها. اختر صورة تعجبك، وسجّل أو ولّد 10 ثوانٍ من الصوت، ثم شغّلها عبر Omni Human 1.5. تستغرق العملية كلها أقل من 5 دقائق ولا تكلّف شيئًا. بعد ذلك، جرّب نموذجًا مختلفًا على الإدخال نفسه، وقارن المخرجات جنبًا إلى جنب. هذه التجربة وحدها ستخبرك بأكثر مما تخبرك به أي مقالة.
تمنحك PicassoIA الوصول إلى كل نموذج مزامنة شفاه مذكور هنا، إضافةً إلى أدوات تحويل النص إلى صورة وتحويل النص إلى كلام التي تحتاجها لبناء خط إنتاج فيديو اصطناعي كامل من الصفر. إذا كان لديك نص وفكرة لوجه، فلديك كل ما تحتاجه لنشر فيديو رأس متحدث اليوم.


