2027 में एक पॉलिश्ड टॉकिंग हेड वीडियो प्रकाशित करने के लिए आपको कैमरा, ग्रीन स्क्रीन या रिकॉर्डिंग स्टूडियो की ज़रूरत नहीं है। बस एक फ़ोटो और ऑडियो की एक लाइन काफ़ी है। AI लिप सिंक मॉडल अब उस स्तर पर पहुँच चुके हैं जहाँ मुँह की हरकत, सिर का मूवमेंट और पलकें झपकने का समय इतना विश्वसनीय लगता है कि ज़्यादातर दर्शक उसे रिकॉर्ड की गई क्लिप से अलग नहीं पहचान पाते। यह लेख बताता है कि टॉकिंग हेड मुफ़्त में कैसे बनाएँ, कौन से मॉडल सबसे यथार्थवादी नतीजे देते हैं, और प्रकाशित करने से पहले किन बातों का ध्यान रखना चाहिए।
टॉकिंग हेड वीडियो असल में क्या है
टॉकिंग हेड वीडियो ऐसी कोई भी क्लिप है जिसमें चेहरा फ़्रेम के ज़्यादातर हिस्से में होता है और वह सीधे दर्शकों से बात करता दिखता है। इसे न्यूज़ एंकर, YouTube ट्यूटोरियल, प्रोडक्ट एक्सप्लेनर या ऑनलाइन कोर्स के परिचय के रूप में सोचें। यह फ़ॉर्मेट दशकों से मौजूद है, लेकिन AI ने दो चीज़ें बदल दीं: अब सेट पर असली इंसान की ज़रूरत नहीं है, और लागत लगभग शून्य हो गई है।
आज के AI टॉकिंग हेड जेनरेटर एक ऑडियो फ़ाइल का इस्तेमाल करके एक सोर्स इमेज को एनिमेट करके काम करते हैं। मॉडल ऑडियो में मौजूद फ़ोनीम्स के आधार पर अनुमान लगाता है कि होंठ, जबड़ा, गाल और आँखें कैसे हिलनी चाहिए, और फिर उन हरकतों को मूल फ़ोटो पर इतनी समय-संगति के साथ रेंडर करता है कि वे प्राकृतिक मूवमेंट जैसी लगें।
क्रिएटर पारंपरिक वीडियो क्यों छोड़ रहे हैं
इसके व्यावहारिक फ़ायदों से इनकार करना मुश्किल है:
- कैमरे का डर नहीं। जो लोग कैमरे के सामने आने से घबराते हैं, वे भी वीडियो-फ़र्स्ट चैनल बना सकते हैं।
- भाषाओं में विस्तार। वही अवतार स्पेनिश, फ़्रेंच या जापानी में डब करें, बिना हर बाज़ार के लिए कलाकार रखे।
- गति। 60 सेकंड की जो क्लिप बनाने में पूरा फ़िल्मांकन दिन लगता, वह 5 मिनट से कम में तैयार हो सकती है।
- लागत। इस लेख में शामिल ज़्यादातर मॉडल मुफ़्त हैं या उदार फ़्री टियर देते हैं।
वे 3 चीज़ें जो किसी को असली जैसा बनाती हैं
कोई टूल चुनने से पहले यह जानना मददगार है कि एक विश्वसनीय टॉकिंग हेड को अजीब लगने वाले हेड से क्या अलग करता है:
- लिप सिंक की सटीकता सिलेबल स्तर पर नहीं, बल्कि फ़ोनीम स्तर पर। "P" और "B" की आवाज़ों पर होंठ पूरी तरह बंद होने चाहिए।
- प्राकृतिक सिर का मूवमेंट। जो चेहरा कभी नहीं हिलता वह मृत लगता है। हल्के सिर हिलाना, झुकाना और सूक्ष्म बदलाव मायने रखते हैं।
- आँखों का व्यवहार। पलकें झपकने का समय, नज़र की दिशा और प्राकृतिक भटकाव यथार्थवाद बनाते या बिगाड़ते हैं।
2027 के सबसे अच्छे मुफ़्त मॉडल तीनों में कमाल करते हैं। सबसे कमज़ोर मॉडल सिर्फ़ पहली चीज़ पर खरे उतरते हैं।
असल में काम करने वाले टूल (मुफ़्त या फ़्रीमियम)
लिप सिंक और अवतार की दुनिया भीड़भाड़ वाली है, लेकिन अगर यथार्थवाद लक्ष्य है तो गिने-चुने मॉडल ही आपका समय लेने लायक हैं। नीचे यह बताया गया है कि क्या उपलब्ध है और हर एक किस काम में अच्छा है।
फ़ोटो को एनिमेट करने वाले लिप सिंक मॉडल
ये मॉडल एक स्थिर इमेज और ऑडियो लेते हैं और ऐसा वीडियो देते हैं जिसमें चेहरा बोलता दिखता है। कोई एक्टिंग नहीं चाहिए, न ही स्टूडियो लाइटिंग।
ByteDance का Omni Human 1.5 अभी सबसे मज़बूत मुफ़्त विकल्प है। यह लिप सिंक के साथ प्राकृतिक सिर का मूवमेंट देता है, सामने से और थोड़ी तिरछी दोनों तरह की फ़ोटो संभालता है, और अलग-अलग स्किन टोन के साथ अच्छा काम करता है। मूल Omni Human भी उपलब्ध है और छोटी क्लिप के लिए अच्छा काम करता है।
VEED का Fabric 1.0 ख़ास तौर पर सिंगल-फ़ोटो एनिमेशन के लिए बना है। इसकी ताकत मूल फ़ोटो का दृश्य रूप बनाए रखने में है, इसलिए नतीजा किसी दूसरे इंसान जैसा नहीं लगता।
Sync का React 1 मौजूदा वीडियो में यथार्थवादी लिप सिंक जोड़ता है, जो तब काम आता है जब आपके पास पहले से मौजूद फ़ुटेज को दोबारा टाइम करना या नई आवाज़ देना हो। उसी टीम के Lipsync 2 और Lipsync 2 Pro सटीक फ़ोनीम मिलान पर ध्यान देते हैं, और तेज़ बोली या तकनीकी शब्दावली पर कसा हुआ सिंक चाहिए तो इन्हें आज़माना चाहिए।
Kwaivgi का Kling Lip Sync और Pixverse Lipsync दोनों होंठों और ऑडियो के मिलान को अच्छी तरह संभालते हैं और अपने-अपने टेक्स्ट-टू-वीडियो इकोसिस्टम में स्वाभाविक रूप से जुड़ जाते हैं।
वे अवतार टूल जो कैमरे को पूरी तरह छोड़ देते हैं
अगर आप असली फ़ोटो को एनिमेट करने के बजाय पूरा AI अवतार चाहते हैं, तो दो मॉडल अलग दिखते हैं:
HeyGen का Avatar IV पॉलिश्ड टॉकिंग अवतार वीडियो बनाता है, जहाँ AI प्रेज़ेंटर सीधे आपकी स्क्रिप्ट पढ़ता है। आप टेक्स्ट देते हैं, अवतार की शैली चुनते हैं, और बाकी काम मॉडल करता है। उसी टीम का Video Agent एक कदम आगे जाता है और अवतार को कट और b-roll वाले संरचित वीडियो में पैक करता है।
Kwaivgi का Kling Avatar v2 फ़ेस-टू-वीडियो एनिमेशन पर केंद्रित है, जो लंबी क्लिप में भी मज़बूत मूवमेंट संगति देता है।
ByteDance का Dreamactor M2.0 पूरे शरीर के मूवमेंट के साथ किरदारों को एनिमेट करने के लिए बना है, लेकिन इसकी चेहरे की एनिमेशन क्वालिटी टॉकिंग हेड के इस्तेमाल में भी अच्छी तरह काम आती है।
PicassoIA पर Omni Human 1.5 कैसे इस्तेमाल करें
Omni Human 1.5 उन सभी के लिए सुझाया गया शुरुआती बिंदु है जो मुफ़्त में टॉकिंग हेड बनाना चाहते हैं। यह रहा सटीक वर्कफ़्लो।
चरण 1: अपनी बेस फ़ोटो चुनें
फ़ोटो की क्वालिटी अंतिम नतीजे का 80% तय करती है। इन दिशानिर्देशों का इस्तेमाल करें:
- रिज़ॉल्यूशन: छोटी तरफ़ कम से कम 512px। 1024px या उससे ज़्यादा आदर्श है।
- एंगल: सामने से या अधिकतम 30 डिग्री तक एक तरफ़ झुका हुआ। अत्यधिक प्रोफ़ाइल कमज़ोर नतीजे देती हैं।
- लाइटिंग: समान और फैली हुई रोशनी। नाक या ठुड्डी पर कठोर छाया से बचें।
- एक्सप्रेशन: सामान्य या हल्की मुस्कान। सोर्स फ़ोटो में पूरी तरह खुला मुँह मॉडल को भ्रमित करता है।
- बैकग्राउंड: सादा या हल्का धुंधला। भीड़भाड़ वाले बैकग्राउंड सुरक्षित रहते हैं, लेकिन ध्यान भटका सकते हैं।
प्रो टिप: अगर आपके पास कोई पसंदीदा फ़ोटो नहीं है, तो पहले टेक्स्ट-टू-इमेज मॉडल से फ़ोटोरियलिस्टिक पोर्ट्रेट बनाएँ, फिर उसे Omni Human 1.5 में डालें। मॉडल को इस बात की परवाह नहीं कि चेहरा असली है या AI से बना है।
चरण 2: अपना ऑडियो तैयार करें
ऑडियो फ़ाइल पूरी एनिमेशन चलाती है। कुछ ग़ैर-स्पष्ट नियम:
- फ़ॉर्मेट: MP3 या WAV, मोनो या स्टीरियो दोनों चलते हैं।
- लंबाई: लुक सेट करते समय शुरुआती टेस्ट 30 सेकंड से कम रखें।
- स्पष्टता: बैकग्राउंड म्यूज़िक, रीवर्ब और शोर, तीनों लिप सिंक की सटीकता घटाते हैं। साफ़, सूखा वोकल ट्रैक इस्तेमाल करें।
- गति: सामान्य बातचीत की रफ़्तार सबसे अच्छे नतीजे देती है। बहुत तेज़ बोलना या फुसफुसाना फ़ोनीम डिटेक्शन को बिगाड़ सकता है।
अगर आपके पास रिकॉर्ड किया हुआ ऑडियो नहीं है, तो पहले टेक्स्ट-टू-स्पीच मॉडल इस्तेमाल करें। इसके बाद लिप सिंक मॉडल से जोड़ें, ताकि बिना किसी रिकॉर्डिंग के पूरी तरह सिंथेटिक पाइपलाइन बने।
चरण 3: मॉडल चलाएँ
- PicassoIA पर Omni Human 1.5 खोलें।
- Image इनपुट फ़ील्ड में अपनी सोर्स फ़ोटो अपलोड करें।
- Audio इनपुट फ़ील्ड में अपनी ऑडियो फ़ाइल अपलोड करें।
- अपने पहले रन के लिए मोशन स्ट्रेंथ को डिफ़ॉल्ट मध्य स्तर पर रहने दें।
- Generate पर क्लिक करें और इंतज़ार करें। 30 सेकंड से कम की क्लिप आम तौर पर 2 से 4 मिनट में प्रोसेस हो जाती हैं।
- नतीजे का प्रीव्यू देखें। सिर्फ़ मुँह के बीच में नहीं, होंठों के कोनों पर ध्यान दें।
अगर कुछ सही न लगे तो क्या करें
| समस्या | संभावित कारण | समाधान |
|---|
| "B" और "P" की आवाज़ों पर होंठ बंद नहीं होते | शोर वाला ऑडियो | ऑडियो ट्रैक साफ़ करें और दोबारा चलाएँ |
| सिर पूरी तरह स्थिर है | मोशन स्ट्रेंथ बहुत कम है | मोशन स्ट्रेंथ 0.7 या उससे ज़्यादा करें |
| मुँह के किनारों पर चेहरा टेढ़ा होता है | सोर्स फ़ोटो में अत्यधिक एंगल | ज़्यादा सामने से ली गई फ़ोटो इस्तेमाल करें |
| बैकग्राउंड झिलमिलाता है | मॉडल जटिल बैकग्राउंड से जूझ रहा है | फ़ोटो को चेहरे के और कसे फ़्रेम में क्रॉप करें |
| ऑडियो और मुँह में हल्का अंतर है | ऑडियो की शुरुआत में ख़ामोशी है | पहले शब्द से पहले की ख़ामोशी ट्रिम करें |
टिप: 2 मिनट की जनरेशन से पहले 5 सेकंड की टेस्ट क्लिप चलाएँ। इससे समय बचता है और समस्याएँ बढ़ने से पहले ठीक की जा सकती हैं।
सबसे अच्छे मुफ़्त लिप सिंक मॉडल की तुलना
हर मॉडल एक ही इस्तेमाल के लिए नहीं बना है। शीर्ष विकल्पों की आपस में तुलना यहाँ है:
सार यह है: Omni Human 1.5 शुद्ध टॉकिंग हेड जनरेशन के लिए सबसे अच्छा शुरुआती बिंदु है। Lipsync 2 Pro तब बेहतर चुनाव है जब आप मौजूदा फ़ुटेज को नई आवाज़ दे रहे हों या डब कर रहे हों और फ़ोनीम सटीकता अहम हो।
5 प्रॉम्प्ट जो शानदार टॉकिंग हेड बनाते हैं
अगर आप एनिमेट करने से पहले AI इमेज मॉडल से बेस पोर्ट्रेट बना रहे हैं, तो ये प्रॉम्प्ट स्ट्रक्चर लगातार ऐसी फ़ोटो देते हैं जो लिप सिंक मॉडल के साथ अच्छा काम करती हैं:
-
प्रोफ़ेशनल प्रेज़ेंटर: "30 के दशक में एक [ethnicity] महिला का पोर्ट्रेट, हल्की मुस्कान, सामने से, नरम स्टूडियो लाइटिंग, सपाट ग्रे बैकग्राउंड, फ़ोटोरियलिस्टिक, 85mm लेंस, शैलो डेप्थ ऑफ़ फ़ील्ड"
-
कैज़ुअल क्रिएटर: "कैज़ुअल शर्ट में एक युवा पुरुष, सीधा आई कॉन्टैक्ट, बाईं ओर से गर्म प्राकृतिक खिड़की की रोशनी, होम ऑफ़िस बैकग्राउंड नरमी से धुंधला, Kodak Portra 400 स्टाइल, सामने से पोर्ट्रेट"
-
कॉर्पोरेट प्रवक्ता: "नेवी ब्लेज़र में एक प्रोफ़ेशनल पुरुष, आत्मविश्वास भरा सामान्य एक्सप्रेशन, हल्का 15 डिग्री एंगल, साफ़ सफ़ेद बैकग्राउंड, एडिटोरियल पोर्ट्रेट, 8K फ़ोटोरियलिस्टिक"
-
शिक्षक या इंस्ट्रक्टर: "चश्मे वाली 40 के दशक की एक महिला, गर्म और मिलनसार एक्सप्रेशन, पीछे किताबों की अलमारियाँ नरमी से धुंधली, प्राकृतिक दिन की रोशनी, सामने से हेडशॉट"
-
ब्रांड अवतार: "जेंडर-न्यूट्रल व्यक्ति, चिकनी समान त्वचा, कैमरे की सीधी नज़र, हल्के नीले रंग का सादा ग्रेडिएंट बैकग्राउंड, क्लीन कमर्शियल पोर्ट्रेट स्टाइल, अत्यधिक विस्तृत फ़ोटोरियलिस्टिक"
नोट: "सामने से" निर्देश सबसे प्रभावी जोड़ है। अकेला यही खराब लिप सिंक नतीजों को आधा कर देता है।
फ़्री टियर की सीमाएँ कैसी होती हैं
मुफ़्त पहुँच असली है, लेकिन यह असीमित नहीं है। क्या उम्मीद करनी है, यह जानने से प्रोजेक्ट के बीच में झुंझलाहट से बचाव होता है।
रिज़ॉल्यूशन और अवधि
ज़्यादातर फ़्री टियर आउटपुट को 720p तक सीमित करते हैं और हर जनरेशन में क्लिप की लंबाई 30 से 60 सेकंड तक रखते हैं। सोशल मीडिया क्लिप, YouTube Shorts या कोर्स प्रीव्यू के लिए यह आम तौर पर काफ़ी है। लंबे एक्सप्लेनर वीडियो या हाई-रिज़ॉल्यूशन ब्रॉडकास्ट कंटेंट के लिए आम तौर पर पेड प्लान चाहिए।
वॉटरमार्क और क्रेडिट
कुछ मॉडल मुफ़्त आउटपुट पर हल्का वॉटरमार्क जोड़ते हैं। अंतिम एडिट से पहले पूरे रिज़ॉल्यूशन पर प्रीव्यू देख लें। PicassoIA के ज़रिए इस्तेमाल किए गए मॉडल अक्सर स्टैंडअलोन ऐप से साफ़ फ़्री आउटपुट देते हैं, क्योंकि API लेयर ज़्यादातर ब्रांडिंग प्रतिबंधों को छिपा देती है।
क्रेडिट सिस्टम अलग-अलग होते हैं। PicassoIA पर ज़्यादातर मॉडल हर जनरेशन में कुछ क्रेडिट लेते हैं, और नए खातों को 10 से 20 पूरी लंबाई की टेस्ट क्लिप चलाने जितने क्रेडिट मिलते हैं, उसके बाद टॉप-अप की ज़रूरत पड़ती है।
कब कौन सा मॉडल इस्तेमाल करें
सही टूल चुनना इस पर निर्भर करता है कि आप किससे शुरू कर रहे हैं और अंत में आपको क्या चाहिए:
फ़ोटो और ऑडियो फ़ाइल से शुरू करना: पहले Omni Human 1.5 इस्तेमाल करें। अगर नतीजे को ज़्यादा सटीक होंठ-परिशुद्धता चाहिए, तो Lipsync 2 Pro पर जाएँ।
सिर्फ़ टेक्स्ट स्क्रिप्ट से शुरू करना: पहले टेक्स्ट-टू-स्पीच मॉडल से ऑडियो बनाएँ, फिर उसे Omni Human 1.5 या Fabric 1.0 में डालें।
मौजूदा वीडियो को दूसरी भाषा में डब करना: HeyGen का Lipsync Precision या Video Translate इस्तेमाल करें, जो दोनों 150 से ज़्यादा भाषाएँ संभालते हैं।
बिना असली फ़ोटो के पूरा AI अवतार प्रेज़ेंटर बनाना: बेस किरदार बनाने के लिए Avatar IV या Dreamactor M2.0 से शुरू करें, फिर लिप सिंक मॉडल से एनिमेट करें।
पहले से मौजूद वीडियो में ऑडियो सिंक करना: React 1 या Kling Lip Sync सबसे भरोसेमंद विकल्प हैं।
वर्कफ़्लो टिप: सबसे कुशल पाइपलाइन यह है: टेक्स्ट-टू-इमेज मॉडल से पोर्ट्रेट बनाएँ, टेक्स्ट-टू-स्पीच मॉडल से आवाज़ बनाएँ, और लिप सिंक मॉडल से एनिमेट करें। तीनों चरण एक ही प्लेटफ़ॉर्म पर मुफ़्त में हो सकते हैं। कोई फ़ाइल ट्रांसफ़र नहीं, कई अकाउंट संभालने की झंझट नहीं।
यथार्थवाद का अंतर तेज़ी से घट रहा है
अठारह महीने पहले, मुफ़्त AI टॉकिंग हेड में आसानी से पहचान में आने वाले संकेत होते थे: अकड़ी हुई गर्दन, अप्राकृतिक पलक दर और धुंधले मुँह के कोने। आज Omni Human 1.5 और Kling Avatar v2 जैसे मॉडल ऐसा आउटपुट दे रहे हैं जो आम दर्शक की जाँच में पास हो जाता है। अब मुफ़्त और पेड के बीच का अंतर ज़्यादातर क्लिप की लंबाई और रिज़ॉल्यूशन का है, विज़ुअल क्वालिटी का नहीं।
सोलो क्रिएटर, छोटी टीमों और उन सभी के लिए जो बिना फ़िल्मांकन के झंझट के प्रोफ़ेशनल वीडियो कंटेंट बनाना चाहते हैं, मुफ़्त टियर सचमुच व्यावहारिक है। टूल मौजूद हैं। वर्कफ़्लो छोटा है। बाधा सिर्फ़ यह जानना है कि शुरुआत कहाँ से करें।
अभी आज़माएँ
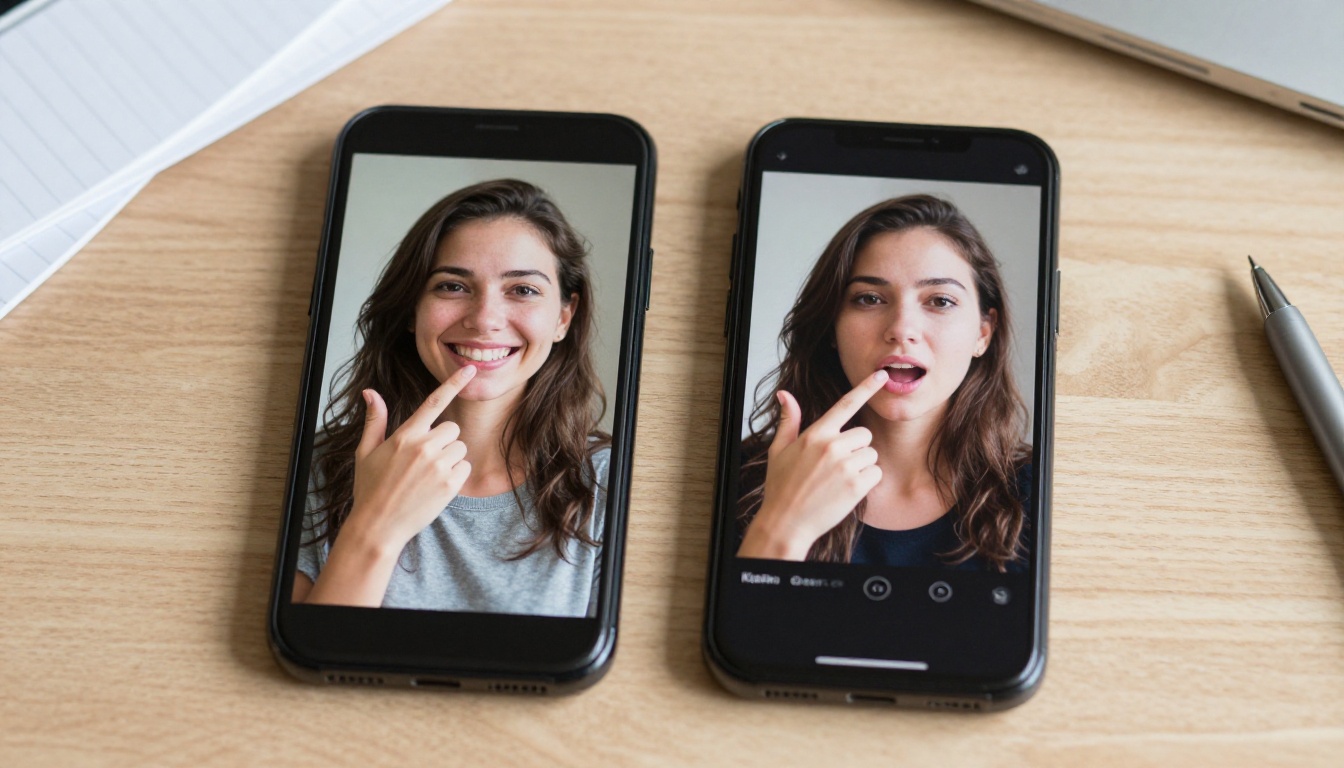
इन मॉडलों की क्षमता समझने का सबसे तेज़ तरीका है एक को चलाकर देखना। एक फ़ोटो चुनें जो आपको पसंद हो, 10 सेकंड का ऑडियो रिकॉर्ड करें या बनाएँ, और उसे Omni Human 1.5 से चलाएँ। पूरी प्रक्रिया 5 मिनट से कम में हो जाती है और इसमें कोई खर्च नहीं होता। इसके बाद उसी इनपुट पर कोई दूसरा मॉडल चलाएँ और दोनों आउटपुट साथ-साथ देखें। यह एक प्रयोग आपको किसी भी लेख से ज़्यादा बता देगा।
PicassoIA आपको यहाँ कवर किए गए हर लिप सिंक मॉडल के साथ-साथ वे टेक्स्ट-टू-इमेज और टेक्स्ट-टू-स्पीच टूल देता है जिनकी ज़रूरत शुरू से एक पूरी सिंथेटिक वीडियो पाइपलाइन बनाने के लिए होती है। अगर आपके पास स्क्रिप्ट और किसी चेहरे का विचार है, तो आज ही टॉकिंग हेड वीडियो प्रकाशित करने के लिए आपके पास सब कुछ है।


