No necesitas una cámara, una pantalla verde ni un estudio de grabación para publicar un video de cabeza parlante pulido en 2027. Basta con una foto y una pista de audio. Los modelos de IA de sincronización labial han llegado a un punto en el que el movimiento de la boca, el de la cabeza y el parpadeo resultan lo bastante convincentes como para que la mayoría de los espectadores no distinga el resultado de un clip grabado. Este artículo explica paso a paso cómo generar cabezas parlantes gratis, qué modelos producen los resultados más realistas y qué debes tener en cuenta antes de publicar.
Qué es realmente un video de cabeza parlante
Un video de cabeza parlante es cualquier clip en el que un rostro ocupa la mayor parte del encuadre y parece hablar directamente al público. Piensa en un presentador de noticias, un tutorial de YouTube, un video explicativo de producto o la introducción de un curso en línea. El formato lleva décadas existiendo, pero la IA cambió dos cosas: ya no necesitas a una persona real frente a la cámara y el costo bajó a cero.
Los generadores actuales de cabezas parlantes con IA animan una imagen de origen usando un archivo de audio. El modelo predice cómo deben moverse los labios, la mandíbula, las mejillas y los ojos según los fonemas del audio, y después plasma esos movimientos sobre la foto original con suficiente coherencia temporal como para que parezcan un movimiento natural.
Por qué los creadores dejan atrás el video tradicional
Las ventajas prácticas son difíciles de discutir:
- Sin ansiedad ante la cámara. Quienes odian salir en cámara pueden crear un canal centrado en el video.
- Adaptación a varios idiomas. Dobla el mismo avatar al español, francés o japonés sin contratar a un actor en cada mercado.
- Velocidad. Un clip de 60 segundos que requeriría un día entero de rodaje puede estar listo en menos de 5 minutos.
- Costo. La mayoría de los modelos que se tratan en este artículo son gratuitos o tienen niveles gratuitos generosos.
Las 3 cosas que hacen que uno se vea real
Antes de elegir una herramienta, conviene saber qué separa a una cabeza parlante convincente de una inquietante:
- Precisión de la sincronización labial a nivel de fonema, no solo de sílaba. Los sonidos "p" y "b" deben cerrar los labios por completo.
- Movimiento natural de la cabeza. Un rostro que nunca se mueve parece sin vida. Los asentimientos sutiles, las inclinaciones y los micro-desplazamientos importan.
- Comportamiento de los ojos. El momento del parpadeo, la dirección de la mirada y los desplazamientos naturales determinan el realismo.
Los mejores modelos gratuitos de 2027 cumplen con los tres puntos. Los más débiles solo cumplen con el primero.
Las herramientas que realmente funcionan (gratuitas o freemium)
El espacio de la sincronización labial y los avatares está saturado, pero solo unos pocos modelos merecen tu tiempo si el objetivo es el realismo. A continuación, un desglose de lo que está disponible y lo que hace bien cada uno.
Modelos de sincronización labial que animan una foto
Estos modelos toman una imagen fija más audio y generan un video en el que el rostro parece hablar. No hace falta actuar ni iluminación de estudio.
Omni Human 1.5 de ByteDance es, por ahora, la opción gratuita más potente. Produce un movimiento natural de la cabeza junto con la sincronización labial, maneja tanto fotos de frente como ligeramente giradas y trabaja bien con distintos tonos de piel. El Omni Human original también está disponible y funciona bien para clips más cortos.
Fabric 1.0 de VEED está diseñado específicamente para animar a partir de una sola foto. Su punto fuerte es conservar la estética de la foto original, de modo que el resultado no parece otra persona.
React 1 de Sync añade sincronización labial realista a un video existente, útil si quieres ajustar los tiempos, volver a grabar la locución o doblar material que ya tienes. Lipsync 2 y Lipsync 2 Pro, del mismo equipo, se centran en la coincidencia precisa de fonemas y merecen la pena si necesitas una sincronización ajustada en habla rápida o terminología técnica.
Kling Lip Sync de Kwaivgi y Pixverse Lipsync gestionan bien la coincidencia entre la boca y el audio, y se integran de forma natural con sus respectivos ecosistemas de texto a video.
Herramientas de avatares que prescinden de la cámara por completo
Si quieres un avatar de IA completo en lugar de animar una foto real, destacan dos modelos:
Avatar IV de HeyGen crea videos de avatares parlantes pulidos en los que el presentador de IA dice tu guion directamente. Tú aportas el texto, eliges el estilo del avatar y el modelo se encarga del resto. Video Agent, del mismo equipo, va más allá y empaqueta el avatar en un video estructurado con cortes y material de apoyo (b-roll).
Kling Avatar v2 de Kwaivgi se centra en la animación de rostro a video con una coherencia de movimiento sólida en clips más largos.
Dreamactor M2.0 de ByteDance está diseñado para animar personajes con movimiento de cuerpo completo, pero la calidad de su animación facial también sirve bien para cabezas parlantes.
Cómo usar Omni Human 1.5 en PicassoIA
Omni Human 1.5 es el punto de partida recomendado para quien quiera generar cabezas parlantes gratis. Este es el flujo de trabajo exacto.
Paso 1: elige tu foto base
La calidad de la foto determina el 80 % del resultado final. Usa estas pautas:
- Resolución: 512 px como mínimo en el lado corto. Lo ideal es 1024 px o más.
- Ángulo: de frente o hasta 30 grados fuera del centro. Los perfiles extremos producen resultados débiles.
- Iluminación: luz uniforme y difusa. Evita sombras duras sobre la nariz o el mentón.
- Expresión: neutra o una leve sonrisa. Las bocas muy abiertas en la foto original confunden al modelo.
- Fondo: sencillo o ligeramente desenfocado. Los fondos cargados se conservan, pero pueden distraer.
Consejo profesional: si no tienes una foto que te guste, usa primero un modelo de texto a imagen para generar un retrato fotorrealista y después introdúcelo en Omni Human 1.5. Al modelo no le importa si el rostro es real o generado por IA.
Paso 2: prepara tu audio
El archivo de audio controla toda la animación. Algunas reglas que no son evidentes:
- Formato: MP3 o WAV; funcionan tanto mono como estéreo.
- Duración: mantén las pruebas iniciales por debajo de 30 segundos mientras ajustas el aspecto.
- Claridad: la música de fondo, la reverberación y el ruido degradan la precisión de la sincronización labial. Usa una pista de voz limpia y seca.
- Ritmo: la velocidad de conversación normal da los mejores resultados. El habla muy rápida o el susurro pueden desajustar la detección de fonemas.
Si no tienes audio grabado, usa primero un modelo de texto a voz. Combínalo después con un modelo de sincronización labial para crear un flujo totalmente sintético, sin grabar nada.
Paso 3: ejecuta el modelo
- Abre Omni Human 1.5 en PicassoIA.
- Sube tu foto de origen en el campo de entrada Image.
- Sube tu archivo de audio en el campo de entrada Audio.
- Deja la intensidad de movimiento en el valor medio para tu primera ejecución.
- Haz clic en Generate y espera. Los clips de menos de 30 segundos suelen procesarse en 2 a 4 minutos.
- Revisa el resultado. Fíjate en las comisuras de los labios, no solo en el centro de la boca.
Qué hacer si algo no encaja
| Problema | Causa probable | Solución |
|---|
| Los labios no se cierran en los sonidos "B" y "P" | Audio con ruido | Limpia la pista de audio y vuelve a ejecutar |
| La cabeza está completamente quieta | Intensidad de movimiento demasiado baja | Sube la intensidad de movimiento a 0,7 o más |
| El rostro se deforma en los bordes de la boca | Ángulo extremo en la foto de origen | Usa una foto más frontal |
| El fondo parpadea | El modelo tiene dificultades con un fondo complejo | Recorta la foto para encuadrar más de cerca el rostro |
| El audio y la boca están ligeramente desfasados | El audio tiene silencio al principio | Recorta el silencio antes de la primera palabra |
Consejo: genera un clip de prueba de 5 segundos antes de comprometerte con una generación de 2 minutos. Así ahorras tiempo y corriges los problemas antes de que se acumulen.
Comparación de los mejores modelos gratuitos de sincronización labial
No todos los modelos están pensados para el mismo caso de uso. Así se comparan las mejores opciones:
La conclusión: Omni Human 1.5 es el mejor punto de partida para la generación pura de cabezas parlantes. Lipsync 2 Pro es la mejor opción cuando vuelves a locutar o doblar material existente y la precisión de fonemas es crítica.
5 prompts que producen cabezas parlantes excelentes
Si generas el retrato base con un modelo de imagen de IA antes de animarlo, estas estructuras de prompt producen de forma constante fotos que funcionan bien con los modelos de sincronización labial:
-
Presentador profesional: "Retrato de una mujer de [etnia] de unos 30 años, leve sonrisa, de frente, iluminación de estudio suave, fondo gris neutro, fotorrealista, lente de 85 mm, profundidad de campo reducida"
-
Creador casual: "Hombre joven con camisa informal, contacto visual directo, luz natural cálida de una ventana por la izquierda, fondo de oficina en casa ligeramente desenfocado, estilo Kodak Portra 400, retrato de frente"
-
Portavoz corporativo: "Hombre profesional con blazer azul marino, expresión neutra y segura, ángulo leve de 15 grados, fondo blanco limpio, retrato editorial, fotorrealista en 8K"
-
Educador o instructor: "Mujer de unos 40 años con gafas, expresión cálida y cercana, estanterías de libros ligeramente desenfocadas detrás, luz de día natural, foto de perfil de frente"
-
Avatar de marca: "Persona de género neutro, piel uniforme y suave, mirada directa a la cámara, fondo degradado liso en azul claro, estilo de retrato comercial limpio, fotorrealista muy detallado"
Nota: la indicación "de frente" es la adición con más impacto. Por sí sola reduce a la mitad los malos resultados de sincronización labial.
Cómo son los límites del nivel gratuito
El acceso gratuito es real, pero no es ilimitado. Saber qué esperar evita frustraciones a mitad de un proyecto.
Resolución y duración
La mayoría de los niveles gratuitos limitan la salida a 720p y la duración del clip a entre 30 y 60 segundos por generación. Para clips de redes sociales, YouTube Shorts o adelantos de cursos, normalmente basta de sobra. Los videos explicativos más largos o el contenido de difusión en alta resolución suelen requerir un plan de pago.
Marcas de agua y créditos
Algunos modelos añaden una marca de agua discreta a la salida gratuita. Revisa la vista previa a resolución completa antes de comprometerte con la edición final. Los modelos accesibles a través de PicassoIA suelen tener una salida gratuita más limpia que las aplicaciones independientes, porque la capa de API elimina la mayoría de las restricciones de marca.
Los sistemas de créditos varían. La mayoría de los modelos de PicassoIA consumen una pequeña cantidad de créditos por generación, y las cuentas nuevas reciben créditos suficientes para ejecutar entre 10 y 20 clips de prueba completos antes de tener que recargar.
Cuándo usar cada modelo
Elegir la herramienta adecuada depende de con qué empiezas y de lo que necesitas al final:
Si partes de una foto y un archivo de audio: usa primero Omni Human 1.5. Si el resultado necesita una precisión labial más ajustada, cambia a Lipsync 2 Pro.
Si partes solo de un guion de texto: usa un modelo de texto a voz para generar primero el audio y luego pásalo a Omni Human 1.5 o Fabric 1.0.
Si quieres doblar un video existente a otro idioma: usa Lipsync Precision de HeyGen o Video Translate, ambos compatibles con más de 150 idiomas.
Si quieres crear un presentador de IA completo sin una foto real: empieza con Avatar IV o Dreamactor M2.0 para crear el personaje base y luego anímalo con un modelo de sincronización labial.
Si quieres sincronizar audio con un video que ya tienes: React 1 o Kling Lip Sync son las opciones más fiables.
Consejo de flujo de trabajo: el proceso más eficiente es: generar el retrato con un modelo de texto a imagen, generar la voz con un modelo de texto a voz y animarlo con un modelo de sincronización labial. Los tres pasos pueden hacerse gratis dentro de la misma plataforma. Sin transferencias de archivos ni malabares con cuentas.
La brecha de realismo se cierra rápido
Hace dieciocho meses, las cabezas parlantes gratuitas de IA tenían señales delatoras: cuello rígido, ritmo de parpadeo antinatural, comisuras de la boca borrosas. Hoy, modelos como Omni Human 1.5 y Kling Avatar v2 ofrecen resultados que superan la inspección casual de un espectador. La diferencia entre lo gratuito y lo de pago depende ahora sobre todo de la duración del clip y la resolución, no de la calidad visual.
Para creadores independientes, equipos pequeños y cualquiera que quiera producir contenido de video profesional sin el trabajo extra que supone rodar, el nivel gratuito es realmente viable. Las herramientas existen. El flujo de trabajo es corto. La barrera es saber por dónde empezar.
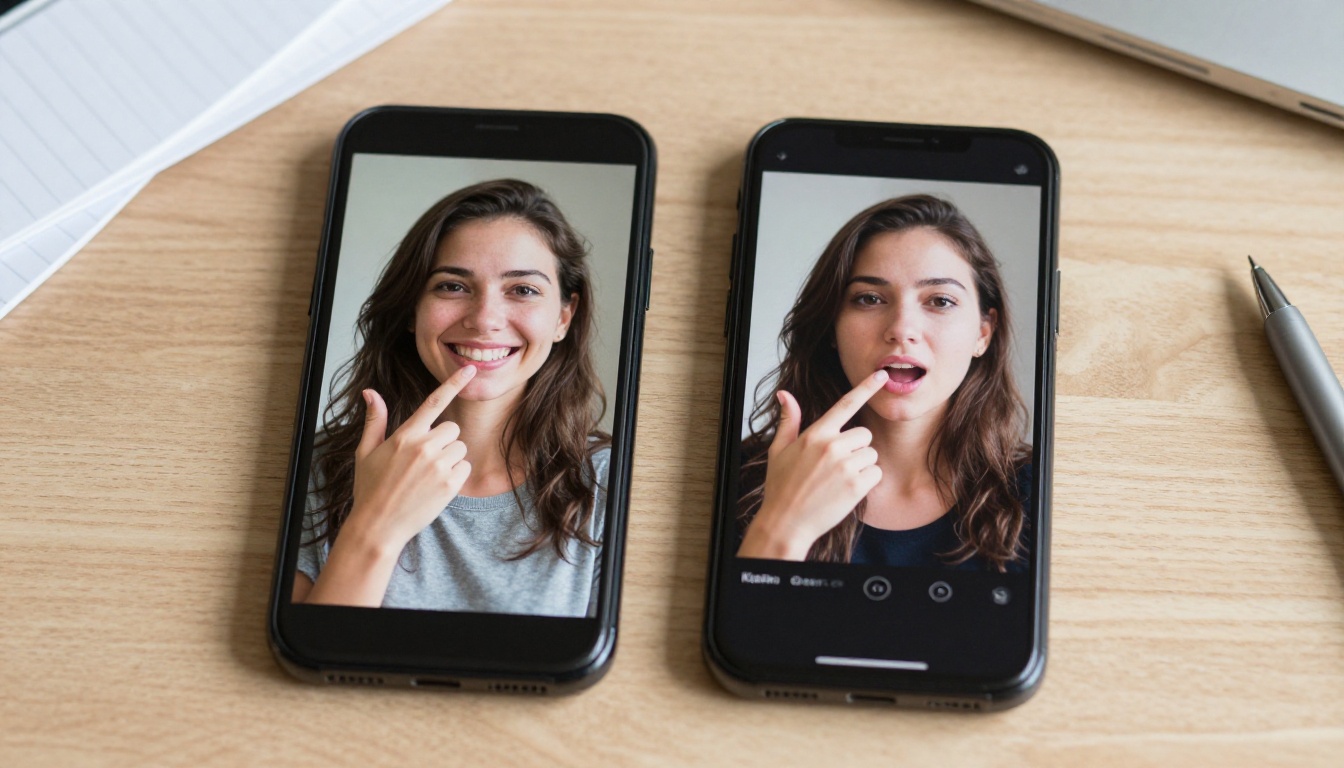
Pruébalo ahora
La forma más rápida de entender lo que pueden hacer estos modelos es usar uno. Elige una foto que te guste, graba o genera 10 segundos de audio y procésalos con Omni Human 1.5. Todo el proceso dura menos de 5 minutos y no cuesta nada. Después, prueba otro modelo con la misma entrada y compara los resultados lado a lado. Ese único experimento te dirá más que cualquier artículo.
PicassoIA te da acceso a todos los modelos de sincronización labial que se tratan aquí, además de las herramientas de texto a imagen y de texto a voz que necesitas para construir un flujo completo de video sintético desde cero. Si tienes un guion y una idea para un rostro, tienes todo lo necesario para publicar un video de cabeza parlante hoy mismo.


