Vous n’avez besoin ni de caméra, ni d’écran vert, ni de studio d’enregistrement pour publier une vidéo de tête parlante soignée en 2027. Une seule photo et une piste audio suffisent. Les modèles de synchronisation labiale par IA sont désormais assez convaincants : le mouvement de la bouche, les mouvements de la tête et le timing des clignements sont tels que la plupart des spectateurs ne peuvent pas distinguer le résultat d’une vidéo filmée. Cet article explique pas à pas comment générer gratuitement des têtes parlantes, quels modèles donnent les résultats les plus réalistes, et ce qu’il faut surveiller avant de publier.
Qu’est-ce qu’une vidéo de tête parlante ?
Une vidéo de tête parlante est tout clip où un visage occupe la majeure partie du cadre et semble s’adresser directement au public. Pensez au présentateur d’un journal, à un tutoriel YouTube, à une présentation de produit ou à l’introduction d’un cours en ligne. Ce format existe depuis des décennies, mais l’IA a changé deux choses : vous n’avez plus besoin d’une vraie personne sur le plateau, et le coût est tombé à zéro.
Les générateurs de têtes parlantes par IA d’aujourd’hui animent une image source à partir d’un fichier audio. Le modèle prédit comment les lèvres, la mâchoire, les joues et les yeux doivent bouger en fonction des phonèmes contenus dans l’audio, puis il applique ces mouvements à la photo d’origine avec une cohérence temporelle suffisante pour paraître naturels.
Pourquoi les créateurs délaissent la vidéo traditionnelle
Les avantages pratiques sont difficiles à contester :
- Aucune appréhension de la caméra. Les personnes qui détestent être filmées peuvent tout de même créer une chaîne axée sur la vidéo.
- Adaptation à plusieurs langues. Doublez le même avatar en espagnol, en français ou en japonais sans engager de comédiens sur chaque marché.
- Rapidité. Un clip de 60 secondes qui demanderait une journée entière de tournage peut être prêt en moins de 5 minutes.
- Coût. La plupart des modèles présentés dans cet article sont gratuits ou proposent des offres gratuites généreuses.
Les 3 éléments qui rendent une tête parlante réaliste
Avant de choisir un outil, il est utile de savoir ce qui distingue une tête parlante convaincante d’une tête qui met mal à l’aise :
- Précision de la synchronisation labiale au niveau du phonème, et pas seulement de la syllabe. Les sons « p » et « b » doivent fermer complètement les lèvres.
- Mouvements naturels de la tête. Un visage qui ne bouge jamais paraît sans vie. Les légers hochements, inclinaisons et micro-déplacements comptent.
- Comportement des yeux. Le timing des clignements, la direction du regard et les dérives naturelles font ou défont le réalisme.
Les meilleurs modèles gratuits de 2027 maîtrisent les trois. Les moins bons ne maîtrisent que le premier.
Les outils qui fonctionnent vraiment (gratuits ou freemium)
L’univers de la synchronisation labiale et des avatars est encombré, mais seule une poignée de modèles mérite votre temps si le réalisme est l’objectif. Voici ce qui est disponible et ce que fait bien chacun d’entre eux.
Modèles de synchronisation labiale qui animent une photo
Ces modèles prennent une image fixe et un audio, puis produisent une vidéo où le visage semble parler. Aucun jeu d’acteur ni éclairage de studio n’est nécessaire.
Omni Human 1.5 de ByteDance est actuellement la meilleure option gratuite. Il produit des mouvements de tête naturels en plus de la synchronisation labiale, gère aussi bien les photos de face que les photos légèrement de trois quarts, et s’adapte bien à différentes teintes de peau. Omni Human d’origine est également disponible et donne de bons résultats pour les clips courts.
Fabric 1.0 de VEED est conçu spécifiquement pour animer une seule photo. Sa force est de préserver l’esthétique de la photo d’origine, si bien que le résultat ne donne pas l’impression d’être une autre personne.
React 1 de Sync ajoute une synchronisation labiale réaliste à une vidéo existante, ce qui est utile si vous voulez modifier le rythme ou refaire la voix d’une séquence que vous avez déjà. Lipsync 2 et Lipsync 2 Pro, de la même équipe, misent sur la précision de l’appariement des phonèmes et valent la peine d’être testés si vous avez besoin d’une synchronisation serrée sur une parole rapide ou un vocabulaire technique.
Kling Lip Sync de Kwaivgi et Pixverse Lipsync gèrent tous deux bien l’appariement entre la bouche et l’audio, et s’intègrent naturellement à leurs écosystèmes respectifs de texte vers vidéo.
Outils d’avatars qui se passent complètement de caméra
Si vous voulez un avatar IA complet plutôt qu’animer une vraie photo, deux modèles se distinguent :
Avatar IV de HeyGen crée des vidéos d’avatars parlants soignées, où le présentateur IA délivre directement votre script. Vous fournissez le texte, choisissez le style de l’avatar, et le modèle s’occupe du reste. Video Agent, de la même équipe, va plus loin et intègre l’avatar dans une vidéo structurée avec des coupes et des plans d’illustration.
Kling Avatar v2 de Kwaivgi se concentre sur l’animation de visage en vidéo, avec une forte cohérence du mouvement sur des clips plus longs.
Dreamactor M2.0 de ByteDance est conçu pour animer des personnages en mouvement corporel complet, mais la qualité de son animation faciale s’applique aussi bien aux usages de têtes parlantes.
Omni Human 1.5 est le point de départ recommandé pour quiconque génère gratuitement des têtes parlantes. Voici le flux de travail exact.
Étape 1 : choisissez votre photo de base
La qualité de la photo détermine 80 % du résultat final. Suivez ces recommandations :
- Résolution : 512 px minimum pour le plus petit côté. 1024 px ou plus est idéal.
- Angle : de face, ou jusqu’à 30 degrés de décalage. Les profils extrêmes donnent des résultats faibles.
- Éclairage : une lumière uniforme et diffuse. Évitez les ombres marquées sur le nez ou le menton.
- Expression : neutre ou léger sourire. Une bouche grande ouverte sur la photo source perturbe le modèle.
- Arrière-plan : simple ou légèrement flou. Les arrière-plans chargés sont conservés mais peuvent distraire.
Astuce pro : si vous n’avez pas de photo qui vous satisfait, utilisez d’abord un modèle de texte vers image pour générer un portrait photoréaliste, puis donnez-le à Omni Human 1.5. Le modèle ne se soucie pas de savoir si le visage est réel ou généré par IA.
Étape 2 : préparez votre audio
Le fichier audio pilote toute l’animation. Quelques règles peu évidentes :
- Format : MP3 ou WAV, mono ou stéréo fonctionnent tous deux.
- Durée : limitez les premiers tests à moins de 30 secondes le temps de régler le rendu.
- Clarté : la musique de fond, la réverbération et le bruit dégradent la précision de la synchronisation labiale. Utilisez une piste vocale propre et sèche.
- Rythme : une vitesse de parole conversationnelle normale donne les meilleurs résultats. Une parole très rapide ou un chuchotement peuvent fausser la détection des phonèmes.
Si vous n’avez pas d’audio enregistré, utilisez d’abord un modèle de synthèse vocale. Combinez-le ensuite avec un modèle de synchronisation labiale pour obtenir un pipeline entièrement synthétique, sans aucun enregistrement.
Étape 3 : lancez le modèle
- Ouvrez Omni Human 1.5 sur PicassoIA.
- Importez votre photo source dans le champ Image.
- Importez votre fichier audio dans le champ Audio.
- Laissez l’intensité du mouvement par défaut, sur le réglage médian, pour votre premier essai.
- Cliquez sur Generate et patientez. Les clips de moins de 30 secondes se traitent généralement en 2 à 4 minutes.
- Prévisualisez le résultat. Regardez les commissures des lèvres, pas seulement le centre de la bouche.
Que faire si le résultat semble décalé
| Problème | Cause probable | Solution |
|---|
| Les lèvres ne se ferment pas sur les sons « B » et « P » | Audio bruité | Nettoyez la piste audio et relancez |
| La tête est complètement immobile | Intensité du mouvement trop faible | Augmentez l’intensité du mouvement à 0,7 ou plus |
| Le visage se déforme aux bords de la bouche | Angle extrême sur la photo source | Utilisez une photo plus frontale |
| L’arrière-plan scintille | Le modèle peine avec un arrière-plan complexe | Recadrez la photo sur le visage de plus près |
| L’audio et la bouche sont légèrement décalés | L’audio commence par un silence | Coupez le silence avant le premier mot |
Conseil : lancez un clip test de 5 secondes avant de vous engager dans une génération de 2 minutes. Cela vous fait gagner du temps et vous permet de corriger les problèmes avant qu’ils ne s’accumulent.
Comparaison des meilleurs modèles de synchronisation labiale gratuits
Tous les modèles ne sont pas conçus pour le même usage. Voici comment se situent les meilleures options :
En résumé : Omni Human 1.5 est le meilleur point de départ pour la génération pure de têtes parlantes. Lipsync 2 Pro est le choix le plus judicieux lorsque vous refaites la voix ou doublez une séquence existante et que la précision phonétique est essentielle.
5 prompts qui produisent de bonnes têtes parlantes
Si vous générez le portrait de base avec un modèle d’image par IA avant de l’animer, ces structures de prompt donnent régulièrement des photos qui fonctionnent bien avec les modèles de synchronisation labiale :
-
Présentatrice professionnelle : « Portrait d’une femme [origine ethnique] dans la trentaine, léger sourire, de face, éclairage de studio doux, fond gris neutre, photoréaliste, objectif 85 mm, faible profondeur de champ »
-
Créateur décontracté : « Jeune homme en chemise décontractée, contact visuel direct, lumière naturelle chaude venant d’une fenêtre à gauche, arrière-plan de bureau à domicile légèrement flou, style Kodak Portra 400, portrait de face »
-
Porte-parole d’entreprise : « Homme professionnel en blazer bleu marine, expression neutre et assurée, léger angle de 15 degrés, fond blanc épuré, portrait éditorial, 8K photoréaliste »
-
Éducatrice ou formateur : « Femme dans la quarantaine avec des lunettes, expression chaleureuse et accessible, bibliothèque légèrement floue en arrière-plan, lumière naturelle du jour, portrait de face en gros plan »
-
Avatar de marque : « Personne au genre neutre, peau lisse et uniforme, regard direct vers la caméra, fond en dégradé uni bleu clair, style portrait commercial épuré, photoréaliste très détaillé »
Remarque : l’instruction « de face » est l’ajout le plus efficace. À lui seul, il réduit de moitié les mauvais résultats de synchronisation labiale.
À quoi ressemblent les limites des offres gratuites
L’accès gratuit est réel, mais il n’est pas illimité. Savoir à quoi s’attendre évite les frustrations en cours de projet.
Résolution et durée
La plupart des offres gratuites limitent la sortie à 720p et la durée des clips à 30 à 60 secondes par génération. Pour les clips destinés aux réseaux sociaux, aux YouTube Shorts ou aux aperçus de cours, c’est généralement largement suffisant. Les vidéos explicatives plus longues ou les contenus haute résolution destinés à la diffusion nécessitent en général une offre payante.
Filigranes et crédits
Certains modèles ajoutent un filigrane discret sur les résultats gratuits. Vérifiez l’aperçu en pleine résolution avant de vous engager dans un montage final. Les modèles accessibles via PicassoIA ont tendance à offrir des résultats gratuits plus propres que les applications autonomes, car la couche API fait disparaître la plupart des restrictions de marque.
Les systèmes de crédits varient. La plupart des modèles sur PicassoIA consomment un petit nombre de crédits par génération, et les nouveaux comptes reçoivent assez de crédits pour lancer 10 à 20 clips de test complets avant de devoir recharger.
Quand utiliser quel modèle
Le bon outil dépend de ce dont vous partez et de ce que vous voulez obtenir à la fin :
Si vous partez d’une photo et d’un fichier audio : utilisez d’abord Omni Human 1.5. Si le résultat demande une précision labiale plus fine, passez à Lipsync 2 Pro.
Si vous partez uniquement d’un script texte : utilisez d’abord un modèle de synthèse vocale pour générer l’audio, puis envoyez-le vers Omni Human 1.5 ou Fabric 1.0.
Si vous doublez une vidéo existante dans une autre langue : utilisez Lipsync Precision de HeyGen ou Video Translate, qui gèrent tous deux plus de 150 langues.
Si vous créez un présentateur IA complet sans vraie photo : commencez par Avatar IV ou Dreamactor M2.0 pour créer le personnage de base, puis animez-le avec un modèle de synchronisation labiale.
Si vous synchronisez un audio sur une vidéo que vous possédez déjà : React 1 ou Kling Lip Sync sont les options les plus fiables.
Conseil pour le flux de travail : le pipeline le plus efficace consiste à générer le portrait avec un modèle de texte vers image, générer la voix avec un modèle de synthèse vocale, puis animer le tout avec un modèle de synchronisation labiale. Les trois étapes peuvent être réalisées gratuitement sur la même plateforme. Aucun transfert de fichiers, aucun jonglage entre comptes.
L’écart de réalisme se réduit rapidement
Il y a dix-huit mois, les têtes parlantes IA gratuites présentaient des signes révélateurs : cou raide, taux de clignement peu naturel, commissures des lèvres floues. Aujourd’hui, des modèles comme Omni Human 1.5 et Kling Avatar v2 produisent des résultats qui passent l’examen d’un spectateur occasionnel. L’écart entre l’offre gratuite et l’offre payante tient désormais surtout à la durée des clips et à la résolution, et non plus à la qualité visuelle.
Pour les créateurs indépendants, les petites équipes et quiconque veut produire des contenus vidéo professionnels sans les contraintes d’un tournage, l’offre gratuite est réellement viable. Les outils existent. Le flux de travail est court. L’obstacle est de savoir par où commencer.
Essayez dès maintenant
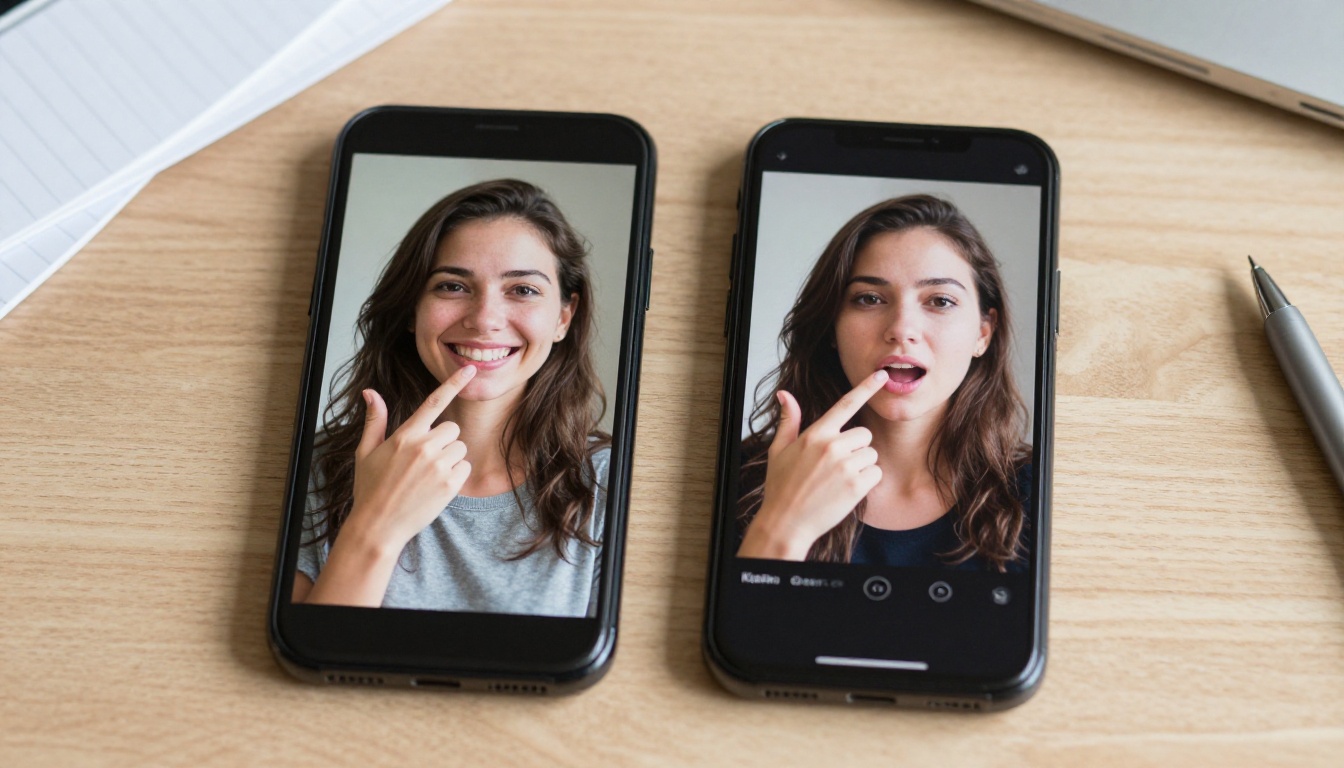
La meilleure façon de comprendre ce que peuvent faire ces modèles est d’en lancer un. Choisissez une photo que vous aimez, enregistrez ou générez 10 secondes d’audio, puis passez-les dans Omni Human 1.5. Tout le processus prend moins de 5 minutes et ne coûte rien. Ensuite, essayez un autre modèle avec la même entrée et comparez les résultats côte à côte. Cette seule expérience vous en apprendra plus que n’importe quel article.
PicassoIA vous donne accès à chacun des modèles de synchronisation labiale présentés ici, ainsi qu’aux outils de texte vers image et de synthèse vocale dont vous avez besoin pour construire un pipeline vidéo synthétique complet depuis zéro. Si vous avez un script et une idée de visage, vous avez tout ce qu’il faut pour publier une vidéo de tête parlante dès aujourd’hui.


