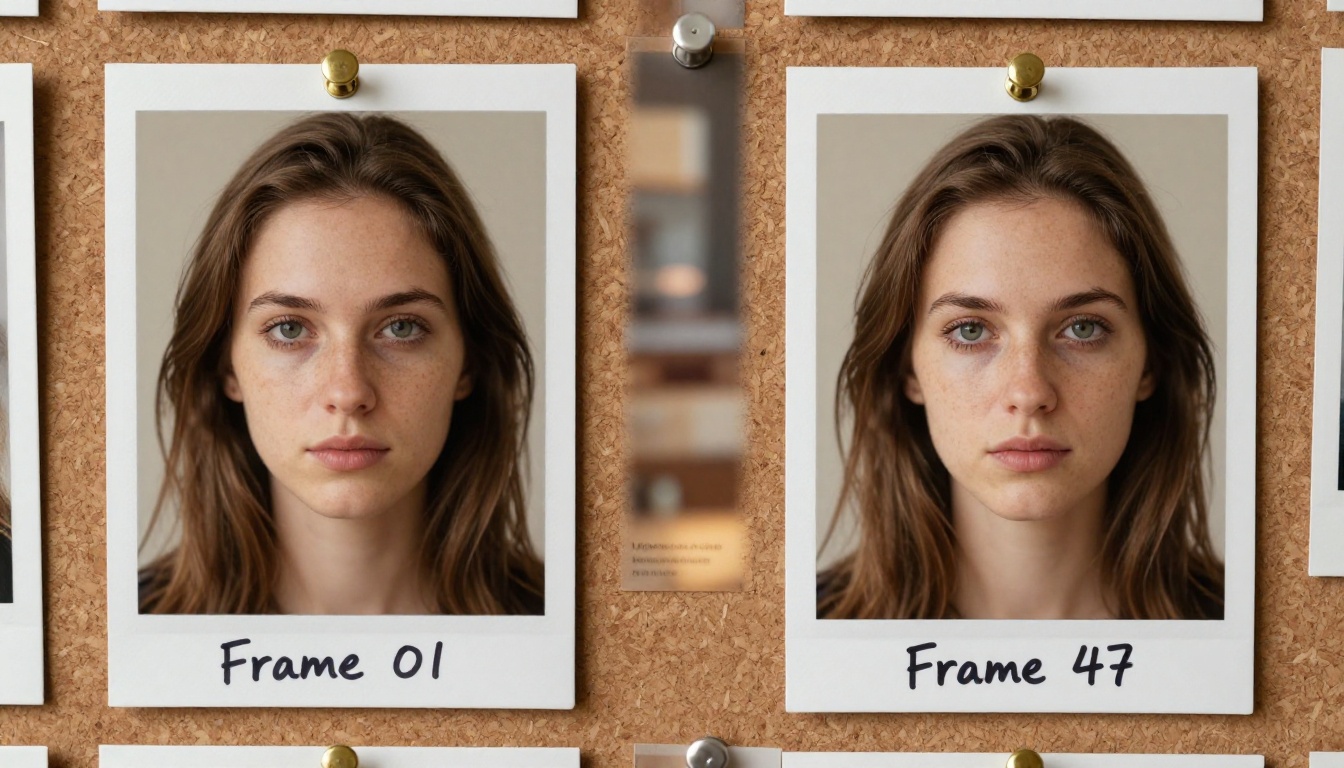
الحصول على الوجه نفسه بشكل موثوق عبر عدة مقاطع فيديو مولّدة بالذكاء الاصطناعي ليس مشكلة محلولة بعد. في كل مرة تولّد فيها مشهدًا جديدًا، تعيد نماذج الانتشار أخذ عينات من الصفر، وقد يشارك الوجه الجديد شخصيتك في الملامح العامة، لكنه يخطئ في خط الفك أو شكل العين أو لون البشرة. في التجارب القصيرة لا بأس بذلك. أما في أي مشروع تريد إطلاقه فعلًا، فهذه كارثة.
هذه المشكلة قابلة للحل. ليس بشكل كامل، ولا دون أي جهد، لكن بما يكفي لتبني مشاريع فيديو ذكاء اصطناعي متماسكة بشخصيات قابلة للتمييز. والمنهج لا يقوم على البحث عن أوامر سحرية. بل على فهم سبب انزياح الوجوه، وبناء سير عمل يواجه هذا الانزياح.
لماذا تنزاح وجوه الذكاء الاصطناعي بين المقاطع
العشوائية المتأصلة في كل عملية توليد
تعمل نماذج تحويل النص إلى فيديو وتحويل الصورة إلى فيديو عبر تحويل الضوضاء العشوائية إلى مرئيات متماسكة، موجَّهةً بأمرك النصي. والكلمة المفتاحية هنا هي "عشوائي". تبدأ كل عملية توليد من قيمة بذرة ضوضاء جديدة ما لم تتحكم فيها صراحةً. وهذا يعني أنك حتى لو كتبت الوصف الدقيق نفسه لشخصيتك مرتين، فإن نقطة البداية العشوائية المختلفة ستنتج شخصين مختلفين يشتركان في بعض السمات العامة فقط.
عملية الانتشار ليست لديها ذاكرة. لا تعرف كيف كانت شخصيتك تبدو في المقطع السابق. لا تعرف إلا ما يقوله أمرك النصي في هذه اللحظة. لذلك حتى كتابة الأوامر بعناية فائقة ستنزاح مع الوقت، لأن اللغة مرجع غير دقيق للوجه.
كيف يُضعف انتباه الأمر النصي تفاصيل الوجه
عندما تصف "امرأة ذات عينين بنيتين ووجنتين بارزتين وشعر أحمر يصل إلى الكتفين تمشي في شارع مدينة"، يوزّع النموذج انتباهه على كل جزء من هذا الوصف. فشارع المدينة مهم. والشعر الأحمر المتدلي إلى الكتفين مهم. وحركة المشي مهمة. أما العينان والوجنتان فتتنافسان مع كل شيء آخر على التأثير في المخرجات.
عمليًا، غالبًا ما تهيمن الأوصاف البيئية وأوصاف الحركة العامة، فتتحول التفاصيل الخاصة بالوجه إلى شيء معقول لكنه غير مطابق. وكلما طال أمرك النصي وتعقّد، تراكم هذا التأثير المتوسِّط.
💡 الحل ليس أوامر أطول. الحل هو المرجع البصري. الوجه المعروض في صورة يحمل معلومات أكثر بكثير مما يمكن أن يحمله أي وصف نصي.
استراتيجية الصورة المرجعية
ما الذي يجعل الوجه المرجعي صالحًا للاستخدام
الصورة المرجعية هي أقوى أداة لديك للحفاظ على ثبات الوجه. والهدف صورة شخصية نظيفة وجيدة الإضاءة تمنح النموذج أكبر قدر ممكن من المعلومات عن الوجه. إليك ما يجعل المرجع يعمل فعلًا:
- تعبير محايد. الابتسام أو التعبير الانفعالي يخلق غموضًا في نسب الوجه. التعبير المحايد أو الهادئ قليلًا يمنح أوضح خط أساس.
- مواجهة للكاميرا أو زاوية ثلاثية الأرباع خفيفة. لقطات الجانب الكامل تخفي الكثير. والنقطة المثالية هي انحراف من 0 إلى 30 درجة عن المركز.
- إضاءة متساوية ومنتشرة. الظلال القاسية تحجب الملامح. ضوء النافذة الناعم أو إعداد بسيط بإضاءة رئيسية وإضاءة تعبئة هو الأفضل.
- خلفية بسيطة أو مموّهة. الخلفيات المزدحمة تنافس الوجه على انتباه النموذج.
- دقة عالية. كلما توفرت تفاصيل أكثر، كان لدى النموذج ما يثبّت عليه.
لقطة شخصية بعدسة 85 ملم وفتحة f/2.0، مع ضوء نافذة طبيعي وخلفية نظيفة، هي تقريبًا ما تحتاجه بالضبط. وهذا ليس موضوع جماليات. إنه موضوع كثافة المعلومات.
الزوايا الأكثر أهمية
جمع عدة زوايا مرجعية للشخصية نفسها يحسّن الثبات بشكل كبير عبر لقطات الفيديو التي تتحرك فيها الكاميرا أو تستدير فيها الشخصية. فإذا أظهر مقطع الفيديو الشخصية من الجانب، يحتاج النموذج إلى بيانات الجانب للحفاظ على الدقة.
| الزاوية | متى تحتاجها |
|---|
| أمامية (0 درجة) | لقطات قريبة مباشرة |
| ثلاثية الأرباع (30 درجة) | معظم مشاهد الحوار والمشي |
| جانبية (90 درجة) | لقطات من فوق الكتف ولقطات الصورة الظلية |
| منحدرة قليلًا للأسفل | لقطات بمنظور الرائي من الأعلى |
| إمالة للأعلى | مشاهد زاوية منخفضة درامية |
بناء ورقة شخصية مصغرة بثلاث إلى خمس زوايا، كلها تحت إضاءة ثابتة، يستغرق 10 دقائق ويوفّر ساعات من إعادة التوليد. وعندما تملك صورًا مرجعية لكل منظور كاميرا رئيسي، يكون لديك دائمًا المرجع المناسب لأي نوع لقطة.
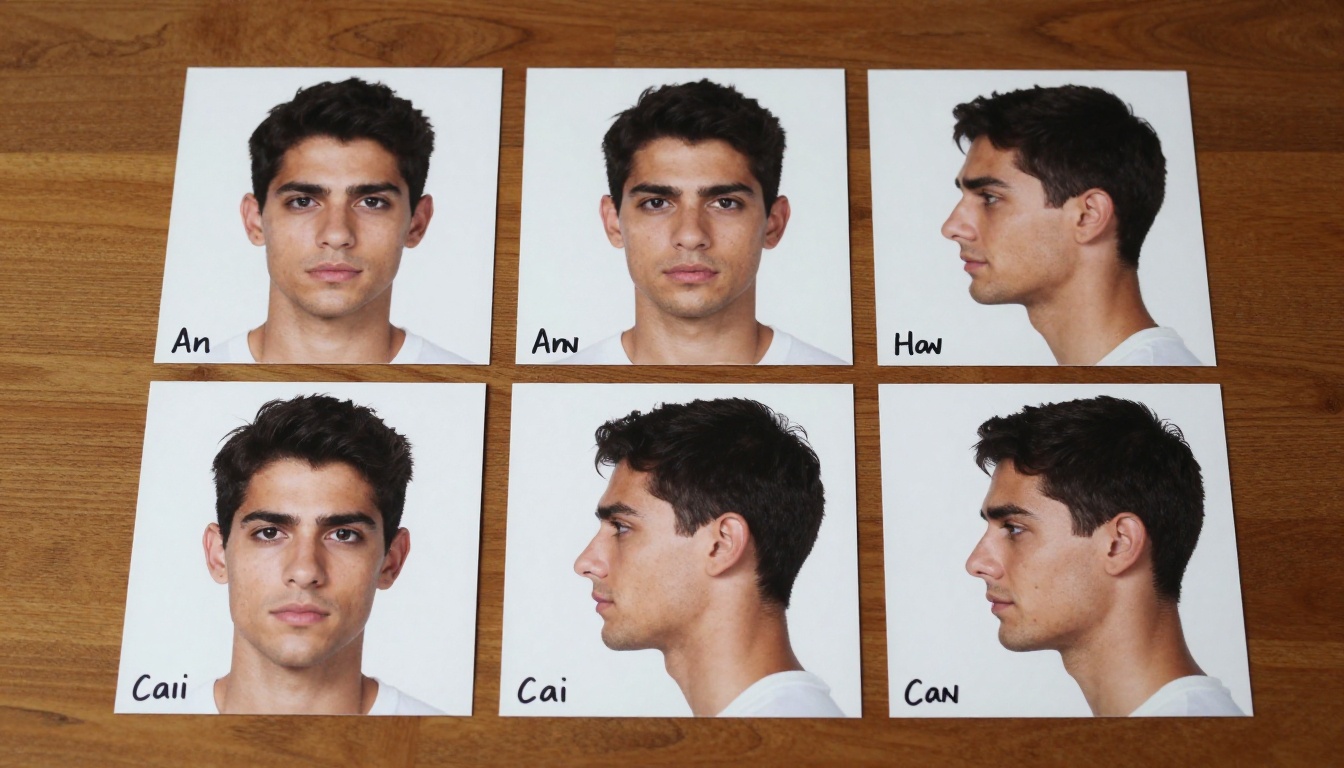
بناء ملف الشخصية
قبل تشغيل أي توليد فيديو، يبني صنّاع فيديو الذكاء الاصطناعي الجادون ما يسميه صنّاع الأفلام "ملف الشخصية": وثيقة ثابتة تحدد كل سمة جسدية للشخصية بتفاصيل بصرية ونصية دقيقة.
في إنتاج فيديو الذكاء الاصطناعي، يتضمن ملف الشخصية العملي ما يلي:
الأصول البصرية:
- الصورة الشخصية المرجعية الرئيسية (دقة كاملة، تعبير محايد، مواجهة للكاميرا)
- المرجع الجانبي (منظر جانبي خالص)
- المرجع ثلاثي الأرباع
- تنويعات التعبير (واحد سعيد، وواحد جاد، وواحد متفاجئ، كلها مبنية من الصورة الرئيسية نفسها)
المرتكزات النصية:
- العمر مكتوبًا برقم محدد، لا بنطاق
- لون البشرة موصوفًا بمصطلحات دقيقة (بني متوسط دافئ، عاجي شاحب، أبنوسي عميق)
- لون العين بتفصيل دقيق (أزرق فولاذي مع حلقة كهرمانية حول البؤبؤ)
- الشعر: اللون والطول والملمس والتسريحة مثبتة بلغة دقيقة
- السمات المميزة: النمش، موضع الندبة، شكل الحاجب
مواصفات الإضاءة:
- إعداد إضاءة واحد ستستخدمه لكل الصور المرجعية
- وصف الإضاءة نفسه لكل أوامر تحويل النص إلى فيديو
قد يبدو هذا عبئًا إضافيًا، لكنه في الحقيقة الوثيقة التي تجعل إنتاج المشاهد المتعددة ممكنًا دون تصحيحات يدوية مستمرة. وبمجرد بناء الملف، يصبح كل قرار توليد واضحًا: هل يطابق هذا الملف؟ إن كان الجواب نعم، تابع. وإن كان لا، فعدّل أولًا.
نماذج مصممة للحفاظ على ثبات الوجوه
ليست كل نماذج فيديو الذكاء الاصطناعي تتعامل مع الوجوه بالطريقة نفسها. بعضها يعتمد على الأمر النصي وحده وينتج مخرجات جميلة لكنها غير مرتبطة بشخصية محددة. وبعضها الآخر مصمم خصيصًا لقبول صورة مرجعية للوجه والحفاظ عليها طوال توليد الفيديو.
Kling Avatar v2
Kling Avatar v2 مصمم خصيصًا لتحريك الوجوه في الفيديو. تزوّده بصورة شخصية فيحافظ على هوية الشخص طوال المقطع. وهذا ليس أداة تحويل صورة إلى فيديو عامة تتعامل مع الوجوه بالمصادفة. فأوضاع الأفاتار مصممة هندسيًا لتثبيت هوية الوجه كقيد صارم، لا كاقتراح مرن.
Dreamactor M2.0
Dreamactor M2.0 من ByteDance يتعامل مع تحريك الشخصية بالجسم كاملًا انطلاقًا من صورة مرجعية. ويحافظ على هوية الوجه بشكل جيد لأن المرجع يُستخدم كمرتكز بنيوي طوال التوليد، لا كتلميح أسلوبي فقط. ويعمل بشكل خاص جيدًا في المشاهد التي تتطلب حركة الجسم كاملًا مع بقاء الوجه قابلًا للتعرف عليه.
Wan 2.7 R2V
Wan 2.7 R2V (Reference-to-Video) يقبل صورة مرجعية لأي موضوع ويحركها. وتعني تسمية R2V تحديدًا أنه مصمم للتوليد المرتكز على المرجع. وفيما يخص ثبات الوجه، فهو من أكثر الأدوات المباشرة المتاحة على المنصة.
Ovi I2V
Ovi I2V من Character AI يولّد فيديو مع صوت مباشرة من صورة فوتوغرافية. ويتعامل مع الصور الشخصية بشكل جيد بشكل خاص، مما يجعله عمليًا للمشاهد التي تحتاج فيها الشخصية إلى الكلام أو التفاعل أو مخاطبة الكاميرا.
Grok Imagine R2V
Grok Imagine R2V خيار آخر لتحويل المرجع إلى فيديو، يأخذ صورة فوتوغرافية وينتج مخرجات فيديو متماسكة، محافظًا على هوية الشخص عبر الحركة. ويستحق اختباره إلى جانب Wan 2.7 R2V للمقارنة وفق نوع شخصيتك تحديدًا.
💡 للفيديو المثبّت للوجه، أعطِ الأولوية لنماذج تحويل الصورة إلى فيديو وتحويل المرجع إلى فيديو بدلًا من تحويل النص إلى فيديو. الصورة هي القيد الذي يمنع الانزياح.
استخدام تحويل الصورة إلى فيديو لتثبيت الوجه
كيف يعمل إطار المرتكز
عندما تستخدم نموذج تحويل الصورة إلى فيديو، تصبح الصورة المدخلة هي الإطار الأول تمامًا. تنتقل مهمة النموذج من "توليد شخص معقول يطابق هذا الوصف" إلى "تحريك هذا الشخص المحدد". وهذه مهمة مختلفة جوهريًا، وتنتج نتائج أكثر ثباتًا بكثير.
الوجه في ذلك الإطار الأول صار الآن قيدًا بصريًا صارمًا. لا يستطيع النموذج إعادة أخذ عينات هندسة الوجه بحرية، لأن عليه أن يبقى متصلًا بالإطار الأول. ولهذا يُعد تحويل الصورة إلى فيديو الطريقة الأكثر موثوقية لثبات الوجه في إنتاج فيديو الذكاء الاصطناعي.
اختيار الصورة المصدر
يجب أن تكون الصورة المصدر لتحويل الصورة إلى فيديو:
- الشخصية بتعبير محايد أو هادئ قليلًا حتى يكون لدى النموذج مساحة للتحريك إلى أي حالة عاطفية
- مُكوَّنة مع مساحة كافية فوق الرأس وجسد ظاهر حتى يستطيع النموذج تحريك حركة الجسم دون مشكلات في القص
- مُلتقطة بإضاءة مسطحة محايدة حتى يستطيع النموذج إضافة إضاءة درامية في الفيديو دون أن يقاوم مرجعًا مضاءً بقوة
- بدقة عالية حتى لا تُدخل عيوب الضغط غموضًا في شكل الوجه
- خالية من ضبابية الحركة حتى تكون حواف الوجه حادة وواضحة ليتتبعها النموذج
تجنّب الصور التي تكون فيها الشخصية في منتصف حركة. إذا أظهر مرجعك الشخص وهو يضحك بشدة أو برأس مدار، فإن النموذج يرتكز على تلك الحالة المحددة ولديه مرونة أقل لتحريكها بشكل مقنع.
كيفية استخدام Kling Avatar v2 على PicassoIA
Kling Avatar v2 هو الطريق الأكثر مباشرة إلى فيديو وجه متسق على PicassoIA. إليك سير العمل بالتفصيل:
الخطوة 1: جهّز الصورة الشخصية المرجعية
ولّد صورة شخصية نظيفة لشخصيتك أو التقطها. تعبير محايد، ومواجهة أو زاوية ثلاثية الأرباع خفيفة، وإضاءة ناعمة، وخلفية بسيطة. احفظها بدقة كاملة.
الخطوة 2: افتح Kling Avatar v2
انتقل إلى Kling Avatar v2 على PicassoIA وارفع صورتك الشخصية كصورة إدخال. الأداة مصممة خصيصًا لقبول الصور الشخصية للوجوه كمدخل أساسي.
الخطوة 3: اكتب أمر الحركة
صِف ما تريد أن تفعله الشخصية، لا كيف تبدو. الوجه معرّف بالفعل من الصورة. ركّز على:
- الحركة ("تلتفت إلى اليسار، تبتسم قليلًا، تومئ")
- البيئة ("تجلس في مقهى مضاء بلطف مع خلفية محيطة دافئة")
- حركة الكاميرا ("تقريب بطيء نحو الوجه")
الخطوة 4: شغّل التوليد وقيّم النتيجة
شغّل التوليد وتحقق من أن الوجه يطابق مرجعك. إذا كان هناك انزياح كبير، فجرّب:
- قصّ المرجع بشكل أضيق حول الوجه (أزل الجسم من الصورة الشخصية)
- تبسيط أمر الحركة إلى عدد أقل من الأفعال المتزامنة
- التشغيل بقيمة بذرة مختلفة
الخطوة 5: ابنِ المقاطع بالتسلسل
في فيديو متعدد المشاهد، استخدم الإطار الأخير من مقطع واحد كصورة مرجعية للمقطع التالي. هذا يخلق سلسلة من الاستمرارية البصرية. فيصبح وجه نهاية كل مقطع مرتكز بداية المقطع التالي، فيمنع الانزياح من التراكم عبر تسلسلك الكامل.
💡 اربط مقاطعك بالسلسلة. الإطار الأخير من المقطع 1 كإدخال للمقطع 2 هو أكثر الطرق موثوقية للحفاظ على الاستمرارية عبر تسلسل فيديو كامل دون إصلاحات ما بعد الإنتاج.
استراتيجيات الأوامر النصية للوجوه المتسقة
عندما تحتاج إلى العمل مع نماذج تحويل النص إلى فيديو مثل Wan 2.7 T2V أو Seedance 2.0 أو Kling v3 Omni Video، تصبح استراتيجية الأمر النصي أداتك الأساسية للثبات.
تثبيت وصف الشخصية
أنشئ كتلة وصف ثابتة للشخصية والصقها في كل أمر دون تغيير. كل اختلاف في الكلمات يفتح الباب لاختلاف في الوجه. مثلًا:
"امرأة بعمر 28 عامًا، بشرة شاحبة مع نمش خفيف، عينان رماديتان مزرقتان، أنف رفيع مستقيم، شفتان رفيعتان، شعر داكن محمّر قصير يصل إلى الفك، أقراط فضية صغيرة مسمارية"
تبقى هذه الكتلة متطابقة في كل عملية توليد. ما يتغير هو المشهد والحركة وموضع الكاميرا. وصف الشخصية متغير ثابت لا تعبث به بين المقاطع.
ثبات الإضاءة
الإضاءة تغيّر الوجوه. الشخصية المضاءة من اليسار تبدو للنموذج مختلفة قليلًا عن الشخصية نفسها مضاءة من اليمين، لأن الإبرازات والظلال تغيّر الهندسة الوجهية المُدركة. اختر إعداد إضاءة واحدًا وصفه بالطريقة نفسها في كل أمر.
- "ضوء نافذة طبيعي ناعم من جهة الكاميرا اليسرى" في المشهد 1 يجب أن يكون هو نفسه في المشهد 10
- هذا أكثر قابلية للتكرار من "إضاءة سينمائية درامية" التي يفسرها النموذج بشكل مختلف في كل مرة
ما يجب تجنبه في الأوامر
| تجنّب هذا | استخدم هذا بدلًا منه |
|---|
| "امرأة جميلة" (عامة) | أوصاف جسدية محددة |
| "وجه سينمائي" | ظروف إضاءة محددة |
| تغيير عمر الشخصية في كل مشهد | عمر ثابت في كل أمر |
| ذكر المشاعر في وصف الشخصية | ضع المشاعر في وصف الحركة |
| أوصاف شعر غير متسقة | ثبّت وصف الشعر بالدقة نفسها |
| "امرأة واقعية" | وصف جسدي كامل ومحدد |
Animate Replace والتحكم في الحركة
للسيناريوهات الأكثر تعقيدًا حيث تريد نقل شخصية إلى لقطات فيديو موجودة أو تطبيق أنماط حركة محددة، يتيح لك Wan 2.2 Animate Replace استبدال الشخصيات في الفيديو مع الحفاظ على الحركة الأصلية. وهذا مفيد عندما تملك الفعل الصحيح لكن الوجه الخاطئ، وتريد إدخال شخصيتك المرجعية في المشهد.
يمنحك Kling v3 Motion Control تحكمًا في الطريقة الدقيقة لحركة الشخصية باستخدام إشارات الحركة. فالحركة الأكثر تحكمًا تعني فرصًا أقل لتشوه الوجه أثناء الأفعال المعقدة. وعندما تكون دقة الوجه أثناء الحركة حاسمة، يزيل التحكم في الحركة متغيرًا آخر من المعادلة.
كلتا الأداتين تكملان سير عمل الصورة المرجعية الأساسي ولا تحلان محله. وهما الأنفع بعد أن تكون قد ثبّتّ هوية شخصيتك وتريد التحكم في الحركة بدقة.
5 أخطاء في انزياح الوجه يجب التوقف عنها
هذه هي الأنماط التي تسبب باستمرار عدم ثبات الوجه في فيديو الذكاء الاصطناعي، وكلها قابلة للتجنب:
-
استخدام تحويل النص إلى فيديو حين يوجد تحويل الصورة إلى فيديو. إذا كانت لديك صورة مرجعية، فاستخدمها. لن يخمّن النموذج بالقدر نفسه الذي يستطيع فيه الارتكاز على وجه حقيقي. استخدم Wan 2.7 I2V أو Kling Avatar v2 كخيار افتراضي قبل اللجوء إلى نموذج نصي فقط.
-
توليد مرجع جديد في كل مرة. اختر صورة مرجعية واحدة لكل شخصية ولا تستبدلها أبدًا. فتوليد "نسخة جديدة" من الشخصية نفسها سينتج دائمًا تنويعات طفيفة تتراكم عبر المقاطع.
-
تغيير وصف الشخصية بين المشاهد. حتى التغييرات الطفيفة في الصياغة ("عينان زرقاوان" مقابل "عينان رماديتان مزرقتان") تنتج اختلافًا ملحوظًا في الوجه. ثبّت الوصف ولا تعبث به.
-
استخدام دقة منخفضة لفيديو يعتمد على الوجه. المخرجات ذات الدقة الأعلى تمنح النموذج بكسلات أكثر للحفاظ على تفاصيل الوجه. استخدم Wan 2.1 I2V 720p أو نماذج عالية الدقة مماثلة عندما تكون دقة الوجه الأهم.
-
تجاهل جودة الإطار الأول. في أي نموذج تحويل صورة إلى فيديو، يُعد الإطار الأول كل شيء. امنح صورة المرجع الوقت الذي تحتاجه حتى تكون صحيحة تمامًا. لن يكون الفيديو متسقًا إلا بقدر اتساق الإطار الذي تبدأ منه.
تجميع كل شيء معًا
يعود ثبات الوجوه في فيديو الذكاء الاصطناعي إلى مبدأ جوهري واحد: أعطِ النموذج قيدًا بصريًا، لا لفظيًا فقط. الأوصاف النصية تنزاح. والصور ترتكز.
سير العمل الذي يصمد عبر المشاريع متعددة المشاهد:
- ولّد صورة شخصية مرجعية نظيفة بتعبير محايد وإضاءة ناعمة منتشرة
- استخدم نموذج أفاتار أو تحويل مرجع إلى فيديو (Kling Avatar v2، Wan 2.7 R2V، Dreamactor M2.0) بدلًا من التوليد النصي فقط
- اربط المقاطع باستخدام الإطار الأخير من كل مقطع كإدخال للمقطع التالي
- ثبّت كل الأوصاف النصية: الصياغة نفسها، والإضاءة نفسها، وتفاصيل الشخصية نفسها في كل توليد
- اعمل بدقة 720p أو أعلى عندما تكون تفاصيل الوجه مهمة
- ابنِ ملف الشخصية والتزم به قبل أول توليد لك
هذه ليست ضمانة لثبات دقيق على مستوى البكسل عبر 10 مقاطع. فما زالت النماذج الحالية تنزاح، خاصة مع الحركات المعقدة أو تغييرات الزاوية الحادة. لكن هذا السير يقلّص التنوع غير المضبوط إلى الحد الأدنى، ويمنحك فرصة حقيقية لقوس شخصية متماسك عبر إنتاج كامل.
ابنِ شخصيتك الآن
يوفر PicassoIA مجموعة الأدوات الكاملة لهذا الغرض: نماذج تحويل الصورة إلى فيديو مثل Wan 2.7 I2V، ونماذج الأفاتار مثل Kling Avatar v2، والأدوات المرتكزة على المرجع مثل Dreamactor M2.0. النماذج موجودة. وما تحضره أنت هو صورة مرجعية نظيفة وسير عمل منضبط.
اختر شخصية واحدة. ولّد صورة شخصية مرجعية واحدة. مرّرها عبر Kling Avatar v2 لمقطعك الأول. جرّب كيف يبدو فيديو الوجه المتسق عمليًا قبل أن تبني حوله خط إنتاج كاملًا.
جميع النماذج المذكورة في هذا المقال متاحة على picassoia.com/en/all-models.


