Lograr que el mismo rostro aparezca de forma fiable en varios clips de video con IA no es un problema resuelto. Cada vez que generas una escena nueva, los modelos de difusión vuelven a muestrear desde cero, y ese rostro nuevo puede compartir el parecido general de tu personaje, pero fallar en la línea de la mandíbula, la forma de los ojos o el tono de piel. Para experimentos breves, no pasa nada. Para cualquier proyecto que de verdad quieras publicar, es un desastre.
Esto tiene solución. No perfecta, ni sin ningún esfuerzo, pero sí lo bastante fiable como para construir proyectos de video con IA coherentes y con personajes reconocibles. El enfoque no consiste en buscar prompts mágicos. Consiste en entender por qué se desvían los rostros y en crear un flujo de trabajo que luche contra ello.
Por qué los rostros con IA se desvían entre clips
La aleatoriedad presente en cada generación
Los modelos de texto a video e imagen a video funcionan eliminando el ruido aleatorio para convertirlo en imágenes coherentes, guiados por tu prompt. La clave es "aleatorio". Cada generación parte de una semilla de ruido nueva, a menos que la controles de forma explícita. Eso significa que, aunque escribas dos veces exactamente la misma descripción del personaje, ese punto de partida aleatorio produce dos personas distintas que comparten algunos rasgos generales.
El proceso de difusión no tiene memoria. No sabe cómo era tu personaje en el clip anterior. Solo sabe lo que dice tu prompt en este momento. Por eso, incluso una redacción de prompts muy cuidadosa se desvía con el tiempo, porque el lenguaje es una referencia imprecisa para un rostro.
Cómo la atención del prompt degrada el detalle facial
Cuando describes "una mujer con ojos marrones, pómulos altos y cabello rojo hasta los hombros caminando por una calle de la ciudad", el modelo reparte la atención entre todas las partes de esa descripción. La calle de la ciudad importa. El cabello rojizo hasta los hombros importa. El movimiento de caminar importa. Los ojos y los pómulos compiten con todo lo demás por influir en el resultado.
En la práctica, las descripciones amplias del entorno y del movimiento suelen dominar, y los detalles del rostro se promedian hasta quedar en algo plausible pero no idéntico. Cuanto más largo y complejo sea tu prompt, más se acumula este efecto de promedio.
💡 La solución no son prompts más largos. Es la referencia visual. Un rostro mostrado como imagen transmite mucha más información que cualquier descripción en texto.
La estrategia de la imagen de referencia
Qué hace útil un rostro de referencia
Una imagen de referencia es tu herramienta más potente para lograr la coherencia del rostro. El objetivo es un retrato limpio y bien iluminado que dé al modelo la mayor cantidad posible de información facial. Así se consigue que una referencia funcione de verdad:
- Expresión neutra. Sonreír o expresar emociones genera ambigüedad en las proporciones faciales. Una expresión neutra o ligeramente suave ofrece la base más clara.
- De frente o con un ángulo de tres cuartos leve. Los perfiles completos ocultan demasiado. El punto ideal está entre 0 y 30 grados desde el centro.
- Iluminación uniforme y difusa. Las sombras duras ocultan rasgos. La luz suave de una ventana o una configuración sencilla de luz principal y de relleno funciona mejor.
- Fondo liso o desenfocado. Los fondos recargados compiten con el rostro por la atención del modelo.
- Alta resolución. Cuanto más detalle haya disponible, más se puede anclar el modelo a él.
Un retrato tomado con 85 mm f/2.0, con luz natural de ventana y un fondo limpio, es casi exactamente lo que buscas. No se trata de la estética. Se trata de la densidad de información.
Los ángulos que más importan
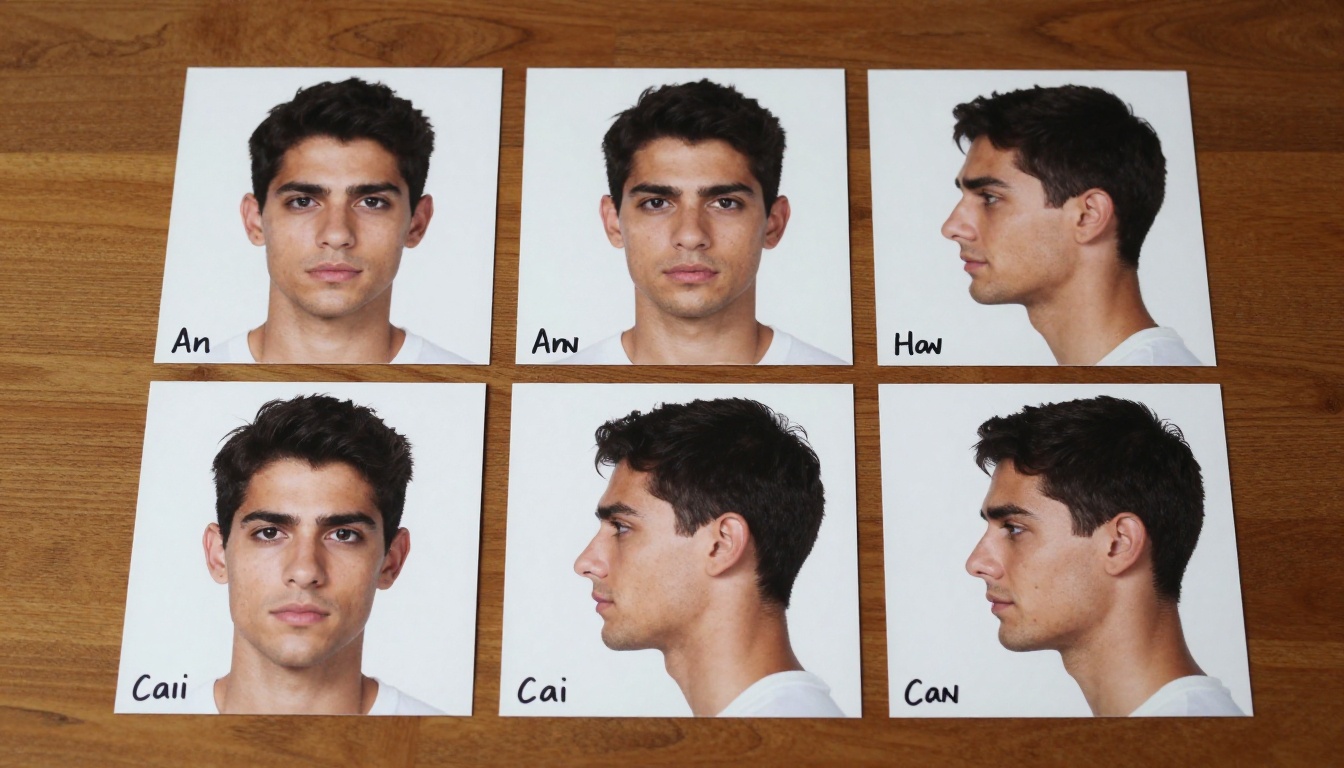
Reunir varios ángulos de referencia del mismo personaje mejora mucho la coherencia entre las tomas en las que la cámara se mueve o el personaje gira. Si tu clip muestra al personaje de perfil, el modelo necesita datos de referencia de perfil para mantener la fidelidad.
| Ángulo | Cuándo lo necesitas |
|---|
| Frontal (0 grados) | Primeros planos de frente |
| Tres cuartos (30 grados) | La mayoría de los diálogos y las tomas caminando |
| Perfil (90 grados) | Planos por encima del hombro y planos de silueta |
| Ligeramente hacia abajo | Planos subjetivos desde arriba |
| Inclinación hacia arriba | Escenas dramáticas en contrapicado |
Crear una pequeña hoja de personaje con 3 a 5 ángulos, todos con la misma iluminación, lleva 10 minutos y ahorra horas de regeneración. Cuando tienes imágenes de referencia para cada perspectiva de cámara principal, siempre tienes el anclaje adecuado para cualquier tipo de plano.
Cómo construir una biblia del personaje
Antes de lanzar una sola generación de video, los creadores de video con IA serios construyen lo que los cineastas llaman una biblia del personaje: un documento fijo que define cada atributo físico del personaje con un detalle visual y textual preciso.
Para la producción de video con IA, una biblia del personaje práctica incluye:
Recursos visuales:
- El retrato maestro de referencia (resolución completa, expresión neutra, de frente)
- Referencia de perfil (perfil puro)
- Referencia de tres cuartos
- Variaciones de expresión (una feliz, una seria, una sorprendida, todas creadas a partir del mismo maestro)
Anclajes de texto:
- Edad escrita como un número concreto, no como un rango
- Tono de piel descrito con terminología precisa (marrón medio cálido, marfil pálido, ébano profundo)
- Color de ojos con un detalle específico (azul acero con un anillo ámbar alrededor de la pupila)
- Cabello: color, largo, textura y peinado fijados con un lenguaje preciso
- Rasgos distintivos: pecas, ubicación de cicatrices, forma de las cejas
Especificación de iluminación:
- Una única configuración de iluminación que usarás en todas las imágenes de referencia
- La misma descripción de iluminación en todos los prompts de texto a video
Esto suena a trabajo extra, pero en realidad es el documento que hace posible la producción de varias escenas sin correcciones manuales constantes. Una vez creada la biblia, cada decisión de generación se vuelve clara: ¿esto coincide con la biblia? Si es así, continúa. Si no, ajusta primero.
Modelos diseñados para la coherencia del rostro
No todos los modelos de video con IA tratan los rostros de la misma manera. Algunos se basan solo en el prompt y producen un resultado bonito pero independiente del personaje. Otros están diseñados específicamente para aceptar una imagen de referencia del rostro y mantenerla durante toda la generación del video.
Kling Avatar v2
Kling Avatar v2 está diseñado para animar rostros en video. Le proporcionas una imagen de retrato y conserva la identidad de la persona durante todo el clip. No es una herramienta general de imagen a video que, por casualidad, maneja rostros. Los modos de avatar están diseñados a nivel de arquitectura para fijar la identidad facial como una restricción estricta y no como una sugerencia flexible.
Dreamactor M2.0
Dreamactor M2.0 de ByteDance gestiona la animación de personajes de cuerpo completo a partir de una imagen de referencia. La identidad facial se mantiene bien porque la referencia se usa como ancla estructural durante toda la generación, no solo como una pista de estilo. Funciona especialmente bien en escenas que requieren movimiento de cuerpo completo sin perder el reconocimiento del rostro.
Wan 2.7 R2V
Wan 2.7 R2V (de referencia a video) acepta una imagen de referencia de cualquier sujeto y la anima. La designación R2V indica específicamente que está diseñado para la generación anclada a una referencia. Para la coherencia del rostro, es una de las herramientas más directas de la plataforma.
Ovi I2V
Ovi I2V de Character AI genera video con audio directamente a partir de una foto. Maneja muy bien las fotos de retrato, lo que lo hace práctico para escenas en las que un personaje necesita hablar, reaccionar o interactuar con la cámara.
Grok Imagine R2V
Grok Imagine R2V es otra opción de referencia a video que toma una foto y produce un resultado de video coherente, conservando la identidad del sujeto durante el movimiento. Vale la pena probarlo junto a Wan 2.7 R2V para comparar con tu tipo de personaje concreto.
💡 Para un video con el rostro fijo, prioriza los modelos de imagen a video y de referencia a video frente a los de texto a video. La imagen es la restricción que evita la desviación.
Usar imagen a video para fijar el rostro
Cómo funciona el fotograma de anclaje
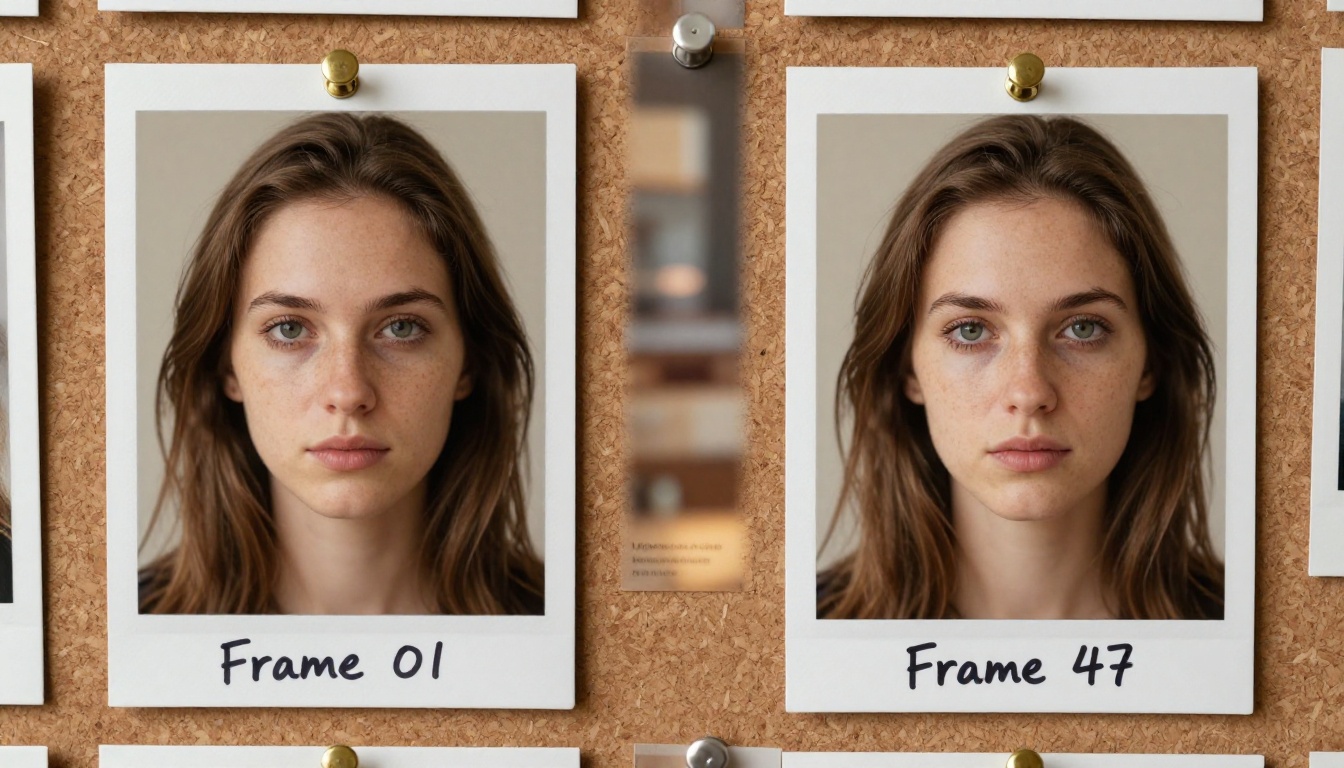
Cuando usas un modelo de imagen a video, la imagen de entrada se convierte en el primer fotograma literal. La tarea del modelo cambia de «generar una persona verosímil que coincida con esta descripción» a «animar a esta persona concreta». Es una tarea fundamentalmente distinta y produce resultados mucho más coherentes.
El rostro de ese primer fotograma es ahora una restricción visual firme. El modelo no puede volver a muestrear libremente la geometría facial, porque debe mantenerse continuo con el fotograma 1. Por eso la imagen a video es el método más fiable para la coherencia del rostro en la producción de video con IA.
Cómo elegir tu imagen de origen
La imagen de origen para la imagen a video debe cumplir estas condiciones:
- El personaje con una expresión neutra o ligeramente relajada, para que el modelo tenga margen para animarlo a cualquier estado emocional
- Encuadrada con suficiente espacio sobre la cabeza y el cuerpo visible, para que el modelo pueda animar el movimiento corporal sin problemas de recorte
- Tomada con iluminación plana y neutra, para que el modelo pueda añadir luz dramática en el video sin luchar contra una referencia muy iluminada
- En alta resolución, para que los artefactos de compresión no introduzcan ambigüedad en la forma del rostro
- Libre de desenfoque por movimiento, para que los bordes del rostro estén nítidos y bien definidos para que el modelo los siga
Evita las imágenes en las que el personaje está en plena acción. Si tu referencia muestra a la persona riendo a carcajadas o con la cabeza girada, el modelo se ancla a ese estado concreto y tiene menos flexibilidad para animarlo de forma creíble.
Cómo usar Kling Avatar v2 en PicassoIA
Kling Avatar v2 es la vía más directa para obtener un video con el rostro coherente en PicassoIA. Este es el flujo de trabajo exacto:
Paso 1: Prepara tu retrato de referencia
Genera o fotografía un retrato limpio de tu personaje. Expresión neutra, de frente o con un ángulo de tres cuartos leve, iluminación suave y fondo liso. Guárdalo en resolución completa.
Paso 2: Abre Kling Avatar v2
Ve a Kling Avatar v2 en PicassoIA y sube tu retrato como imagen de entrada. La herramienta está diseñada específicamente para aceptar retratos de rostros como entrada principal.
Paso 3: Escribe tu prompt de movimiento
Describe lo que quieres que haga el personaje, no cómo es. El rostro ya está definido por la imagen. Céntrate en:
- Movimiento ("gira la cabeza hacia la izquierda, sonríe ligeramente, asiente")
- Entorno ("sentado en una cafetería con luz suave y un ambiente cálido de fondo")
- Movimiento de cámara ("acercamiento lento de dolly hacia el rostro")
Paso 4: Genera y evalúa
Ejecuta la generación. Comprueba que el rostro coincide con tu referencia. Si hay una desviación significativa, prueba a:
- Recortar la referencia más de cerca en torno al rostro (quita el cuerpo del retrato)
- Simplificar el prompt de movimiento a menos acciones simultáneas
- Ejecutar con un valor de semilla distinto
Paso 5: Crea los clips en secuencia
Para un video de varias escenas, usa el fotograma final de un clip como imagen de referencia del siguiente. Así se crea una cadena de continuidad visual. El rostro del final de cada clip se convierte en el anclaje inicial del siguiente, lo que evita que la desviación se acumule a lo largo de toda la secuencia.
💡 Encadena tus clips. El último fotograma del clip 1 como entrada del clip 2 es la forma más fiable de mantener la continuidad en una secuencia completa de video sin correcciones de posproducción.
Estrategias de prompt para rostros coherentes
Cuando necesites trabajar con modelos de texto a video como Wan 2.7 T2V, Seedance 2.0 o Kling v3 Omni Video, la estrategia del prompt se convierte en tu palanca principal para la coherencia.
Anclaje de la descripción del personaje
Crea un bloque de descripción fijo del personaje y pégalo en cada prompt, sin cambios. Cada variación de palabras abre la puerta a una variación del rostro. Algo como:
"mujer de 28 años, piel pálida con pecas claras, ojos gris azulado, nariz estrecha y recta, labios finos, cabello castaño rojizo oscuro corto hasta la mandíbula, pequeños pendientes de botón plateados"
Ese bloque se mantiene idéntico en cada generación. Lo que cambia son la escena, la acción y la posición de la cámara. La descripción del personaje es una variable fija que no tocas entre clips.
Coherencia de la iluminación
La iluminación cambia los rostros. Un personaje iluminado desde la izquierda se ve de forma sutilmente distinta para el modelo que el mismo personaje iluminado desde la derecha, porque las luces y las sombras alteran la geometría facial percibida. Elige una sola configuración de iluminación y descríbela de forma idéntica en todos los prompts.
- "Luz natural suave de ventana desde la izquierda de la cámara" en la escena 1 debe ser exactamente eso en la escena 10
- Esto es más repetible que "iluminación cinematográfica dramática", que el modelo interpreta de forma distinta cada vez
Qué evitar en los prompts
| Evita esto | Usa esto en su lugar |
|---|
| "Mujer bonita" (vago) | Descriptores físicos específicos |
| "Rostro cinematográfico" | Condiciones de iluminación específicas |
| Cambiar la edad del personaje en cada escena | Edad fija en cada prompt |
| Mencionar emociones en la descripción del personaje | Pon las emociones en la descripción de la acción |
| Descripciones del cabello incoherentes | Fija la descripción exacta del cabello |
| "Mujer realista" | Descripción física completa y específica |
Animate Replace y control de movimiento
Para escenarios más complejos en los que quieres trasladar un personaje a metraje existente o aplicar patrones de movimiento concretos, Wan 2.2 Animate Replace te permite intercambiar personajes en el video conservando el movimiento original. Es útil cuando tienes la acción correcta pero el rostro equivocado y quieres introducir tu personaje de referencia en la escena.
Kling v3 Motion Control te permite controlar con exactitud cómo se mueve el personaje mediante señales de movimiento. Un movimiento más controlado significa menos oportunidades de que el rostro se distorsione durante acciones complejas. Cuando la fidelidad facial durante el movimiento es crítica, el control de movimiento elimina una variable más de la ecuación.
Ambas herramientas complementan el flujo de trabajo principal con imágenes de referencia en lugar de sustituirlo. Son más útiles una vez que ya has fijado la identidad de tu personaje y quieres controlar el movimiento con precisión.
5 errores de desviación facial que debes dejar de cometer
Estos son los patrones que causan de forma constante la inconsistencia facial en el video con IA, y todos se pueden evitar:
-
Usar texto a video cuando existe imagen a video. Si tienes una imagen de referencia, úsala. El modelo no adivinará tan bien como cuando se ancla a un rostro real. Elige por defecto Wan 2.7 I2V o Kling Avatar v2 antes de recurrir a un modelo solo de texto.
-
Generar una nueva referencia cada vez. Elige una imagen de referencia por personaje y nunca la cambies. Generar "una versión nueva" del mismo personaje siempre producirá variaciones sutiles que se acumulan entre clips.
-
Cambiar la descripción del personaje entre escenas. Incluso pequeños cambios de redacción ("ojos azules" frente a "ojos gris azulado") producen variaciones faciales medibles. Fija la descripción y no la toques.
-
Usar baja resolución en un video en el que el rostro es lo más importante. Los resultados de mayor resolución dan al modelo más píxeles para conservar el detalle facial. Usa Wan 2.1 I2V 720p o modelos similares de alta resolución cuando la fidelidad facial importa más.
-
Ignorar la calidad del primer fotograma. En cualquier modelo de imagen a video, el primer fotograma lo es todo. Dedica el tiempo necesario a que esa imagen de referencia quede exactamente bien. El video solo será tan coherente como el fotograma del que parte.
Juntándolo todo
Los rostros coherentes en el video con IA se reducen a un principio básico: dale al modelo una restricción visual, no solo una verbal. Las descripciones de texto se desvían. Las imágenes anclan.
El flujo de trabajo que funciona en proyectos de varias escenas es este:
- Genera un retrato de referencia limpio con expresión neutra e iluminación suave y difusa
- Usa un avatar o un modelo de referencia a video (Kling Avatar v2, Wan 2.7 R2V, Dreamactor M2.0) en lugar de la generación solo con texto
- Encadena los clips usando el fotograma final de cada uno como entrada del siguiente
- Mantén todas las descripciones en texto fijas: mismas palabras, misma iluminación, mismos detalles del personaje en cada generación
- Trabaja a 720p o más cuando el detalle del rostro sea importante
- Crea y ciñete a una biblia del personaje antes de tu primera generación
Esto no garantiza una coherencia exacta, píxel a píxel, en 10 clips. Los modelos actuales siguen desviándose, sobre todo con movimientos complejos o cambios de ángulo extremos. Pero este flujo de trabajo reduce al mínimo la variación no controlada y te da una oportunidad real de lograr un arco de personaje coherente a lo largo de toda una producción.
Crea tu personaje ahora
PicassoIA tiene el conjunto completo de herramientas para esto: modelos de imagen a video como Wan 2.7 I2V, modelos de avatar como Kling Avatar v2 y herramientas de anclaje por referencia como Dreamactor M2.0. Los modelos están ahí. Lo que tú aportas es una imagen de referencia limpia y un flujo de trabajo disciplinado.
Elige un personaje. Genera un retrato de referencia. Pásalo por Kling Avatar v2 para tu primer clip. Comprueba cómo resulta en la práctica un video con el rostro coherente antes de montar todo un flujo de producción a su alrededor.
Todos los modelos mencionados en este artículo están disponibles en picassoia.com/en/all-models.


