कई AI वीडियो क्लिपों में एक ही चेहरा भरोसेमंद तरीके से दिखाना अभी तक हल हुई समस्या नहीं है। हर बार जब आप नया दृश्य जनरेट करते हैं, डिफ़्यूज़न मॉडल शुरू से नए सिरे से सैंपल लेते हैं, और वह नया चेहरा आपके किरदार जैसा सामान्य माहौल तो रख सकता है, लेकिन जॉलाइन, आँखों के आकार या स्किन टोन में चूक जाता है। छोटे प्रयोगों के लिए यह ठीक है। किसी ऐसे प्रोजेक्ट के लिए, जिसे आप सचमुच रिलीज़ करना चाहते हैं, यह एक आपदा है।
इसे ठीक किया जा सकता है। पूरी तरह से नहीं, और बिना किसी मेहनत के नहीं, लेकिन इतने भरोसे के साथ कि आप पहचान में आने वाले किरदारों के साथ सुसंगत AI वीडियो प्रोजेक्ट बना सकें। तरीका जादुई प्रॉम्प्ट खोजने का नहीं है। तरीका यह समझने का है कि चेहरे क्यों बहकते हैं, और ऐसा वर्कफ़्लो बनाने का है जो इसके खिलाफ़ काम करे।
AI चेहरे क्लिपों के बीच क्यों बदलते हैं
हर जनरेशन में बसी रैंडमनेस
टेक्स्ट-टू-वीडियो और इमेज-टू-वीडियो मॉडल प्रॉम्प्ट से निर्देशित होकर रैंडम नॉइज़ को सुसंगत विज़ुअल में बदलकर काम करते हैं। मुख्य शब्द है रैंडम। जब तक आप इसे साफ़-साफ़ नियंत्रित न करें, हर जनरेशन एक नए सीड से शुरू होती है। यानी अगर आप एक ही किरदार का विवरण दो बार लिखें, तब भी वह अंतर्निहित रैंडम शुरुआती बिंदु दो अलग लोग पैदा करेगा, जो बस कुछ व्यापक गुण साझा करते होंगे।
डिफ़्यूज़न प्रक्रिया में कोई मेमोरी नहीं होती। उसे नहीं पता कि आपका किरदार पिछली क्लिप में कैसा दिखता था। उसे सिर्फ़ यही पता होता है कि अभी आपका प्रॉम्प्ट क्या कह रहा है। इसलिए सबसे सावधानी से लिखे गए प्रॉम्प्ट भी समय के साथ बहक जाते हैं, क्योंकि चेहरे के लिए भाषा एक अस्पष्ट संदर्भ है।
प्रॉम्प्ट अटेंशन चेहरे के विवरण को कैसे कमज़ोर करता है
जब आप लिखते हैं "a woman with brown eyes, high cheekbones, and shoulder-length red hair walking through a city street", तो मॉडल उस विवरण के हर हिस्से में अपना अटेंशन बाँटता है। शहर की सड़क मायने रखती है। कंधे तक लंबे लाल बाल मायने रखते हैं। चलने की गति मायने रखती है। आँखें और गालों की हड्डियाँ बाकी सब के साथ आउटपुट पर असर के लिए होड़ करती हैं।
व्यवहार में, व्यापक परिवेश और गति के विवरण अक्सर हावी हो जाते हैं, और चेहरे की खास बातें किसी ऐसी चीज़ में औसत बन जाती हैं जो विश्वसनीय तो लगती है, पर हूबहू एक जैसी नहीं होती। आपका प्रॉम्प्ट जितना लंबा और जटिल होगा, यह औसत बनाने का असर उतना ही बढ़ता जाएगा।
💡 इसका हल लंबे प्रॉम्प्ट नहीं हैं। इसका हल विज़ुअल रेफ़रेंस है। इमेज में दिखाया गया चेहरा किसी भी टेक्स्ट विवरण से कहीं ज़्यादा जानकारी लेकर चलता है।
रेफ़रेंस इमेज की रणनीति
काम आने वाला रेफ़रेंस चेहरा कैसा होता है
चेहरे की एकरूपता के लिए रेफ़रेंस इमेज आपका सबसे शक्तिशाली औज़ार है। लक्ष्य एक साफ़, अच्छी रोशनी वाला पोर्ट्रेट है, जो मॉडल को अधिक से अधिक चेहरे की जानकारी दे। रेफ़रेंस को सचमुच काम का बनाने वाली बातें ये हैं:
- तटस्थ भाव। मुस्कुराना या भाव दिखाना चेहरे के अनुपात के बारे में अस्पष्टता पैदा करता है। तटस्थ या हल्का शांत भाव सबसे साफ़ आधार देता है।
- सामने से या हल्का थ्री-क्वार्टर कोण। पूरी प्रोफ़ाइल वाले शॉट बहुत कुछ छिपा देते हैं। सबसे अच्छा कोण केंद्र से 0 से 30 डिग्री तक है।
- समान, बिखरी हुई रोशनी। तेज़ परछाइयाँ फ़ीचर्स को धुंधला कर देती हैं। सॉफ़्ट विंडो लाइट या एक सरल की-फ़िल सेटअप सबसे अच्छा काम करता है।
- सादा या धुंधला बैकग्राउंड। भीड़भरा बैकग्राउंड मॉडल के अटेंशन के लिए चेहरे से होड़ करता है।
- उच्च रिज़ॉल्यूशन। जितना ज़्यादा विवरण उपलब्ध होगा, मॉडल के पास उतना ज़्यादा एंकर होगा।
85mm f/2.0 पर लिया गया पोर्ट्रेट शॉट, जिसमें प्राकृतिक खिड़की की रोशनी और साफ़ बैकग्राउंड हो, लगभग ठीक वैसा ही है जैसा आप चाहते हैं। यह सौंदर्य की बात नहीं है। यह जानकारी के घनत्व की बात है।
सबसे ज़रूरी कोण
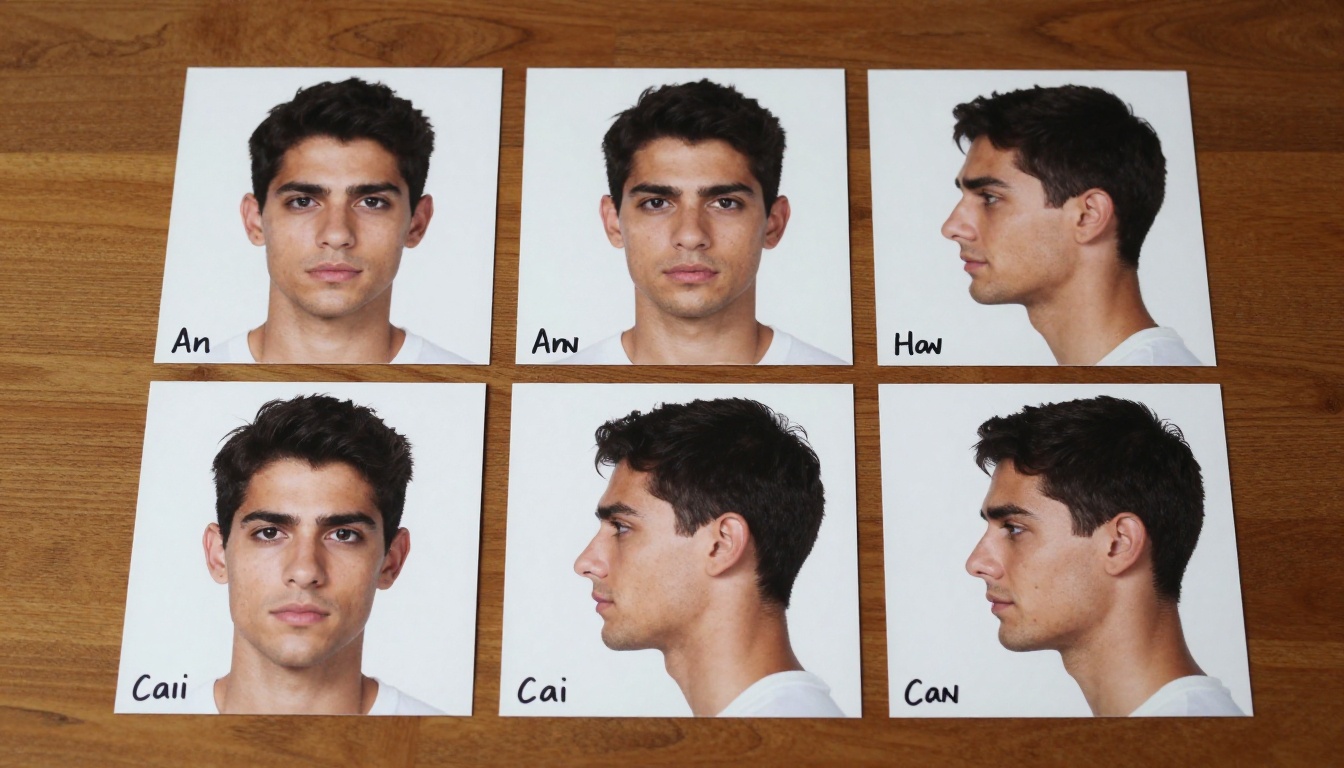
एक ही किरदार के कई रेफ़रेंस कोण इकट्ठा करने से उन वीडियो शॉट्स में एकरूपता नाटकीय रूप से बेहतर होती है, जहाँ कैमरा घूमता है या किरदार मुड़ता है। अगर आपकी वीडियो क्लिप में किरदार बगल से दिखता है, तो मॉडल को निष्ठा बनाए रखने के लिए साइड-रेफ़रेंस डेटा चाहिए।
| कोण | कब चाहिए |
|---|
| सामने (0 डिग्री) | सीधे क्लोज़-अप |
| थ्री-क्वार्टर (30 डिग्री) | ज़्यादातर संवाद और चलने वाले शॉट |
| प्रोफ़ाइल (90 डिग्री) | ओवर-द-शोल्डर और सिल्हूट शॉट |
| हल्का नीचे की ओर | ऊपर से लिए गए POV शॉट |
| ऊपर की ओर झुकाव | नाटकीय लो-एंगल दृश्य |
एक ही रोशनी में लिए गए 3 से 5 कोणों वाली एक छोटी कैरेक्टर शीट बनाने में 10 मिनट लगते हैं, और इससे घंटों की दोबारा जनरेशन बचती है। जब आपके पास हर मुख्य कैमरा परिप्रेक्ष्य के लिए रेफ़रेंस इमेज होती हैं, तो किसी भी शॉट प्रकार के लिए आपके पास हमेशा सही एंकर रहता है।
कैरेक्टर बाइबल बनाना
एक भी वीडियो जनरेशन चलाने से पहले, गंभीर AI वीडियो क्रिएटर वह बनाते हैं जिसे फ़िल्ममेकर कैरेक्टर बाइबल कहते हैं: एक लॉक किया हुआ दस्तावेज़, जो किरदार की हर शारीरिक विशेषता को सटीक विज़ुअल और टेक्स्टुअल ब्योरे में परिभाषित करता है।
AI वीडियो प्रोडक्शन के लिए, एक व्यावहारिक कैरेक्टर बाइबल में ये चीज़ें शामिल होती हैं:
विज़ुअल एसेट:
- मास्टर रेफ़रेंस पोर्ट्रेट (पूरे रिज़ॉल्यूशन में, तटस्थ भाव, सामने से)
- साइड रेफ़रेंस (शुद्ध प्रोफ़ाइल)
- थ्री-क्वार्टर रेफ़रेंस
- भाव की विविधताएँ (एक खुश, एक गंभीर, एक चौंका हुआ, सभी एक ही मास्टर से बने)
टेक्स्ट एंकर:
- उम्र एक सटीक संख्या में लिखी हुई, कोई रेंज नहीं
- स्किन टोन सटीक शब्दावली में (गर्म मध्यम भूरा, पीला हाथीदांत, गहरा आबनूस)
- आँखों का रंग खास ब्योरे के साथ (पुतली के चारों ओर एम्बर रिंग वाला स्टील ब्लू)
- बाल: रंग, लंबाई, बनावट और स्टाइल, सटीक भाषा में लॉक किए हुए
- पहचान की खास बातें: झाइयाँ, निशान की जगह, भौंह का आकार
लाइटिंग स्पेक:
- एक ही लाइटिंग सेटअप, जिसे आप सभी रेफ़रेंस इमेज के लिए इस्तेमाल करेंगे
- सभी टेक्स्ट-टू-वीडियो प्रॉम्प्ट में एक ही लाइटिंग विवरण
यह अतिरिक्त काम लग सकता है, लेकिन यही वह दस्तावेज़ है जो बार-बार हाथ से सुधार किए बिना मल्टी-सीन प्रोडक्शन को संभव बनाता है। एक बार बाइबल बन जाए, तो हर जनरेशन का फ़ैसला साफ़ हो जाता है: क्या यह बाइबल से मेल खाता है? अगर हाँ, तो आगे बढ़ें। अगर नहीं, तो पहले सुधार करें।
चेहरे की एकरूपता के लिए बने मॉडल
सभी AI वीडियो मॉडल चेहरों से एक जैसा व्यवहार करते हों, ऐसा नहीं है। कुछ पूरी तरह प्रॉम्प्ट-आधारित होते हैं और सुंदर, पर किरदार-निरपेक्ष आउटपुट देते हैं। कुछ खास तौर पर चेहरे की रेफ़रेंस इमेज स्वीकार करने और पूरी वीडियो जनरेशन में उसे बनाए रखने के लिए बने होते हैं।
Kling Avatar v2
Kling Avatar v2 चेहरों को वीडियो में एनिमेट करने के लिए खास तौर पर बनाया गया है। आप एक पोर्ट्रेट इमेज देते हैं और यह पूरी क्लिप में व्यक्ति की पहचान बनाए रखता है। यह सिर्फ़ एक सामान्य इमेज-टू-वीडियो टूल नहीं है जो संयोग से चेहरे भी संभाल लेता है। अवतार मोड इस तरह डिज़ाइन किए गए हैं कि चेहरे की पहचान को एक सुझाव नहीं, बल्कि एक सख़्त बाध्यता के रूप में लॉक करें।
Dreamactor M2.0
ByteDance का Dreamactor M2.0 एक रेफ़रेंस इमेज से फ़ुल-बॉडी किरदार एनिमेशन संभालता है। चेहरे की पहचान अच्छी तरह बनी रहती है, क्योंकि रेफ़रेंस को पूरी जनरेशन के दौरान एक स्ट्रक्चरल एंकर के रूप में इस्तेमाल किया जाता है, न कि सिर्फ़ स्टाइल के संकेत के रूप में। यह उन दृश्यों के लिए खास तौर पर अच्छा काम करता है जिनमें फ़ुल-बॉडी मूवमेंट चाहिए और चेहरा फिर भी पहचान में आना चाहिए।
Wan 2.7 R2V
Wan 2.7 R2V (Reference-to-Video) किसी भी सब्जेक्ट की रेफ़रेंस इमेज लेकर उसे एनिमेट करता है। R2V पदनाम का मतलब है कि यह रेफ़रेंस-आधारित जनरेशन के लिए डिज़ाइन किया गया है। चेहरे की एकरूपता के लिए, यह प्लेटफ़ॉर्म पर उपलब्ध सबसे सीधे औज़ारों में से एक है।
Ovi I2V
Character AI का Ovi I2V सीधे एक फ़ोटो से ऑडियो के साथ वीडियो जनरेट करता है। यह पोर्ट्रेट फ़ोटो को विशेष रूप से अच्छी तरह संभालता है, जिससे उन दृश्यों के लिए यह व्यावहारिक बनता है जिनमें किरदार को बोलना, प्रतिक्रिया देना या कैमरे से जुड़ना हो।
Grok Imagine R2V
Grok Imagine R2V एक और रेफ़रेंस-टू-वीडियो विकल्प है, जो एक फ़ोटो लेता है और गति के दौरान सब्जेक्ट की पहचान बनाए रखते हुए सुसंगत वीडियो आउटपुट देता है। अपने खास किरदार प्रकार पर तुलना के लिए इसे Wan 2.7 R2V के साथ आज़माना उपयोगी है।
💡 फ़ेस-लॉक्ड वीडियो के लिए, टेक्स्ट-टू-वीडियो की जगह इमेज-टू-वीडियो और रेफ़रेंस-टू-वीडियो मॉडल को प्राथमिकता दें। इमेज ही वह बाधा है जो बहाव को रोकती है।
फ़ेस लॉकिंग के लिए इमेज-टू-वीडियो का उपयोग
एंकर फ़्रेम कैसे काम करता है
जब आप इमेज-टू-वीडियो मॉडल का उपयोग करते हैं, तो इनपुट इमेज ही असली पहला फ़्रेम बन जाती है। मॉडल का काम "इस विवरण से मेल खाता एक विश्वसनीय व्यक्ति जनरेट करो" से बदलकर "इस खास व्यक्ति को एनिमेट करो" हो जाता है। यह मूल रूप से एक अलग काम है, और इससे कहीं ज़्यादा सुसंगत नतीजे मिलते हैं।
उस पहले फ़्रेम का चेहरा अब एक सख़्त विज़ुअल बाधा है। मॉडल चेहरे की ज्यामिति को स्वतंत्र रूप से दोबारा सैंपल नहीं कर सकता, क्योंकि उसे फ़्रेम 1 के साथ निरंतर रहना होता है। इसीलिए AI वीडियो प्रोडक्शन में चेहरे की एकरूपता के लिए इमेज-टू-वीडियो सबसे भरोसेमंद तरीका है।
अपनी सोर्स इमेज चुनना
इमेज-टू-वीडियो के लिए सोर्स इमेज ऐसी होनी चाहिए:
- किरदार तटस्थ या हल्के आराम वाले भाव में हो, ताकि मॉडल के पास किसी भी भावनात्मक स्थिति में एनिमेट होने की गुंजाइश हो
- पर्याप्त हेड रूम और दिखता शरीर के साथ बनी हो, ताकि मॉडल क्रॉपिंग की समस्या के बिना शरीर की गति एनिमेट कर सके
- सपाट, तटस्थ रोशनी में ली गई हो, ताकि मॉडल वीडियो में नाटकीय रोशनी जोड़ सके बिना किसी तेज़ रोशनी वाले रेफ़रेंस से लड़े
- उच्च रिज़ॉल्यूशन में हो, ताकि कंप्रेशन आर्टिफ़ैक्ट चेहरे के आकार में अस्पष्टता पैदा न करें
- मोशन ब्लर से मुक्त हो, ताकि चेहरे के किनारे तीखे और साफ़ हों और मॉडल उन्हें ट्रैक कर सके
ऐसी इमेज इस्तेमाल करने से बचें जिसमें किरदार किसी काम के बीच में हो। अगर आपके रेफ़रेंस में व्यक्ति हँसते हुए या सिर घुमाए हुए दिखता है, तो मॉडल उसी खास स्थिति से एंकर हो जाता है और उसके पास विश्वसनीय ढंग से एनिमेट होने की कम लचक रह जाती है।
PicassoIA पर Kling Avatar v2 कैसे इस्तेमाल करें
PicassoIA पर सुसंगत चेहरे वाले वीडियो का सबसे सीधा रास्ता Kling Avatar v2 है। यह रहा सटीक वर्कफ़्लो:
चरण 1: अपना रेफ़रेंस पोर्ट्रेट तैयार करें
अपने किरदार का एक साफ़ पोर्ट्रेट जनरेट करें या फ़ोटो लें। तटस्थ भाव, सामने से या हल्का थ्री-क्वार्टर कोण, सॉफ़्ट रोशनी, सादा बैकग्राउंड। इसे पूरे रिज़ॉल्यूशन में सेव करें।
चरण 2: Kling Avatar v2 खोलें
PicassoIA पर Kling Avatar v2 पर जाएँ और अपना पोर्ट्रेट इनपुट इमेज के रूप में अपलोड करें। यह टूल खास तौर पर चेहरे के पोर्ट्रेट को मुख्य इनपुट के रूप में स्वीकार करने के लिए बनाया गया है।
चरण 3: अपना मोशन प्रॉम्प्ट लिखें
बताएँ कि किरदार क्या करे, न कि वह कैसा दिखता है। चेहरा पहले से इमेज से तय है। इन पर ध्यान दें:
- गति ("बाईं ओर देखता है, हल्के से मुस्कुराता है, सिर हिलाता है")
- परिवेश ("गर्म रोशनी वाले बैकग्राउंड के साथ एक हल्की रोशनी वाले कैफ़े में बैठा है")
- कैमरा मूवमेंट ("चेहरे की ओर धीरे डॉली इन")
चरण 4: जनरेट करें और जाँचें
जनरेशन चलाएँ। जाँचें कि चेहरा आपके रेफ़रेंस से मेल खाता है। अगर काफ़ी बहाव हो, तो यह आज़माएँ:
- रेफ़रेंस को चेहरे पर और कसकर क्रॉप करें (पोर्ट्रेट से शरीर हटाएँ)
- मोशन प्रॉम्प्ट को एक साथ कम क्रियाओं तक सरल करें
- एक अलग सीड वैल्यू के साथ चलाएँ
चरण 5: क्लिप क्रम से बनाएँ
मल्टी-सीन वीडियो के लिए, एक क्लिप के आउटपुट फ़्रेम को अगली क्लिप की रेफ़रेंस इमेज की तरह इस्तेमाल करें। इससे विज़ुअल निरंतरता की एक श्रृंखला बनती है। हर क्लिप का अंतिम चेहरा अगली क्लिप का शुरुआती एंकर बन जाता है, जिससे पूरे क्रम में बहाव जमा नहीं होता।
💡 क्लिप को जोड़ते चलें। क्लिप 1 का अंतिम फ़्रेम क्लिप 2 के इनपुट के रूप में देना, बिना पोस्ट-प्रोडक्शन सुधार के पूरे वीडियो क्रम में निरंतरता बनाए रखने का सबसे भरोसेमंद तरीका है।
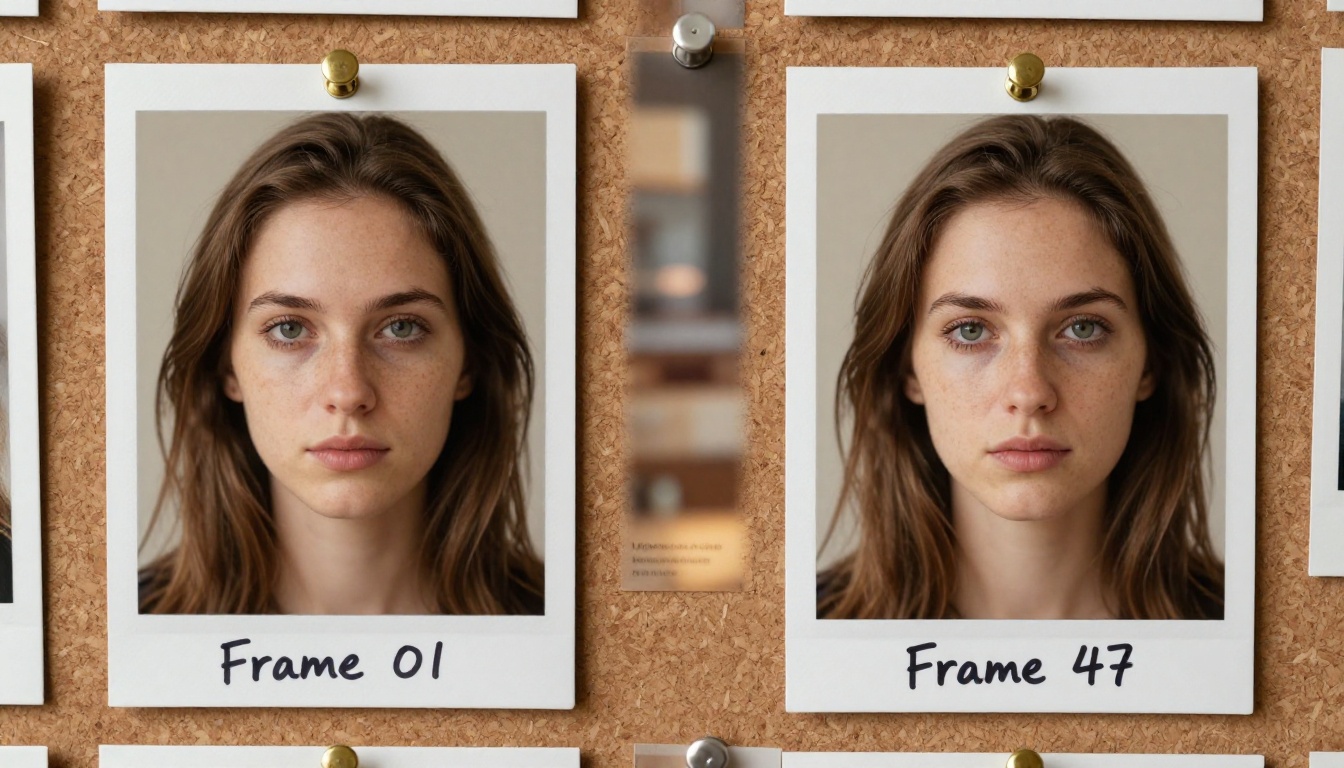
एक जैसे चेहरों के लिए प्रॉम्प्ट रणनीतियाँ
जब आपको Wan 2.7 T2V, Seedance 2.0, या Kling v3 Omni Video जैसे टेक्स्ट-टू-वीडियो मॉडल के साथ काम करना हो, तब प्रॉम्प्ट रणनीति एकरूपता के लिए आपका मुख्य लीवर बन जाती है।
किरदार विवरण को एंकर करना
एक तय किरदार-विवरण ब्लॉक बनाएँ और उसे हर प्रॉम्प्ट में बिना बदले चिपकाएँ। शब्दों का हर बदलाव चेहरे में बदलाव का रास्ता खोल देता है। कुछ इस तरह:
"28-year-old woman, pale skin with light freckles, blue-grey eyes, narrow straight nose, thin lips, short dark auburn hair cut to the jaw, small silver stud earrings"
यह ब्लॉक हर जनरेशन में एक जैसा रहता है। बदलते हैं दृश्य, क्रिया और कैमरा की स्थिति। किरदार का विवरण एक लॉक किया हुआ वेरिएबल है, जिसे आप क्लिपों के बीच नहीं छेड़ते।
लाइटिंग की एकरूपता
रोशनी चेहरों को बदल देती है। बाईं ओर से रोशन किया गया किरदार मॉडल को दाईं ओर से रोशन उसी किरदार से थोड़ा अलग दिखता है, क्योंकि हाइलाइट और परछाइयाँ चेहरे की दिखने वाली ज्यामिति बदल देती हैं। एक लाइटिंग सेटअप चुनें और उसे हर प्रॉम्प्ट में बिल्कुल एक जैसा लिखें।
- दृश्य 1 में "camera-left से आती सॉफ़्ट प्राकृतिक खिड़की की रोशनी" वही होनी चाहिए जो दृश्य 10 में है
- यह "ड्रामेटिक सिनेमैटिक लाइटिंग" से ज़्यादा दोहराने लायक है, जिसे मॉडल हर बार अलग तरीके से समझता है
प्रॉम्प्ट में क्या न करें
| यह न करें | इसकी जगह यह करें |
|---|
| "Beautiful woman" (अस्पष्ट) | सटीक शारीरिक विवरण |
| "Cinematic face" | सटीक रोशनी की स्थितियाँ |
| हर दृश्य में किरदार की उम्र बदलना | हर प्रॉम्प्ट में तय उम्र |
| किरदार के विवरण में भाव बताना | भावों को क्रिया के विवरण में रखें |
| बालों का असंगत विवरण | बालों का सटीक विवरण लॉक करें |
| "Realistic woman" | पूरा सटीक शारीरिक विवरण |
Animate Replace और मोशन कंट्रोल
अधिक जटिल स्थितियों के लिए, जहाँ आप किसी किरदार को मौजूदा फ़ुटेज में डालना या खास मूवमेंट पैटर्न लगाना चाहते हैं, Wan 2.2 Animate Replace आपको मूल गति बनाए रखते हुए वीडियो में किरदार बदलने देता है। यह तब काम आता है जब आपके पास सही क्रिया हो, पर गलत चेहरा, और आप अपने रेफ़रेंस किरदार को दृश्य में डालना चाहते हों।
Kling v3 Motion Control आपको मोशन सिग्नल का उपयोग करके किरदार की गति पर सटीक नियंत्रण देता है। ज़्यादा नियंत्रित गति का मतलब है कि जटिल क्रियाओं के दौरान चेहरा बिगड़ने के कम मौके। जब मूवमेंट के दौरान चेहरे की निष्ठा सबसे ज़रूरी हो, तब मोशन कंट्रोल समीकरण से एक और चर हटा देता है।
ये दोनों टूल मुख्य रेफ़रेंस-इमेज वर्कफ़्लो की जगह नहीं लेते, बल्कि उसे पूरा करते हैं। ये तब सबसे उपयोगी होते हैं जब आपने पहले ही किरदार की पहचान लॉक कर ली हो और अब गति को सटीकता से नियंत्रित करना चाहते हों।
AI वीडियो में चेहरे के बहाव की 5 गलतियाँ जो बंद करनी हैं
ये वे पैटर्न हैं जो AI वीडियो में लगातार चेहरे की असंगति पैदा करते हैं, और ये सभी टाले जा सकते हैं:
-
जब इमेज-टू-वीडियो मौजूद है, तब टेक्स्ट-टू-वीडियो इस्तेमाल करना। अगर आपके पास रेफ़रेंस इमेज है, तो उसका उपयोग करें। असली चेहरे से एंकर होने पर मॉडल उतना अंदाज़ा नहीं लगाएगा। सिर्फ़ टेक्स्ट वाले मॉडल तक जाने से पहले Wan 2.7 I2V या Kling Avatar v2 को डिफ़ॉल्ट रखें।
-
हर बार नया रेफ़रेंस जनरेट करना। हर किरदार के लिए एक रेफ़रेंस इमेज चुनें और उसे कभी न बदलें। एक ही किरदार का "नया वर्ज़न" जनरेट करने से हमेशा बारीक अंतर आएँगे, जो क्लिपों में जुड़ते जाएँगे।
-
दृश्यों के बीच किरदार का विवरण बदलना। छोटे शब्द-बदलाव ("blue eyes" बनाम "blue-grey eyes") भी मापने लायक चेहरे का अंतर पैदा करते हैं। विवरण लॉक करें और उसे न छुएँ।
-
चेहरे-संवेदनशील वीडियो के लिए कम रिज़ॉल्यूशन इस्तेमाल करना। ज़्यादा रिज़ॉल्यूशन वाले आउटपुट मॉडल को चेहरे का विवरण बचाने के लिए ज़्यादा पिक्सल देते हैं। जब चेहरे की निष्ठा सबसे ज़रूरी हो, तब Wan 2.1 I2V 720p या ऐसे ही उच्च-रिज़ॉल्यूशन मॉडल इस्तेमाल करें।
-
पहले फ़्रेम की गुणवत्ता को नज़रअंदाज़ करना। किसी भी इमेज-टू-वीडियो मॉडल के लिए, पहला फ़्रेम ही सब कुछ है। उस रेफ़रेंस इमेज को बिल्कुल सही बनाने में जितना समय चाहिए, लगाएँ। वीडियो उतना ही एकसार होगा जितना वह फ़्रेम जिससे आप शुरू करते हैं।
सब कुछ एक साथ रखना
AI वीडियो में एक जैसे चेहरे एक मूल सिद्धांत पर निर्भर करते हैं: मॉडल को सिर्फ़ मौखिक नहीं, विज़ुअल बाधा दें। टेक्स्ट विवरण बहकते हैं। इमेज एंकर करती है।
वह वर्कफ़्लो जो मल्टी-सीन प्रोजेक्ट्स में टिकता है:
- तटस्थ भाव और सॉफ़्ट, बिखरी हुई रोशनी वाला एक साफ़ रेफ़रेंस पोर्ट्रेट जनरेट करें
- केवल टेक्स्ट वाली जनरेशन की जगह अवतार या रेफ़रेंस-टू-वीडियो मॉडल (Kling Avatar v2, Wan 2.7 R2V, Dreamactor M2.0) का उपयोग करें
- हर क्लिप का अंतिम फ़्रेम अगली क्लिप के इनपुट के रूप में देकर क्लिप जोड़ें
- सभी टेक्स्ट विवरण लॉक रखें: हर जनरेशन में वही शब्द, वही रोशनी, वही किरदार का ब्योरा
- जब चेहरे का विवरण मायने रखे, तब 720p या उससे ऊँचे रिज़ॉल्यूशन पर काम करें
- अपनी पहली जनरेशन से पहले कैरेक्टर बाइबल बनाएँ और उस पर टिके रहें
यह 10 क्लिपों में पिक्सल-परफ़ेक्ट एकरूपता की गारंटी नहीं है। मौजूदा मॉडल अभी भी बहकते हैं, खासकर जटिल गतियों या अत्यधिक कोण बदलाव में। लेकिन यह वर्कफ़्लो अनियंत्रित बदलाव को न्यूनतम पर लाता है और पूरे प्रोडक्शन में एक सुसंगत किरदार-आर्क के लिए आपको असली मौका देता है।
अपना किरदार अभी बनाएँ
PicassoIA के पास इसके लिए पूरा टूल्स का सेट है: Wan 2.7 I2V जैसे इमेज-टू-वीडियो मॉडल, Kling Avatar v2 जैसे अवतार मॉडल, और Dreamactor M2.0 जैसे रेफ़रेंस-एंकर्ड टूल। मॉडल मौजूद हैं। आप जो लाते हैं वह है एक साफ़ रेफ़रेंस इमेज और एक अनुशासित वर्कफ़्लो।
एक किरदार चुनें। एक रेफ़रेंस पोर्ट्रेट जनरेट करें। अपनी पहली क्लिप के लिए उसे Kling Avatar v2 में चलाएँ। किसी पूरे प्रोडक्शन पाइपलाइन को उसके इर्द-गिर्द बनाने से पहले देखें कि सुसंगत चेहरे वाला वीडियो व्यवहार में कैसा लगता है।
इस लेख में बताए गए सभी मॉडल picassoia.com/en/all-models पर उपलब्ध हैं।


