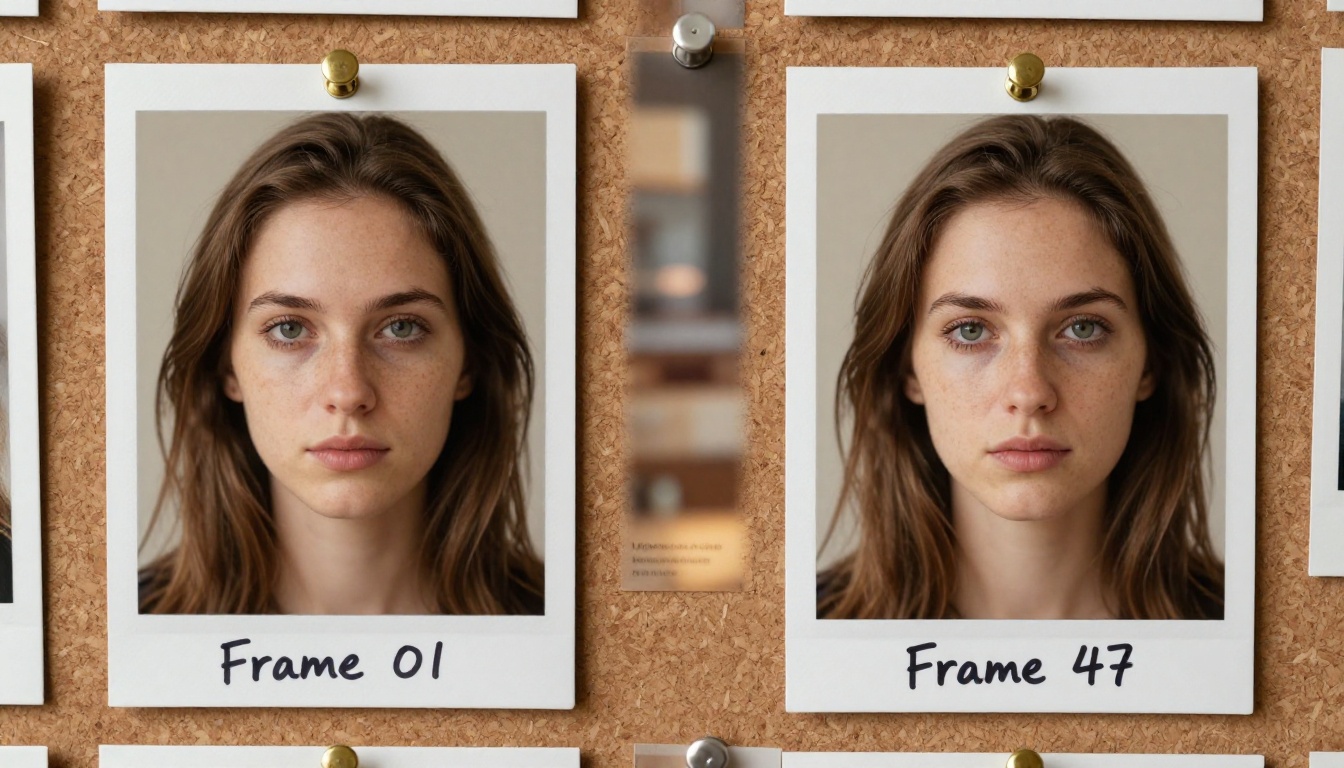
Faire apparaître le même visage de façon fiable dans plusieurs clips vidéo IA n’est pas un problème résolu. À chaque nouvelle scène générée, les modèles de diffusion repartent de zéro, et ce nouveau visage peut partager l’allure générale de votre personnage tout en s’écartant sur la ligne de la mâchoire, la forme des yeux ou le teint. Pour de courtes expérimentations, c’est acceptable. Pour un projet que vous voulez réellement livrer, c’est un désastre.
C’est corrigeable. Pas parfaitement, et pas sans effort, mais suffisamment fiable pour construire des projets vidéo IA cohérents avec des personnages reconnaissables. L’approche ne consiste pas à courir après des prompts magiques. Il s’agit de comprendre pourquoi les visages dérivent et de construire un flux de travail qui lutte contre ce phénomène.
Pourquoi les visages IA dérivent d’un clip à l’autre
L’aléatoire intégré à chaque génération
Les modèles de texte vers vidéo et d’image vers vidéo fonctionnent en débruitant un bruit aléatoire pour en faire des images cohérentes, guidées par votre prompt. Le mot clé est « aléatoire ». Chaque génération part d’un seed de bruit neuf, sauf si vous le contrôlez explicitement. Cela signifie que même si vous écrivez deux fois exactement la même description de personnage, ce point de départ aléatoire produit deux personnes différentes qui partagent simplement quelques traits généraux.
Le processus de diffusion n’a pas de mémoire. Il ne sait pas à quoi ressemblait votre personnage dans le clip précédent. Il ne connaît que ce que dit votre prompt à l’instant présent. Même une rédaction de prompt méticuleuse dérivera donc avec le temps, car le langage est une référence imprécise pour un visage.
Comment l’attention portée au prompt dégrade les détails du visage
Lorsque vous décrivez « une femme aux yeux bruns, aux pommettes saillantes et aux cheveux roux mi-longs marchant dans une rue de la ville », le modèle répartit son attention sur chaque partie de cette description. La rue de la ville compte. Les cheveux roux mi-longs comptent. Le mouvement de marche compte. Les yeux et les pommettes rivalisent avec tout le reste pour influencer le résultat.
En pratique, les descriptions de l’environnement et du mouvement dominent souvent, et les détails du visage se diluent en quelque chose de plausible mais pas identique. Plus votre prompt est long et complexe, plus cet effet de moyennage s’accentue.
💡 La solution n’est pas d’allonger les prompts. Elle passe par une référence visuelle. Un visage montré sous forme d’image transmet beaucoup plus d’informations que n’importe quelle description textuelle.
La stratégie de l’image de référence
Ce qui fait un visage de référence exploitable
Une image de référence est votre outil le plus puissant pour la cohérence des visages. L’objectif est un portrait net et bien éclairé, qui donne au modèle le plus d’informations faciales possible. Voici ce qui rend une référence réellement efficace :
- Expression neutre. Sourire ou exprimer une émotion crée une ambiguïté sur les proportions du visage. Une expression neutre ou légèrement douce offre la base la plus claire.
- Face ou léger trois-quarts. Les profils complets cachent trop de choses. Le point idéal se situe entre 0 et 30 degrés par rapport au centre.
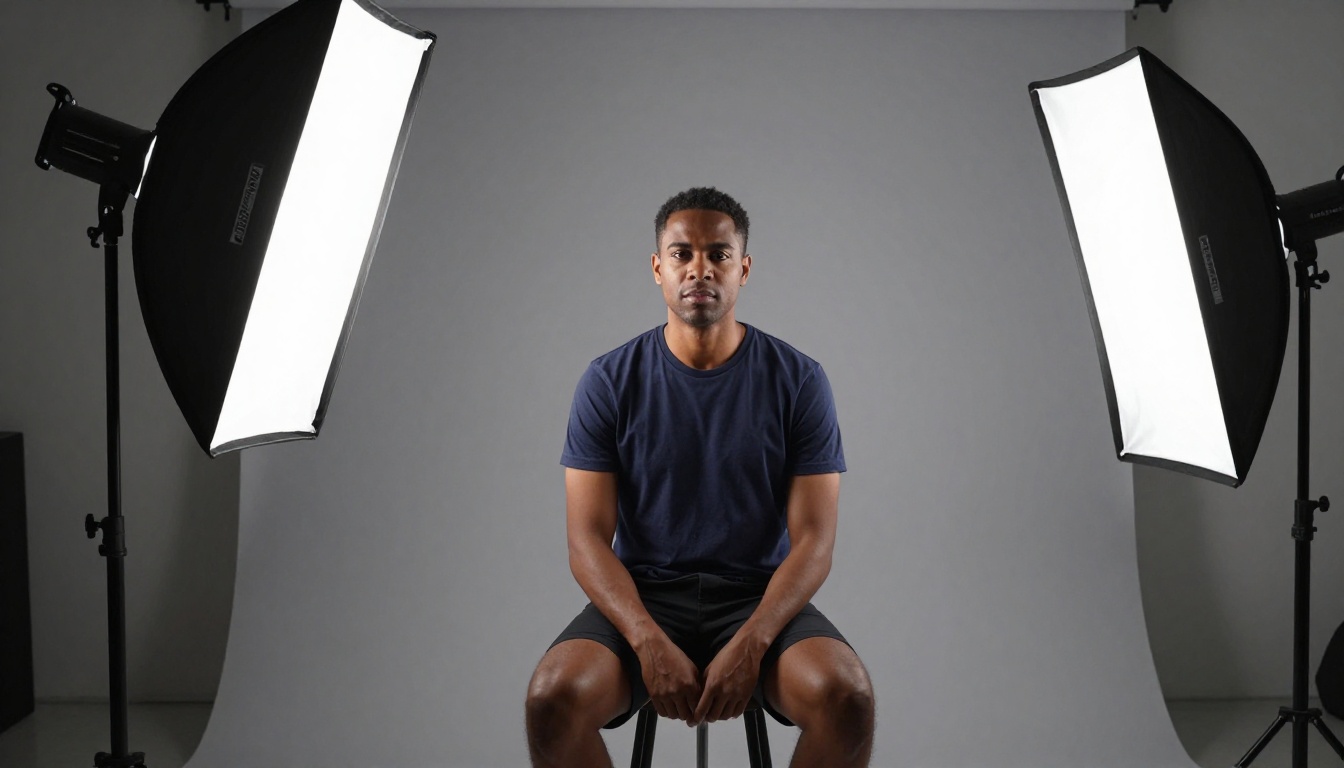
- Éclairage uniforme et diffus. Les ombres dures masquent les traits. La lumière douce d’une fenêtre ou un simple dispositif clé-fill donne les meilleurs résultats.
- Arrière-plan uni ou flou. Les arrière-plans chargés rivalisent avec le visage pour l’attention du modèle.
- Haute résolution. Plus il y a de détails disponibles, plus le modèle dispose d’éléments pour s’ancrer.
Un portrait pris à 85 mm f/2.0, avec la lumière naturelle d’une fenêtre et un arrière-plan épuré, correspond presque exactement à ce que vous recherchez. Il ne s’agit pas d’esthétique. Il s’agit de densité d’information.
Les angles les plus importants
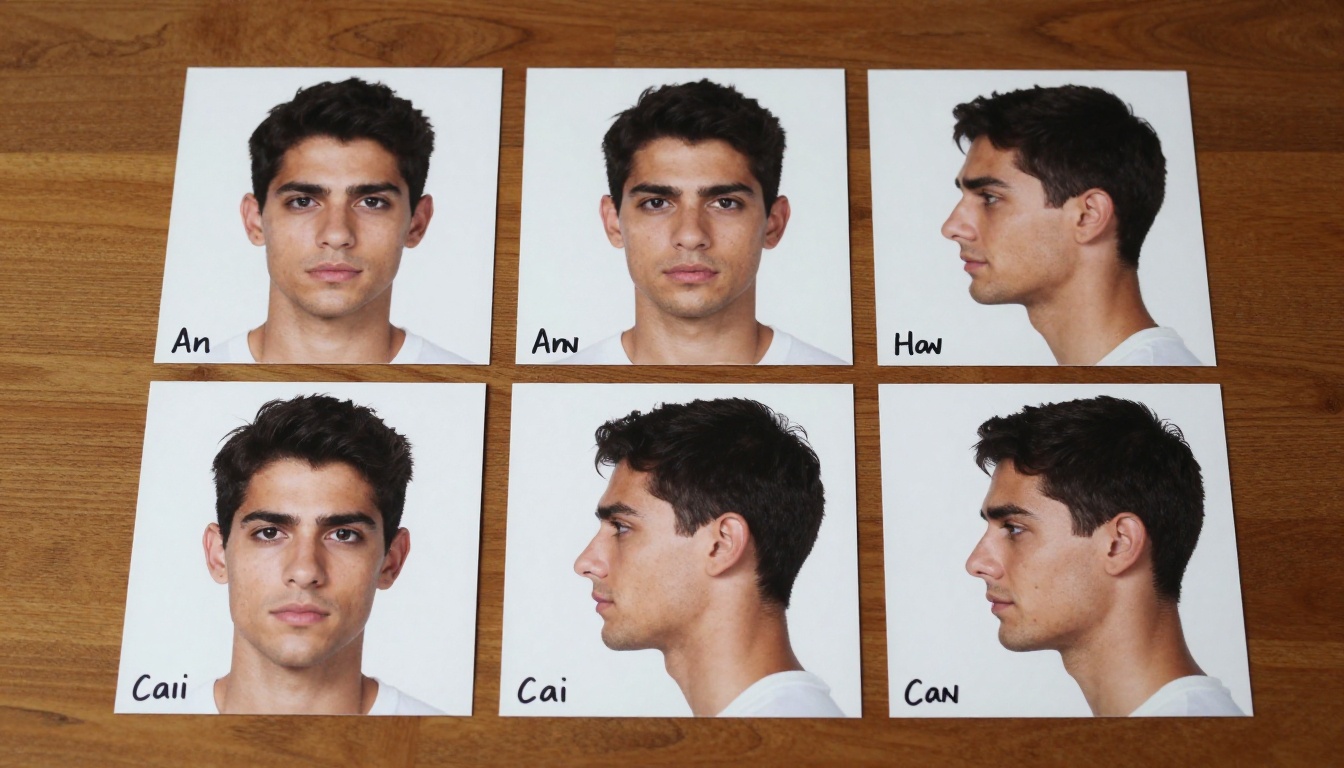
Rassembler plusieurs angles de référence du même personnage améliore nettement la cohérence dans les plans où la caméra bouge ou où le personnage se tourne. Si votre clip vidéo montre le personnage de profil, le modèle a besoin de données de référence de profil pour conserver la fidélité.
| Angle | Quand vous en avez besoin |
|---|
| Face (0 degré) | Gros plans frontaux |
| Trois-quarts (30 degrés) | La plupart des dialogues et des plans de marche |
| Profil (90 degrés) | Plans par-dessus l’épaule et plans en silhouette |
| Léger plongeant | Plans en vue subjective depuis le haut |
| Contre-plongée légère | Scènes dramatiques en contre-plongée |
Construire une mini fiche de personnage avec 3 à 5 angles, tous sous un éclairage constant, prend 10 minutes et évite des heures de régénération. Lorsque vous disposez d’images de référence pour chaque perspective de caméra majeure, vous avez toujours le bon point d’ancrage pour n’importe quel type de plan.
Construire une bible de personnage
Avant de lancer la moindre génération vidéo, les créateurs de vidéos IA sérieux constituent ce que les cinéastes appellent une bible de personnage : un document figé qui définit chaque attribut physique du personnage avec des détails visuels et textuels précis.
Pour la production vidéo IA, une bible de personnage pratique comprend :
Éléments visuels :
- Le portrait de référence principal (pleine résolution, expression neutre, face)
- Référence de profil (profil pur)
- Référence trois-quarts
- Variations d’expression (une joyeuse, une sérieuse, une surprise, toutes construites à partir du portrait principal)
Repères textuels :
- L’âge écrit sous forme de nombre précis, et non de tranche
- Le teint décrit avec une terminologie précise (brun moyen chaud, ivoire pâle, ébène profond)
- La couleur des yeux avec un détail précis (bleu acier avec un anneau ambré autour de la pupille)
- Cheveux : couleur, longueur, texture et coiffure verrouillées par un vocabulaire précis
- Signes distinctifs : taches de rousseur, emplacement d’une cicatrice, forme des sourcils
Spécification d’éclairage :
- Un dispositif d’éclairage unique que vous utiliserez pour toutes les images de référence
- La même description d’éclairage pour tous les prompts de texte vers vidéo
Cela ressemble à une charge de travail supplémentaire, mais c’est en réalité le document qui rend possible la production multi-scènes sans corrections manuelles constantes. Une fois la bible construite, chaque décision de génération devient claire : est-ce que cela correspond à la bible ? Si oui, on continue. Si non, on corrige d’abord.
Les modèles conçus pour la cohérence des visages
Tous les modèles de vidéo IA ne traitent pas les visages de la même manière. Certains sont uniquement pilotés par le prompt et produisent des résultats magnifiques mais indépendants du personnage. D’autres sont spécifiquement conçus pour accepter une image de référence de visage et la conserver pendant toute la génération vidéo.
Kling Avatar v2
Kling Avatar v2 est conçu spécifiquement pour animer des visages en vidéo. Vous fournissez un portrait et il préserve l’identité de la personne pendant toute la durée du clip. Ce n’est pas un outil d’image vers vidéo générique qui gère aussi les visages par hasard. Les modes avatar sont conçus de manière architecturale pour verrouiller l’identité faciale comme une contrainte stricte plutôt qu’une simple suggestion.
Dreamactor M2.0
Dreamactor M2.0 de ByteDance gère l’animation de personnage en pied à partir d’une image de référence. L’identité faciale tient bien, car la référence sert d’ancre structurelle tout au long de la génération, et pas seulement de suggestion de style. Il fonctionne particulièrement bien pour les scènes qui exigent un mouvement du corps entier tout en gardant le visage reconnaissable.
Wan 2.7 R2V
Wan 2.7 R2V (Reference-to-Video) accepte une image de référence de n’importe quel sujet et l’anime. La désignation R2V signifie précisément qu’il est conçu pour une génération ancrée sur une référence. Pour la cohérence des visages, c’est l’un des outils les plus directs disponibles sur la plateforme.
Ovi I2V
Ovi I2V de Character AI génère une vidéo avec audio directement à partir d’une photo. Il gère particulièrement bien les photos de portrait, ce qui le rend pratique pour les scènes où un personnage doit parler, réagir ou interagir avec la caméra.
Grok Imagine R2V
Grok Imagine R2V est une autre option de référence vers vidéo qui prend une photo et produit une vidéo cohérente, en préservant l’identité du sujet pendant le mouvement. Il vaut la peine d’être testé en parallèle de Wan 2.7 R2V pour comparer les résultats sur votre type de personnage précis.
💡 Pour une vidéo à visage verrouillé, privilégiez les modèles image vers vidéo et référence vers vidéo plutôt que texte vers vidéo. L’image est la contrainte qui empêche la dérive.
Utiliser l’image vers vidéo pour verrouiller le visage
Le fonctionnement de l’image d’ancrage
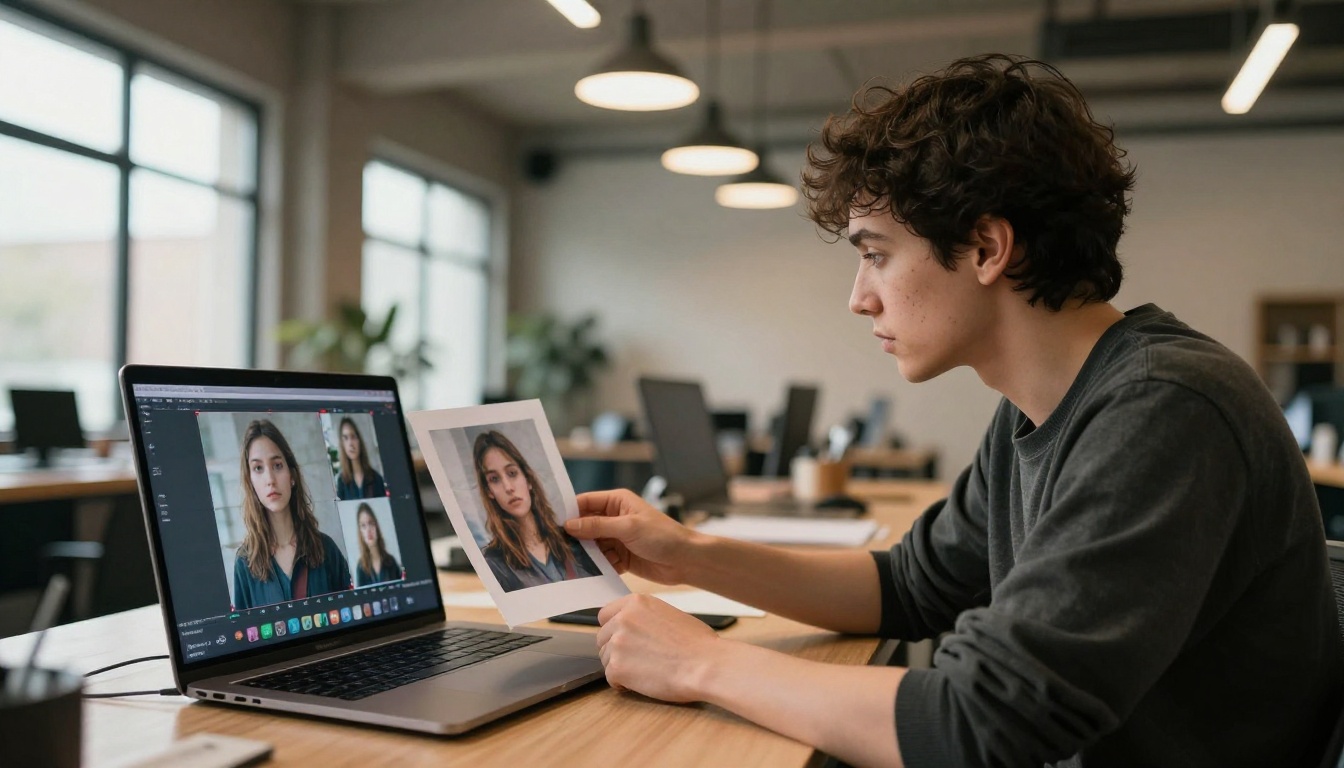
Lorsque vous utilisez un modèle image vers vidéo, l’image fournie devient littéralement la première image. La tâche du modèle passe de « générer une personne plausible correspondant à cette description » à « animer cette personne précise ». C’est une tâche fondamentalement différente, qui produit des résultats beaucoup plus cohérents.
Le visage de cette première image devient une contrainte visuelle stricte. Le modèle ne peut pas rééchantillonner librement la géométrie du visage, car il doit rester continu avec l’image 1. C’est pourquoi l’image vers vidéo est la méthode la plus fiable pour la cohérence des visages en production vidéo IA.
Choisir votre image source
L’image source pour l’image vers vidéo doit être :
- Le personnage avec une expression neutre ou légèrement détendue, pour que le modèle ait de la marge pour l’animer vers n’importe quel état émotionnel
- Cadrée avec suffisamment d’espace au-dessus de la tête et le corps visible, pour que le modèle puisse animer le mouvement du corps sans problème de recadrage
- Prise sous un éclairage plat et neutre, pour que le modèle puisse ajouter un éclairage dramatique dans la vidéo sans lutter contre une référence très éclairée
- En haute résolution, pour que les artefacts de compression n’introduisent pas d’ambiguïté sur la forme du visage
- Exempte de flou de bougé, pour que les contours du visage soient nets et bien définis pour que le modèle puisse les suivre
Évitez les images où le personnage est en pleine action. Si votre référence montre la personne en train de rire ou la tête tournée, le modèle s’ancre sur cet état précis et dispose de moins de latitude pour l’animer de façon crédible.
Kling Avatar v2 est le chemin le plus direct vers une vidéo à visage cohérent sur PicassoIA. Voici le flux de travail exact :
Étape 1 : Préparez votre portrait de référence
Générez ou photographiez un portrait net de votre personnage. Expression neutre, face ou léger trois-quarts, éclairage doux, arrière-plan uni. Enregistrez-le en pleine résolution.
Étape 2 : Ouvrez Kling Avatar v2
Rendez-vous sur Kling Avatar v2 sur PicassoIA et importez votre portrait comme image d’entrée. L’outil est conçu spécifiquement pour accepter des portraits de visage comme entrée principale.
Étape 3 : Rédigez votre prompt de mouvement
Décrivez ce que vous voulez que le personnage fasse, et non à quoi il ressemble. Le visage est déjà défini par l’image. Concentrez-vous sur :
- Le mouvement (« se tourne vers la gauche, sourit légèrement, hoche la tête »)
- L’environnement (« assis dans un café doucement éclairé, avec un arrière-plan chaleureux »)
- Le mouvement de caméra (« travelling lent vers le visage »)
Étape 4 : Générez et évaluez
Lancez la génération. Vérifiez que le visage correspond à votre référence. S’il y a une dérive importante, essayez :
- De recadrer la référence plus serrée sur le visage (retirez le corps du portrait)
- De simplifier le prompt de mouvement pour réduire le nombre d’actions simultanées
- De relancer avec une autre valeur de seed
Étape 5 : Construisez les clips en séquence
Pour une vidéo multi-scènes, utilisez l’image finale d’un clip comme image de référence du clip suivant. Cela crée une chaîne de continuité visuelle. Le visage final de chaque clip devient le point d’ancrage de départ du suivant, ce qui empêche la dérive de s’accumuler sur l’ensemble de votre séquence.
💡 Enchaînez vos clips. L’image finale du clip 1 utilisée comme entrée du clip 2 est le moyen le plus fiable de maintenir la continuité sur une séquence vidéo complète, sans retouches en post-production.
Stratégies de prompt pour des visages cohérents
Lorsque vous travaillez avec des modèles de texte vers vidéo comme Wan 2.7 T2V, Seedance 2.0 ou Kling v3 Omni Video, la stratégie de prompt devient votre principal levier de cohérence.
Ancrage par la description du personnage
Construisez un bloc de description de personnage fixe et collez-le dans chaque prompt, sans le modifier. Chaque variation de mot ouvre la porte à une variation du visage. Par exemple :
« Femme de 28 ans, peau pâle avec de légères taches de rousseur, yeux bleu-gris, nez fin et droit, lèvres fines, cheveux courts roux acajou foncé coupés à la mâchoire, petites boucles d’oreilles argentées »
Ce bloc reste identique à chaque génération. Ce qui change, c’est la scène, l’action et la position de la caméra. La description du personnage est une variable verrouillée que vous ne touchez pas entre les clips.
Cohérence de l’éclairage
L’éclairage modifie les visages. Un personnage éclairé par la gauche paraît subtilement différent pour le modèle qu’un même personnage éclairé par la droite, car les reflets et les ombres altèrent la géométrie faciale perçue. Choisissez un dispositif d’éclairage et décrivez-le de façon identique dans chaque prompt.
- « Lumière naturelle douce de fenêtre venant de la gauche de la caméra » dans la scène 1 doit être exactement la même dans la scène 10
- C’est plus reproductible que « éclairage cinématographique dramatique », que le modèle interprète différemment à chaque fois
Ce qu’il faut éviter dans les prompts
| À éviter | À utiliser à la place |
|---|
| « Belle femme » (vague) | Descripteurs physiques précis |
| « Visage cinématographique » | Conditions d’éclairage précises |
| Changer l’âge du personnage d’une scène à l’autre | Âge fixe dans chaque prompt |
| Mentionner les émotions dans la description du personnage | Placer les émotions dans la description de l’action |
| Descriptions de cheveux incohérentes | Verrouiller la description exacte des cheveux |
| « Femme réaliste » | Description physique complète et précise |
Animate Replace et contrôle du mouvement
Pour des scénarios plus complexes, où vous voulez transférer un personnage dans une séquence existante ou appliquer des schémas de mouvement précis, Wan 2.2 Animate Replace vous permet de remplacer des personnages dans une vidéo tout en conservant le mouvement d’origine. C’est utile lorsque vous avez la bonne action mais le mauvais visage, et que vous voulez injecter votre personnage de référence dans la scène.
Kling v3 Motion Control vous permet de contrôler précisément la manière dont le personnage se déplace grâce à des signaux de mouvement. Un mouvement plus maîtrisé laisse moins de chances au visage de se déformer pendant les actions complexes. Lorsque la fidélité faciale pendant le mouvement est critique, le contrôle du mouvement retire une variable de plus de l’équation.
Ces deux outils complètent le flux de travail central fondé sur l’image de référence, sans le remplacer. Ils sont les plus utiles une fois que vous avez déjà verrouillé l’identité de votre personnage et que vous voulez contrôler le mouvement avec précision.
5 erreurs de dérive du visage à ne plus commettre
Voici les schémas qui provoquent systématiquement l’incohérence des visages en vidéo IA, et ils sont tous évitables :
-
Utiliser le texte vers vidéo alors que l’image vers vidéo existe. Si vous avez une image de référence, utilisez-la. Le modèle ne devinera pas aussi bien qu’il peut s’ancrer sur un vrai visage. Privilégiez Wan 2.7 I2V ou Kling Avatar v2 avant de recourir à un modèle uniquement textuel.
-
Générer une nouvelle référence à chaque fois. Choisissez une seule image de référence par personnage et ne la remplacez jamais. Générer « une nouvelle version » du même personnage produira toujours de légères variations qui s’accumulent d’un clip à l’autre.
-
Modifier la description du personnage entre les scènes. Même de petites variations de formulation (« yeux bleus » ou « yeux bleu-gris ») produisent une variation mesurable du visage. Verrouillez la description et n’y touchez pas.
-
Utiliser une faible résolution pour une vidéo où le visage est critique. Des sorties en haute résolution donnent au modèle davantage de pixels pour préserver les détails du visage. Utilisez Wan 2.1 I2V 720p ou un modèle haute résolution similaire lorsque la fidélité du visage compte le plus.
-
Négliger la qualité de la première image. Pour tout modèle image vers vidéo, la première image est essentielle. Prenez le temps nécessaire pour obtenir exactement la bonne image de référence. La vidéo ne sera jamais plus cohérente que l’image de départ.
Tout assembler
La cohérence des visages en vidéo IA repose sur un principe central : donnez au modèle une contrainte visuelle, pas seulement verbale. Les descriptions textuelles dérivent. Les images ancrent.
Le flux de travail qui tient la route dans les projets multi-scènes :
- Générez un portrait de référence net, avec une expression neutre et un éclairage doux et diffus
- Utilisez un modèle avatar ou référence vers vidéo (Kling Avatar v2, Wan 2.7 R2V, Dreamactor M2.0) plutôt qu’une génération uniquement textuelle
- Enchaînez les clips en utilisant l’image finale de chaque clip comme entrée du suivant
- Gardez toutes les descriptions textuelles verrouillées : mêmes formulations, même éclairage, mêmes détails du personnage dans chaque génération
- Travaillez en 720p ou plus lorsque le détail du visage compte
- Construisez une bible de personnage et engagez-vous dessus avant votre première génération
Ce n’est pas une garantie de cohérence parfaite au pixel près sur 10 clips. Les modèles actuels dérivent encore, surtout avec des mouvements complexes ou des changements d’angle extrêmes. Mais ce flux de travail réduit au minimum les variations non maîtrisées et vous donne une véritable chance d’obtenir un arc de personnage cohérent sur une production complète.
Créez votre personnage dès maintenant
PicassoIA dispose de tout l’ensemble d’outils nécessaire : des modèles image vers vidéo comme Wan 2.7 I2V, des modèles avatar comme Kling Avatar v2, et des outils à ancrage par référence comme Dreamactor M2.0. Les modèles sont là. Ce que vous apportez, c’est une image de référence nette et un flux de travail rigoureux.
Choisissez un seul personnage. Générez un portrait de référence. Passez-le dans Kling Avatar v2 pour votre premier clip. Voyez ce que donne une vidéo à visage cohérent en pratique avant de construire tout un pipeline de production autour.
Tous les modèles mentionnés dans cet article sont disponibles sur picassoia.com/en/all-models.


