تلتقط صورة. بعد ثوانٍ، تتنفس تلك الصورة الثابتة وتتحرك وتصير مقطع فيديو حيًّا. هذا ما يفعله الذكاء الاصطناعي لتحويل الصورة إلى فيديو، وهو يحدث الآن عبر منصات التواصل الاجتماعي وحملات التسويق ومحافظ التصوير الفوتوغرافي واستوديوهات الإبداع بالذكاء الاصطناعي في جميع أنحاء العالم. التقنية التي تقف خلف هذا مدهشة حقًا، وحين تفهم طريقة عملها ستريد استخدامها فورًا.
ماذا يفعل الذكاء الاصطناعي لتحويل الصورة إلى فيديو فعليًا
يأخذ الذكاء الاصطناعي لتحويل الصورة إلى فيديو صورة ثابتة واحدة مدخلًا، وينتج مقطع فيديو قصيرًا متحركًا مخرجًا. لا يكتفي النموذج بالتقريب أو تطبيق تأثير تحريك بسيط، بل يولّد إطارات جديدة بالكامل، إطارًا تلو الآخر، تمثل تسلسلًا حركيًا معقولًا استنادًا إلى ما كان في الصورة الفوتوغرافية الأصلية.
من صورة فوتوغرافية ثابتة إلى مقطع متحرك
حين تُدخل صورة إلى نموذج مثل Wan 2.7 I2V أو Kling v2.1، لا يكتفي الذكاء الاصطناعي بـ"تحريك" الصورة بالمعنى التقليدي. بل يولّد تسلسلًا من الإطارات، عادةً ما بين 24 و60 إطارًا في الثانية، حيث يمثل كل إطار تصييرًا واقعيًا كالصور الفوتوغرافية لكيفية تطور المشهد مع الوقت. تتموج المياه. يتحرك الشعر. ترمش العينان. ينساب القماش مع النسيم.
يمكن أن تكون النتيجة من 2 إلى 10 ثوانٍ من الفيديو، حسب النموذج وإعداداتك. بعض النماذج الأحدث مثل Kling v3 Video تدفع هذا نحو جودة سينمائية بدقة 1080p، مع حركة كاميرا طبيعية الشكل وسلوك واقعي للشخص مدمج افتراضيًا.
الفرق عن تحويل النص إلى فيديو
يولّد الذكاء الاصطناعي لتحويل النص إلى فيديو مقطعًا من وصف مكتوب وحده. أما الذكاء الاصطناعي لتحويل الصورة إلى فيديو فيستخدم صورة فوتوغرافية حقيقية نقطة ارتكاز للمشهد. وهذا يمنحك تحكمًا أكبر بكثير في الشخص والبيئة والأسلوب البصري، لأنك تبدأ من شيء ملموس بدلًا من الاعتماد على النموذج في اختراع كل شيء من الصفر.
الجمع بين الأسلوبين قوي: يمكنك توليد صورة بخصائص بصرية دقيقة باستخدام نموذج لتحويل النص إلى صورة، ثم تمريرها إلى نموذج لتحويل الصورة إلى فيديو لتحريكها. سير العمل المكوّن من خطوتين هذا من أكثر مسارات إنشاء المحتوى بالذكاء الاصطناعي استخدامًا اليوم. فهو يمنحك المرونة الإبداعية للأوامر النصية والدقة البصرية لصورة مرجعية حقيقية.
التقنية التي تقف خلفه
نماذج الانتشار والاتساق الزمني
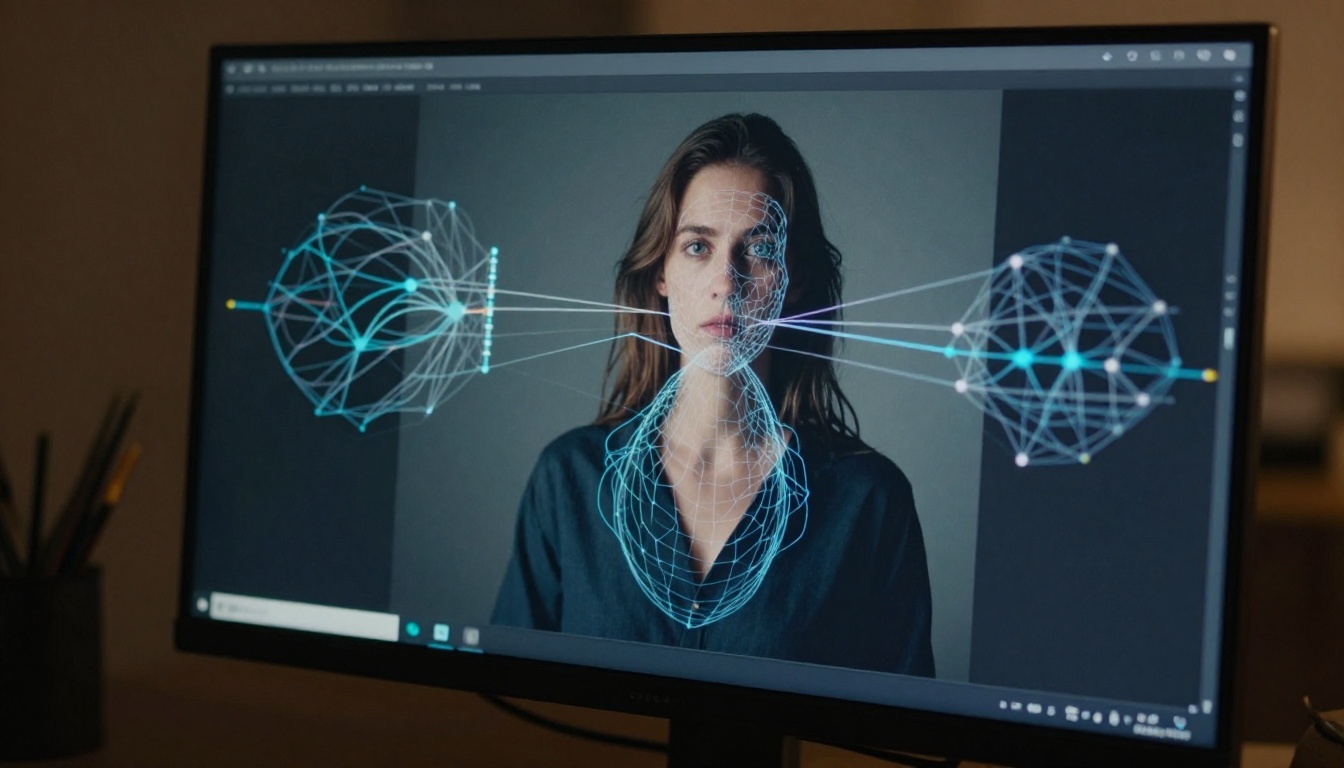
تُبنى معظم نماذج تحويل الصورة إلى فيديو على بنى انتشار الفيديو. وهي امتدادات لعملية الانتشار نفسها المستخدمة في توليد الصور، حيث ينزع النموذج تدريجيًا الضوضاء عن إشارة عشوائية ليحوّلها إلى محتوى بصري متماسك. أما في الفيديو فالتحدي أصعب بشكل أُسّي، إذ يجب أن يحافظ النموذج على الاتساق البصري عبر عشرات أو مئات الإطارات في الوقت نفسه.
تُسمّى هذه الخاصية الاتساق الزمني، وهي أصعب مشكلة منفردة في الذكاء الاصطناعي للفيديو. إذا بدا وجه شخص في الإطار الأول مختلفًا قليلًا عنه في الإطار 47، يبدو الناتج مهتزًا بدلًا من أن يبدو لقطة حقيقية. أفضل النماذج تعالج هذا بتوجيه كل إطار مُولَّد استنادًا إلى الصورة الأصلية، فتعاملها كمرجع بصري دائم طوال عملية التوليد.
التدفق البصري وتنبؤ الإطارات
استخدمت أنظمة تحريك الصور الأقدم التدفق البصري لتشويه البكسلات من إطار إلى آخر، فتحاكي الحركة بإزاحة البكسلات وفق متجهات سرعة مقدّرة. يعمل هذا النهج بشكل معقول على الحركات البسيطة والمنظمة مثل المياه أو السحب، لكنه ينهار بشدة مع الموضوعات المعقدة مثل الوجوه البشرية أو حركات الجسم المفصلية، فينتج تمويهًا وتمزقًا بصريًا.
لا تشوّه النماذج الحديثة القائمة على الانتشار البكسلات. بل تعيد توليد كل إطار من الصفر باستخدام الصورة الأصلية إشارةً للتوجيه، مسترشدةً بفهم متعلَّم لكيفية تصرف الفيزياء والحركة في العالم الحقيقي. والنتيجة أكثر واقعية بكثير، وإن كانت تتطلب حوسبة أكبر بكثير لكل توليد.
كيف "يتخيّل" النموذج الحركة
وهنا تصبح الأمور مثيرة. حين تعطي نموذجًا صورة شخصية وتطلب منه تحريك الشخص، لا يملك الذكاء الاصطناعي أي معلومات عن الحركة التي حدثت فعلًا عند التقاط تلك الصورة. عليه أن يختلق حركة معقولة استنادًا كليًا إلى الأنماط التي تعلّمها من ملايين الفيديوهات الحقيقية أثناء التدريب.
هذا يعني أن النموذج استوعب أشياء مثل: كيف يتحرك الشعر في الريح بشدات مختلفة، وكيف يتصرف القماش حين يدير الشخص رأسه، وكيف تخلق حركات عضلات الوجه الدقيقة إيحاء بالتنفس أو الرمش. كلما كان النموذج أفضل، أصبحت هذه الحركة المُولَّدة أكثر إقناعًا من الناحية الفيزيائية، حتى يصعب على المشاهد تمييزها عن اللقطات الحقيقية عند المسافات العادية للمشاهدة.
💡 نصيحة: إضافة تلميح عن اتجاه الحركة إلى أمرك النصي، مثل "نسيم خفيف من اليسار" أو "دوران بطيء للكاميرا نحو الأمام"، يحسّن بشكل كبير قصدية الحركة المُولَّدة ويقلل من التشوهات العشوائية.
أنواع نماذج تحويل الصورة إلى فيديو
ليست كل نماذج تحويل الصورة إلى فيديو متساوية. فهي تختلف بشكل كبير في الدقة وطول المقطع وجودة الحركة والتعامل مع الموضوعات. واختيار النموذج المناسب لحالتك تحديدًا لا يقل أهمية عن جودة صورتك المصدر.
المقاطع القصيرة مقابل المخرجات الطويلة
تعمل معظم حالات الاستخدام التجاري بشكل جيد تمامًا مع مقاطع من 4 إلى 6 ثوانٍ. تزدهر منصات التواصل الاجتماعي بالمحتوى المتحرك القصير، لذا فإن فيديو بالذكاء الاصطناعي مدته 5 ثوانٍ من صورة فوتوغرافية قابل للاستخدام بدرجة عالية بالفعل لمقاطع Instagram Reels أو TikTok أو منشورات LinkedIn.
نتائج واقعية مقابل نتائج مُنمّطة
صُممت بعض النماذج خصيصًا للحفاظ على مخرجات واقعية كالصور الفوتوغرافية تتطابق بدقة مع الصورة الفوتوغرافية المدخلة. وتُدخل نماذج أخرى حركة مُنمّطة أو معالجة لونية سينمائية قد تختلف بشكل ملحوظ عن المظهر الأصلي للصورة المصدر.
إذا كنت تحرّك صورة شخصية وتحتاج إلى نتيجة لا يمكن تمييزها عن اللقطات الحقيقية، فإن نماذج مثل Wan 2.6 I2V وKling v2.6 Motion Control خيارات قوية. أما إذا أردت مخرجات أكثر إبداعًا أو سينمائية، مع حركة تضفي أجواءً وتحولات إضاءة درامية، فإن Kling v3 Video يقدّم باستمرار نتائج درامية عالية تبدو أقرب إلى مقطع من فيلم منها إلى فيلم وثائقي.
ما الذي يؤثر في جودة المخرجات
النموذج الذي تختاره ليس إلا عاملًا واحدًا. فطريقة إعداد صورتك المدخلة وأمرك النصي للحركة مهمة بالقدر نفسه، وفي بعض الحالات أكثر.
دقة الصورة المدخلة وتكوينها
الصور المدخلة ذات الدقة الأعلى تنتج نتائج أفضل. تعمل معظم النماذج بأفضل شكل مع مدخلات بدقة 720p على الأقل. الصور منخفضة الدقة أو المضغوطة بشدة تجعل النموذج يختلق تفاصيل مفقودة، ما يؤدي إلى تشوهات في تسلسلات الحركة أو تشوه الوجه عبر الإطارات.
التكوين مهم أيضًا. الصور التي تتضمن موضوعًا واضحًا في البؤرة وخلفيات نظيفة وإضاءة جيدة تتحرك بإقناع أكبر من الصور الفوتوغرافية المزدحمة سيئة الإضاءة. فالبورتريه المصوَّر جيدًا التعريض بعدسة ممتازة سيتحرك بشكل أفضل بكثير من لقطة هاتف ضبابية بإضاءة خلفية.
- استخدم صورًا بحجم 1280x720 بكسل على الأقل
- تأكد من أن الشخص الرئيسي ظاهر بوضوح ولا يُقتطع عند الحواف
- تجنّب ضبابية الحركة في الصورة المصدر نفسها
- يساعد التباين الإضائي القوي في الصورة الأصلية النموذج على قراءة العمق وتفاصيل السطح
كيف تكتب الأوامر النصية للفيديو
حين تقدّم أمرًا نصيًا للحركة مع صورتك، فأنت تعطي النموذج تعليمات اتجاهية لما يجب أن يحدث في المشهد. فكّر فيه على أنه وصف لما يحدث لا لشكل المشهد.
الأوامر التي تعمل جيدًا تركّز على:
- اتجاه الحركة: "تتحرك الكاميرا ببطء نحو اليمين"، "يدير الشخص رأسه قليلًا نحو اليسار"
- ديناميكيات المحيط: "نسيم خفيف يحرّك الشعر والقماش"، "أمواج لطيفة في الخلفية"
- تفاصيل الأجواء: "يتحول ضوء الصباح الناعم تدريجيًا إلى دفء أكبر"، "يتصاعد البخار من فنجان القهوة"
- حركة الكاميرا: "تكبير بطيء بالدوللي"، "اهتزاز خفيف كأنها محمولة باليد"
ما يميل إلى إعطاء نتائج ضعيفة:
- وصف المشهد البصري الثابت بدلًا من الحركة
- تعليمات معقدة أكثر من اللازم تتضمن موضوعات متعددة متعارضة
- طلب حركة كاميرا سريعة أو قصوى، وهي حركة تتعامل معها معظم النماذج بشكل سيئ
- أوصاف طويلة جدًا وغامضة بلا فعل أساسي واضح
💡 نصيحة: أبقِ الأوامر النصية للحركة أقل من 30 كلمة، وركّز على فعل أساسي واحد. تستجيب النماذج لتعليمة واحدة محددة وواضحة أفضل مما تستجيب لخمس تعليمات عامة.
إعدادات المدة ومعدل الإطارات
تقدم معظم النماذج إعدادات لطول المقطع بالثواني، وأحيانًا معدل الإطارات (24 أو 30 إطارًا في الثانية شائعان). المقاطع الأقصر، من 3 إلى 5 ثوانٍ، تميل إلى امتلاك اتساق زمني أقوى لأن النموذج يحافظ على الترابط عبر إطارات أقل. أما المقاطع الأطول، من 8 إلى 10 ثوانٍ، فهي أكثر إبهارًا من حيث النطاق، لكنها تحمل احتمالًا أعلى بأن يبتعد مظهر الشخص عن الصورة المصدر في منتصف المقطع.
عند البداية، تُعد 4 ثوانٍ النقطة المثالية: طويلة بما يكفي لتبدو حركة حقيقية، وقصيرة بما يكفي لتبقى واضحة طوال المقطع.
الاستخدامات في العالم الحقيقي
منصات التواصل وإنشاء المحتوى
أبرز حالة استخدام مباشرة هي تحويل التصوير الفوتوغرافي الثابت إلى محتوى متحرك لمنصات التواصل. يمكن لبورتريه واحد من جلسة تصوير لعلامة تجارية أن يصبح مقطعًا متكررًا لقصص Instagram، أو منشورًا ديناميكيًا على LinkedIn، أو صورة رأس جذابة لحملة رقمية.
يستخدم المصورون وصنّاع المحتوى أدوات مثل P Video لمضاعفة قيمة كل جلسة تصوير دون تكاليف إنتاج إضافية. يمكن لجلسة تصوير واحدة الآن أن تنتج أصولًا ثابتة ومحتوى متحركًا في الوقت نفسه، دون طاقم فيديو أو معدات إضافية.
تصور المنتجات والتجارة الإلكترونية
تصوير المنتجات تطبيق عالي القيمة. فتحريك صورة منتج لإظهاره وهو يدور، أو يلتقط الضوء من زوايا مختلفة، أو يُستخدم بطريقة طبيعية، يخلق تجربة شراء أكثر جاذبية من أي صورة ثابتة بمفردها. تستخدم العلامات التجارية في التجارة الإلكترونية Grok Imagine R2V وأدوات مشابهة لإنتاج عروض منتجات متحركة مباشرة من كتالوجات التصوير الحالية، دون جدولة تصوير فيديو جديد أو التعاقد مع فرق إنتاج.
تحريك البورتريهات والصور الفوتوغرافية
إحياء الصور الفوتوغرافية القديمة أو العاطفية من أكثر استخدامات هذه التقنية تأثيرًا عاطفيًا. نماذج مثل Pia وI2VGen XL مصممة خصيصًا لتحريك البورتريهات، وتنتج حركة خفيفة وطبيعية تحترم الصورة الفوتوغرافية الأصلية بدلًا من تغيير طابعها البصري بشكل جذري.
يستخدم مصورو البورتريه الذكاء الاصطناعي لتحويل الصورة إلى فيديو لتقديم منتجات بورتريه متحركة كخدمة إضافية لعملائهم، ما يفتح مصدر دخل جديدًا دون أي استثمار إضافي في المعدات أو أعباء إنتاج.
أفضل نماذج تحويل الصورة إلى فيديو على PicassoIA
تستضيف PicassoIA عشرات نماذج تحويل الصورة إلى فيديو عبر منصتها. فيما يلي عرض لأكثرها صلةً مرتبًا حسب حالة الاستخدام.
سلسلة Wan
عائلة Wan من Wan-Video من أقوى سلاسل نماذج تحويل الصورة إلى فيديو مفتوحة الأوزان المتاحة. Wan 2.7 I2V هو النموذج الرائد الحالي، ويقدم اتساقًا زمنيًا قويًا وتعاملًا ممتازًا مع الشخصيات البشرية بدقة تصل إلى 1080p. وللتكرار الأسرع بجودة أقل قليلًا، يضحّي Wan 2.5 I2V Fast ببعض الدقة مقابل تقليل كبير في زمن التوليد. وإذا أردت تحريك الصور بتكلفة حوسبة أقل، يظل Wan 2.2 I2V Fast خيارًا موثوقًا لتحريك البورتريهات والمناظر الطبيعية البسيطة. وتتعامل سلسلة Wan كلها بشكل خاص جيد مع الطبيعة المحيطة والأقمشة والشعر.
Kling والنماذج السينمائية
أصبح Kling من KwaiVGI معيارًا لجودة الفيديو السينمائي. يُنتج Kling v3 Video بعضًا من أكثر المخرجات صقلًا بصريًا المتاحة حاليًا، مع معالجة لونية غنية وحركة كاميرا طبيعية مدمجة في أسلوب توليده. وللمشاهد التي تتطلب تحكمًا دقيقًا في الحركة، يتيح Kling v2.6 Motion Control توجيه مسار الكاميرا وحركة الشخص بدقة أكبر مما يسمح به التحكم القائم على الأوامر النصية القياسي.
يستحق Gen4 Turbo من Runway الاستخدام تحديدًا لسرعته. فحين تحتاج إلى التكرار السريع بين عدة نسخ من صورة متحركة، يُنتج Gen4 Turbo نتائج قابلة للاستخدام في جزء صغير من الوقت الذي تحتاجه النماذج الأثقل. يضحي بجزء من تعقيد الحركة مقابل تلك السرعة، لكنه أداة سير عمل ممتازة لمحتوى التواصل الذي تكون فيه سرعة التسليم أهم من الجودة المطلقة.
نماذج متخصصة للبورتريهات والصوت
تنتج بعض النماذج أكثر من مجرد صورة متحركة. يولّد Ovi I2V من Character AI مقاطع فيديو مع صوت متزامن من صورة فوتوغرافية واحدة. وهذا قوي بشكل خاص في تحريك البورتريهات حين ترغب في أن يبدو الشخص وكأنه يتكلم أو يتفاعل أو يعبّر عن مشاعر بصوت مقنع.
يقدم Hailuo 2.3 Fast من MiniMax تسليمًا سريعًا لتحريك الصور الفوتوغرافية مع دقة وجه جيدة، مما يجعله خيارًا موثوقًا لمحتوى التواصل حيث تهم السرعة. أما Video 01 Live من المطور نفسه فهو الخيار الأبطأ والأعلى جودة في خط إنتاجه، وهو أنسب للمخرجات النهائية للإنتاج منه للنماذج الأولية السريعة.
كيف تنشئ أول فيديو بالذكاء الاصطناعي على PicassoIA
بما أن PicassoIA تدعم عددًا كبيرًا من نماذج تحويل الصورة إلى فيديو، إليك سير عمل عملي خطوة بخطوة لإنتاج أول مقطع متحرك لك.
الخطوة 1: اختر صورتك الأولية
الصورة المصدر هي أساس كل ما يليها. اختر صورة فوتوغرافية تتميز بـ:
- موضوع واضح وجيد الإضاءة دون ضبابية حركة
- دقة لا تقل عن 1280x720 بكسل
- تكوين لا يقتطع الشخص بإحكام عند حواف الإطار
- خلفية نظيفة أو بسيطة إلى حد معقول إذا أردت نتائج مستقرة وخالية من التشوهات
إذا لم تكن تملك صورة فوتوغرافية مناسبة، يمكنك توليد واحدة باستخدام أي من نماذج PicassoIA لتحويل النص إلى صورة، ثم تمرير المخرج مباشرة إلى نموذج لتحويل الصورة إلى فيديو. يمنحك هذا المسار المكوّن من خطوتين تحكمًا إبداعيًا كاملًا من البداية إلى النهاية.
الخطوة 2: اختر نموذجًا
لمعظم المحاولات الأولى، يُعد Wan 2.7 I2V نقطة البداية الأفضل. يتعامل مع مجموعة واسعة من أنواع الموضوعات بموثوقية، ويُنتج نتائج قوية بثبات. وإذا كنت تريد جودة سينمائية وتقبل بالانتظار قليلًا أطول للتوليد، فإن Kling v3 Video هو الخيار المتميز للمخرجات عالية الأهمية.
الخطوة 3: اكتب أمرك النصي للحركة
أمر نصي جيد للحركة في البورتريه: "يتنفس الشخص ببطء، ويتحرك الشعر في نسيم لطيف من اليسار، وتتغير الإضاءة الدافئة الناعمة قليلًا، وتكون الحركة طبيعية وخفيفة طوال المقطع."
وللمنظر الطبيعي: "تنجرف السحب ببطء من اليمين إلى اليسار، ويتموج سطح المياه بلطف، وتتمايل الأعشاب الطويلة في ريح خفيفة، والكاميرا ثابتة."
ركّز على عنصر أو عنصرين للحركة. التعليمات المتنافسة، مثل طلب كاميرا متحركة ومؤثرات رياح وحركة شخص في الوقت نفسه، غالبًا ما تنتج مخرجات مشوشة وكثيرة التشوهات في النماذج الأقصر أو الأخف.
الخطوة 4: حدد المدة وولّد
ابدأ بمدة من 4 إلى 5 ثوانٍ لمحاولتك الأولى. بعد التوليد، راجع المخرج وانتبه إلى:
- هل يظل وجه الشخص وشكله ثابتين عبر جميع الإطارات؟
- هل تبدو الحركة طبيعية من الناحية الفيزيائية أم آلية ومتشنجة؟
- هل توجد تشوهات بصرية في المناطق عالية التفاصيل مثل الشعر وأنماط الملابس أو الخلفيات المعقدة؟
إذا لم تكن النتائج مرضية، جرّب قيمة بذرة عشوائية مختلفة قبل التحول إلى نموذج آخر بالكامل. فالتركيبة نفسها من النموذج والأمر النصي قد تُنتج نتائج مختلفة بشكل ملموس بقيمة بذرة عشوائية أخرى، والتكرار داخل النموذج الواحد أسرع من التبديل بينها.
💡 نصيحة: بعد توليد الفيديو، مرّره عبر Crystal Video Upscaler أو Video Upscale by Topaz Labs لرفع الدقة إلى 4K للحصول على مخرجات بجودة الإنتاج.
المشكلات الشائعة وكيفية إصلاحها
تشوهات الحركة
الوميض في الأنسجة أو تموج الأسطح أو تشوه أجزاء من الصورة هي أكثر التشوهات شيوعًا في مخرجات تحويل الصورة إلى فيديو. تحدث عادةً في المناطق عالية التردد البصري: الشعر وأنماط الملابس والنباتات أو الخلفيات المعمارية التفصيلية.
الإصلاح: استخدم أمرًا نصيًا للحركة يحدد حركة دنيا في تلك المناطق. إضافة "خلفية ثابتة، دون حركة للكاميرا" تقلل كثيرًا من تشوهات الخلفية. كما يساعد تقليص مدة المقطع إلى 3 إلى 4 ثوانٍ، لأن المقاطع الأقصر تمنح النموذج عددًا أقل من الإطارات تتراكم عبرها الانحرافات.
تشوه الوجه
الوجوه هي أصعب موضوع بالنسبة لأي نموذج ذكاء اصطناعي للفيديو. يشيع التشوه الدقيق للوجه عبر الإطارات حين يحاول النموذج الحفاظ على شبه شخص معين عبر 60 إطارًا مُولَّدًا أو أكثر.
الإصلاح: استخدم نماذج مُحسَّنة لتحريك البورتريهات: Wan 2.7 I2V، وKling v2.6 Motion Control، وHailuo 2.3 Fast تمتلك جميعها سجلًا قويًا في اتساق الوجه. كما اطلب حركة خفيفة للوجه فقط: التنفس وحركة خفيفة جدًا للرأس والرمش الطبيعي. فكلما كانت حركة الوجه أكثر دراماتيكية، صار الحفاظ على الدقة أصعب.
خلفيات غير متسقة
إذا كانت صورتك المصدر تحتوي على خلفية معقدة أو مفصلة، فقد يواجه النموذج صعوبة في الحفاظ على استقرارها بصريًا أثناء تحريك الشخص في المقدمة. قد تبدو الخلفية وكأنها "تتنفس" أو تتحول بين الإطارات حتى حين لا تُطلب أي حركة.
الإصلاح: استخدم صورًا مصدرًا ذات خلفيات نظيفة وبسيطة كلما أمكن. إذا كانت صورتك تحتوي على خلفية مزدحمة، فأضف "خلفية ثابتة" إلى أمرك النصي للحركة، وقلّل مدة المقطع المطلوبة إلى 3 أو 4 ثوانٍ. وبالنسبة للموضوعات التي تتطلب خلفيات معقدة، فإن Kling v3 Video وWan 2.7 I2V يتعاملان مع التعقيد المكاني بشكل أفضل من النماذج الأخف أو الأقدم.
ابدأ إنشاء فيديوهات بالذكاء الاصطناعي الآن
انتقل الذكاء الاصطناعي لتحويل الصورة إلى فيديو من كونه فضولًا بحثيًا إلى أداة جاهزة للإنتاج يمكن لأي شخص استخدامها اليوم. صارت المسافة بين الصورة الفوتوغرافية الثابتة ومقطع الفيديو المتحرك الديناميكي بضع نقرات وأمر نصي قصير للحركة.
تغطي النماذج على PicassoIA كل حالة استخدام، من المحتوى السريع للتواصل الاجتماعي إلى المخرجات السينمائية عالية الجودة. سواء كنت مصورًا تريد تقديم بورتريهات متحركة، أو علامة تجارية تحتاج إلى مرئيات منتجات ديناميكية، أو صانع محتوى يبني محتواه دون فريق إنتاج فيديو، فالتقنية تنتج بالفعل نتائج تبهر حقًا من المشاهدة الأولى.
اختر صورة فوتوغرافية لديك بالفعل. افتح Wan 2.7 I2V أو Kling v3 Video على PicassoIA، واكتب أمرًا نصيًا بسيطًا للحركة يصف ما تريد أن يحدث في المشهد، ثم ولّد أول مقطع متحرك لك. يستغرق سير العمل أقل من دقيقتين بمجرد أن تنفذه مرة واحدة. تتحدث النتائج عن نفسها عادةً فورًا، وبمجرد أن ترى أول صورة فوتوغرافية لك تدب فيها الحياة كمقطع فيديو سلس وواقعي، يصعب جدًا العودة إلى مشاركة الصور الثابتة وحدها.


