Você tira uma foto. Segundos depois, aquela imagem estática está respirando, se movendo, viva como um clipe de vídeo. É isso que a IA de imagem para vídeo faz, e isso está acontecendo agora mesmo nos feeds das redes sociais, em campanhas de marketing, em portfólios de fotografia e em estúdios criativos de IA no mundo todo. A tecnologia por trás disso é genuinamente notável e, depois que você entender como ela funciona, vai querer usá-la imediatamente.
O que a IA de imagem para vídeo realmente faz
A IA de imagem para vídeo recebe uma única imagem fixa como entrada e produz como saída um breve clipe de vídeo animado. O modelo não apenas aplica um zoom ou um efeito de panorâmica básico. Ele sintetiza quadros totalmente novos, quadro a quadro, que representam uma sequência de movimento plausível com base no que havia na fotografia original.
Da foto estática ao clipe em movimento
Quando você envia uma imagem para um modelo como o Wan 2.7 I2V ou o Kling v2.1, a IA não apenas "anima" a foto no sentido tradicional. Ela gera uma sequência de quadros, normalmente de 24 a 60 por segundo, em que cada quadro é uma renderização fotorrealista de como aquela cena poderia ter evoluído ao longo do tempo. A água se agita. O cabelo se move. Os olhos piscam. O tecido balança com a brisa.
O resultado pode ter de 2 a 10 segundos de vídeo, dependendo do modelo e das suas configurações. Alguns modelos mais recentes, como o Kling v3 Video, levam isso para uma qualidade cinematográfica em 1080p, com movimento de câmera de aparência natural e comportamento físico crível do sujeito já embutido por padrão.
A diferença em relação ao texto para vídeo
A IA de texto para vídeo gera um clipe apenas a partir de uma descrição escrita. A IA de imagem para vídeo usa uma fotografia real como ponto de ancoragem da cena. Isso dá a você muito mais controle sobre o sujeito, o ambiente e o estilo visual, porque você está partindo de algo concreto, em vez de depender do modelo para inventar tudo do zero.
A combinação é poderosa: você pode gerar uma imagem com características visuais exatas usando um modelo de texto para imagem e, em seguida, enviá-la para um modelo de imagem para vídeo para animá-la. Esse fluxo de trabalho em duas etapas é um dos pipelines mais usados na criação de conteúdo com IA hoje. Ele oferece tanto a flexibilidade criativa do prompt de texto quanto a especificidade visual de uma imagem de referência real.
A tecnologia por trás disso
Modelos de difusão e consistência temporal
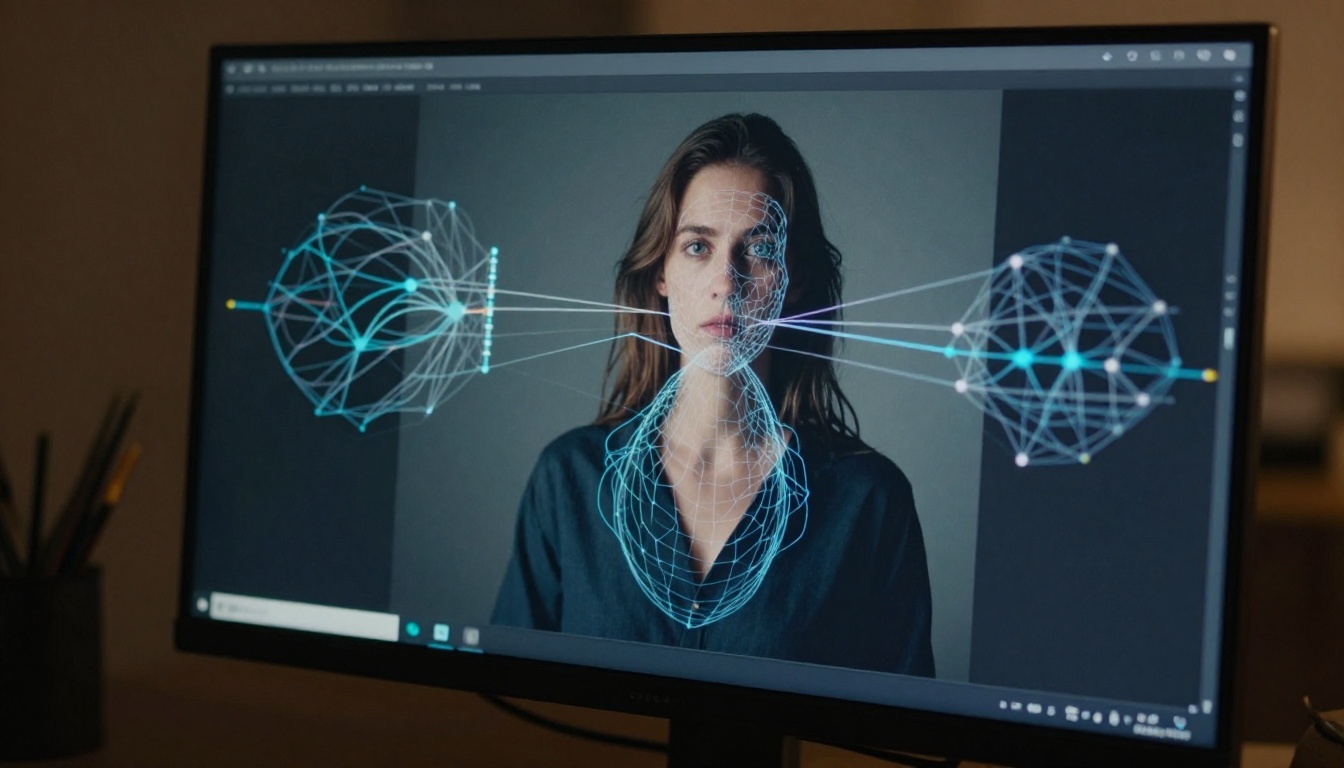
A maioria dos modelos de imagem para vídeo é construída sobre arquiteturas de difusão para vídeo. Elas são extensões do mesmo processo de difusão usado na geração de imagens, em que um modelo remove gradualmente o ruído de um sinal aleatório até transformá-lo em conteúdo visual coerente. No vídeo, o desafio é exponencialmente mais difícil: o modelo precisa manter a consistência visual ao longo de dezenas ou centenas de quadros simultaneamente.
Essa propriedade se chama consistência temporal, e é de longe o problema mais difícil da IA de vídeo. Se o rosto de uma pessoa no quadro 1 parece sutilmente diferente no quadro 47, o resultado parece travado em vez de parecer uma filmagem real. Os melhores modelos lidam com isso condicionando cada quadro gerado à imagem original de entrada, tratando-a como uma referência visual permanente durante todo o processo de geração.
Fluxo óptico e previsão de quadros
Os primeiros sistemas de animação de imagens usavam fluxo óptico para deformar pixels de um quadro para o seguinte, simulando movimento ao deslocar pixels de acordo com vetores de velocidade estimados. Essa abordagem funciona razoavelmente bem para movimentos simples e estruturados, como água ou nuvens, mas falha gravemente em sujeitos complexos, como rostos humanos ou movimentos articulados do corpo, produzindo borrões e rasgos visuais.
Os modelos modernos baseados em difusão não deformam pixels. Eles regeneram cada quadro do zero usando a imagem original como sinal de condicionamento, guiados por uma compreensão aprendida de como a física e o movimento do mundo real se comportam. O resultado é muito mais fotorrealista, embora exija bem mais processamento por geração.
Como o modelo "imagina" o movimento
Aqui é que fica interessante. Quando você entrega a um modelo uma fotografia de retrato e pede que ele anime o sujeito, a IA não tem nenhuma informação sobre qual movimento de fato ocorreu no momento em que aquela foto foi tirada. Ela precisa inventar um movimento plausível com base apenas em padrões aprendidos de milhões de vídeos reais durante o treinamento.
Isso significa que o modelo internalizou coisas como: como o cabelo se move com o vento em diferentes intensidades, como o tecido se comporta quando uma pessoa vira a cabeça, como micromovimentos dos músculos do rosto criam a impressão de respiração ou de piscar. Quanto melhor o modelo, mais convincente fisicamente fica esse movimento sintetizado, a ponto de os espectadores não conseguirem distingui-lo de uma filmagem real a distâncias de visualização casuais.
💡 Dica: Adicionar uma indicação de direção do movimento ao seu prompt, como "brisa suave vindo da esquerda" ou "travelling lento da câmera para frente", melhora bastante a intencionalidade do movimento gerado e reduz artefatos aleatórios.
Tipos de modelos de imagem para vídeo
Nem todos os modelos de imagem para vídeo são iguais. Eles variam bastante em resolução, duração do clipe, qualidade do movimento e tratamento de sujeitos. Escolher o modelo certo para o seu caso de uso é tão importante quanto a qualidade da sua imagem de origem.
Clipes curtos versus saídas de formato longo
A maioria dos casos de uso comerciais funciona perfeitamente bem com clipes de 4 a 6 segundos. As redes sociais prosperam com conteúdo animado de formato curto, então um vídeo de IA de 5 segundos feito a partir de uma fotografia já é altamente utilizável para Reels no Instagram, TikTok ou publicações no LinkedIn.
Resultados realistas versus estilizados
Alguns modelos são treinados especificamente para manter uma saída fotorrealista que corresponda de perto à fotografia de entrada. Outros introduzem movimento estilizado ou uma gradação cinematográfica que pode diferir de forma perceptível da aparência original da imagem de origem.
Se você está animando uma fotografia de retrato e precisa que o resultado seja indistinguível de uma filmagem real, modelos como o Wan 2.6 I2V e o Kling v2.6 Motion Control são boas escolhas. Se você quer uma saída mais criativa ou cinematográfica, com movimento atmosférico e mudanças dramáticas de iluminação, o Kling v3 Video entrega de forma consistente resultados de alto drama que parecem mais um trecho de filme do que um documentário.
O que afeta a qualidade do resultado
O modelo que você escolhe é apenas um fator. A forma como você prepara sua imagem de entrada e seu prompt de movimento importa tanto quanto, e em alguns casos mais.
Resolução e composição da imagem
Imagens de entrada com resolução mais alta produzem melhores resultados. A maioria dos modelos funciona melhor com entradas de pelo menos 720p. Imagens de baixa resolução ou muito comprimidas levam o modelo a alucinar detalhes ausentes, o que gera artefatos nas sequências de movimento ou distorção facial entre os quadros.
A composição também importa. Imagens com um sujeito focal claro, fundos limpos e boa iluminação se animam de forma mais convincente do que fotografias confusas e mal iluminadas. Um retrato bem exposto, feito com uma lente fixa, vai se animar muito melhor do que uma foto de celular borrada e com contraluz.
- Use imagens com pelo menos 1280x720 pixels
- Garanta que o sujeito principal esteja claramente visível e não cortado nas bordas
- Evite desfoque de movimento na própria imagem de origem
- Um bom contraste de iluminação na original ajuda o modelo a ler profundidade e detalhes de superfície
Como escrever prompts para vídeo
Quando você fornece um prompt de movimento junto com sua imagem, está dando ao modelo instruções direcionais sobre o que deve acontecer na cena. Pense nisso como descrever o que acontece, em vez de como a cena se parece.
Prompts que funcionam bem se concentram em:
- Direção do movimento: "a câmera faz uma panorâmica lenta para a direita", "o sujeito vira levemente a cabeça para a esquerda"
- Dinâmica do ambiente: "uma brisa leve balança o cabelo e o tecido", "ondas suaves ao fundo"
- Detalhes atmosféricos: "a luz suave da manhã fica gradualmente mais quente", "vapor sobe da xícara de café"
- Movimento de câmera: "zoom de travelling lento para dentro", "leve balanço de câmera na mão"
O que tende a produzir resultados ruins:
- Descrever a cena visual estática em vez do movimento
- Instruções excessivamente complexas, com vários sujeitos em conflito
- Pedir movimentos de câmera rápidos ou extremos, que a maioria dos modelos lida mal
- Descrições muito longas e vagas, sem uma ação principal clara
💡 Dica: Mantenha os prompts de movimento com menos de 30 palavras e concentre-se em uma única ação principal. Os modelos respondem melhor a uma instrução específica e clara do que a cinco gerais.
Configurações de taxa de quadros e duração
A maioria dos modelos oferece configurações de duração do clipe em segundos e, às vezes, de taxa de quadros (24 fps ou 30 fps são comuns). Clipes mais curtos, de 3 a 5 segundos, tendem a ter consistência temporal mais forte porque o modelo mantém a coerência em menos quadros. Clipes mais longos, de 8 a 10 segundos, são mais impressionantes em escopo, mas têm maior chance de a aparência do sujeito se afastar da imagem de origem no meio do clipe.
Para quem está começando, 4 segundos é o ponto ideal: tempo suficiente para parecer movimento real, curto o bastante para se manter nítido do início ao fim.
Usos no mundo real
Redes sociais e criação de conteúdo
O caso de uso mais imediato é transformar fotografias estáticas em conteúdo animado para plataformas sociais. Um único retrato de uma sessão de fotos de marca pode virar um clipe animado em loop para os Stories do Instagram, uma publicação dinâmica no LinkedIn ou um cabeçalho chamativo para uma campanha digital.
Fotógrafos e criadores de conteúdo estão usando ferramentas como o P Video para multiplicar o valor de cada sessão de imagens sem custos extras de produção. Uma única sessão de fotos agora pode gerar, ao mesmo tempo, materiais estáticos e conteúdo em movimento, sem equipe de vídeo nem equipamento adicional.
Visualização de produtos e e-commerce
A fotografia de produtos é uma aplicação de alto valor. Animar a imagem de um produto para mostrá-lo girando, recebendo luz de diferentes ângulos ou sendo manuseado de forma natural cria uma experiência de compra mais envolvente do que qualquer fotografia estática isolada consegue oferecer. Marcas de e-commerce estão usando o Grok Imagine R2V e ferramentas semelhantes para produzir demonstrações animadas de produtos diretamente a partir de catálogos fotográficos existentes, sem agendar novas gravações de vídeo nem contratar equipes de produção.
Animação de retratos e fotografias
Dar vida a fotografias antigas ou sentimentais está entre os usos mais emocionalmente marcantes dessa tecnologia. Modelos como o Pia e o I2VGen XL são especificamente projetados para a animação de retratos, produzindo movimento sutil e natural que respeita a fotografia original em vez de alterar drasticamente seu caráter visual.
Fotógrafos de retrato estão usando a IA de imagem para vídeo para oferecer produtos de retrato animado como um serviço adicional aos clientes, criando uma nova fonte de receita sem nenhum investimento extra em equipamento ou custos gerais de produção.
Os melhores modelos de imagem para vídeo no PicassoIA
O PicassoIA hospeda dezenas de modelos de imagem para vídeo em sua plataforma. Aqui está um resumo dos mais relevantes, organizados por caso de uso.
A série Wan
A família Wan, da Wan-Video, está entre os conjuntos de modelos de imagem para vídeo de pesos abertos mais capazes disponíveis. O Wan 2.7 I2V é o modelo principal atual, com forte consistência temporal e excelente tratamento de sujeitos humanos em até 1080p. Para uma iteração mais rápida com qualidade um pouco menor, o Wan 2.5 I2V Fast troca parte da fidelidade por um tempo de geração bem menor. Se você quer animar fotos com menor custo de processamento, o Wan 2.2 I2V Fast continua sendo uma escolha confiável para animação direta de retratos e paisagens. A série Wan inteira lida especialmente bem com ambientes naturais, tecidos e cabelos.
Kling e modelos cinematográficos
O Kling, da KwaiVGI, se tornou um benchmark de qualidade cinematográfica em vídeo. O Kling v3 Video produz parte dos resultados visualmente mais refinados disponíveis atualmente, com gradação de cor rica e movimento de câmera natural embutidos em seu estilo de geração. Para cenas que exigem controle preciso de movimento, o Kling v2.6 Motion Control permite dirigir a trajetória da câmera e o movimento do sujeito com mais precisão do que o controle padrão baseado em prompt.
O Gen4 Turbo, da Runway, vale a pena usar especificamente pela velocidade. Quando você precisa iterar rapidamente por várias variações de uma imagem animada, o Gen4 Turbo gera resultados utilizáveis em uma fração do tempo que os modelos mais pesados exigem. Ele sacrifica parte da complexidade do movimento por essa velocidade, mas, para conteúdo social em que a entrega rápida importa mais do que a qualidade absoluta, é uma excelente ferramenta de fluxo de trabalho.
Modelos especializados em retratos e áudio
Alguns modelos produzem mais do que uma imagem animada. O Ovi I2V, da Character AI, gera clipes de vídeo com áudio sincronizado a partir de uma única fotografia. Isso é especialmente poderoso na animação de retratos em que você quer que o sujeito pareça falar, reagir ou expressar emoção com um som convincente.
O Hailuo 2.3 Fast, da MiniMax, oferece entrega rápida na animação de fotos, com boa fidelidade facial, o que o torna uma escolha confiável para conteúdo social em que a velocidade importa. O Video 01 Live, do mesmo desenvolvedor, é a opção mais lenta e de maior qualidade do catálogo deles, mais indicada para a produção final do que para prototipagem rápida.
Como o PicassoIA tem amplo suporte a modelos de imagem para vídeo, aqui está um fluxo de trabalho prático, passo a passo, para produzir seu primeiro clipe animado.
Passo 1: escolha sua imagem inicial
A imagem de origem é a base de tudo o que vem depois. Escolha uma fotografia com:
- Um sujeito claro e bem iluminado, sem desfoque de movimento
- Resolução de pelo menos 1280x720 pixels
- Uma composição que não corte o sujeito de forma apertada nas bordas do quadro
- Um fundo razoavelmente limpo ou simples se você quiser resultados estáveis e sem artefatos
Se você não tem uma fotografia adequada, pode gerar uma com qualquer um dos modelos de texto para imagem do PicassoIA e enviar o resultado diretamente para um modelo de imagem para vídeo. Esse pipeline em duas etapas oferece controle criativo total do início ao fim.
Passo 2: escolha um modelo
Para a maioria das primeiras tentativas, o Wan 2.7 I2V é o melhor ponto de partida. Ele lida com uma grande variedade de tipos de sujeito de forma confiável e entrega resultados sólidos de maneira consistente. Se você quer qualidade cinematográfica e está disposto a esperar um pouco mais pela geração, o Kling v3 Video é a opção premium para resultados em que há muito em jogo.
Passo 3: escreva seu prompt de movimento
Um bom prompt de movimento inicial para um retrato: "O sujeito respira devagar, o cabelo se move com uma brisa suave vinda da esquerda, a luz quente e suave muda levemente, movimento natural e sutil o tempo todo."
Para uma paisagem: "As nuvens se deslocam lentamente da direita para a esquerda, a superfície da água ondula suavemente, a grama alta balança com um vento leve, câmera parada."
Concentre-se em um ou dois elementos de movimento. Instruções concorrentes, como pedir câmera em movimento E efeitos de vento E movimento do sujeito ao mesmo tempo, costumam produzir resultados confusos e cheios de artefatos em modelos mais curtos ou mais leves.
Passo 4: defina a duração e gere
Comece com 4 a 5 segundos na sua primeira tentativa. Depois da geração, revise o resultado e observe:
- O rosto e a forma do sujeito se mantêm consistentes em todos os quadros?
- O movimento parece fisicamente natural ou mecânico e nervoso?
- Há artefatos visuais em áreas de textura densa, como cabelo, padrões de roupa ou fundos complexos?
Se os resultados não forem satisfatórios, teste um valor de seed diferente antes de trocar de modelo por completo. A mesma combinação de modelo e prompt pode produzir resultados bem diferentes com uma seed aleatória distinta, e iterar dentro de um único modelo é mais rápido do que trocar de modelo.
💡 Dica: Depois de gerar seu vídeo, passe-o pelo Crystal Video Upscaler ou pelo Video Upscale by Topaz Labs para elevar a resolução a 4K e obter uma saída com qualidade de produção.
Problemas comuns e como resolvê-los
Artefatos de movimento
Texturas que piscam, superfícies que ondulam ou partes da imagem que parecem se distorcer são os artefatos mais comuns na saída de imagem para vídeo. Eles geralmente ocorrem em áreas de textura de alta frequência: cabelo, padrões de roupa, folhagem ou fundos arquitetônicos detalhados.
Solução: use um prompt de movimento que especifique movimento mínimo nessas áreas. Acrescentar "fundo estático, sem movimento de câmera" costuma reduzir bastante os artefatos de fundo. Diminuir a duração do clipe para 3 a 4 segundos também ajuda, já que clipes mais curtos dão ao modelo menos quadros nos quais acumular desvio.
Distorção facial
Rostos são o sujeito mais difícil para qualquer modelo de IA de vídeo. A distorção facial sutil entre os quadros é comum quando o modelo tenta manter a semelhança de uma pessoa específica ao longo de 60 ou mais quadros sintetizados.
Solução: use modelos otimizados para animação de retratos: o Wan 2.7 I2V, o Kling v2.6 Motion Control e o Hailuo 2.3 Fast têm bons históricos de consistência facial. Além disso, peça apenas movimento facial sutil: respiração, pequenos movimentos da cabeça e piscadas naturais. Quanto mais dramático o movimento do rosto, mais difícil é manter a fidelidade.
Fundos inconsistentes
Se a imagem de origem tiver um fundo complexo ou detalhado, o modelo pode ter dificuldade para manter a estabilidade visual dele enquanto anima o sujeito em primeiro plano. O fundo pode parecer "respirar" ou se deslocar entre os quadros mesmo quando nenhum movimento foi pedido.
Solução: use imagens de origem com fundos limpos e simples sempre que possível. Se a sua imagem de origem tiver um fundo movimentado, inclua "fundo estático" no prompt de movimento e reduza a duração pedida para 3 a 4 segundos. Para sujeitos que exigem fundos complexos, o Kling v3 Video e o Wan 2.7 I2V lidam melhor com a complexidade espacial do que modelos mais leves ou mais antigos.
A IA de imagem para vídeo deixou de ser uma curiosidade de pesquisa e se tornou uma ferramenta pronta para produção que qualquer pessoa pode usar hoje. A distância entre uma fotografia estática e um clipe de vídeo animado e dinâmico agora é de alguns cliques e um prompt de movimento curto.
Os modelos do PicassoIA cobrem todos os casos de uso, do conteúdo social rápido à saída cinematográfica de alta qualidade. Seja você um fotógrafo que quer oferecer retratos animados, uma marca que precisa de visuais de produtos dinâmicos ou um criador que produz conteúdo sem uma equipe de produção de vídeo, a tecnologia já entrega resultados que realmente impressionam logo no primeiro contato.
Escolha uma fotografia que você já tenha. Abra o Wan 2.7 I2V ou o Kling v3 Video no PicassoIA, escreva um prompt de movimento simples descrevendo o que você quer que aconteça na cena e gere seu primeiro clipe animado. O processo leva menos de dois minutos depois da primeira vez. Os resultados costumam falar por si mesmos logo de cara, e quando você vir sua primeira fotografia ganhar vida como um clipe de vídeo fluido e fotorrealista, vai ser muito difícil voltar a compartilhar apenas imagens estáticas.


