आप एक फ़ोटो लेते हैं। कुछ सेकंड बाद वही स्थिर इमेज एक वीडियो क्लिप बनकर साँस लेती, हिलती और जीवंत दिखती है। इमेज-टू-वीडियो AI यही करता है, और यह अभी सोशल मीडिया फ़ीड, मार्केटिंग कैंपेन, फ़ोटोग्राफ़ी पोर्टफ़ोलियो और दुनिया भर के AI क्रिएटिव स्टूडियो में हो रहा है। इसे चलाने वाली तकनीक सचमुच कमाल की है, और एक बार आप देख लें कि यह कैसे काम करती है, तो आप इसे तुरंत इस्तेमाल करना चाहेंगे।
इमेज-टू-वीडियो AI असल में क्या करता है
इमेज-टू-वीडियो AI इनपुट के रूप में एक स्थिर इमेज लेता है और आउटपुट के रूप में एक छोटी एनिमेटेड वीडियो क्लिप बनाता है। मॉडल बस ज़ूम इन नहीं करता या कोई साधारण पैन इफ़ेक्ट नहीं लगाता। यह फ़्रेम-दर-फ़्रेम पूरी तरह नए फ़्रेम संश्लेषित करता है, जो मूल फ़ोटो में मौजूद चीज़ों के आधार पर गति का एक विश्वसनीय क्रम दिखाते हैं।
स्थिर फ़ोटो से चलती क्लिप तक
जब आप Wan 2.7 I2V या Kling v2.1 जैसे मॉडल में कोई इमेज देते हैं, तो AI फ़ोटो को पारंपरिक अर्थ में बस "एनिमेट" नहीं करता। यह फ़्रेम का एक क्रम बनाता है, आमतौर पर प्रति सेकंड 24 से 60 फ़्रेम, और हर फ़्रेम उस दृश्य का फ़ोटोरियलिस्टिक रेंडरिंग होता है कि समय के साथ वह दृश्य कैसे बदल सकता था। पानी में लहरें उठती हैं। बाल हिलते हैं। आँखें झपकती हैं। हवा में कपड़ा लहराता है।
नतीजा मॉडल और आपकी सेटिंग्स के आधार पर 2 से 10 सेकंड के वीडियो तक हो सकता है। Kling v3 Video जैसे कुछ नए मॉडल इसे 1080p रेज़ोल्यूशन पर सिनेमैटिक क्वालिटी की ओर ले जाते हैं, जिसमें डिफ़ॉल्ट रूप से प्राकृतिक दिखने वाली कैमरा मोशन और भौतिक रूप से विश्वसनीय सब्जेक्ट व्यवहार शामिल होता है।
टेक्स्ट-टू-वीडियो से अंतर
टेक्स्ट-टू-वीडियो AI सिर्फ़ लिखे गए विवरण से एक क्लिप बनाता है। इमेज-टू-वीडियो AI दृश्य के लिए एंकर पॉइंट के रूप में एक असली फ़ोटो का इस्तेमाल करता है। इससे आपको सब्जेक्ट, माहौल और विज़ुअल स्टाइल पर कहीं ज़्यादा नियंत्रण मिलता है, क्योंकि आप कुछ ठोस से शुरू कर रहे होते हैं, न कि मॉडल पर सब कुछ शून्य से गढ़ने का भरोसा करते हैं।
यह कॉम्बिनेशन ताक़तवर है: आप टेक्स्ट-टू-इमेज मॉडल से सटीक विज़ुअल गुणों वाली इमेज बना सकते हैं, फिर उसे इमेज-टू-वीडियो मॉडल में डालकर एनिमेट कर सकते हैं। यह दो-चरणों वाला वर्कफ़्लो आज AI कंटेंट क्रिएशन में सबसे व्यापक रूप से इस्तेमाल होने वाली पाइपलाइनों में से एक है। इससे आपको टेक्स्ट प्रॉम्प्टिंग की रचनात्मक लचक और असली रेफ़रेंस इमेज की विज़ुअल सटीकता, दोनों मिलती हैं।
इसके पीछे की तकनीक
डिफ़्यूज़न मॉडल और टेम्पोरल कंसिस्टेंसी
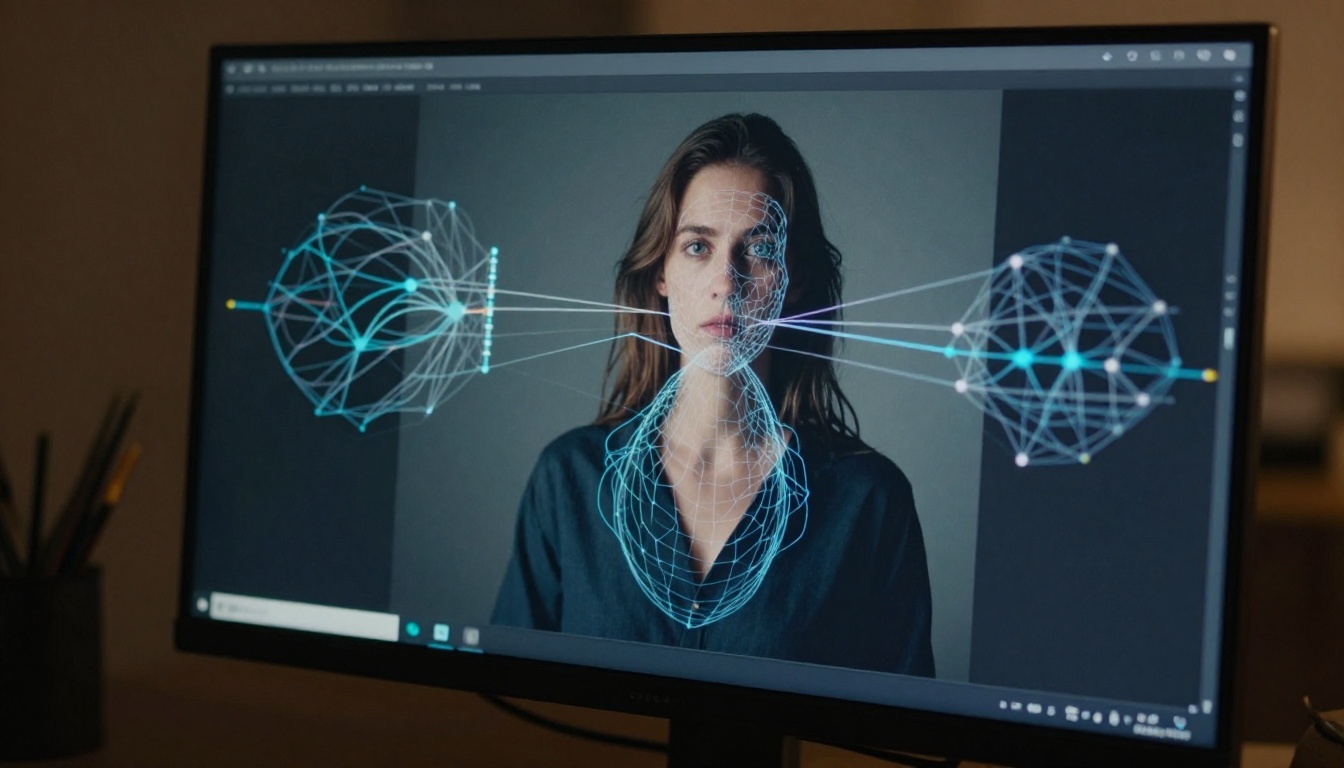
ज़्यादातर इमेज-टू-वीडियो मॉडल वीडियो डिफ़्यूज़न आर्किटेक्चर पर बने होते हैं। ये उसी डिफ़्यूज़न प्रक्रिया के विस्तार हैं जो इमेज जनरेशन में इस्तेमाल होती है, जहाँ मॉडल धीरे-धीरे एक रैंडम सिग्नल को सुसंगत विज़ुअल कंटेंट में बदलता है। वीडियो के लिए चुनौती कहीं ज़्यादा कठिन है: मॉडल को एक साथ दर्जनों या सैकड़ों फ़्रेम में विज़ुअल कंसिस्टेंसी बनाए रखनी होती है।
इस गुण को टेम्पोरल कंसिस्टेंसी कहते हैं, और यह वीडियो AI की सबसे कठिन समस्या है। अगर फ़्रेम 1 में किसी व्यक्ति का चेहरा फ़्रेम 47 में हल्का-सा अलग दिखता है, तो नतीजा असली फ़ुटेज जैसा नहीं, बल्कि गड़बड़ जैसा लगता है। सबसे अच्छे मॉडल हर बनाए गए फ़्रेम को मूल इनपुट इमेज पर कंडीशन करके इसे हल करते हैं, यानी पूरी जनरेशन प्रक्रिया में उसे एक स्थायी विज़ुअल रेफ़रेंस मानते हैं।
ऑप्टिकल फ़्लो और फ़्रेम प्रेडिक्शन
पहले की इमेज एनिमेशन प्रणालियाँ एक फ़्रेम से अगले फ़्रेम तक पिक्सल को वार्प करने के लिए ऑप्टिकल फ़्लो का इस्तेमाल करती थीं। वे अनुमानित वेलोसिटी वेक्टर के अनुसार पिक्सल को विस्थापित करके गति का अनुकरण करती थीं। यह तरीका पानी या बादल जैसी सरल, संरचित गति के लिए काफ़ी ठीक काम करता है, लेकिन इंसानी चेहरों या जोड़ों वाली शरीर की गतियों जैसे जटिल सब्जेक्ट पर बुरी तरह टूट जाता है, जिससे धुंधलापन और विज़ुअल टियरिंग होती है।
आधुनिक डिफ़्यूज़न-आधारित मॉडल पिक्सल को वार्प नहीं करते। वे मूल इमेज को कंडीशनिंग सिग्नल के रूप में इस्तेमाल करके हर फ़्रेम को शुरू से दोबारा जनरेट करते हैं, और असली दुनिया में भौतिकी व गति कैसे बर्ताव करती है, इसकी सीखी हुई समझ से मार्गदर्शन लेते हैं। नतीजा कहीं ज़्यादा फ़ोटोरियलिस्टिक होता है, हालाँकि हर जनरेशन के लिए काफ़ी ज़्यादा कंप्यूट लगता है।
मॉडल गति की "कल्पना" कैसे करता है
यहीं बात दिलचस्प हो जाती है। जब आप मॉडल को एक पोर्ट्रेट फ़ोटो देते हैं और उसके सब्जेक्ट को एनिमेट करने को कहते हैं, तो AI के पास इस बारे में कोई जानकारी नहीं होती कि वह फ़ोटो खींचे जाते समय असल में कौन-सी गति हुई थी। उसे ट्रेनिंग के दौरान लाखों असली वीडियो से सीखे गए पैटर्न के आधार पर विश्वसनीय गति का आविष्कार करना होता है।
इसका मतलब है कि मॉडल ने चीज़ें आत्मसात कर ली होती हैं, जैसे अलग-अलग तीव्रता में हवा में बाल कैसे हिलते हैं, व्यक्ति सिर घुमाता है तो कपड़ा कैसे बर्ताव करता है, और चेहरे की सूक्ष्म मांसपेशियों की गति साँस लेने या पलक झपकने का आभास कैसे देती है। मॉडल जितना बेहतर होगा, यह संश्लेषित गति उतनी ही भौतिक रूप से विश्वसनीय लगेगी, यहाँ तक कि आम दर्शक दूरी से देखने पर इसे असली फ़ुटेज से अलग नहीं पहचान पाएँगे।
💡 टिप: अपने प्रॉम्प्ट में गति की दिशा का संकेत जोड़ना, जैसे "बाईं ओर से हल्की हवा" या "धीमा कैमरा डॉली फ़ॉरवर्ड", जनरेट हुई गति की नीयत को काफ़ी बेहतर बनाता है और रैंडम आर्टिफ़ैक्ट्स घटाता है।
इमेज-टू-वीडियो मॉडल के प्रकार
सभी इमेज-टू-वीडियो मॉडल एक जैसे नहीं होते। वे रेज़ोल्यूशन, क्लिप की लंबाई, मोशन क्वालिटी और सब्जेक्ट हैंडलिंग में काफ़ी अलग होते हैं। अपने खास इस्तेमाल के लिए सही मॉडल चुनना उतना ही ज़रूरी है जितनी आपकी सोर्स इमेज की क्वालिटी।
शॉर्ट-क्लिप बनाम लॉन्ग-फ़ॉर्म आउटपुट
ज़्यादातर कमर्शियल इस्तेमाल के मामले 4 से 6 सेकंड की क्लिप के साथ पूरी तरह ठीक चलते हैं। सोशल मीडिया प्लेटफ़ॉर्म शॉर्ट-फ़ॉर्म एनिमेटेड कंटेंट पर फलते-फूलते हैं, इसलिए एक फ़ोटो से बना 5 सेकंड का AI वीडियो Instagram Reels, TikTok या LinkedIn पोस्ट के लिए पहले से ही बहुत काम का है।
रियलिस्टिक बनाम स्टाइलाइज़्ड नतीजे
कुछ मॉडल खास तौर पर फ़ोटोरियलिस्टिक आउटपुट बनाए रखने के लिए ट्रेन किए गए हैं जो इनपुट फ़ोटो से बारीकी से मेल खाए। दूसरे स्टाइलाइज़्ड मोशन या सिनेमैटिक ग्रेडिंग लाते हैं, जो सोर्स इमेज के मूल रूप से साफ़ तौर पर अलग दिख सकती है।
अगर आप कोई पोर्ट्रेट फ़ोटो एनिमेट कर रहे हैं और नतीजा असली फ़ुटेज से अलग न पहचाना जा सके, ऐसा चाहिए, तो Wan 2.6 I2V और Kling v2.6 Motion Control जैसे मॉडल मज़बूत विकल्प हैं। अगर आप वायुमंडलीय गति और नाटकीय लाइटिंग बदलाव वाला ज़्यादा क्रिएटिव या सिनेमैटिक आउटपुट चाहते हैं, तो Kling v3 Video लगातार हाई-ड्रामा नतीजे देता है, जो डॉक्यूमेंट्री की बजाय फ़िल्म क्लिप जैसे लगते हैं।
आउटपुट की क्वालिटी पर क्या असर डालता है
आपका चुना हुआ मॉडल सिर्फ़ एक कारक है। आप अपनी इनपुट इमेज और मोशन प्रॉम्प्ट कैसे सेट करते हैं, यह भी उतना ही मायने रखता है, और कुछ मामलों में उससे भी ज़्यादा।
इमेज रेज़ोल्यूशन और कंपोज़िशन
ज़्यादा रेज़ोल्यूशन वाली इनपुट इमेज बेहतर नतीजे देती हैं। ज़्यादातर मॉडल कम से कम 720p वाले इनपुट के साथ सबसे अच्छा काम करते हैं। कम रेज़ोल्यूशन या भारी कंप्रेस्ड इमेज मॉडल को गायब डिटेल का हैलुसिनेशन करने पर मजबूर करती हैं, जिससे मोशन सीक्वेंस में आर्टिफ़ैक्ट्स या फ़्रेम-दर-फ़्रेम चेहरे की विकृति आती है।
कंपोज़िशन भी मायने रखती है। साफ़ फ़ोकल सब्जेक्ट, साफ़ बैकग्राउंड और अच्छी लाइटिंग वाली इमेज भीड़भाड़ वाली, खराब रोशनी वाली फ़ोटो की तुलना में कहीं ज़्यादा विश्वसनीय तरीके से एनिमेट होती हैं। अच्छे प्राइम लेंस से ली गई सही एक्सपोज़र वाली पोर्ट्रेट फ़ोटो किसी धुंधली, बैकलिट फ़ोन स्नैपशॉट की तुलना में कहीं बेहतर एनिमेट होगी।
- कम से कम 1280x720 पिक्सल वाली इमेज इस्तेमाल करें
- सुनिश्चित करें कि मुख्य सब्जेक्ट साफ़ दिखे और किनारों पर कटा न हो
- सोर्स इमेज में ही मोशन ब्लर से बचें
- मूल इमेज में मज़बूत लाइट कॉन्ट्रास्ट मॉडल को गहराई और सतह की डिटेल पढ़ने में मदद करता है
वीडियो के लिए प्रॉम्प्ट कैसे लिखें
जब आप अपनी इमेज के साथ मोशन प्रॉम्प्ट देते हैं, तो आप मॉडल को बताते हैं कि दृश्य में क्या होना चाहिए। इसे ऐसे समझें कि आप बताते हैं कि क्या घटित होता है, न कि दृश्य कैसा दिखता है।
अच्छे काम करने वाले प्रॉम्प्ट इन पर ध्यान देते हैं:
- गति की दिशा: "कैमरा धीरे से दाईं ओर पैन करता है", "सब्जेक्ट सिर को हल्का बाईं ओर घुमाता है"
- वातावरण की गतिशीलता: "हल्की हवा बाल और कपड़े को सरसराती है", "पृष्ठभूमि में धीमी लहरें"
- वायुमंडलीय डिटेल: "सुबह की रोशनी धीरे-धीरे और गर्म होती है", "कॉफ़ी के कप से भाप उठती है"
- कैमरा मूवमेंट: "धीमा डॉली ज़ूम इन", "हल्का हैंडहेल्ड झूला"
जो प्रॉम्प्ट आम तौर पर खराब नतीजे देते हैं:
- मोशन की बजाय स्थिर विज़ुअल दृश्य का वर्णन करना
- कई टकराते सब्जेक्ट वाले बहुत जटिल निर्देश
- तेज़ या अत्यधिक कैमरा मूवमेंट माँगना, जिसे ज़्यादातर मॉडल ठीक से नहीं संभाल पाते
- साफ़ मुख्य क्रिया के बिना बहुत लंबे, अस्पष्ट विवरण
💡 Tip: मोशन प्रॉम्प्ट को 30 शब्दों से कम रखें और एक ही मुख्य क्रिया पर ध्यान दें। मॉडल पाँच सामान्य निर्देशों की बजाय एक खास, साफ़ निर्देश पर बेहतर प्रतिक्रिया देते हैं।
फ़्रेम रेट और अवधि की सेटिंग्स
ज़्यादातर मॉडल क्लिप की लंबाई सेकंड में सेट करने का विकल्प देते हैं, और कभी-कभी फ़्रेम रेट भी (24fps या 30fps आम हैं)। छोटी क्लिप, 3 से 5 सेकंड की, में टेम्पोरल कंसिस्टेंसी आम तौर पर मज़बूत होती है, क्योंकि मॉडल कम फ़्रेम में तालमेल बनाए रखता है। लंबी क्लिप, 8 से 10 सेकंड की, दायरे में ज़्यादा प्रभावशाली होती हैं, लेकिन क्लिप के बीच में सब्जेक्ट की शक्ल सोर्स इमेज से दूर खिसकने का खतरा ज़्यादा होता है।
शुरुआत में 4 सेकंड सबसे सही रहते हैं: इतने लंबे कि असली गति जैसे लगें, और इतने छोटे कि पूरे समय साफ़ बने रहें।
असली दुनिया में इस्तेमाल
सोशल मीडिया और कंटेंट क्रिएशन
सबसे तात्कालिक इस्तेमाल स्थिर फ़ोटोग्राफ़ी को सोशल प्लेटफ़ॉर्म के लिए एनिमेटेड कंटेंट में बदलना है। किसी ब्रांड के फ़ोटोशूट की एक पोर्ट्रेट Instagram Stories के लिए लूप होने वाली एनिमेटेड क्लिप, LinkedIn के लिए डायनैमिक पोस्ट, या किसी डिजिटल कैंपेन के लिए ध्यान खींचने वाला हेडर बन सकती है।
फ़ोटोग्राफ़र और कंटेंट क्रिएटर P Video जैसे टूल्स का इस्तेमाल करके बिना अतिरिक्त प्रोडक्शन लागत के हर इमेज सेशन की वैल्यू बढ़ा रहे हैं। अब एक फ़ोटोशूट से एक साथ स्थिर एसेट्स और मोशन कंटेंट, दोनों बन सकते हैं, बिना वीडियो क्रू या अतिरिक्त उपकरणों के।
प्रोडक्ट विज़ुअलाइज़ेशन और ई-कॉमर्स
प्रोडक्ट फ़ोटोग्राफ़ी एक उच्च-मूल्य वाला इस्तेमाल है। किसी प्रोडक्ट इमेज को घूमते हुए, अलग-अलग कोणों से रोशनी पकड़ते हुए, या स्वाभाविक रूप से इंटरैक्ट होते हुए एनिमेट करना ऐसा खरीदारी अनुभव बनाता है जिसे अकेली स्थिर फ़ोटो कभी नहीं दे सकती। ई-कॉमर्स ब्रांड मौजूदा फ़ोटो कैटलॉग से सीधे एनिमेटेड प्रोडक्ट डेमो बनाने के लिए Grok Imagine R2V और इसी तरह के टूल्स का इस्तेमाल कर रहे हैं, बिना नई वीडियो शूट शेड्यूल किए या प्रोडक्शन टीम किराए पर लिए।
पोर्ट्रेट और फ़ोटोग्राफ़ी एनिमेशन
पुरानी या भावनात्मक फ़ोटो को जीवंत करना इस तकनीक के सबसे भावनात्मक रूप से गहरे इस्तेमालों में से एक है। Pia और I2VGen XL जैसे मॉडल खास तौर पर पोर्ट्रेट एनिमेशन के लिए बनाए गए हैं, जो सूक्ष्म और स्वाभाविक गति देते हैं, और मूल फ़ोटो के विज़ुअल चरित्र को नाटकीय रूप से बदलने की बजाय उसका सम्मान करते हैं।
पोर्ट्रेट फ़ोटोग्राफ़र ग्राहकों को अतिरिक्त सेवा के रूप में एनिमेटेड पोर्ट्रेट प्रोडक्ट देने के लिए इमेज-टू-वीडियो AI का इस्तेमाल कर रहे हैं, जिससे बिना किसी अतिरिक्त उपकरण निवेश या प्रोडक्शन खर्च के एक नई आय का स्रोत बन रहा है।
PicassoIA पर शीर्ष इमेज-टू-वीडियो मॉडल
PicassoIA अपने प्लेटफ़ॉर्म पर दर्जनों इमेज-टू-वीडियो मॉडल होस्ट करता है। यहाँ इस्तेमाल के मामले के अनुसार सबसे प्रासंगिक मॉडलों का विवरण है।
Wan सीरीज़
Wan-Video का Wan परिवार उपलब्ध सबसे सक्षम ओपन-वेट्स इमेज-टू-वीडियो मॉडल लाइनअप में से एक है। Wan 2.7 I2V मौजूदा फ़्लैगशिप है, जो 1080p तक मज़बूत टेम्पोरल कंसिस्टेंसी और मानव सब्जेक्ट्स की उत्कृष्ट हैंडलिंग देता है। थोड़ी कम क्वालिटी पर तेज़ इटरेशन के लिए, Wan 2.5 I2V Fast कुछ फ़िडेलिटी छोड़कर जनरेशन समय में काफ़ी कमी लाता है। कम कंप्यूट लागत पर फ़ोटो एनिमेट करना चाहते हैं, तो Wan 2.2 I2V Fast सीधे-सादे पोर्ट्रेट और लैंडस्केप एनिमेशन के लिए भरोसेमंद विकल्प बना हुआ है। पूरी Wan सीरीज़ प्राकृतिक वातावरण, कपड़े और बालों को खास तौर पर अच्छी तरह संभालती है।
Kling और सिनेमैटिक मॉडल
KwaiVGI का Kling सिनेमैटिक वीडियो क्वालिटी का बेंचमार्क बन गया है। Kling v3 Video उपलब्ध सबसे विज़ुअली परिष्कृत आउटपुट में से कुछ देता है, जिसकी जनरेशन स्टाइल में समृद्ध कलर ग्रेडिंग और प्राकृतिक कैमरा मूवमेंट शामिल है। सटीक मोशन कंट्रोल वाले दृश्यों के लिए, Kling v2.6 Motion Control आपको मानक प्रॉम्प्ट-आधारित कंट्रोल से ज़्यादा सटीकता के साथ कैमरा पाथ और सब्जेक्ट मोशन को निर्देशित करने देता है।
Runway का Gen4 Turbo खास तौर पर अपनी गति के लिए इस्तेमाल करने लायक है। जब आपको एनिमेटेड इमेज के कई वेरिएशन तेज़ी से देखने हों, तो Gen4 Turbo भारी मॉडलों को लगने वाले समय के एक हिस्से में उपयोगी नतीजे देता है। यह उस गति के लिए कुछ मोशन जटिलता छोड़ देता है, लेकिन सोशल कंटेंट के लिए, जहाँ तेज़ टर्नअराउंड पूर्ण क्वालिटी से ज़्यादा मायने रखता है, यह एक शानदार वर्कफ़्लो टूल है।
पोर्ट्रेट और ऑडियो के लिए खास मॉडल
कुछ मॉडल सिर्फ़ एनिमेटेड इमेज से ज़्यादा बनाते हैं। Character AI का Ovi I2V एक ही फ़ोटो से सिंक्रनाइज़्ड ऑडियो के साथ वीडियो क्लिप बनाता है। यह पोर्ट्रेट एनिमेशन के लिए खास तौर पर शक्तिशाली है, जहाँ आप चाहते हैं कि सब्जेक्ट विश्वसनीय आवाज़ के साथ बोलता, प्रतिक्रिया देता या भाव व्यक्त करता दिखे।
MiniMax का Hailuo 2.3 Fast मज़बूत चेहरा फ़िडेलिटी के साथ फ़ोटो एनिमेशन के लिए तेज़ टर्नअराउंड देता है, जो उन सोशल कंटेंट के लिए भरोसेमंद विकल्प है जहाँ गति मायने रखती है। उसी डेवलपर का Video 01 Live उनकी लाइनअप का धीमा, उच्च-क्वालिटी विकल्प है, जो तेज़ प्रोटोटाइपिंग की बजाय अंतिम प्रोडक्शन आउटपुट के लिए बेहतर है।
PicassoIA पर अपना पहला AI वीडियो कैसे बनाएँ
चूँकि PicassoIA पर इमेज-टू-वीडियो मॉडल का व्यापक समर्थन है, यहाँ पहली एनिमेटेड क्लिप बनाने के लिए एक व्यावहारिक, चरण-दर-चरण वर्कफ़्लो है।
चरण 1: अपनी शुरुआती इमेज चुनें
सोर्स इमेज ही उसके बाद आने वाली हर चीज़ की नींव है। ऐसी फ़ोटो चुनें जिसमें:
- एक साफ़, अच्छी रोशनी वाला सब्जेक्ट हो, बिना मोशन ब्लर के
- कम से कम 1280x720 पिक्सल का रेज़ोल्यूशन हो
- कंपोज़िशन ऐसी हो कि सब्जेक्ट फ़्रेम के किनारों पर कसकर न कटे
- अगर आप स्थिर, आर्टिफ़ैक्ट-मुक्त नतीजे चाहते हैं तो बैकग्राउंड काफ़ी साफ़ या सरल हो
अगर आपके पास उपयुक्त फ़ोटो नहीं है, तो PicassoIA के किसी भी टेक्स्ट-टू-इमेज मॉडल से एक फ़ोटो बनाएँ और आउटपुट सीधे किसी इमेज-टू-वीडियो मॉडल में डालें। यह दो-चरणों वाली पाइपलाइन शुरू से अंत तक आपको पूरा रचनात्मक नियंत्रण देती है।
चरण 2: एक मॉडल चुनें
ज़्यादातर पहले प्रयासों के लिए, Wan 2.7 I2V सबसे अच्छी शुरुआत है। यह कई तरह के सब्जेक्ट प्रकारों को भरोसेमंद ढंग से संभालता है और लगातार ठोस नतीजे देता है। अगर आपको सिनेमैटिक क्वालिटी चाहिए और जनरेशन के लिए थोड़ा ज़्यादा इंतज़ार कर सकते हैं, तो Kling v3 Video अहम प्रोजेक्ट के लिए प्रीमियम विकल्प है।
चरण 3: अपना मोशन प्रॉम्प्ट लिखें
पोर्ट्रेट के लिए एक अच्छा शुरुआती मोशन प्रॉम्प्ट: "सब्जेक्ट धीरे-धीरे साँस लेता है, बाल बाईं ओर से आती हल्की हवा में हिलते हैं, नरम गर्म रोशनी थोड़ी बदलती है, पूरे समय प्राकृतिक सूक्ष्म गति।"
लैंडस्केप के लिए: "बादल धीरे-धीरे दाईं से बाईं ओर खिसकते हैं, पानी की सतह हल्की लहराती है, ऊँची घास हल्की हवा में झूमती है, कैमरा स्थिर।"
एक से दो मोशन तत्वों पर ध्यान दें। परस्पर विरोधी निर्देश, जैसे एक साथ मूविंग कैमरा, हवा का इफ़ेक्ट और सब्जेक्ट की गति माँगना, छोटे या हल्के मॉडलों पर अक्सर उलझा हुआ, आर्टिफ़ैक्ट-भरा आउटपुट देते हैं।
चरण 4: अवधि सेट करें और जनरेट करें
अपने पहले प्रयास के लिए 4 से 5 सेकंड से शुरू करें। जनरेशन के बाद आउटपुट देखें और इन बातों पर ध्यान दें:
- क्या सब्जेक्ट का चेहरा और शरीर सभी फ़्रेम में लगातार एक जैसा बना रहता है?
- क्या गति भौतिक रूप से स्वाभाविक लगती है या यांत्रिक और झटकेदार?
- क्या बाल, कपड़े के पैटर्न या जटिल बैकग्राउंड जैसे हाई-टेक्सचर हिस्सों में विज़ुअल आर्टिफ़ैक्ट हैं?
अगर नतीजे संतोषजनक नहीं हैं, तो पूरी तरह मॉडल बदलने से पहले अलग सीड वैल्यू आज़माएँ। वही मॉडल और प्रॉम्प्ट कॉम्बिनेशन अलग रैंडम सीड के साथ काफ़ी अलग नतीजे दे सकता है, और एक ही मॉडल के भीतर इटरेशन मॉडल बदलने से तेज़ है।
💡 Tip: अपना वीडियो जनरेट करने के बाद उसे Crystal Video Upscaler या Video Upscale by Topaz Labs से चलाएँ, ताकि प्रोडक्शन-स्तर के आउटपुट के लिए रेज़ोल्यूशन 4K तक ले जाया जा सके।
आम समस्याएँ और उनके समाधान
मोशन आर्टिफ़ैक्ट्स
टिमटिमाते टेक्सचर, लहराती सतहें, या इमेज के हिस्सों का विकृत दिखना इमेज-टू-वीडियो आउटपुट में सबसे आम आर्टिफ़ैक्ट्स हैं। ये आम तौर पर हाई-फ़्रीक्वेंसी टेक्सचर वाले हिस्सों में होते हैं: बाल, कपड़े के पैटर्न, पत्तियाँ, या विस्तृत वास्तुकला वाले बैकग्राउंड।
समाधान: ऐसा मोशन प्रॉम्प्ट इस्तेमाल करें जो उन हिस्सों में न्यूनतम गति निर्दिष्ट करे। "स्थिर बैकग्राउंड, कोई कैमरा मूवमेंट नहीं" जोड़ने से अक्सर बैकग्राउंड आर्टिफ़ैक्ट्स काफ़ी घट जाते हैं। क्लिप की अवधि 3 से 4 सेकंड तक कम करना भी मदद करता है, क्योंकि छोटी क्लिप में मॉडल के पास बहाव जमा होने के लिए कम फ़्रेम होते हैं।
चेहरे की विकृति
किसी भी वीडियो AI मॉडल के लिए चेहरे सबसे कठिन सब्जेक्ट होते हैं। जब मॉडल 60 या उससे ज़्यादा संश्लेषित फ़्रेम में किसी व्यक्ति की शक्ल बनाए रखने की कोशिश करता है, तो फ़्रेम-दर-फ़्रेम सूक्ष्म चेहरे की विकृति आम है।
समाधान: पोर्ट्रेट एनिमेशन के लिए अनुकूलित मॉडल इस्तेमाल करें: Wan 2.7 I2V, Kling v2.6 Motion Control, और Hailuo 2.3 Fast सभी में चेहरे की कंसिस्टेंसी का अच्छा रिकॉर्ड है। साथ ही, केवल सूक्ष्म चेहरे की गति माँगें: साँस लेना, बहुत हल्की सिर की हरकत, और स्वाभाविक पलक झपकना। चेहरे की गति जितनी नाटकीय होगी, फ़िडेलिटी बनाए रखना उतना ही कठिन होगा।
असंगत बैकग्राउंड
अगर आपकी सोर्स इमेज का बैकग्राउंड जटिल या विस्तृत है, तो मॉडल फ़ोरग्राउंड सब्जेक्ट को एनिमेट करते समय उसे विज़ुअली स्थिर रखने में संघर्ष कर सकता है। बैकग्राउंड फ़्रेम के बीच "साँस लेता" या खिसकता दिख सकता है, भले ही कोई गति माँगी न गई हो।
समाधान: जब संभव हो, साफ़, सरल बैकग्राउंड वाली सोर्स इमेज इस्तेमाल करें। अगर आपकी सोर्स इमेज का बैकग्राउंड व्यस्त है, तो अपने मोशन प्रॉम्प्ट में "स्थिर बैकग्राउंड" शामिल करें और माँगी गई क्लिप की लंबाई 3 से 4 सेकंड तक घटाएँ। जिन सब्जेक्ट्स को जटिल बैकग्राउंड चाहिए, उनके लिए Kling v3 Video और Wan 2.7 I2V हल्के या पुराने मॉडलों की तुलना में स्थानिक जटिलता बेहतर संभालते हैं।
अभी से AI वीडियो बनाना शुरू करें
इमेज-टू-वीडियो AI शोध की जिज्ञासा से आगे बढ़कर एक प्रोडक्शन-रेडी टूल बन चुका है, जिसे आज कोई भी इस्तेमाल कर सकता है। स्थिर फ़ोटो और गतिशील, एनिमेटेड वीडियो क्लिप के बीच का फ़ासला अब कुछ क्लिक और एक छोटे मोशन प्रॉम्प्ट जितना रह गया है।
PicassoIA के मॉडल तेज़ सोशल कंटेंट से लेकर उच्च-क्वालिटी सिनेमैटिक आउटपुट तक हर इस्तेमाल को कवर करते हैं। चाहे आप एनिमेटेड पोर्ट्रेट देना चाहने वाले फ़ोटोग्राफ़र हों, डायनैमिक प्रोडक्ट विज़ुअल चाहने वाला ब्रांड हों, या बिना वीडियो प्रोडक्शन टीम के कंटेंट बनाने वाले क्रिएटर हों, यह तकनीक पहली बार देखने पर ही सचमुच प्रभावित करने वाले नतीजे दे रही है।
कोई फ़ोटो चुनें जो आपके पास पहले से है। PicassoIA पर Wan 2.7 I2V या Kling v3 Video खोलें, एक सरल मोशन प्रॉम्प्ट लिखें जो बताए कि दृश्य में क्या होना चाहिए, और अपनी पहली एनिमेटेड क्लिप जनरेट करें। एक बार कर लेने के बाद पूरा वर्कफ़्लो दो मिनट से कम में हो जाता है। नतीजे अक्सर तुरंत अपनी बात कह देते हैं, और एक बार जब आप अपनी पहली फ़ोटो को एक सहज, फ़ोटोरियलिस्टिक वीडियो क्लिप बनकर जीवंत होते देख लेते हैं, तो फिर सिर्फ़ स्थिर इमेज साझा करने पर लौटना बहुत मुश्किल लगता है।


