Vous prenez une photo. Quelques secondes plus tard, cette image fixe respire, bouge, prend vie sous la forme d’un clip vidéo. C’est ce que fait l’image vers vidéo par IA, et cela se produit en ce moment même sur les fils des réseaux sociaux, dans les campagnes marketing, les portfolios de photographes et les studios créatifs d’IA partout dans le monde. La technologie qui rend cela possible est vraiment remarquable, et une fois que vous aurez compris son fonctionnement, vous aurez envie de l’utiliser immédiatement.
Ce que fait réellement l’image vers vidéo par IA
L’image vers vidéo par IA prend une seule image fixe en entrée et produit en sortie un court clip vidéo animé. Le modèle ne se contente pas de zoomer ou d’appliquer un simple panoramique. Il synthétise entièrement de nouvelles images, une par une, qui représentent une séquence de mouvement plausible à partir de ce que contenait la photographie d’origine.
De la photo fixe au clip animé
Lorsque vous importez une image dans un modèle comme Wan 2.7 I2V ou Kling v2.1, l’IA ne se contente pas d’« animer » la photo au sens traditionnel. Elle génère une suite d’images, généralement de 24 à 60 par seconde, où chaque image est un rendu photoréaliste de la façon dont la scène pourrait évoluer dans le temps. L’eau ondule. Les cheveux bougent. Les yeux clignent. Le tissu se déplace sous une brise.
Le résultat peut aller de 2 à 10 secondes de vidéo, selon le modèle et vos réglages. Certains modèles plus récents comme Kling v3 Video visent une qualité cinématographique en 1080p, avec un mouvement de caméra naturel et un comportement physiquement crédible des sujets, intégrés par défaut.
La différence avec le texte vers vidéo
Le texte vers vidéo par IA génère un clip à partir d’une simple description écrite. L’image vers vidéo par IA utilise une vraie photographie comme point d’ancrage de la scène. Vous gardez ainsi un contrôle bien plus fin sur le sujet, l’environnement et le style visuel, puisque vous partez de quelque chose de concret au lieu de laisser le modèle tout inventer à partir de zéro.
La combinaison est puissante : vous pouvez générer une image aux caractéristiques visuelles précises avec un modèle de texte vers image, puis la transmettre à un modèle d’image vers vidéo pour l’animer. Ce flux de travail en deux étapes est l’un des pipelines les plus utilisés dans la création de contenus par IA aujourd’hui. Il vous offre à la fois la souplesse créative du prompt textuel et la précision visuelle d’une image de référence réelle.
La technologie qui se cache derrière
Modèles de diffusion et cohérence temporelle
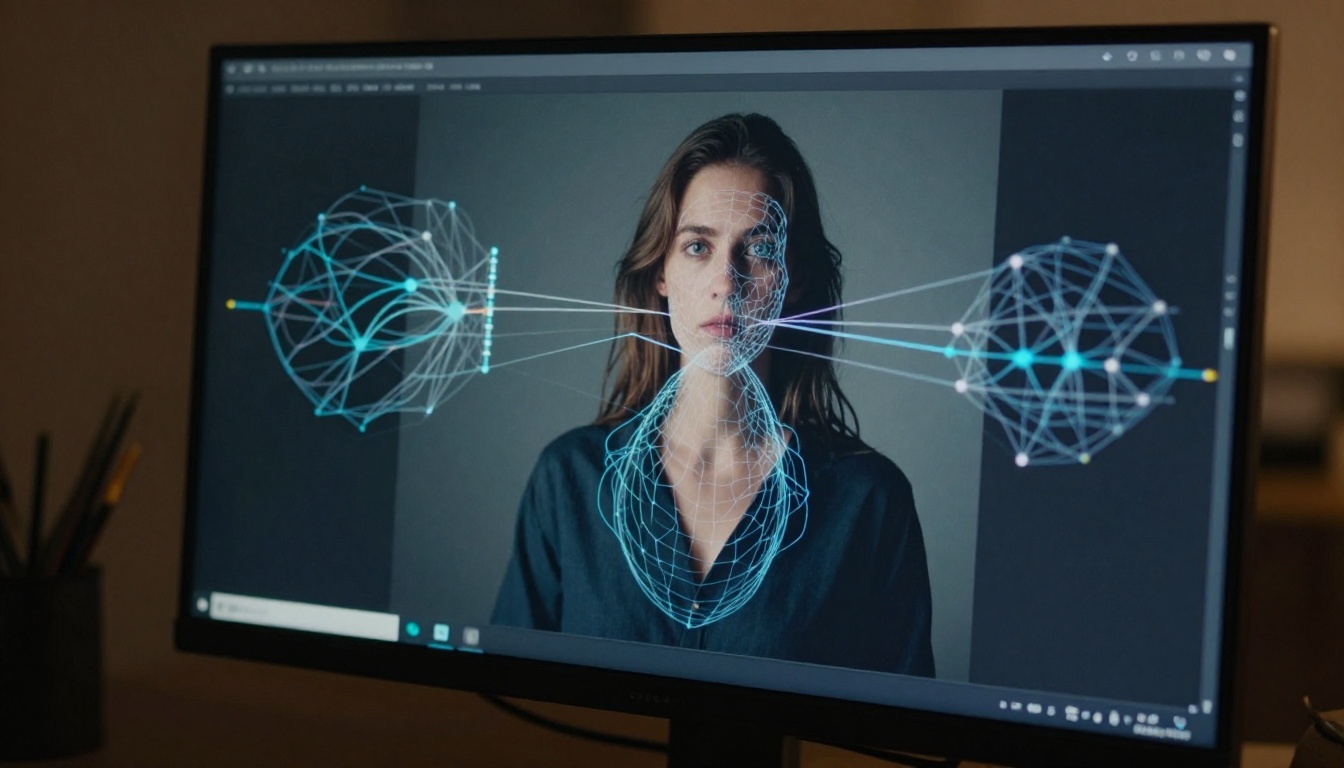
La plupart des modèles d’image vers vidéo reposent sur des architectures de diffusion vidéo. Il s’agit d’extensions du même processus de diffusion que celui utilisé pour la génération d’images, où un modèle débruite progressivement un signal aléatoire pour obtenir un contenu visuel cohérent. Pour la vidéo, le défi est bien plus ardu : le modèle doit maintenir une cohérence visuelle sur des dizaines, voire des centaines d’images simultanément.
Cette propriété s’appelle la cohérence temporelle, et c’est le problème le plus difficile de l’IA vidéo. Si le visage d’une personne paraît légèrement différent sur l’image 1 et sur l’image 47, le résultat a l’air saccadé plutôt que de ressembler à une vraie prise de vue. Les meilleurs modèles traitent ce point en conditionnant chaque image générée sur l’image d’origine, qu’ils considèrent comme une référence visuelle permanente tout au long de la génération.
Flux optique et prédiction d’images
Les premiers systèmes d’animation d’images utilisaient le flux optique pour déformer les pixels d’une image à la suivante, en simulant le mouvement par le déplacement des pixels selon des vecteurs de vitesse estimés. Cette approche fonctionne raisonnablement bien pour des mouvements simples et structurés, comme l’eau ou les nuages, mais elle échoue nettement sur des sujets complexes comme les visages humains ou les mouvements articulés du corps, en produisant des traînées et des déchirures visuelles.
Les modèles récents fondés sur la diffusion ne déforment pas les pixels. Ils régénèrent chaque image à partir de zéro en utilisant l’image d’origine comme signal de conditionnement, guidés par une compréhension apprise de la façon dont la physique et le mouvement du monde réel se comportent. Le résultat est nettement plus photoréaliste, même si chaque génération demande beaucoup plus de calcul.
Comment le modèle « imagine » le mouvement
C’est là que cela devient intéressant. Lorsque vous donnez à un modèle une photo de portrait et lui demandez d’animer le sujet, l’IA ne dispose d’aucune information sur le mouvement qui a réellement eu lieu au moment de la prise de vue. Elle doit inventer un mouvement plausible à partir uniquement des schémas appris sur des millions de vraies vidéos pendant l’entraînement.
Cela signifie que le modèle a intégré des éléments comme la façon dont les cheveux bougent au vent selon son intensité, le comportement d’un tissu lorsqu’une personne tourne la tête, ou la manière dont de subtils mouvements des muscles du visage donnent l’impression de respirer ou de cligner des yeux. Plus le modèle est performant, plus ce mouvement synthétisé est physiquement convaincant, au point que les spectateurs ne peuvent plus le distinguer d’une vraie prise de vue à une distance de visionnage ordinaire.
💡 Astuce : ajouter une indication de direction du mouvement à votre prompt, comme « brise douce venant de la gauche » ou « lent travelling avant », rend nettement plus intentionnel le mouvement généré et réduit les artefacts aléatoires.
Les différents types de modèles d’image vers vidéo
Tous les modèles d’image vers vidéo ne se valent pas. Ils diffèrent fortement par la résolution, la durée des clips, la qualité du mouvement et la manière de traiter les sujets. Choisir le bon modèle pour votre cas d’usage compte autant que la qualité de votre image source.
Clips courts ou formats longs
La plupart des cas d’usage commercial fonctionnent parfaitement avec des clips de 4 à 6 secondes. Les réseaux sociaux se nourrissent de contenus animés courts, si bien qu’une vidéo IA de 5 secondes tirée d’une photographie est déjà très exploitable pour des Reels Instagram, TikTok ou des publications LinkedIn.
Rendus réalistes ou stylisés
Certains modèles sont entraînés spécifiquement pour conserver un rendu photoréaliste proche de la photographie d’origine. D’autres introduisent un mouvement stylisé ou un étalonnage cinématographique qui peut différer nettement de l’aspect initial de l’image source.
Si vous animez une photo de portrait et que le résultat doit être indiscernable d’une vraie prise de vue, des modèles comme Wan 2.6 I2V et Kling v2.6 Motion Control sont de bons choix. Si vous recherchez un rendu plus créatif ou cinématographique, avec des mouvements atmosphériques et des changements de lumière spectaculaires, Kling v3 Video livre régulièrement des résultats très dramatiques qui ressemblent davantage à un extrait de film qu’à un documentaire.
Ce qui influence la qualité du rendu
Le modèle choisi n’est qu’un facteur parmi d’autres. La façon dont vous préparez votre image d’entrée et votre prompt de mouvement compte tout autant, et parfois davantage.
Résolution et composition de l’image
Des images d’entrée à plus haute résolution donnent de meilleurs résultats. La plupart des modèles fonctionnent au mieux avec des entrées d’au moins 720p. Les images à faible résolution ou fortement compressées poussent le modèle à halluciner les détails manquants, ce qui entraîne des artefacts dans les séquences de mouvement ou des déformations du visage d’une image à l’autre.
La composition compte aussi. Les images avec un sujet principal clair, des arrière-plans épurés et un bon éclairage s’animent de façon bien plus convaincante que des photos encombrées et mal éclairées. Un portrait bien exposé, pris avec un objectif à focale fixe, s’animera nettement mieux qu’un cliché de téléphone flou et à contre-jour.
- Utilisez des images d’au moins 1280x720 pixels
- Veillez à ce que le sujet principal soit bien visible et non coupé sur les bords
- Évitez le flou de bougé dans l’image source elle-même
- Un fort contraste de lumière dans l’original aide le modèle à lire la profondeur et les détails de surface
Comment rédiger des prompts pour la vidéo
Lorsque vous fournissez un prompt de mouvement avec votre image, vous donnez au modèle des instructions directionnelles sur ce qui doit se passer dans la scène. Considérez-le comme une description de ce qui se produit, plutôt que de ce à quoi ressemble la scène.
Les prompts efficaces se concentrent sur :
- La direction du mouvement : « la caméra panoramique lentement vers la droite », « le sujet tourne légèrement la tête vers la gauche »
- La dynamique de l’environnement : « une légère brise fait bruisser les cheveux et le tissu », « de douces vagues en arrière-plan »
- Les détails atmosphériques : « la lumière du matin douce se réchauffe progressivement », « de la vapeur monte de la tasse de café »
- Le mouvement de caméra : « lent zoom avant en travelling », « légère oscillation caméra à l’épaule »
Ce qui donne en général de mauvais résultats :
- Décrire la scène visuelle statique au lieu du mouvement
- Des consignes trop complexes avec plusieurs sujets en conflit
- Demander un mouvement de caméra rapide ou extrême, que la plupart des modèles gèrent mal
- De longues descriptions vagues sans action principale claire
💡 Astuce : gardez vos prompts de mouvement sous 30 mots et concentrez-vous sur une seule action principale. Les modèles répondent mieux à une consigne précise et claire qu’à cinq consignes générales.
Réglages de fréquence d’images et de durée
La plupart des modèles proposent des réglages de durée du clip en secondes, et parfois la fréquence d’images (24 ou 30 fps sont courantes). Les clips courts, de 3 à 5 secondes, tendent à offrir une meilleure cohérence temporelle, car le modèle doit maintenir la cohérence sur moins d’images. Les clips plus longs, de 8 à 10 secondes, sont plus impressionnants par leur ampleur, mais risquent davantage que l’apparence du sujet s’écarte de l’image source en cours de clip.
Pour débuter, 4 secondes sont le juste milieu : assez longues pour donner une impression de mouvement réel, assez courtes pour rester nettes du début à la fin.
Usages concrets
Réseaux sociaux et création de contenus
Le cas d’usage le plus immédiat consiste à transformer des photographies fixes en contenus animés pour les plateformes sociales. Un seul portrait issu d’une séance photo de marque peut devenir un clip animé en boucle pour les Stories Instagram, une publication dynamique sur LinkedIn ou un visuel d’en-tête accrocheur pour une campagne numérique.
Photographes et créateurs de contenus utilisent des outils comme P Video pour multiplier la valeur de chaque séance photo sans coûts de production supplémentaires. Une seule séance peut désormais produire à la fois des visuels fixes et des contenus animés, sans équipe vidéo ni matériel supplémentaire.
Visualisation de produits et e-commerce
La photographie produit est une application à forte valeur ajoutée. Animer une image de produit pour le faire pivoter, capter la lumière sous différents angles ou être manipulé de façon naturelle crée une expérience d’achat plus convaincante que n’importe quelle photo fixe. Les marques e-commerce utilisent Grok Imagine R2V et des outils similaires pour produire des démonstrations animées de produits directement à partir de catalogues photo existants, sans planifier de nouveaux tournages vidéo ni faire appel à des équipes de production.
Animation de portraits et de photographies
Redonner vie à de vieilles photographies ou à des clichés chargés d’émotion est l’un des usages les plus touchants de cette technologie. Des modèles comme Pia et I2VGen XL sont spécialement conçus pour l’animation de portraits, avec un mouvement subtil et naturel qui respecte la photo d’origine au lieu de modifier radicalement son caractère visuel.
Les photographes de portrait proposent désormais l’image vers vidéo par IA comme service complémentaire à leurs clients, avec des portraits animés, ce qui crée une nouvelle source de revenus sans investissement matériel supplémentaire ni surcoût de production.
Les meilleurs modèles d’image vers vidéo sur PicassoIA
PicassoIA héberge des dizaines de modèles d’image vers vidéo sur sa plateforme. Voici un aperçu des plus pertinents, classés par cas d’usage.
La série Wan
La famille Wan, développée par Wan-Video, fait partie des gammes de modèles d’image vers vidéo à poids ouverts les plus performantes disponibles. Wan 2.7 I2V est le modèle phare actuel, avec une forte cohérence temporelle et une excellente gestion des sujets humains jusqu’en 1080p. Pour des itérations plus rapides, au prix d’une qualité légèrement inférieure, Wan 2.5 I2V Fast sacrifie un peu de fidélité pour réduire nettement le temps de génération. Si vous souhaitez animer des photos avec un coût de calcul plus faible, Wan 2.2 I2V Fast reste un choix fiable pour une animation simple de portraits et de paysages. L’ensemble de la série Wan gère particulièrement bien les environnements naturels, les tissus et les cheveux.
Kling et les modèles cinématographiques
Kling, développé par KwaiVGI, est devenu un benchmark en matière de qualité vidéo cinématographique. Kling v3 Video produit certains des rendus les plus soignés disponibles aujourd’hui, avec un étalonnage riche en couleurs et un mouvement de caméra naturel intégré à son style de génération. Pour les scènes qui exigent un contrôle précis du mouvement, Kling v2.6 Motion Control vous permet de diriger la trajectoire de la caméra et le mouvement du sujet avec plus de précision que le contrôle standard par prompt.
Gen4 Turbo de Runway vaut la peine d’être utilisé spécifiquement pour sa rapidité. Lorsque vous devez itérer rapidement sur plusieurs variantes d’une image animée, Gen4 Turbo produit des résultats exploitables en une fraction du temps qu’exigent les modèles plus lourds. Il sacrifie une partie de la complexité du mouvement en échange de cette vitesse, mais pour les contenus sociaux où un délai court compte davantage que la qualité absolue, c’est un excellent outil de flux de travail.
Modèles spécialisés pour les portraits et l’audio
Certains modèles font plus qu’animer une image. Ovi I2V de Character AI génère des clips vidéo avec un audio synchronisé à partir d’une seule photographie. C’est particulièrement puissant pour l’animation de portraits lorsque vous voulez que le sujet paraisse parler, réagir ou exprimer une émotion avec un son crédible.
Hailuo 2.3 Fast de MiniMax offre un délai de génération court pour l’animation de photos, avec une bonne fidélité du visage, ce qui en fait un choix fiable pour les contenus sociaux où la vitesse compte. Video 01 Live, du même développeur, est l’option plus lente mais de meilleure qualité de sa gamme, mieux adaptée à une production finale qu’à un prototypage rapide.
Comme PicassoIA prend largement en charge les modèles d’image vers vidéo, voici un flux de travail pratique, étape par étape, pour produire votre premier clip animé.
Étape 1 : choisir votre image de départ
L’image source est le socle de tout ce qui suit. Choisissez une photographie qui présente :
- Un sujet clair et bien éclairé, sans flou de bougé
- Une résolution d’au moins 1280x720 pixels
- Une composition qui ne coupe pas trop le sujet sur les bords du cadre
- Un arrière-plan assez épuré ou simple si vous voulez des résultats stables, sans artefacts
Si vous n’avez pas de photo adaptée, vous pouvez en générer une avec l’un des modèles de texte vers image de PicassoIA, puis transmettre le résultat directement à un modèle d’image vers vidéo. Ce pipeline en deux étapes vous donne un contrôle créatif total du début à la fin.
Étape 2 : choisir un modèle
Pour la plupart des premiers essais, Wan 2.7 I2V est le meilleur point de départ. Il gère fiablement une grande variété de sujets et produit systématiquement des résultats solides. Si vous recherchez une qualité cinématographique et acceptez d’attendre un peu plus longtemps la génération, Kling v3 Video est l’option premium pour des rendus à forts enjeux.
Étape 3 : rédiger votre prompt de mouvement
Un bon prompt de mouvement de départ pour un portrait : « Le sujet respire lentement, les cheveux bougent dans une légère brise venant de la gauche, la lumière chaude et douce change légèrement, mouvement naturel et subtil tout au long du clip. »
Pour un paysage : « Les nuages dérivent lentement de droite à gauche, la surface de l’eau ondule doucement, les hautes herbes ondulent sous un vent léger, caméra fixe. »
Concentrez-vous sur un ou deux éléments de mouvement. Des consignes concurrentes, comme demander simultanément un mouvement de caméra, des effets de vent et un déplacement du sujet, produisent souvent un rendu confus et plein d’artefacts sur les modèles plus courts ou plus légers.
Étape 4 : définir la durée et générer
Commencez par 4 à 5 secondes pour votre première tentative. Une fois la génération terminée, examinez le résultat et prêtez attention à :
- Le visage et la silhouette du sujet sont-ils conservés de façon cohérente sur toutes les images ?
- Le mouvement paraît-il physiquement naturel ou mécanique et saccadé ?
- Y a-t-il des artefacts visuels dans les zones très texturées, comme les cheveux, les motifs des vêtements ou les arrière-plans complexes ?
Si les résultats ne vous satisfont pas, essayez une autre valeur de seed avant de changer complètement de modèle. Une même combinaison de modèle et de prompt peut donner des résultats sensiblement différents avec une autre seed aléatoire, et itérer au sein d’un même modèle est plus rapide que d’en changer.
💡 Astuce : après avoir généré votre vidéo, passez-la dans Crystal Video Upscaler ou Video Upscale by Topaz Labs pour la porter en 4K et obtenir un rendu de qualité production.
Problèmes courants et solutions
Artefacts de mouvement
Les textures qui scintillent, les surfaces qui ondulent ou les parties de l’image qui semblent se déformer sont les artefacts les plus fréquents dans les rendus d’image vers vidéo. Ils apparaissent généralement dans les zones à haute fréquence de texture : cheveux, motifs de vêtements, feuillage ou arrière-plans architecturaux détaillés.
Solution : utilisez un prompt de mouvement qui précise un mouvement minimal dans ces zones. Ajouter « arrière-plan statique, pas de mouvement de caméra » réduit souvent nettement les artefacts d’arrière-plan. Réduire la durée du clip à 3 ou 4 secondes aide aussi, car les clips plus courts laissent au modèle moins d’images sur lesquelles accumuler la dérive.
Déformation du visage
Les visages sont le sujet le plus difficile pour n’importe quel modèle d’IA vidéo. Une déformation subtile du visage d’une image à l’autre est courante lorsque le modèle tente de conserver la ressemblance d’une personne sur 60 images synthétisées ou plus.
Solution : utilisez des modèles optimisés pour l’animation de portraits : Wan 2.7 I2V, Kling v2.6 Motion Control et Hailuo 2.3 Fast ont tous fait leurs preuves en matière de cohérence du visage. Demandez aussi uniquement un mouvement facial subtil : respiration, très légère inclinaison de la tête et clignements naturels. Plus le mouvement du visage est spectaculaire, plus il est difficile de préserver la fidélité.
Arrière-plans instables
Si votre image source comporte un arrière-plan complexe ou très détaillé, le modèle peut peiner à le garder visuellement stable pendant l’animation du sujet au premier plan. L’arrière-plan peut donner l’impression de « respirer » ou de se déplacer d’une image à l’autre, même lorsqu’aucun mouvement n’a été demandé.
Solution : utilisez si possible des images sources aux arrière-plans épurés et simples. Si votre image source a un arrière-plan chargé, ajoutez « arrière-plan statique » à votre prompt de mouvement et réduisez la durée demandée à 3 ou 4 secondes. Pour les sujets qui exigent des arrière-plans complexes, Kling v3 Video et Wan 2.7 I2V gèrent mieux la complexité spatiale que les modèles plus légers ou plus anciens.
Commencez dès maintenant à créer des vidéos IA
L’image vers vidéo par IA est passée du stade de simple curiosité de laboratoire à un outil de production que chacun peut utiliser aujourd’hui. L’écart entre une photographie fixe et un clip vidéo animé et dynamique ne tient plus qu’à quelques clics et à un court prompt de mouvement.
Les modèles de PicassoIA couvrent tous les cas d’usage, du contenu social rapide à la production cinématographique de haute qualité. Que vous soyez photographe et souhaitiez proposer des portraits animés, une marque qui a besoin de visuels produits dynamiques, ou un créateur qui réalise des contenus sans équipe de production vidéo, la technologie produit déjà des résultats qui impressionnent vraiment dès le premier visionnage.
Choisissez une photographie que vous avez déjà. Ouvrez Wan 2.7 I2V ou Kling v3 Video sur PicassoIA, rédigez un prompt de mouvement simple décrivant ce que vous voulez voir se produire dans la scène, puis générez votre premier clip animé. Le flux de travail prend moins de deux minutes une fois que vous l’avez fait une fois. Les résultats parlent généralement d’eux-mêmes dès le premier essai, et une fois que vous avez vu votre première photographie prendre vie sous la forme d’un clip vidéo fluide et photoréaliste, il devient très difficile de revenir au partage d’images fixes seulement.


