Has generado el video. Lo has revisado. Y algo no cuadra. La persona se mueve como si estuviera bajo el agua. El pelo se comporta como un objeto sólido. Las sombras parecen caer de tres soles distintos a la vez. Es una de las experiencias más frustrantes en la creación de contenido con IA, y le pasa casi a todo el mundo al empezar con herramientas de texto a video.
La buena noticia: los motivos por los que un video con IA parece falso son concretos, se repiten y tienen solución. Son cuatro, y en cuanto entiendas qué sale mal en realidad, la calidad de tus resultados mejorará de forma notable. No se trata de cambiar a un modelo mejor ni de gastar más créditos. Se trata de entender lo que estos modelos necesitan de ti.
La mayoría de la gente supone que el problema es el modelo. Cambian a uno mejor, prueban otra herramienta y obtienen casi el mismo resultado. El problema rara vez es el modelo en sí. La IA de texto a video actual es realmente potente. Kling v3 Video, Seedance 1.5 Pro y Wan 2.7 T2V pueden generar grabaciones que, en las condiciones adecuadas, rozan lo indistinguible de una película real. El techo es alto. Pero el suelo, que es donde aterriza la mayoría de los resultados, no tanto.
Los problemas que hacen que el video con IA parezca falso se agrupan en cuatro categorías recurrentes: la física del movimiento, la textura de las superficies, la coherencia de la iluminación y la estabilidad temporal. Cada uno tiene una causa de raíz. Cada uno tiene una solución.
El valle inquietante existe
El valle inquietante es la incomodidad perceptiva que surge cuando algo casi parece humano, pero no termina de cuadrar. El video agrava esto más que las imágenes fijas, porque el movimiento amplifica cada imperfección. Una posición de mano ligeramente incorrecta resulta chocante durante un fotograma. A lo largo de 96 fotogramas de animación, resulta visceralmente incómodo de ver. El cerebro procesa la señal visual de forma continua, y cada desviación del comportamiento humano esperado se registra como incorrecta, aunque el espectador no sepa explicar por qué.
No es el modelo, es el input
Los modelos de video con IA no leen tu intención. Procesan tus palabras. Un prompt vago produce un resultado vago. El modelo rellena la información que falta con promedios estadísticos, y por eso obtienes esa calidad genérica, hueca y artificialmente renderizada. La especificidad es la herramienta más poderosa que tienes, y no cuesta nada.
Motivo 1: Física rota y movimiento antinatural
Este es el problema más común y más evidente. Telas que flotan en lugar de caer. Pelo que se mueve como un bloque rígido. Un personaje corriendo cuyos pies nunca llegan a tocar el suelo del todo. No son fallos aleatorios: son el resultado directo de cómo funcionan los modelos de video basados en difusión.
Los modelos de IA aprenden de patrones en los datos de entrenamiento. Entienden que "una persona camina" implica movimiento de piernas. Pero no simulan la física desde primeros principios. La aproximan de forma estadística. Cuando la aproximación falla, obtienes un movimiento que parece animado por alguien que ha leído sobre cómo se camina, pero nunca lo ha hecho.
Cuando la gravedad se olvida de aparecer
La señal más reveladora de una física falsa es el comportamiento de la tela y el pelo. La tela real tiene peso. Responde al impulso y a la gravedad de forma distinta según su tejido, su densidad y su corte. Un abrigo de lana pesado se balancea con un retardo y un peso considerables. Una blusa de seda responde a casi cualquier micromovimiento. Los modelos de IA, sobre todo con prompts vagos, recurren a un comportamiento de tela promedio que no se corresponde de forma convincente con ningún material real.
El pelo es aún peor. Es una de las cosas más difíciles de renderizar de forma convincente, porque cada hebra tiene una masa casi nula, pero en conjunto crean patrones de movimiento complejos y emergentes. Si pides "una mujer corriendo", casi seguro obtendrás un pelo que se mueve como una sola forma lisa, como una pieza de plástico moldeado pegada al cuero cabelludo.
Pide movimiento, no solo apariencia
💡 No describas cómo se ve la escena. Describe cómo se comporta físicamente. Incluye la masa, el impulso y el retardo que sigue al movimiento del mundo real.
En lugar de: "Una mujer con un vestido rojo caminando por un parque"
Prueba con: "Una mujer con un vestido de seda fluido caminando despacio por un parque, la tela se mece suavemente con cada paso, el impulso natural crea un ligero retardo en el bajo, el peso real se ve en el material mientras se asienta tras cada zancada"
| Prompt de movimiento débil | Prompt de movimiento fuerte |
|---|
| "Un hombre corriendo" | "Un hombre trotando a ritmo moderado, apoyo natural del talón a la punta del pie, brazos que se balancean con una ligera rotación del torso, leve rebote de los hombros con cada pisada" |
| "Su pelo al viento" | "El pelo recibe una brisa suave de costado desde la izquierda, hebras individuales que se separan y se superponen, resistencia natural cuando el viento cambia brevemente de dirección" |
| "La bandera ondeando" | "Una bandera con viento moderado, la tela ondulando desde el punto de sujeción hacia fuera, tensión visible en el mástil, frecuencia natural de oscilación al pasar las ráfagas" |
| "Hojas cayendo de los árboles" | "Hojas que se desprenden de las ramas y caen en espiral con un movimiento irregular de volteo, cada una respondiendo de forma distinta a las corrientes de aire, acumulándose en el suelo con ángulos variados" |
La diferencia en la calidad del resultado que produce este único cambio suele ser la mejora más notable que puede hacer un creador. La descripción física casi siempre está poco especificada en los prompts, y los modelos están diseñados para usarla cuando está presente.
Motivo 2: Problemas de piel, pelo y textura
La textura es donde el video con IA más suele delatarse en los planos cercanos y medios. El problema tiene un nombre concreto en el sector: el efecto figura de cera. Es ese aspecto en el que la piel de una persona parece lisa, ligeramente reflectante y uniformemente iluminada, como un maniquí de alta calidad y no como un ser humano. La geometría facial puede ser excelente. Las proporciones pueden ser perfectas. Pero la superficie se lee como fabricada.
La piel real es extraordinariamente compleja. Tiene poros, vello fino, microsombras, dispersión subsuperficial de la luz, variaciones de grasa y humedad, pequeñas imperfecciones y cambios de color según el flujo sanguíneo y la estructura vascular que hay debajo. Los modelos de IA comprimen todo esto en un promedio estadístico. El resultado es una piel que es técnicamente "correcta", pero que resulta profundamente extraña de una forma que la mayoría de los espectadores percibirán sin saber nombrarla.
El efecto figura de cera
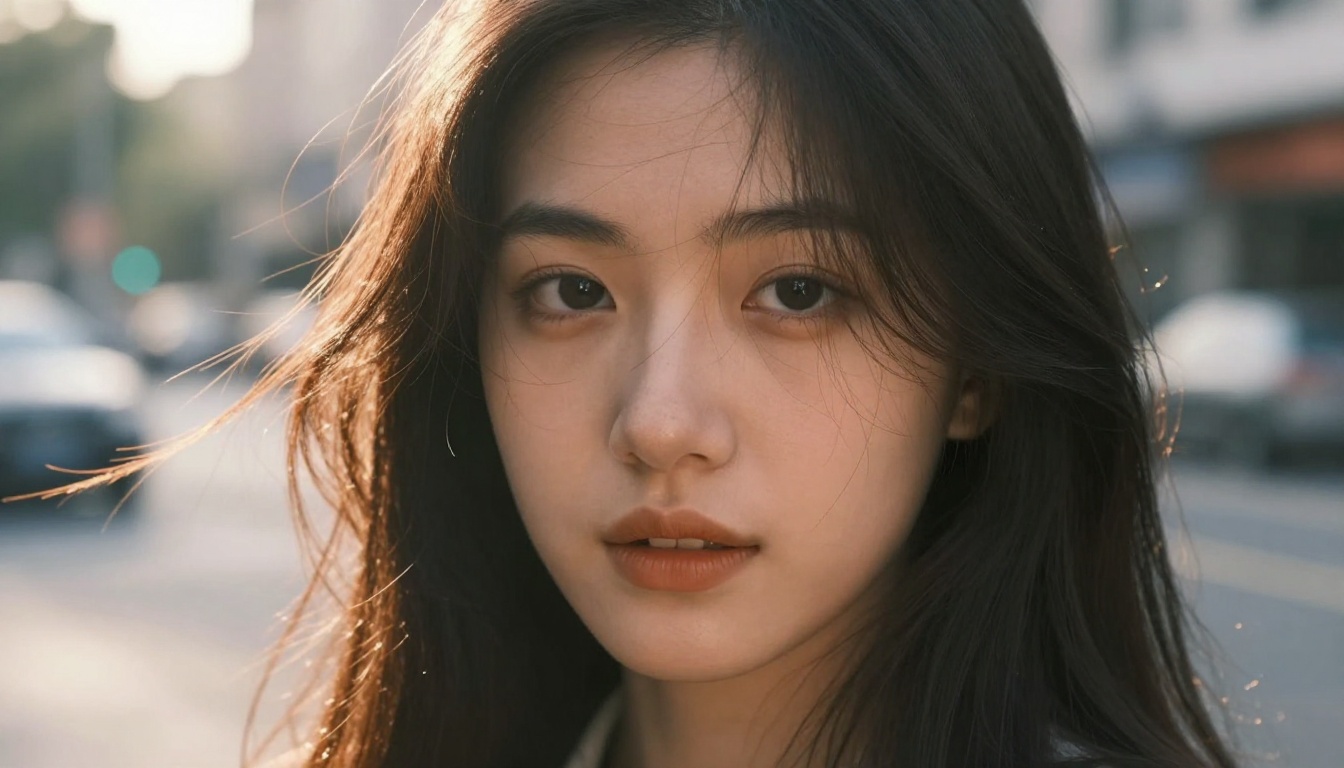
El efecto figura de cera surge de dos factores que actúan juntos:
- Suavizado excesivo: El modelo promedia la variación de la textura en lugar de conservar las microimperfecciones que delatan la piel humana real.
- Falta de dispersión subsuperficial: La piel real deja pasar la luz ligeramente por las capas dérmicas superiores, creando un sutil brillo cálido interno. Sin esto, los rostros se ven opacos y planos, como una superficie pintada y no como tejido biológico.
Este problema es mucho peor en los primeros planos. Los planos generales y medios tienen suficiente complejidad espacial para ocultar los fallos de superficie. En cuanto pasas a un primer plano, cada debilidad en la renderización de la textura se vuelve evidente de inmediato y se lee como artificial.
Cómo pedir una textura real
Añade lenguaje de textura explícito a tus prompts. Esto indica al modelo que el detalle de la superficie importa y que debe conservarse en lugar de suavizarse.
💡 Añade estas frases a los prompts de primer plano: "poros de la piel visibles", "variación natural de la piel", "vello facial fino", "efecto de dispersión subsuperficial de la luz", "imperfecciones auténticas de la piel", "grasa y humedad naturales en la superficie de la piel", "rubor capilar realista"
En el caso del pelo, describe las hebras individuales en lugar de la forma general. "Pelo castaño oscuro con reflejos naturales que captan la luz, hebras individuales visibles, ligero encrespamiento en la línea del nacimiento, brillo natural de grasa en la coronilla" superará siempre a "pelo castaño oscuro" por un margen considerable. El modelo necesita permiso para renderizar la complejidad en lugar de recurrir a una representación simplificada.
Motivo 3: Iluminación incorrecta y sombras malas
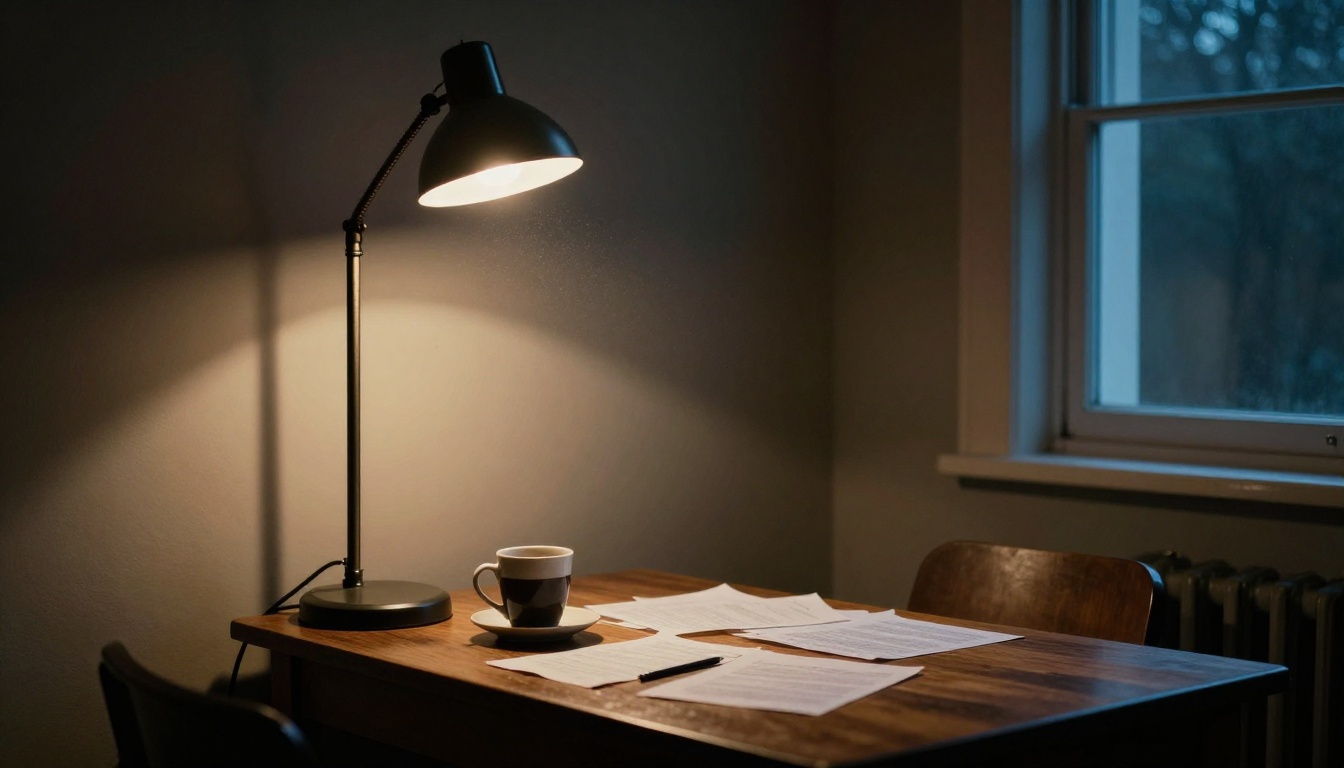
La iluminación es donde el video con IA falla de una forma que la mayoría de los espectadores no pueden identificar de manera consciente, pero sienten de inmediato. Las sombras caen en la dirección equivocada. Un rostro está iluminado de forma uniforme por todos los lados en una escena que debería tener una luz direccional fuerte. Los reflejos de las superficies no coinciden con las fuentes de luz visibles en el encuadre. Estas incoherencias no gritan que algo es falso. Lo susurran, de forma persistente, durante toda la duración del clip. El procesamiento subconsciente de la física de la luz es uno de los aspectos más profundamente entrenados de la percepción visual humana, y la IA lo rompe de maneras sutiles pero constantes.
Por qué la IA entiende tan mal la luz
Los modelos de IA no tienen un motor de simulación de luz funcionando por debajo. Aprenden la iluminación exclusivamente a partir de datos de entrenamiento, lo que hace que desarrollen sesgos fuertes hacia ciertos patrones de luz: la iluminación de retrato de tres puntos, la luz suave y nublada de exterior, los montajes de estudio limpios. Estos están sobrerrepresentados en los datos de entrenamiento porque producen imágenes agradables y bien expuestas.
En cuanto describes un escenario de luz más inusual o específico, el modelo tiende a volver a sus promedios cómodos. Pide una luz lateral dura de mediodía y, a menudo, obtendrás una luz suave y favorecedora. Pide una sola vela como única fuente en la escena y, con frecuencia, seguirás obteniendo una iluminación suave y uniforme, como si se hubiera colocado una gran caja de luz justo fuera de cámara. El modelo sabe lo que significa "vela", pero recurre a lo que ha aprendido que hace que una imagen se vea bien.
Prompts de iluminación basados en la escena que sí funcionan
La solución es describir las fuentes de luz de forma física, no estética. No digas "iluminación dramática" ni "atmósfera melancólica". Son resultados subjetivos, no descripciones físicas. Di "una única fuente de luz práctica de tungsteno justo encima, que proyecta sombras fuertes hacia abajo, sin luz ambiental de otras fuentes, relleno de sombra profunda desde abajo".
💡 Estructura de prompt de iluminación: [Number and type of light source] + [Position and direction] + [Color temperature in Kelvin] + [Shadow behavior] + [Secondary or fill light if any]
| Aspecto deseado | Descripción física en el prompt |
|---|
| Atardecer cálido | "Sol a 10 grados sobre el horizonte, a la derecha, luz naranja-ámbar de 2700K que roza las superficies con un ángulo bajo, sombras largas que se extienden hacia la izquierda, ligera neblina atmosférica" |
| Interior práctico | "Una única bombilla de tungsteno cenital, ámbar cálido de 2400K, sombras duras justo debajo de todos los objetos, ligero rebote ambiental de las paredes blancas que reduce ligeramente la profundidad de la sombra" |
| Nublado plano | "Cielo nublado uniforme como una fuente de luz difusa de 5500K desde arriba, profundidad de sombra mínima, ligero relleno verdoso reflejado desde la hierba bajo el sujeto" |
| Luz lateral dramática | "Una gran ventana única a la izquierda, luz de día de 5500K, sombras horizontales fuertes sobre el rostro y el cuerpo, lado derecho casi en sombra total, sin luz de relleno" |
Motivo 4: Parpadeo temporal y deriva entre fotogramas
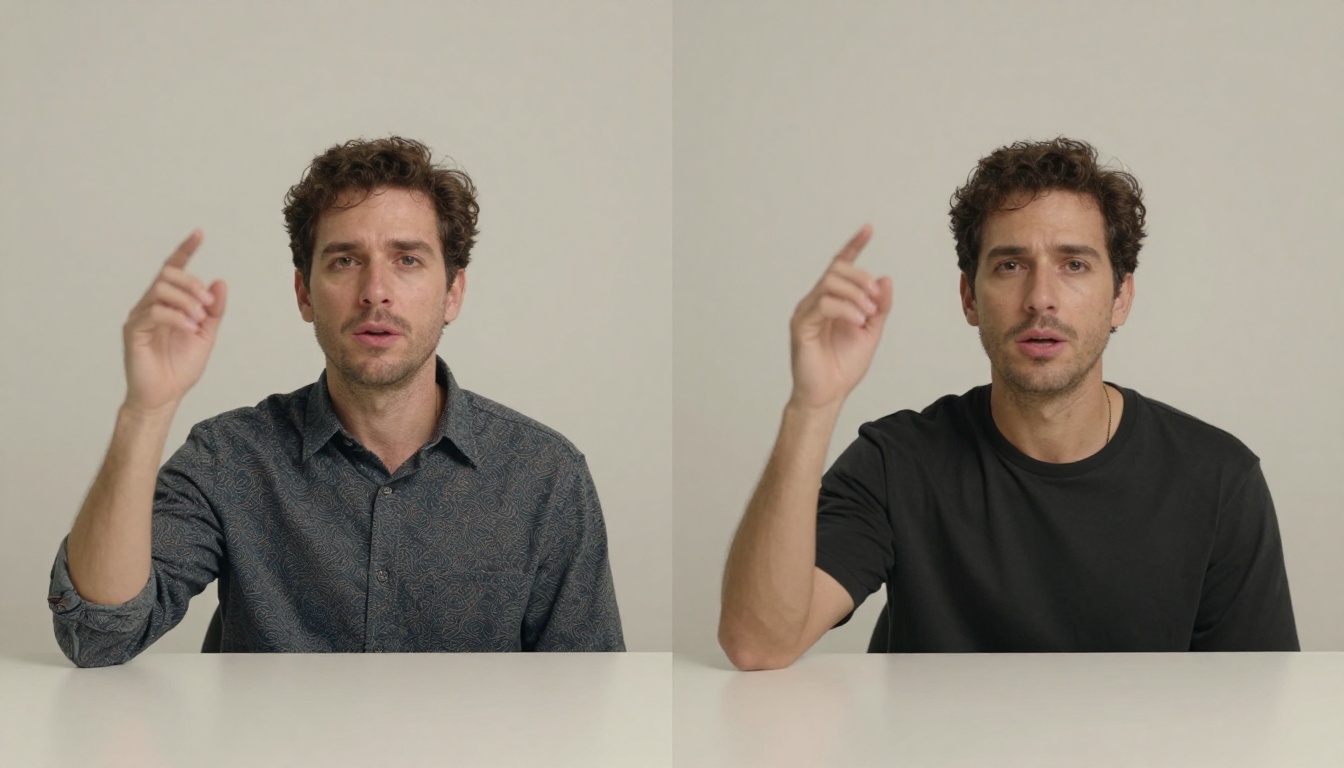
La coherencia temporal es el problema menos comprendido, pero a menudo el que más daña la calidad percibida. Se refiere a la capacidad de un video para mantener la coherencia visual entre fotogramas consecutivos. Cuando falla, aparece el parpadeo: el color de la piel cambia sutilmente entre fotogramas, los detalles del cabello se desplazan ligeramente y los elementos del fondo ondulan a nivel de píxel. En el mejor de los casos, parece un artefacto de compresión. En el peor, da la sensación de una escena montada con elementos que no encajan.
Lo que realmente ocurre
Los modelos de video generan los fotogramas con cierto grado de independencia. Mantienen la coherencia mediante mecanismos de condicionamiento aprendidos, pero no son perfectos y se degradan bajo ciertas condiciones. Los detalles finos en zonas de alta frecuencia visual, en concreto el cabello, la textura de la tela, los fondos complejos y los rostros en movimiento, son especialmente propensos a pequeñas variaciones entre fotogramas. Al reproducirse a 24 fotogramas por segundo, estas variaciones crean un efecto de centelleo o estroboscópico que se percibe de inmediato como artificial.
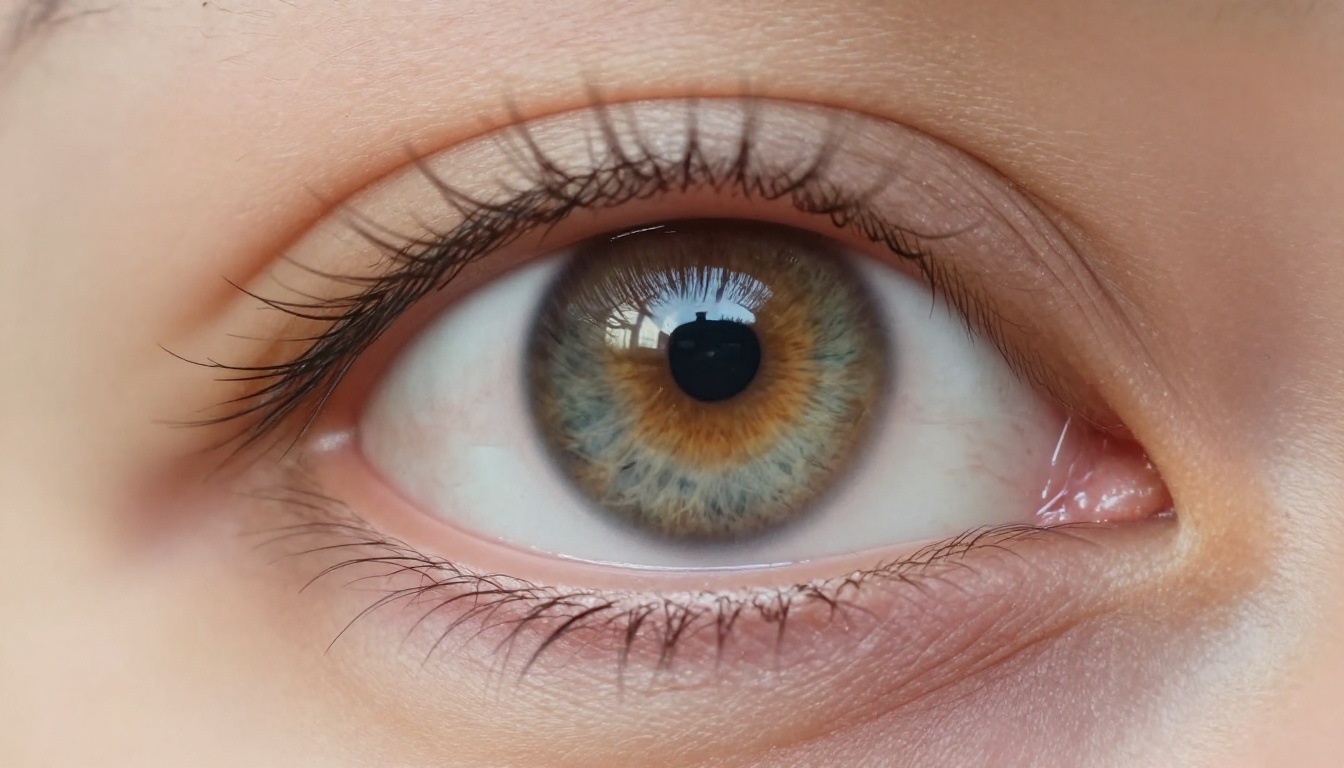
Los ojos son un área especialmente reveladora para el parpadeo temporal. El patrón del iris, la posición del reflejo de luz y la forma precisa de la pupila pueden cambiar ligeramente entre fotogramas de formas que se leen de inmediato como artificiales. Esto explica en parte por qué los personajes de IA suelen tener una mirada vidriosa y ligeramente muerta, aunque la geometría facial sea técnicamente correcta. El ojo es una de las características que más atrae la atención en cualquier escena, y la inestabilidad temporal ahí es casi imposible de pasar por alto.
Elegir el modelo adecuado para la coherencia
No todos los modelos gestionan la coherencia temporal por igual. Los modelos entrenados durante más tiempo y con arquitecturas más grandes, diseñadas específicamente para salidas cinematográficas, tienden a mantener la coherencia entre fotogramas de forma notablemente mejor. Las versiones rápidas y ligeras de la mayoría de modelos sacrifican la estabilidad temporal para reducir el tiempo de cómputo y el costo.
💡 Para la estabilidad temporal, los tiempos de generación más largos suelen corresponder a una mejor coherencia. Si un modelo ofrece un nivel "fast" y otro "pro", el nivel pro suele manejar mejor el parpadeo en los detalles finos de superficie.
Estrategias de prompt que mejoran la coherencia temporal:
- Describe un movimiento estable y más lento en lugar de un movimiento caótico y rápido
- Evita escenas con muchos elementos que se mueven de forma independiente y compiten por la atención
- Usa prompts de clip más largos y específicos en lugar de descripciones abiertas y vagas
- Especifica el comportamiento de la cámara de forma explícita ("cámara completamente estática" o "travelling lento y suave hacia la derecha a velocidad constante") en lugar de dejar que el modelo improvise el movimiento de cámara
Modelos que sí ofrecen realismo
Entender los cuatro problemas es útil. Tener las herramientas adecuadas para actuar según ese entendimiento es lo que realmente cambia tu resultado. Estos modelos producen siempre resultados con menos de los artefactos descritos, aunque los principios de prompting siguen aplicándose sin importar qué modelo elijas.
Seedance 1.5 Pro para una salida cinematográfica
Seedance 1.5 Pro de ByteDance es uno de los mejores modelos actuales para sujetos humanos fotorrealistas. Incluye generación de audio nativa, lo que elimina uno de los pasos de edición adicionales más comunes. Su manejo de la textura de la piel y del movimiento del pelo es notablemente mejor que el de muchos competidores en el mismo nivel de velocidad, y responde especialmente bien a la descripción física explícita en los prompts. Cuanto más específico sea tu lenguaje de iluminación y textura, más fiel será el resultado a lo que describiste.
Kling v3 para la calidad del movimiento
Kling v3 Video de Kwai es el referente actual en movimiento natural. Su comportamiento de tela, la locomoción de los personajes y los detalles de movimiento secundario, como el pelo que sigue a una cabeza en movimiento en lugar de animarse por su cuenta, están siempre entre los mejores disponibles. Si los problemas de movimiento basados en la física son tu principal frustración, Kling v3 debería ser tu primera opción. Combínalo con los prompts de movimiento detallados de la sección del Motivo 1 y los resultados son siempre sólidos. Kling v3 Omni Video lleva esto más lejos para la generación de texto a video en 1080p.
Otros contendientes sólidos
Varios otros modelos ofrecen ventajas específicas para casos de uso concretos:
- Veo 3: Modelo de Google con integración nativa de audio. La coherencia temporal está entre las mejores disponibles y maneja especialmente bien las escenas exteriores con iluminación natural compleja.
- Wan 2.7 T2V: Excelente salida en 1080p con buena adherencia al prompt. Un modelo polivalente y fiable para escenas que priorizan la resolución y el detalle fino.
- Hailuo 2.3: Sólido en composiciones cinematográficas con iluminación dramática. Maneja mejor que la mayoría de su gama los escenarios de sombras complejas.
- LTX 2.3 Pro: Salida en 4K con niveles de calidad impresionantes. Cuando la resolución es la prioridad y el tiempo de generación no es una limitación, ofrece un detalle de superficie excepcional.
- Sora 2: El modelo de OpenAI tiene un sólido modelado del mundo, lo que significa que maneja la física de forma más fiable por defecto, incluso con prompts menos detallados. Un buen punto de partida para quienes todavía están desarrollando su práctica con prompts.
- Pixverse v5: Generación rápida con calidad sólida en 1080p. Ideal para iterar con rapidez al probar varias variaciones de prompt antes de decidirte por una generación completa.
| Modelo | Ideal para | Salida |
|---|
| Seedance 1.5 Pro | Personas fotorrealistas, textura de piel y cabello | Hasta 1080p con audio |
| Kling v3 Video | Física del movimiento, comportamiento de la tela y el cabello | Hasta 1080p |
| Veo 3 | Coherencia temporal, iluminación exterior | Hasta 1080p con audio |
| LTX 2.3 Pro | Detalle fino, salida de alta resolución | Hasta 4K |
| Wan 2.7 T2V | Calidad polivalente, fidelidad al prompt | Hasta 1080p |
| Sora 2 | Modelado de la física del mundo, prompts accesibles | Hasta 1080p con audio |
Empieza a crear mejores videos con IA ahora mismo
Los cuatro problemas que hemos tratado aquí, la física rota, los fallos de textura de superficie, las incoherencias de iluminación y el parpadeo temporal, tienen soluciones prácticas que puedes aplicar a tu próxima generación. El hilo común en todos ellos es la especificidad. Los prompts vagos producen resultados promedio que parecen video con IA promedio. Las descripciones detalladas y físicamente precisas dan al modelo la información que necesita para producir resultados que resistan un examen detenido.
La vía más rápida para mejorar es elegir una de estas cuatro áreas, aplicar la estrategia de prompt correspondiente a tu próxima generación y comparar el resultado directamente con un intento anterior de la misma escena. La diferencia suele ser lo bastante significativa como para cambiar por completo tu forma de entender cómo funcionan estas herramientas.
Una lista rápida antes de generar:
- ¿Tu prompt describe fuerzas físicas, peso e impulso, y no solo la apariencia?
- ¿Has especificado de forma explícita la textura de la piel y de las superficies en los planos de primer plano?
- ¿Has descrito tus fuentes de luz como objetos físicos con posición, dirección y temperatura de color?
- ¿Le has indicado a la cámara qué hacer, o la has dejado sin definir?
Todos los modelos mencionados en este artículo están disponibles en Picasso IA, donde puedes ejecutarlos directamente desde tu navegador sin configuración local, instalación ni requisitos de GPU. Si has estado conformándote con un video con IA que parece artificial, las herramientas y los conocimientos para cambiarlo están ahí mismo. El próximo video que generes no tiene por qué parecer falso.


