Você gerou o vídeo. Você assistiu. E algo simplesmente... não está certo. A pessoa se move como se estivesse debaixo d'água. O cabelo se comporta como um objeto sólido. As sombras parecem vir de três sóis diferentes ao mesmo tempo. Esta é uma das experiências mais frustrantes na criação de conteúdo com IA, e acontece com quase todo mundo que começa a usar ferramentas de texto para vídeo.
A boa notícia: os motivos pelos quais o vídeo com IA parece falso são específicos, repetíveis e corrigíveis. São quatro, e, quando você entende o que está dando errado de fato, a qualidade do seu resultado melhora bastante. Não se trata de trocar por um modelo melhor nem de gastar mais créditos. Trata-se de entender o que esses modelos realmente precisam de você.
A maioria das pessoas presume que o problema é o modelo. Elas trocam de modelo, testam outra ferramenta e obtêm quase o mesmo resultado. O problema raramente está no modelo em si. A IA atual de texto para vídeo é realmente poderosa. Kling v3 Video, Seedance 1.5 Pro e Wan 2.7 T2V conseguem produzir imagens que, sob as condições certas, beiram o indistinguível de uma filmagem real. O teto é alto. O piso, porém, é onde a maioria dos resultados termina.
Os problemas que fazem o vídeo com IA parecer falso se dividem em quatro categorias coerentes: física do movimento, textura da superfície, consistência da iluminação e estabilidade temporal. Cada uma tem uma causa raiz. Cada uma tem uma correção.
O vale da estranheza existe de verdade
O vale da estranheza é o desconforto perceptivo provocado por algo que quase parece humano, mas não chega a convencer. O vídeo piora isso em relação às imagens estáticas, porque o movimento amplifica cada imperfeição. Uma posição levemente errada da mão é incômoda por um quadro. Ao longo de 96 quadros de animação, torna-se visceralmente desconfortável de assistir. O cérebro processa o sinal visual continuamente, e cada desvio do comportamento humano esperado é registrado como errado, mesmo quando o espectador não consegue explicar por quê.
Não é o modelo, é a entrada
Os modelos de vídeo com IA não leem sua intenção. Eles processam suas palavras. Um prompt vago produz um resultado vago. O modelo preenche as informações que faltam com médias estatísticas, e é exatamente por isso que você obtém aquela qualidade genérica, oca e artificialmente renderizada. A especificidade é a ferramenta mais poderosa que você tem, e não custa nada.
Motivo 1: Física quebrada e movimento não natural
Este é o problema mais comum e o mais óbvio. Tecido que flutua em vez de cair em dobras. Cabelo que se move como um bloco rígido. Um personagem correndo cujos pés nunca tocam o chão de verdade. Não são falhas aleatórias; são resultado direto do modo como os modelos de vídeo baseados em difusão funcionam.
Os modelos de IA aprendem com padrões nos dados de treinamento. Eles entendem que "uma pessoa anda" deve resultar em movimento das pernas. Mas não simulam física a partir de princípios básicos. Eles a aproximam estatisticamente. Quando a aproximação falha, você obtém um movimento que parece ter sido animado por alguém que leu sobre caminhar, mas nunca caminhou de verdade.
Quando a gravidade esquece de aparecer
O sinal mais revelador de física falsa é o comportamento do tecido e do cabelo. O tecido real tem peso. Ele responde ao momento e à gravidade de maneira diferente conforme a trama, a densidade e o corte. Um casaco pesado de lã balança com atraso e peso considerável. Uma blusa de seda responde a quase qualquer micromovimento. Os modelos de IA, principalmente com prompts vagos, recorrem a um comportamento médio de tecido que não corresponde de forma convincente a nenhum material real.
O cabelo é ainda pior. É uma das coisas mais difíceis de renderizar de forma convincente, porque cada fio individual tem massa quase nula, mas, coletivamente, cria padrões complexos de movimento emergente. Ao escrever um prompt para "uma mulher correndo" e quase certamente você obterá um cabelo que se move como uma forma única e lisa, como uma peça de plástico moldado presa ao couro cabeludo.
Peça movimento no prompt, não apenas aparência
💡 Não descreva como a cena parece. Descreva como isso se comporta fisicamente. Inclua massa, momento e o atraso que acompanha o movimento do mundo real.
Em vez de: "Uma mulher de vestido vermelho caminhando em um parque"
Experimente: "Uma mulher de vestido de seda fluido caminhando devagar por um parque, o tecido balançando suavemente a cada passo, o momento natural criando um leve movimento atrasado na barra, peso real visível no material enquanto ele assenta após cada passada"
| Prompt de movimento fraco | Prompt de movimento forte |
|---|
| "Um homem correndo" | "Um homem correndo em ritmo moderado, ataque natural do calcanhar para os dedos, braços balançando com leve rotação no tronco, leve oscilação dos ombros a cada passada" |
| "O cabelo dela ao vento" | "Cabelo pego por uma brisa lateral suave vinda da esquerda, fios individuais se separando e se sobrepondo, resistência natural enquanto o vento muda brevemente de direção" |
| "A bandeira tremulando" | "Uma bandeira em vento moderado, tecido ondulando a partir do ponto de fixação em direção às bordas, tensão visível no mastro, frequência natural de oscilação conforme as rajadas passam" |
| "Folhas caindo das árvores" | "Folhas se desprendendo dos galhos e descendo em espiral com um movimento irregular de tombo, cada uma reagindo de forma diferente às correntes de ar sutis, acumulando-se no chão em ângulos variados" |
A diferença na qualidade do resultado com essa única mudança costuma ser a melhoria mais dramática que um criador pode fazer. A descrição física é quase sempre insuficiente nos prompts, e os modelos são projetados para usá-la quando ela está presente.
Motivo 2: Problemas de pele, cabelo e textura
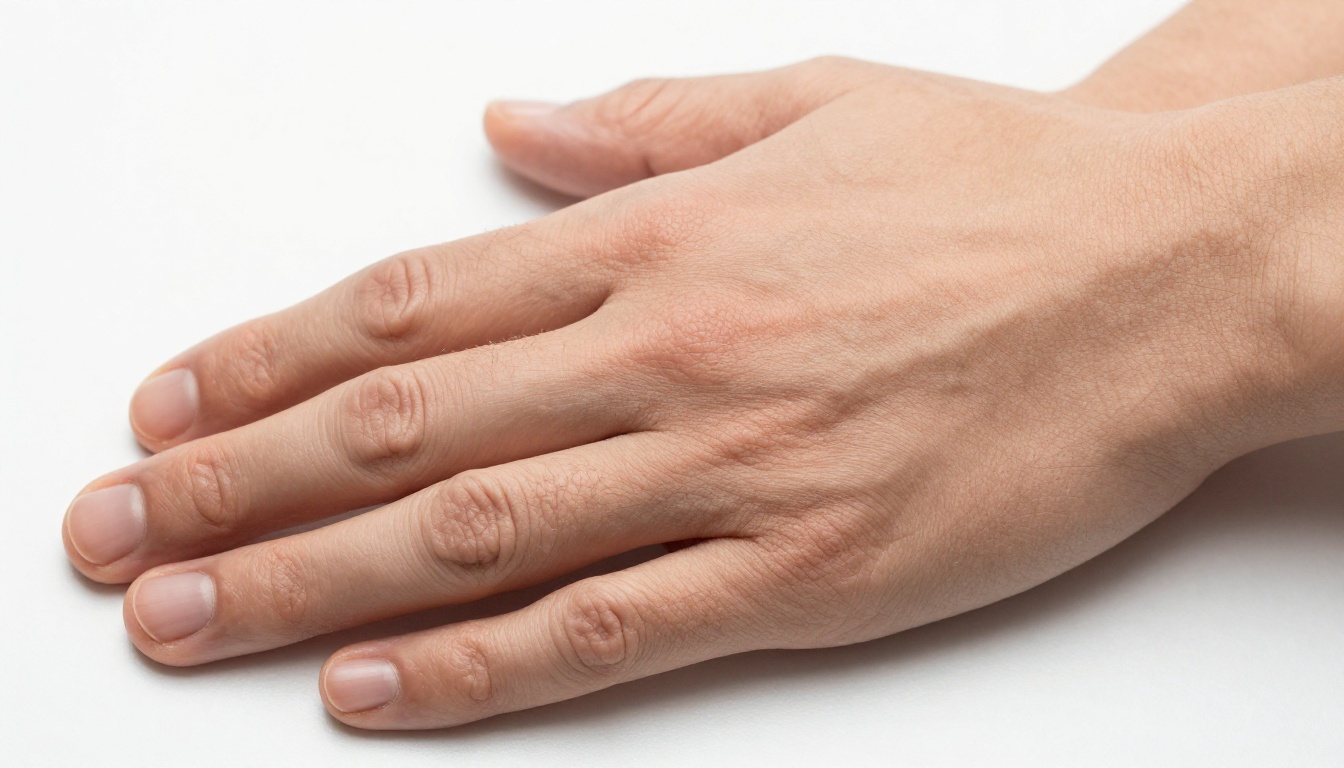
A textura é onde o vídeo com IA mais costuma se trair em planos fechados e médios. O problema tem um nome específico no setor: o efeito de figura de cera. É aquele visual em que a pele da pessoa parece lisa, levemente reflexiva e uniformemente iluminada, como um manequim de alta qualidade em vez de um ser humano. A geometria facial pode ser excelente. As proporções podem estar perfeitas. Mas a superfície transmite a sensação de fabricação.
A pele real é extraordinariamente complexa. Tem poros, pelos finos, microssombras, dispersão de luz subsuperficial, variação de oleosidade e umidade, pequenas imperfeições e mudanças de cor baseadas no fluxo sanguíneo e na estrutura vascular subjacente. Os modelos de IA comprimem tudo isso em uma média estatística. O resultado é uma pele tecnicamente "correta", mas que parece profundamente errada de um jeito que a maioria dos espectadores percebe, mas não consegue nomear.
O efeito de figura de cera
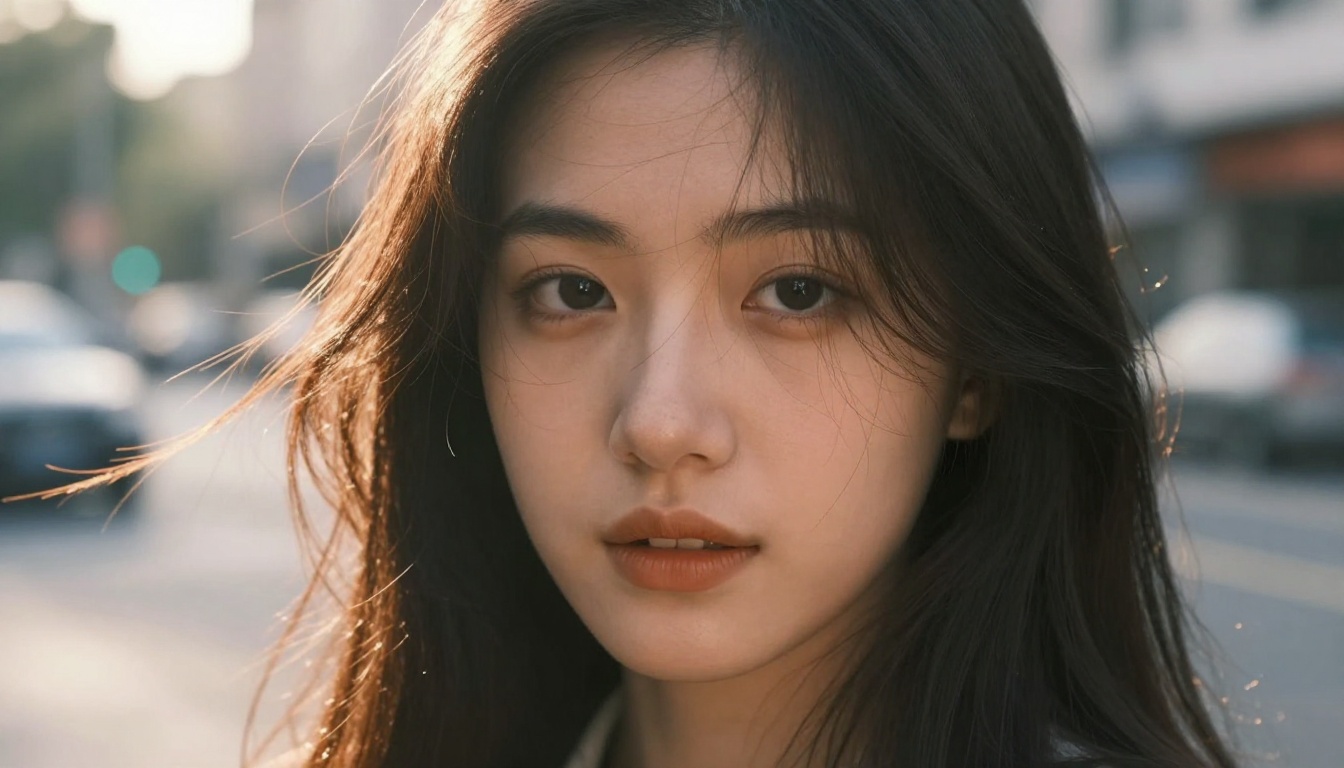
O efeito de figura de cera vem de dois fatores que atuam juntos:
- Suavização excessiva: o modelo nivela a variação de textura, em vez de preservar as microimperfeições que indicam pele humana real
- Ausência de dispersão subsuperficial: a pele real deixa a luz atravessar ligeiramente as camadas dérmicas superiores, criando um sutil brilho quente interno. Sem isso, os rostos parecem opacos e chapados, como uma superfície pintada em vez de tecido biológico
Esse problema é bem pior em planos fechados. Os planos abertos e médios têm complexidade espacial suficiente para esconder falhas de superfície. No momento em que você passa para um close, cada fraqueza na renderização de textura se torna imediatamente aparente e passa a parecer artificial.
Como pedir textura real no prompt
Acrescente linguagem explícita de textura aos seus prompts. Isso sinaliza ao modelo que o detalhe da superfície importa e deve ser preservado, em vez de suavizado.
💡 Acrescente estas expressões aos prompts de close-up: "poros visíveis na pele", "variação natural da pele", "pelos faciais finos", "efeito de dispersão de luz subsuperficial", "imperfeições autênticas da pele", "oleosidade e umidade naturais na superfície da pele", "rubor capilar realista"
No caso do cabelo, descreva fios individuais em vez da forma geral. "Cabelo castanho-escuro com reflexos naturais captando a luz, fios individuais visíveis, leve frizz na linha do cabelo, brilho oleoso natural no topo da cabeça" vai superar consistentemente "cabelo castanho-escuro" por uma margem significativa. O modelo precisa de permissão para renderizar complexidade, em vez de recorrer a uma representação simplificada.
Motivo 3: Iluminação errada e sombras ruins
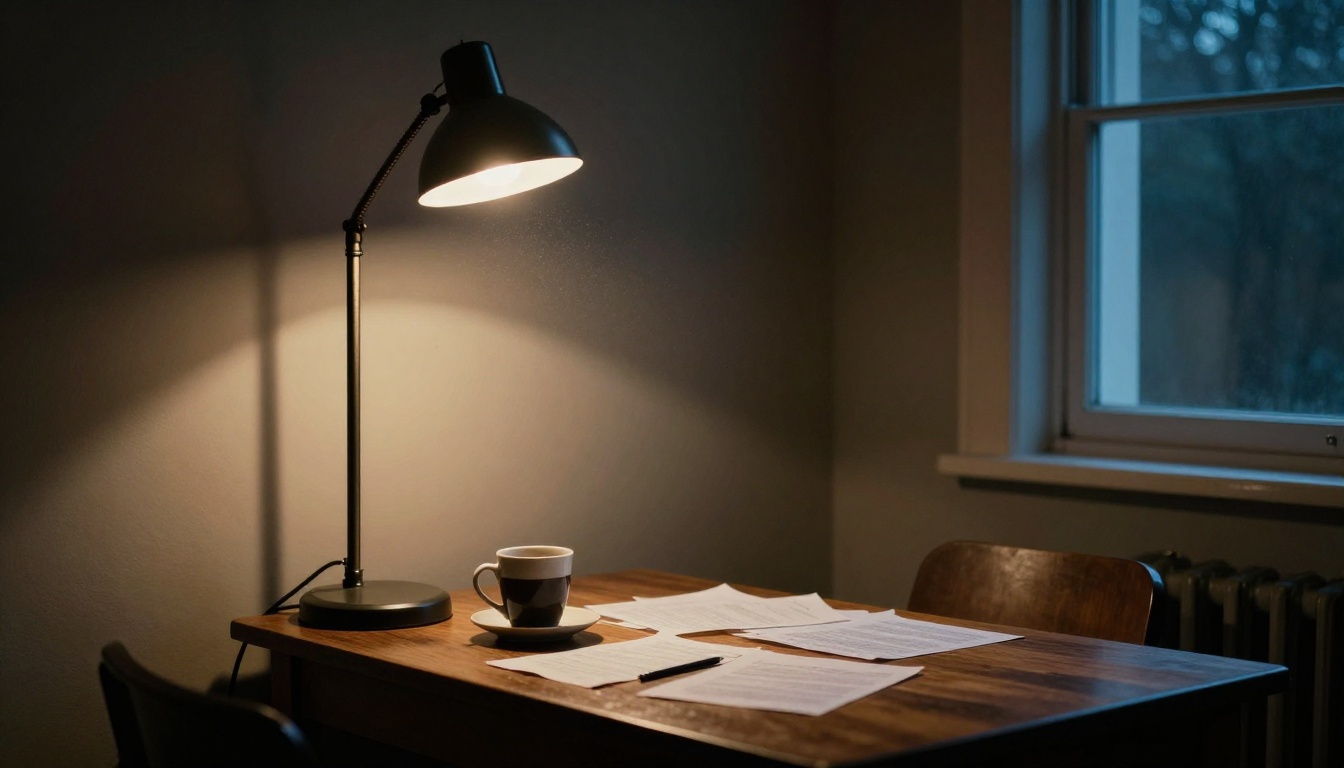
A iluminação é onde o vídeo com IA falha de um jeito que a maioria dos espectadores não consegue identificar conscientemente, mas sente de imediato. As sombras caem na direção errada. Um rosto é iluminado de maneira uniforme por todos os lados em uma cena que deveria ter luz direcional forte. Os reflexos nas superfícies não batem com as fontes de luz visíveis no quadro. Essas inconsistências não gritam que é falso. Elas sussurram, de forma persistente, durante toda a duração do clipe. O processamento subconsciente da física da luz é um dos aspectos mais profundamente treinados da percepção visual humana, e a IA a quebra de maneiras sutis, mas constantes.
Por que a IA erra tanto a luz
Os modelos de IA não têm um motor de simulação de luz funcionando por trás. Eles aprendem a iluminação inteiramente a partir dos dados de treinamento, o que significa que desenvolvem fortes vieses para certos padrões de luz: iluminação de retrato de três pontos, luz externa difusa de céu nublado, cenários de estúdio limpos. Esses padrões são superrepresentados nos dados de treinamento porque produzem imagens agradáveis e bem expostas.
No momento em que você descreve um cenário de luz mais incomum ou específico, o modelo tende a voltar para suas médias confortáveis. Peça luz lateral dura de meio-dia e você frequentemente obterá uma luz suave e lisonjeira. Peça uma única vela como a única fonte da cena e, com frequência, ainda terá uma iluminação suave e uniforme, como se uma grande softbox tivesse sido colocada logo fora do quadro. O modelo sabe o que significa "vela", mas recorre ao que aprendeu que deixa a imagem bonita.
Prompts de iluminação baseados em cena que funcionam
A solução é descrever as fontes de luz de forma física, não estética. Não diga "iluminação dramática" ou "atmosfera sombria". Esses são resultados subjetivos, não descrições físicas. Diga "uma única fonte prática de tungstênio diretamente acima, projetando sombras fortes para baixo, sem luz ambiente de outras fontes, sombra profunda com preenchimento vindo de baixo".
💡 Estrutura de prompt de iluminação: [Number and type of light source] + [Position and direction] + [Color temperature in Kelvin] + [Shadow behavior] + [Secondary or fill light if any]
| Aparência desejada | Descrição física no prompt |
|---|
| Pôr do sol quente | "Sol a 10 graus acima do horizonte à direita, luz âmbar-alaranjada de 2700K varrendo as superfícies em ângulo baixo, sombras longas se estendendo para a esquerda, leve névoa atmosférica" |
| Interior prático | "Uma única lâmpada de tungstênio no teto, âmbar quente de 2400K, sombras duras diretamente sob todos os objetos, leve reflexo ambiente das paredes brancas reduzindo um pouco a profundidade da sombra" |
| Nublado chapado | "Céu nublado uniforme como uma fonte de luz difusa de 5500K vinda de cima, profundidade de sombra mínima, leve preenchimento verde refletido pela grama abaixo do sujeito" |
| Luz lateral dramática | "Uma grande janela à esquerda, luz do dia de 5500K, sombras horizontais fortes atravessando o rosto e o corpo, lado direito em sombra quase total, sem luz de preenchimento" |
Motivo 4: Cintilação temporal e deriva de quadros
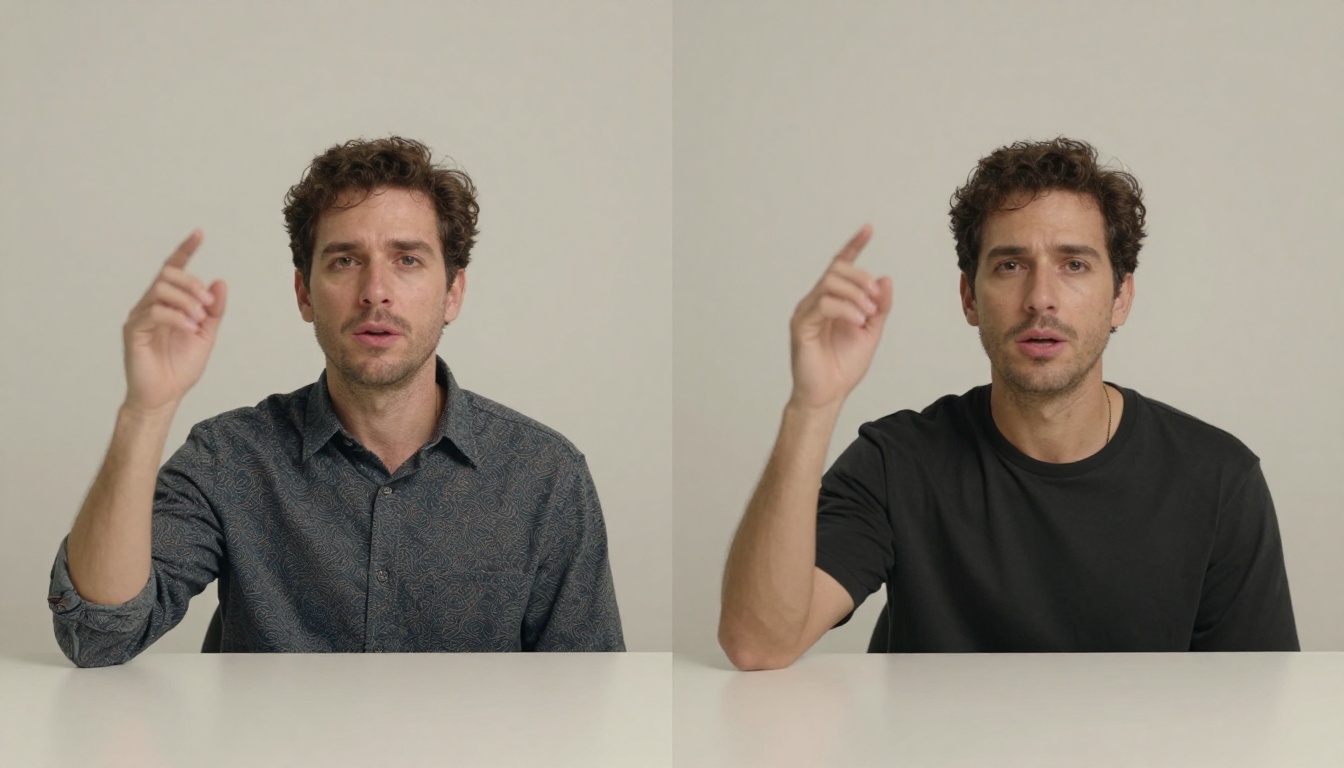
A consistência temporal é o problema menos compreendido, mas muitas vezes o que mais prejudica a qualidade percebida. Ela se refere à capacidade de um vídeo de manter coerência visual entre quadros consecutivos. Quando falha, você vê cintilação: a cor da pele muda sutilmente entre os quadros, os detalhes do cabelo mudam ligeiramente de posição, elementos do fundo ondulam no nível do pixel. Na melhor das hipóteses, parece um artefato de compressão. Na pior, lembra uma cena composta a partir de elementos incompatíveis.
O que realmente está acontecendo
Os modelos de vídeo geram quadros com certo grau de independência. Eles mantêm a consistência por meio de mecanismos de condicionamento aprendidos, mas esses mecanismos não são perfeitos e se degradam em certas condições. Detalhes finos em áreas visuais de alta frequência, especificamente cabelo, textura de tecido, fundos complexos e rostos em movimento, são particularmente propensos a pequenas variações entre quadros. Quando reproduzidos a 24 quadros por segundo, essas variações criam um efeito de tremulação ou estroboscópico que é percebido de imediato como artificial.
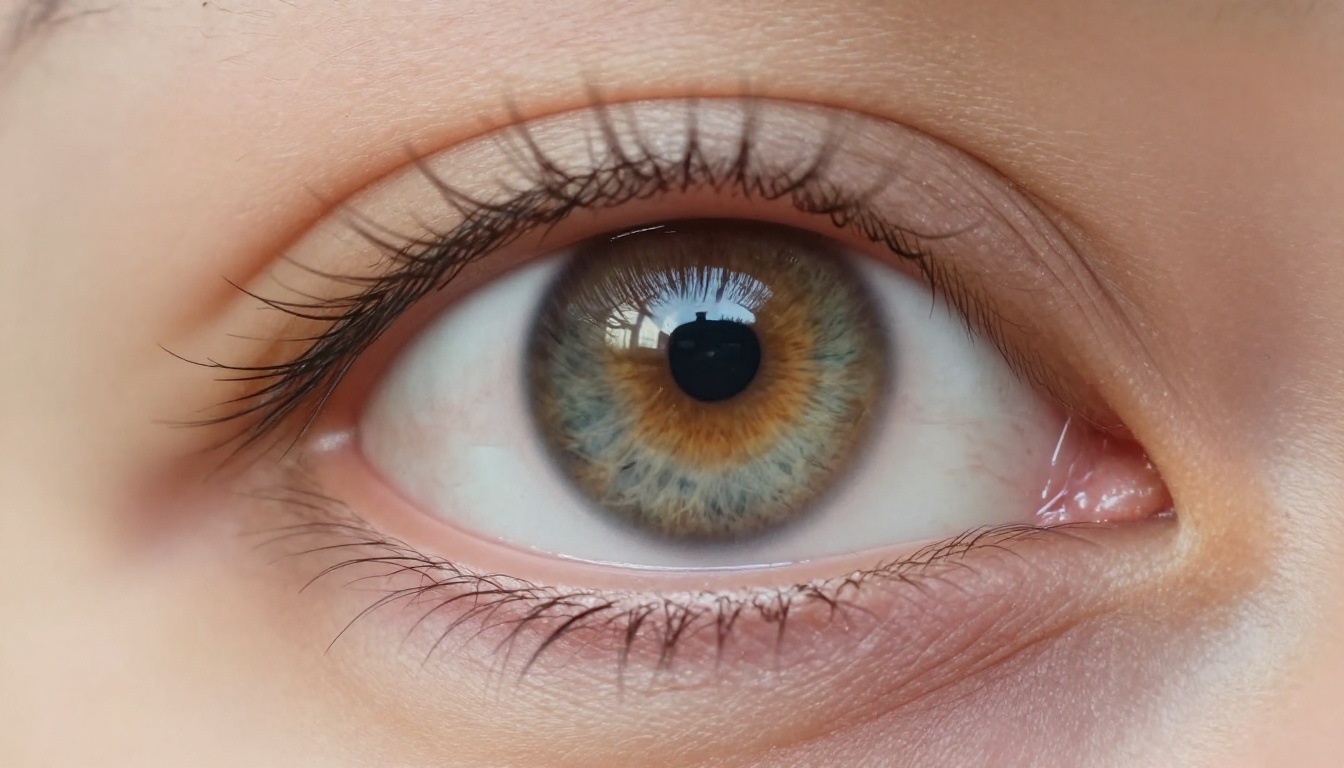
Os olhos são uma área especialmente reveladora da cintilação temporal. O padrão da íris, a posição do brilho na córnea e a forma precisa da pupila podem mudar levemente entre os quadros de maneiras que são percebidas de imediato como artificiais. Isso explica em parte por que personagens de IA costumam ter um olhar vítreo, levemente sem vida, mesmo quando a geometria facial está tecnicamente correta. O olho é uma das características que mais atraem a atenção em qualquer cena, e a instabilidade temporal ali é quase impossível de ignorar.
Escolhendo o modelo certo para consistência
Nem todos os modelos lidam com a consistência temporal da mesma forma. Modelos treinados com execuções de treinamento mais longas e arquiteturas maiores, projetadas especificamente para saída cinematográfica, tendem a manter a coerência quadro a quadro significativamente melhor. As versões rápidas e leves da maioria dos modelos sacrificam a estabilidade temporal para reduzir o tempo de processamento e o custo.
💡 Para estabilidade temporal, tempos de geração mais longos geralmente correspondem a uma consistência melhor. Se um modelo oferece um nível "rápido" e um "pro", o nível pro normalmente lidará melhor com a cintilação em detalhes finos da superfície.
Estratégias de prompt que melhoram a consistência temporal:
- Descreva um movimento estável e mais lento, em vez de movimento rápido e caótico
- Evite cenas com muitos elementos se movendo de forma independente disputando a atenção
- Use prompts de clipe mais longos e específicos, em vez de descrições vagas e abertas
- Especifique o comportamento da câmera de forma explícita ("câmera completamente estática" ou "travelling lento e suave para a direita em velocidade constante"), em vez de deixar o modelo improvisar o movimento da câmera
Modelos que realmente entregam realismo
Entender os quatro problemas é útil. Ter as ferramentas certas para agir com base nesse entendimento é o que realmente muda o seu resultado. Estes modelos entregam consistentemente resultados com menos dos artefatos descritos acima, embora os princípios de prompt continuem valendo, independentemente do modelo que você escolher.
Seedance 1.5 Pro para saída cinematográfica
O Seedance 1.5 Pro, da ByteDance, é hoje um dos melhores para sujeitos humanos fotorrealistas. Ele inclui geração de áudio nativa, o que elimina uma das etapas de edição adicionais mais comuns. Seu tratamento de textura da pele e movimento do cabelo é claramente melhor que o de muitos concorrentes na mesma faixa de velocidade, e ele responde particularmente bem a descrições físicas explícitas nos prompts. Quanto mais específica for sua linguagem de iluminação e textura, mais o resultado adere ao que você descreveu.
Kling v3 para qualidade de movimento
O Kling v3 Video, da Kwai, é atualmente a referência em física de movimento natural. Seu comportamento de tecido, a locomoção de personagens e os detalhes de movimento secundário, como o cabelo acompanhando a cabeça em movimento em vez de se animar de forma independente, estão consistentemente entre os melhores disponíveis. Se os problemas de movimento baseados em física são sua principal frustração, o Kling v3 deve ser sua primeira escolha. Combine-o com os prompts de movimento detalhados da seção Motivo 1 e os resultados são confiavelmente fortes. O Kling v3 Omni Video vai além e oferece texto para vídeo em 1080p.
Outros concorrentes fortes
Vários outros modelos oferecem vantagens específicas para casos de uso particulares:
- Veo 3: modelo do Google com integração nativa de áudio. A consistência temporal está entre as melhores disponíveis, e ele lida especialmente bem com cenas externas com iluminação natural complexa.
- Wan 2.7 T2V: excelente saída em 1080p com forte aderência ao prompt. Um coringa confiável para cenas que priorizam resolução e detalhe fino.
- Hailuo 2.3: forte em composições cinematográficas com iluminação dramática. Lida com cenários de sombra complexos melhor que a maioria na sua faixa.
- LTX 2.3 Pro: saída em 4K com qualidade impressionante. Quando a resolução é a prioridade e o tempo de geração não é uma restrição, ele entrega detalhes de superfície finos excepcionais.
- Sora 2: o modelo da OpenAI tem modelagem de mundo sólida, o que significa que lida com a física de forma mais confiável por padrão, mesmo com prompts menos detalhados. Um bom ponto de partida para usuários que ainda estão desenvolvendo sua prática de prompts.
- Pixverse v5: geração rápida com qualidade sólida em 1080p. Bem indicado para iterações rápidas ao testar várias variações de prompt antes de partir para uma geração completa.
| Modelo | Melhor para | Saída |
|---|
| Seedance 1.5 Pro | Humanos fotorrealistas, textura de pele e cabelo | Até 1080p com áudio |
| Kling v3 Video | Física de movimento, comportamento de tecido e cabelo | Até 1080p |
| Veo 3 | Consistência temporal, iluminação externa | Até 1080p com áudio |
| LTX 2.3 Pro | Detalhe fino, saída de alta resolução | Até 4K |
| Wan 2.7 T2V | Qualidade versátil, fidelidade ao prompt | Até 1080p |
| Sora 2 | Modelagem da física do mundo, prompts acessíveis | Até 1080p com áudio |
Os quatro problemas abordados aqui, física quebrada, falhas de textura de superfície, inconsistências de iluminação e cintilação temporal, têm soluções práticas que você pode aplicar já na sua próxima geração. O fio condutor de todas elas é a especificidade. Prompts vagos produzem resultados médios que parecem vídeo com IA genérico. Descrições detalhadas e fisicamente precisas dão ao modelo as informações de que ele precisa para produzir resultados que resistem ao escrutínio.
O caminho mais rápido para melhorar é escolher uma dessas quatro áreas, aplicar a estratégia de prompt correspondente à sua próxima geração e comparar o resultado diretamente com uma tentativa anterior com a mesma cena. A diferença costuma ser grande o suficiente para mudar todo o seu modelo mental de como essas ferramentas funcionam.
Uma checklist rápida antes de gerar:
- Seu prompt descreve forças físicas, peso e momento, e não apenas aparência?
- Você especificou pele e textura de superfície explicitamente para qualquer plano fechado?
- Você descreveu suas fontes de luz como objetos físicos com posição, direção e temperatura de cor?
- Você disse à câmera o que fazer, ou deixou isso indefinido?
Todos os modelos citados neste artigo estão disponíveis no Picasso IA, onde você pode executá-los diretamente no navegador, sem configuração local, instalação ou necessidade de GPU. Se você vinha aceitando vídeos com IA que parecem artificiais, as ferramentas e o conhecimento para mudar isso estão ali, prontos para uso. O próximo vídeo que você gerar não precisa parecer falso.


