Vous avez généré la vidéo. Vous l’avez regardée. Et quelque chose cloche… La personne bouge comme si elle était sous l’eau. Les cheveux se comportent comme un objet solide. Les ombres semblent tomber de trois soleils à la fois. C’est l’une des expériences les plus frustrantes de la création de contenu par IA, et elle touche presque tous ceux qui débutent avec les outils de texte vers vidéo.
Bonne nouvelle : les raisons pour lesquelles une vidéo IA paraît fausse sont précises, reproductibles et corrigeables. Il y en a quatre, et dès que vous comprenez ce qui ne va pas, la qualité de vos résultats s’améliore nettement. Il ne s’agit ni de changer de modèle, ni de dépenser davantage de crédits. Il s’agit de comprendre ce dont ces modèles ont réellement besoin de votre part.
Pourquoi tant de vidéos IA paraissent encore bizarres
La plupart des gens pensent que le problème vient du modèle. Ils passent à une version supérieure, essaient un autre outil, et obtiennent presque le même résultat. Le problème vient rarement du modèle lui-même. L’IA de texte vers vidéo actuelle est réellement puissante. Kling v3 Video, Seedance 1.5 Pro et Wan 2.7 T2V peuvent tous produire des images qui, dans les bonnes conditions, frôlent l’indiscernable d’un vrai film. Le plafond est élevé. Le plancher, en revanche, c’est là qu’atterrissent la plupart des résultats.
Les problèmes qui rendent une vidéo IA artificielle se répartissent en quatre catégories récurrentes : la physique du mouvement, la texture des surfaces, la cohérence de l’éclairage et la stabilité temporelle. Chacune a une cause profonde. Chacune a une solution.
La vallée de l’étrange est réelle
La vallée de l’étrange désigne le malaise perceptif que déclenche quelque chose qui ressemble presque à un humain sans tout à fait y parvenir. La vidéo aggrave ce phénomène par rapport aux images fixes, car le mouvement amplifie chaque imperfection. Une main légèrement mal placée choque pendant une image. Sur 96 images d’animation, cela devient viscéralement désagréable à regarder. Le cerveau traite le signal visuel en continu, et chaque écart par rapport au comportement humain attendu est perçu comme faux, même quand le spectateur ne saurait pas expliquer pourquoi.
Ce n’est pas le modèle, c’est l’entrée
Les modèles de vidéo IA ne lisent pas votre intention. Ils traitent vos mots. Un prompt vague produit un résultat vague. Le modèle comble les informations manquantes avec des moyennes statistiques, ce qui explique précisément cette qualité générique, creuse et artificielle. La précision est l’outil le plus puissant dont vous disposez, et elle ne coûte rien.
Raison 1 : une physique cassée et un mouvement peu naturel
C’est le problème le plus fréquent et le plus visible. Un tissu qui flotte au lieu de tomber. Des cheveux qui bougent comme un bloc rigide. Un personnage qui court et dont les pieds ne touchent jamais vraiment le sol. Ce ne sont pas des bugs aléatoires : ils résultent directement du fonctionnement des modèles de vidéo à diffusion.
Les modèles d’IA apprennent à partir de motifs présents dans leurs données d’entraînement. Ils savent qu’« une personne marche » doit entraîner un mouvement des jambes. Mais ils ne simulent pas la physique à partir de principes premiers. Ils l’approximent statistiquement. Quand l’approximation échoue, on obtient un mouvement qui semble animé par quelqu’un qui a lu comment on marche sans jamais l’avoir fait.
Quand la gravité oublie de se manifester
Le signe le plus révélateur d’une fausse physique réside dans le comportement des tissus et des cheveux. Un vrai tissu a du poids. Il réagit à l’élan et à la gravité différemment selon son tissage, sa densité et sa coupe. Un manteau en laine lourd se balance avec un retard et une masse marquée. Un chemisier en soie réagit à presque chaque micro-mouvement. Les modèles d’IA, surtout avec des prompts vagues, reviennent à un comportement moyen du tissu qui ne correspond à aucune matière réelle.
Les cheveux sont pires encore. C’est l’un des éléments les plus difficiles à générer de façon convaincante, car chaque mèche a une masse presque nulle, mais ensemble elles créent des mouvements complexes et émergents. Demandez « une femme qui court » et vous obtiendrez presque certainement des cheveux qui bougent comme une forme lisse unique, comme une pièce de plastique moulé fixée au crâne.
Décrivez le mouvement, pas seulement l’apparence
💡 Ne décrivez pas à quoi ressemble la scène. Décrivez comment cela se comporte physiquement. Indiquez la masse, l’élan et le retard qui suit un mouvement réel.
Au lieu de : « Une femme en robe rouge marchant dans un parc »
Essayez : « Une femme en robe de soie fluide marchant lentement dans un parc, le tissu oscillant doucement à chaque pas, l’élan naturel créant un léger retard dans le mouvement de l’ourlet, le poids réel du matériau visible à mesure qu’il retombe après chaque foulée »
| Prompt de mouvement faible | Prompt de mouvement fort |
|---|
| « Un homme qui court » | « Un homme qui trottine à allure modérée, attaque naturelle du talon vers la pointe, bras qui balancent avec une légère rotation du torse, léger rebond des épaules à chaque impact du pied » |
| « Ses cheveux qui volent dans le vent » | « Cheveux pris par une douce brise latérale venant de la gauche, mèches individuelles qui se séparent et se chevauchent, résistance naturelle lorsque le vent change brièvement de direction » |
| « Le drapeau qui flotte » | « Un drapeau dans un vent modéré, tissu ondulant depuis le point d’attache vers l’extérieur, tension visible au niveau du mât, fréquence naturelle d’oscillation au passage des rafales » |
| « Des feuilles qui tombent des arbres » | « Des feuilles qui se détachent des branches et descendent en spirale avec une chute irrégulière, chacune réagissant différemment aux courants d’air subtils, s’amassant au sol selon des angles variés » |
La différence de qualité obtenue par ce seul changement est souvent l’amélioration la plus spectaculaire qu’un créateur puisse apporter. La description physique est presque toujours sous-spécifiée dans les prompts, alors que les modèles sont conçus pour l’exploiter quand elle est présente.
Raison 2 : problèmes de peau, de cheveux et de texture
La texture est l’endroit où la vidéo IA se trahit le plus souvent dans les plans rapprochés et moyens. Le problème a un nom précis dans le secteur : l’effet figure de cire. C’est cet aspect où la peau d’une personne paraît lisse, légèrement réfléchissante et uniformément éclairée, comme un mannequin de haute qualité plutôt qu’un être humain. La géométrie du visage peut être excellente. Les proportions peuvent être parfaites. Mais la surface paraît fabriquée.
La peau réelle est extraordinairement complexe. Elle a des pores, un duvet fin, des micro-ombres, une diffusion de la lumière sous la surface, des variations de sébum et d’hydratation, de petites imperfections et des changements de couleur selon la circulation sanguine et la structure vasculaire sous-jacente. Les modèles d’IA compressent tout cela en une moyenne statistique. Le résultat est une peau techniquement « correcte », mais qui paraît profondément fausse, d’une manière que la plupart des spectateurs sentiront sans pouvoir la nommer.
L’effet figure de cire
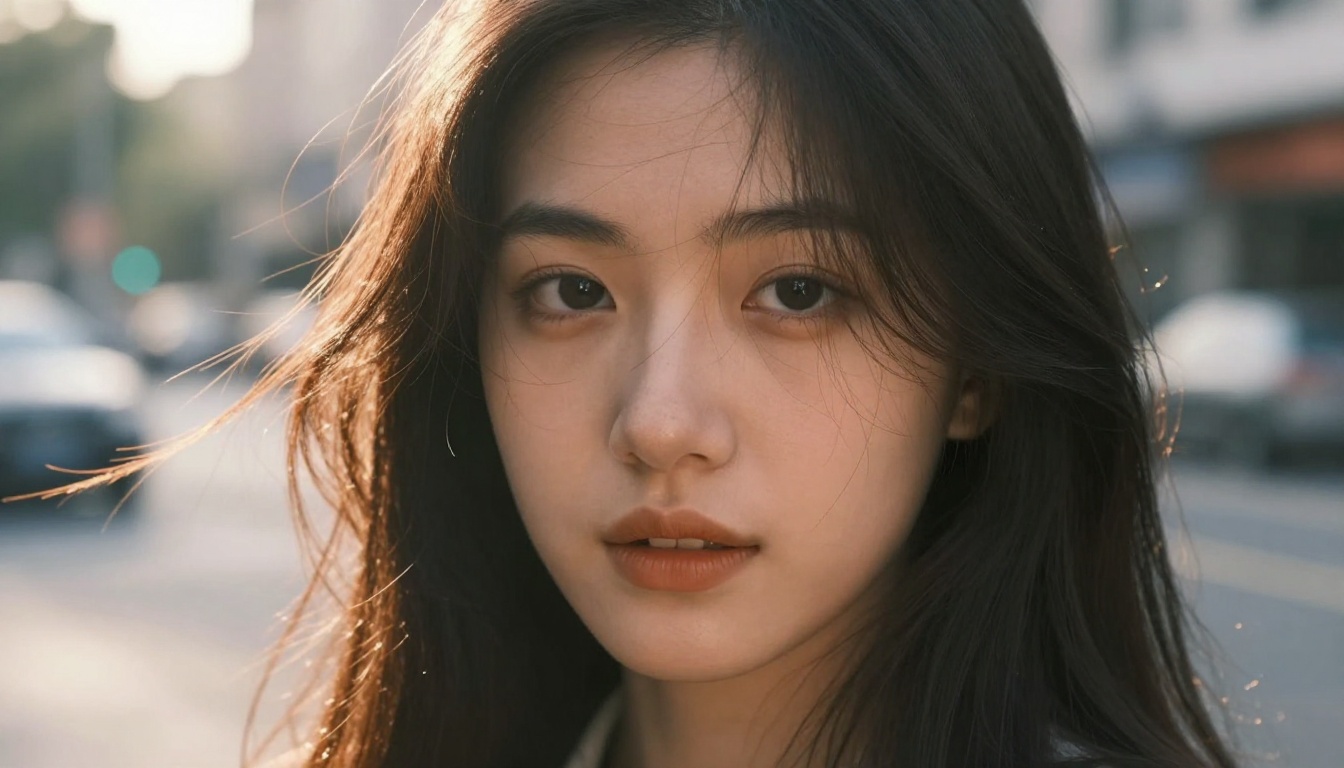
L’effet figure de cire résulte de deux causes qui agissent ensemble :
- Lissage excessif : le modèle moyenne les variations de texture au lieu de préserver les micro-imperfections qui signalent une vraie peau humaine
- Absence de diffusion sous la surface : la vraie peau laisse passer un peu de lumière dans les couches dermiques superficielles, créant une subtile lueur chaude interne. Sans cela, les visages paraissent opaques et plats, comme une surface peinte plutôt qu’un tissu biologique
Le problème est nettement pire en gros plan. Les plans larges et moyens offrent assez de complexité spatiale pour masquer les défauts de surface. Dès que l’on passe au gros plan, chaque faiblesse du rendu de texture devient immédiatement visible et paraît artificielle.
Comment écrire un prompt pour une vraie texture
Ajoutez un vocabulaire explicite de texture à vos prompts. Cela signale au modèle que le détail de surface compte et doit être préservé plutôt qu’adouci.
💡 Ajoutez ces expressions aux prompts en gros plan : « pores de la peau visibles », « variation naturelle de la peau », « duvet facial fin », « effet de diffusion de la lumière sous la surface », « imperfections authentiques de la peau », « sébum et hydratation naturels à la surface de la peau », « rougeur capillaire réaliste »
Pour les cheveux en particulier, décrivez les mèches individuelles plutôt que la forme d’ensemble. « Cheveux bruns foncés avec des reflets naturels captant la lumière, mèches individuelles visibles, léger frisotis à la racine, reflet naturel de sébum sur le sommet du crâne » surpassera systématiquement « cheveux bruns foncés » avec une marge importante. Le modèle a besoin qu’on l’autorise à rendre la complexité plutôt que de se replier sur une représentation simplifiée.
Raison 3 : un mauvais éclairage et des ombres incohérentes
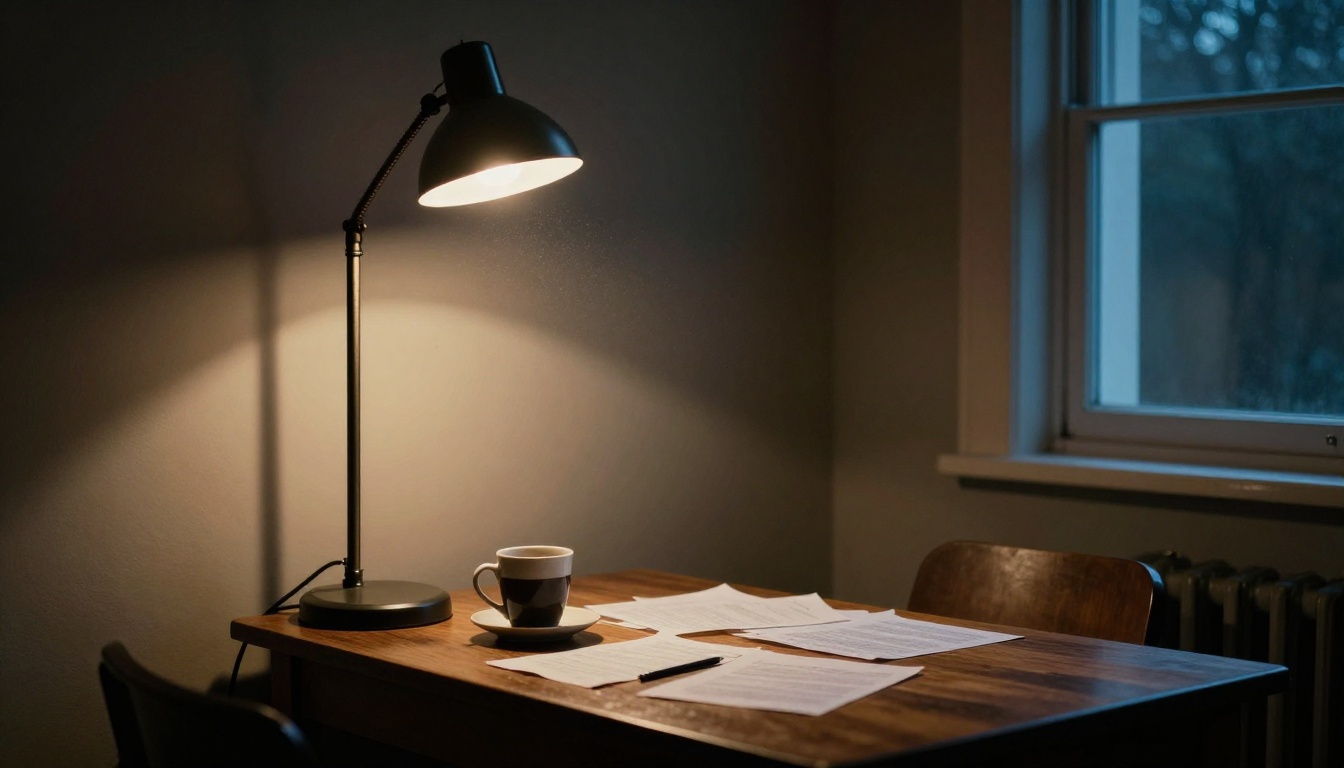
L’éclairage est l’endroit où la vidéo IA échoue d’une façon que la plupart des spectateurs ne peuvent pas identifier consciemment, mais qu’ils ressentent immédiatement. Les ombres tombent dans la mauvaise direction. Un visage est éclairé uniformément de tous les côtés dans une scène qui devrait avoir une lumière directionnelle marquée. Les reflets sur les surfaces ne correspondent pas aux sources lumineuses visibles dans le cadre. Ces incohérences ne crient pas au faux. Elles le murmurent, en continu, pendant toute la durée du clip. Le traitement inconscient de la physique de la lumière est l’un des aspects les plus profondément entraînés de la perception visuelle humaine, et l’IA le casse de manière subtile mais constante.
Pourquoi l’IA se trompe autant sur la lumière
Les modèles d’IA ne disposent d’aucun moteur de simulation lumineuse sous le capot. Ils apprennent l’éclairage uniquement à partir des données d’entraînement, ce qui les amène à développer de fortes préférences pour certains schémas d’éclairage : éclairage de portrait à trois points, lumière extérieure douce de ciel couvert, configurations de studio propres. Ceux-ci sont surreprésentés dans les données d’entraînement parce qu’ils produisent des images agréables et bien exposées.
Dès que vous décrivez un scénario d’éclairage plus inhabituel ou précis, le modèle tend à revenir à ses moyennes confortables. Demandez une lumière latérale dure en milieu de journée et vous obtiendrez souvent une lumière douce et flatteuse. Demandez une seule bougie comme unique source dans la scène et vous obtiendrez fréquemment, là encore, une illumination douce et uniforme, comme si une grande boîte à lumière avait été placée juste à côté de la caméra. Le modèle sait ce que signifie « bougie », mais il revient à ce qu’il a appris à rendre une image belle.
Des prompts d’éclairage par scène qui fonctionnent
La solution consiste à décrire les sources lumineuses de façon physique, et non esthétique. Ne dites pas « éclairage dramatique » ni « atmosphère sombre ». Ce sont des résultats subjectifs, pas des descriptions physiques. Dites plutôt : « source lumineuse unique au tungstène directement au-dessus, projetant de fortes ombres vers le bas, sans lumière ambiante d’autres sources, remplissage d’ombre profond par le bas ».
💡 Structure d’un prompt d’éclairage : [Number and type of light source] + [Position and direction] + [Color temperature in Kelvin] + [Shadow behavior] + [Secondary or fill light if any]
| Rendu recherché | Description physique du prompt |
|---|
| Coucher de soleil chaud | « Soleil à 10 degrés au-dessus de l’horizon à droite, lumière orange-ambre de 2700 K rasant les surfaces sous un angle bas, longues ombres s’étirant vers la gauche, légère brume atmosphérique » |
| Intérieur à la lumière pratique | « Unique ampoule au tungstène au plafond, ambre chaud de 2400 K, ombres dures directement sous tous les objets, légère réflexion ambiante des murs peints en blanc réduisant légèrement la profondeur des ombres » |
| Ciel couvert uniforme | « Ciel nuageux uniforme comme source lumineuse diffuse de 5500 K venant d’en haut, profondeur d’ombre minimale, léger reflet vert de l’herbe sous le sujet » |
| Lumière latérale dramatique | « Grande fenêtre unique à gauche, lumière du jour de 5500 K, fortes ombres horizontales sur le visage et le corps, côté droit dans une obscurité presque totale, aucune lumière de remplissage » |
Raison 4 : scintillement temporel et dérive des images
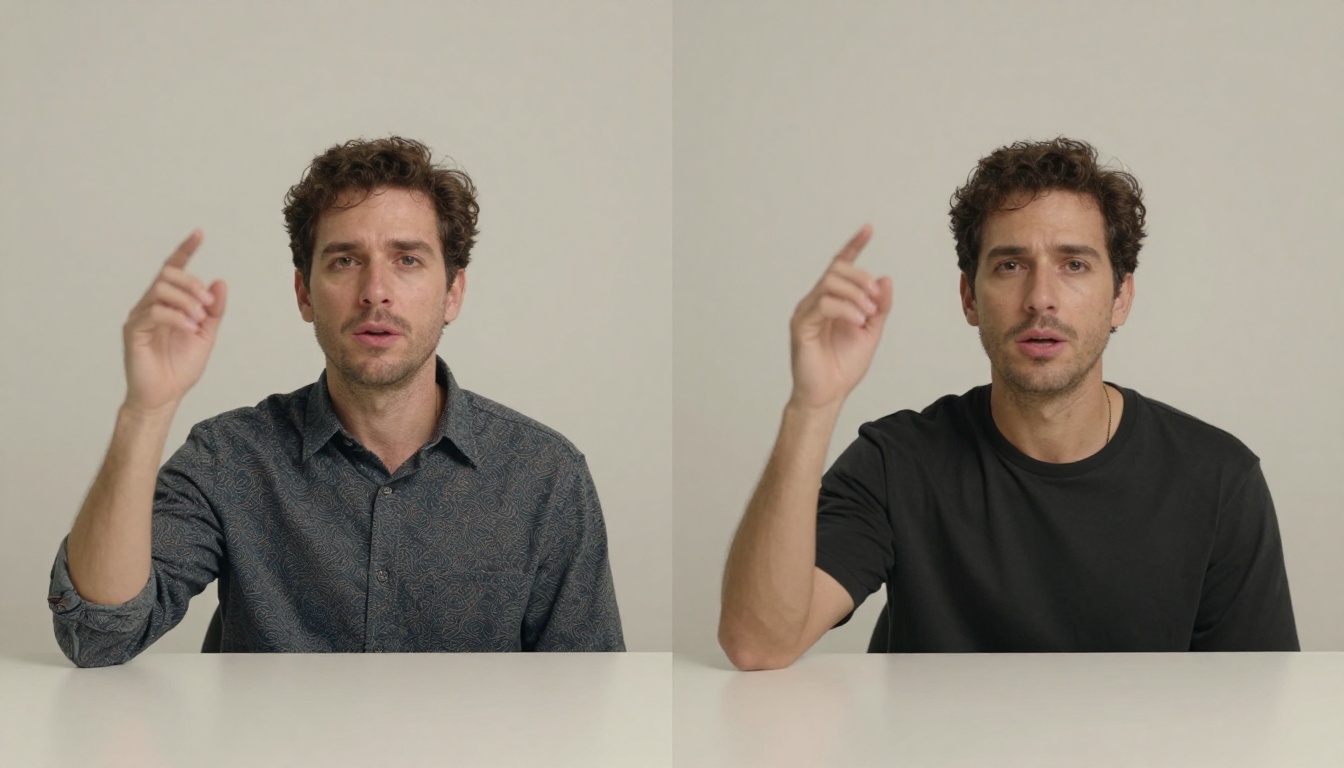
La cohérence temporelle est le problème le moins bien compris, mais souvent le plus nuisible à la qualité perçue. Elle désigne la capacité d’une vidéo à maintenir une cohérence visuelle entre des images successives. Quand elle échoue, on voit du scintillement : la couleur de la peau change subtilement d’une image à l’autre, les détails des cheveux se déplacent légèrement, les éléments de l’arrière-plan ondulent au niveau du pixel. Au mieux, cela ressemble à un artefact de compression. Au pire, cela donne l’impression d’une scène assemblée à partir d’éléments mal assortis.
Ce qui se passe réellement
Les modèles de vidéo génèrent les images avec un certain degré d’indépendance. Ils maintiennent la cohérence grâce à des mécanismes de conditionnement appris, mais ceux-ci ne sont pas parfaits et se dégradent dans certaines conditions. Les détails fins dans les zones visuelles à haute fréquence, en particulier les cheveux, la texture des tissus, les arrière-plans complexes et les visages en mouvement, sont particulièrement sujets à de petites variations d’une image à l’autre. Lues à 24 images par seconde, ces variations créent un effet de scintillement ou de stroboscopie qui signale immédiatement l’artifice.
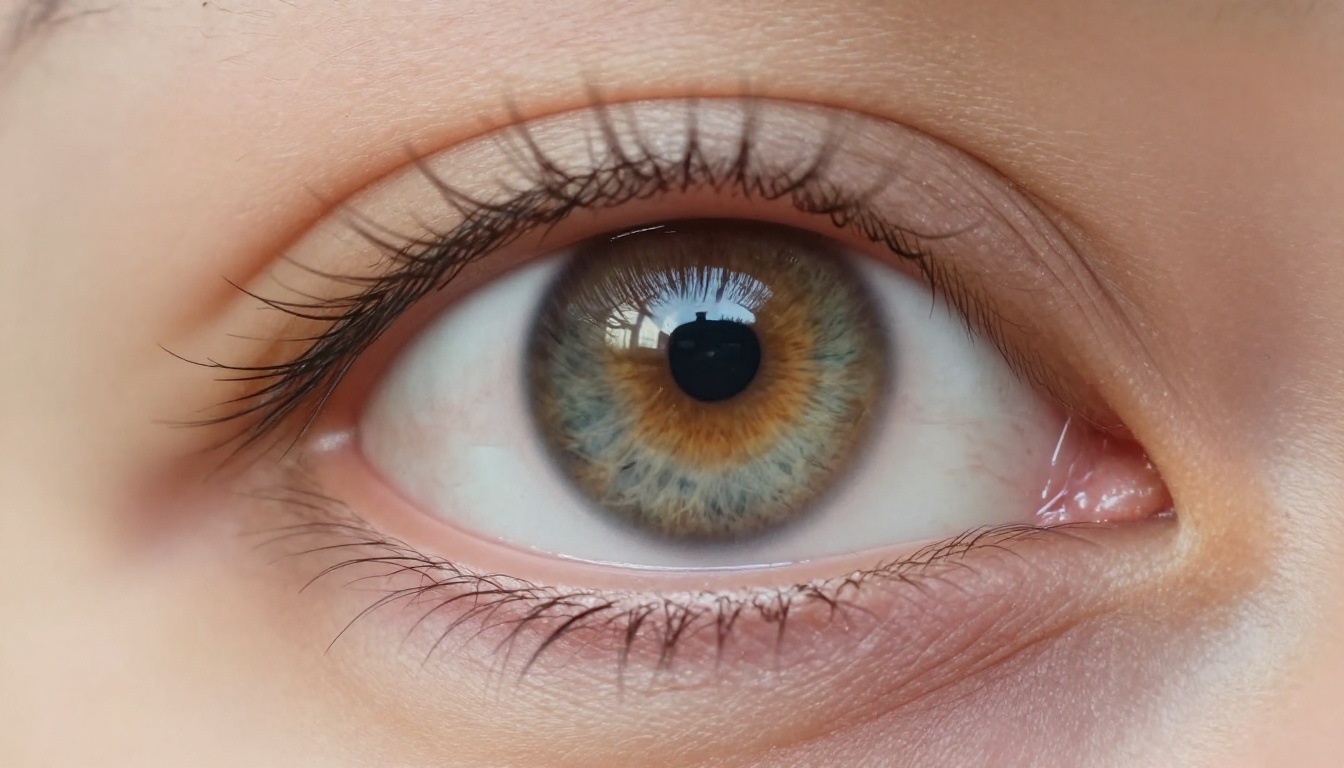
Les yeux sont une zone particulièrement révélatrice du scintillement temporel. Le motif de l’iris, la position du reflet lumineux (catchlight) et la forme précise de la pupille peuvent tous légèrement varier d’une image à l’autre, de façon immédiatement perceptible comme artificielle. C’est en partie pour cela que les personnages IA ont souvent un regard vitreux, légèrement sans vie, même lorsque la géométrie du visage est techniquement exacte. L’œil est l’un des éléments qui attirent le plus l’attention dans une scène, et une instabilité temporelle à cet endroit est presque impossible à ignorer.
Choisir le bon modèle pour la cohérence
Tous les modèles ne gèrent pas la cohérence temporelle de la même façon. Les modèles entraînés sur des cycles d’entraînement plus longs, avec des architectures plus grandes conçues spécifiquement pour un rendu cinématographique, tendent à mieux maintenir la cohérence d’une image à l’autre. Les versions rapides et légères de la plupart des modèles sacrifient la stabilité temporelle pour réduire le temps de calcul et le coût.
💡 Pour la stabilité temporelle, des temps de génération plus longs correspondent généralement à une meilleure cohérence. Si un modèle propose un niveau « fast » et un niveau « pro », le niveau pro gérera en général mieux le scintillement sur les détails fins de surface.
Stratégies de prompt qui améliorent la cohérence temporelle :
- Décrivez un mouvement stable et plus lent plutôt qu’un mouvement rapide et chaotique
- Évitez les scènes comportant beaucoup d’éléments en mouvement indépendant qui se disputent l’attention
- Utilisez des prompts de clip plus longs et plus précis plutôt que des descriptions vagues et ouvertes
- Précisez explicitement le comportement de la caméra (« caméra complètement fixe » ou « lent travelling latéral droit à vitesse constante ») plutôt que de laisser le modèle improviser le mouvement de caméra
Les modèles qui offrent un réalisme véritable
Comprendre les quatre problèmes est utile. Disposer des bons outils pour agir sur cette compréhension est ce qui change réellement vos résultats. Ces modèles produisent systématiquement des résultats présentant moins d’artefacts parmi ceux décrits plus haut, même si les principes de prompt s’appliquent quel que soit le modèle choisi.
Seedance 1.5 Pro pour un rendu cinématographique
Seedance 1.5 Pro de ByteDance est l’un des meilleurs modèles actuels pour les sujets humains photoréalistes. Il intègre la génération audio native, ce qui supprime l’une des étapes d’édition supplémentaires les plus courantes. Son traitement de la texture de la peau et du mouvement des cheveux est nettement meilleur que celui de nombreux concurrents à vitesse équivalente, et il réagit particulièrement bien à une description physique explicite dans les prompts. Plus votre vocabulaire d’éclairage et de texture est précis, plus le résultat respecte ce que vous avez décrit.
Kling v3 pour la qualité du mouvement
Kling v3 Video de Kwai est la référence actuelle pour un mouvement naturel fondé sur la physique. Son comportement des tissus, la locomotion des personnages et les détails de mouvement secondaire, comme des cheveux qui suivent une tête en mouvement au lieu de s’animer indépendamment, comptent parmi les meilleurs disponibles de façon constante. Si les problèmes de mouvement liés à la physique sont votre principale source de frustration, Kling v3 doit être votre premier choix. Combinez-le avec les prompts de mouvement détaillés de la section Raison 1, et les résultats sont fiables et solides. Kling v3 Omni Video va plus loin pour la génération de vidéos à partir de texte en 1080p.
Autres concurrents sérieux
Plusieurs autres modèles offrent des avantages spécifiques selon les cas d’usage :
- Veo 3 : le modèle de Google avec intégration audio native. La cohérence temporelle figure parmi les meilleures disponibles, et il gère particulièrement bien les scènes en extérieur à l’éclairage naturel complexe.
- Wan 2.7 T2V : sortie 1080p excellente et forte fidélité aux prompts. Un outil polyvalent fiable pour les scènes qui privilégient la résolution et les détails fins.
- Hailuo 2.3 : performant pour les compositions cinématographiques à l’éclairage dramatique. Il gère mieux que la plupart des modèles de sa gamme les scénarios d’ombres complexes.
- LTX 2.3 Pro : sortie 4K d’une qualité impressionnante. Lorsque la résolution est la priorité et que le temps de génération n’est pas une contrainte, il offre un détail de surface fin exceptionnel.
- Sora 2 : le modèle d’OpenAI dispose d’une solide modélisation du monde, ce qui signifie qu’il gère la physique plus fiablement par défaut, même avec des prompts moins détaillés. Un bon point de départ pour les utilisateurs qui construisent encore leur pratique du prompt.
- Pixverse v5 : génération rapide en 1080p de bonne qualité. Bien adapté à l’itération rapide lorsque l’on teste plusieurs variantes de prompt avant de lancer une génération complète.
| Modèle | Idéal pour | Sortie |
|---|
| Seedance 1.5 Pro | Humains photoréalistes, texture de la peau et des cheveux | Jusqu’à 1080p avec audio |
| Kling v3 Video | Physique du mouvement, comportement des tissus et des cheveux | Jusqu’à 1080p |
| Veo 3 | Cohérence temporelle, éclairage extérieur | Jusqu’à 1080p avec audio |
| LTX 2.3 Pro | Détail fin, sortie haute résolution | Jusqu’à 4K |
| Wan 2.7 T2V | Qualité polyvalente, fidélité au prompt | Jusqu’à 1080p |
| Sora 2 | Modélisation de la physique du monde, prompt accessible | Jusqu’à 1080p avec audio |
Commencez dès maintenant à créer de meilleures vidéos IA
Les quatre problèmes abordés ici, une physique défaillante, des défauts de texture de surface, des incohérences d’éclairage et le scintillement temporel, ont chacun leurs solutions concrètes que vous pouvez appliquer dès votre prochaine génération. Le fil conducteur de toutes ces solutions est la précision. Des prompts vagues produisent des résultats moyens qui ressemblent à de la vidéo IA moyenne. Des descriptions détaillées et physiquement exactes donnent au modèle les informations nécessaires pour produire des résultats qui résistent à l’examen.
La voie la plus rapide vers l’amélioration consiste à choisir l’un de ces quatre domaines, à appliquer la stratégie de prompt correspondante à votre prochaine génération, puis à comparer directement le résultat à une tentative précédente avec la même scène. La différence est souvent assez nette pour modifier toute votre vision du fonctionnement de ces outils.
Une courte checklist avant de générer :
- Votre prompt décrit-il les forces physiques, le poids et l’élan, et pas seulement l’apparence ?
- Avez-vous précisé la texture de la peau et des surfaces pour les plans rapprochés ?
- Avez-vous décrit vos sources lumineuses comme des objets physiques, avec position, direction et température de couleur ?
- Avez-vous indiqué à la caméra ce qu’elle doit faire, ou l’avez-vous laissée indéfinie ?
Tous les modèles cités dans cet article sont disponibles sur Picasso IA, où vous pouvez les lancer directement depuis votre navigateur, sans configuration locale, installation ni GPU. Si vous vous contentez d’une vidéo IA qui paraît artificielle, les outils et le savoir-faire pour changer cela sont déjà là. La prochaine vidéo que vous générerez n’a pas à paraître fausse.


