आपने वीडियो जनरेट कर लिया। उसे दोबारा देखा। और कुछ... गड़बड़ लगता है। व्यक्ति ऐसे चल रहा है जैसे पानी के अंदर हो। बाल किसी ठोस चीज़ की तरह बर्ताव कर रहे हैं। परछाइयाँ जैसे एक साथ तीन सूरजों से गिर रही हों। AI कंटेंट बनाने में यह सबसे निराश करने वाले अनुभवों में से एक है, और टेक्स्ट-टू-वीडियो टूल्स से शुरुआत करने वाले लगभग हर किसी के साथ ऐसा होता है।
अच्छी ख़बर यह है कि AI वीडियो नकली क्यों लगता है, इसके कारण साफ़ और दोहराए जा सकने वाले हैं, और उन्हें ठीक किया जा सकता है। ऐसे कारण चार हैं, और एक बार आप समझ जाएँ कि असल में गड़बड़ी कहाँ हो रही है, तो आपके आउटपुट की क्वालिटी काफ़ी सुधर जाती है। यह किसी बेहतर मॉडल पर जाने या ज़्यादा क्रेडिट खर्च करने की बात नहीं है। बात यह समझने की है कि ये मॉडल आपसे असल में क्या चाहते हैं।
आज भी ज़्यादातर AI वीडियो अजीब क्यों लगते हैं
ज़्यादातर लोग मान लेते हैं कि समस्या मॉडल में है। वे अपग्रेड करते हैं, कोई दूसरा टूल आज़माते हैं, और लगभग वही नतीजा पाते हैं। समस्या शायद ही कभी मॉडल की होती है। आज का टेक्स्ट-टू-वीडियो AI सचमुच शक्तिशाली है। Kling v3 Video, Seedance 1.5 Pro और Wan 2.7 T2V सही परिस्थितियों में ऐसा फ़ुटेज बना सकते हैं जो असली फ़िल्म से लगभग अलग पहचानना मुश्किल हो। ऊपरी सीमा बहुत ऊँची है। लेकिन ज़्यादातर आउटपुट उस निचले स्तर पर आते हैं जहाँ से ऊपर उठना बाकी है।
AI वीडियो को नकली बनाने वाली समस्याएँ चार लगातार पैटर्न में आती हैं: मोशन फ़िज़िक्स, सतह की बनावट, रोशनी की एकरूपता, और टेम्पोरल स्थिरता। हर एक का एक मूल कारण है। हर एक का एक समाधान है।
अनकैनी वैली असली है
अनकैनी वैली वह मनोवैज्ञानिक असहजता है जो तब पैदा होती है जब कोई चीज़ लगभग इंसान जैसी दिखती है, पर पूरी तरह सही नहीं बैठती। वीडियो में यह असर स्थिर तस्वीरों से ज़्यादा होता है, क्योंकि गति हर छोटी खामी को बढ़ा देती है। हाथ की थोड़ी गलत स्थिति एक फ़्रेम के लिए भी चुभती है। एनिमेशन के 96 फ़्रेमों में वह असहजता देखने में लगभग असह्य हो जाती है। दिमाग़ लगातार विज़ुअल सिग्नल प्रोसेस करता है, और इंसानी व्यवहार से हर विचलन गलत लगता है, भले ही दर्शक यह बता न सके कि ऐसा क्यों लग रहा है।
समस्या मॉडल की नहीं, इनपुट की है
AI वीडियो मॉडल आपके इरादे को नहीं पढ़ते। वे आपके शब्दों को प्रोसेस करते हैं। एक अस्पष्ट प्रॉम्प्ट से अस्पष्ट आउटपुट निकलता है। मॉडल गायब जानकारी को सांख्यिकीय औसत से भर देता है, और इसी वजह से आपको वह सामान्य, खोखली, कृत्रिम रूप से रेंडर की गई क्वालिटी मिलती है। स्पेसिफ़िसिटी आपके पास मौजूद सबसे शक्तिशाली टूल है, और इसकी कोई कीमत नहीं लगती।
कारण 1: टूटी फ़िज़िक्स और अप्राकृतिक मोशन
यह सबसे आम और सबसे साफ़ दिखने वाली समस्या है। कपड़ा जो लटकने के बजाय तैरता है। बाल जो एक कठोर ब्लॉक की तरह हिलते हैं। दौड़ता हुआ किरदार जिसके पैर ज़मीन को कभी ठीक से छूते ही नहीं। ये कोई बेतरतीब गड़बड़ियाँ नहीं हैं; ये इस बात का सीधा नतीजा हैं कि डिफ़्यूज़न-आधारित वीडियो मॉडल कैसे काम करते हैं।
AI मॉडल ट्रेनिंग डेटा के पैटर्न से सीखते हैं। वे समझते हैं कि "एक व्यक्ति चलता है" का नतीजा पैरों की हरकत होना चाहिए। लेकिन वे फ़िज़िक्स को पहले सिद्धांतों से नहीं चलाते। वे उसे सांख्यिकीय रूप से अनुमानित करते हैं। जब यह अनुमान गलत पड़ता है, तो मोशन ऐसा दिखता है जैसे उसे कोई ऐसा व्यक्ति एनिमेट कर रहा हो जिसने चलने के बारे में पढ़ा तो है, पर कभी चला नहीं।
जब गुरुत्वाकर्षण आना भूल जाए
नकली फ़िज़िक्स की सबसे साफ़ पहचान कपड़े और बालों के बर्ताव में होती है। असली कपड़े में वज़न होता है। उसकी बुनावट, घनत्व और कटिंग के हिसाब से गति और गुरुत्वाकर्षण पर अलग-अलग प्रतिक्रिया होती है। भारी ऊनी कोट देर से और काफ़ी वज़न के साथ झूलता है। सिल्क का ब्लाउज़ लगभग हर सूक्ष्म हरकत पर प्रतिक्रिया देता है। AI मॉडल, खासकर अस्पष्ट प्रॉम्प्ट के साथ, कपड़े के एक औसत बर्ताव पर डिफ़ॉल्ट कर जाते हैं, जो किसी भी असली मटीरियल से पूरी तरह मेल नहीं खाता।
बाल तो और भी खराब होते हैं। इन्हें विश्वसनीय रूप से रेंडर करना सबसे कठिन कामों में से है, क्योंकि अलग-अलग बालों का द्रव्यमान लगभग शून्य होता है, पर वे मिलकर जटिल, उभरते मोशन पैटर्न बनाते हैं। "एक महिला दौड़ रही है" का प्रॉम्प्ट दें, और लगभग तय है कि बाल एक चिकने आकार की तरह हिलेंगे, जैसे खोपड़ी से चिपकी ढली हुई प्लास्टिक की कोई चीज़ हो।
सिर्फ़ दिखावट नहीं, मोशन के लिए प्रॉम्प्ट लिखें
💡 यह मत बताइए कि दृश्य कैसा दिखता है। बताइए कि वह भौतिक रूप से कैसा महसूस होता है। द्रव्यमान, मोमेंटम और उस देरी को शामिल करें जो असली दुनिया की हरकत के साथ आती है।
इसकी जगह: "पार्क में चलती लाल ड्रेस में एक महिला"
यह आज़माएँ: "पार्क में धीरे-धीरे चलती बहती सिल्क ड्रेस में एक महिला, हर कदम के साथ कपड़ा हल्के से लहराता हुआ, मोमेंटम से हेम में थोड़ी देरी वाली हरकत, हर स्ट्राइड के बाद सामग्री में असली वज़न दिखता हुआ जब वह बैठता है"
| कमज़ोर मोशन प्रॉम्प्ट | मज़बूत मोशन प्रॉम्प्ट |
|---|
| "एक आदमी दौड़ रहा है" | "एक आदमी मध्यम गति से जॉगिंग करता हुआ, प्राकृतिक हील-से-पंजा स्ट्राइक, धड़ में हल्के घुमाव के साथ झूलते हाथ, हर कदम पर कंधों में हल्का उछाल" |
| "उसके बाल हवा में उड़ रहे हैं" | "बाल बाईं ओर से आती हल्की क्रॉसविंड को पकड़ते हुए, अलग-अलग तार अलग होते और एक-दूसरे पर आते हुए, हवा की दिशा के अचानक बदलने पर प्राकृतिक प्रतिरोध" |
| "झंडा लहरा रहा है" | "मध्यम हवा में झंडा, कपड़ा अटैचमेंट पॉइंट से बाहर की ओर लहराता हुआ, पोल पर तनाव दिखता हुआ, झोंकों के गुजरने पर दोलन की प्राकृतिक आवृत्ति" |
| "पेड़ों से पत्ते गिर रहे हैं" | "पत्ते टहनियों से अलग होकर अनियमित लुढ़कन के साथ नीचे घूमते हुए, हर पत्ता हल्की हवा की धाराओं पर अलग तरह से प्रतिक्रिया करता हुआ, ज़मीन पर अलग-अलग कोणों पर जमा होता हुआ" |
इस एक बदलाव से आउटपुट क्वालिटी में जो फ़र्क आता है, वह अक्सर किसी क्रिएटर द्वारा किया जा सकने वाला सबसे नाटकीय सुधार होता है। प्रॉम्प्ट में भौतिक विवरण लगभग हमेशा कम दिया जाता है, और मॉडल उसे तब इस्तेमाल करने के लिए बने हैं जब वह मौजूद हो।
कारण 2: त्वचा, बाल और बनावट की समस्याएँ
क्लोज़ और मीडियम शॉट्स में AI वीडियो सबसे ज़्यादा बनावट के मामले में धोखा देता है। इस समस्या का उद्योग में एक खास नाम है: वैक्स फ़िगर इफ़ेक्ट। यह वह लुक है जिसमें व्यक्ति की त्वचा चिकनी, हल्की चमकदार और एक समान रोशनी वाली दिखती है, जैसे कोई हाई-क्वालिटी मैनेक्विन हो, न कि इंसान। चेहरे की ज्यामिति बेहतरीन हो सकती है। अनुपात भी सटीक हो सकते हैं। पर सतह गढ़ी हुई लगती है।
असली त्वचा बेहद जटिल होती है। उसमें रोमकूप, बारीक बाल, सूक्ष्म छाया, सबसरफ़ेस लाइट स्कैटरिंग, तेल और नमी में बदलाव, छोटी-छोटी खामियाँ, और रक्त प्रवाह और नीचे की नसों की संरचना के आधार पर रंग में बदलाव होते हैं। AI मॉडल इस सबको एक सांख्यिकीय औसत में समेट देते हैं। नतीजा वह त्वचा है जो तकनीकी रूप से "सही" है, पर ऐसे तरीके से गलत लगती है जिसे ज़्यादातर दर्शक महसूस करेंगे, पर नाम नहीं दे पाएँगे।
वैक्स फ़िगर इफ़ेक्ट
वैक्स फ़िगर इफ़ेक्ट दो जगहों से आता है जो मिलकर काम करती हैं:
- ज़रूरत से ज़्यादा स्मूथिंग: मॉडल बनावट के उतार-चढ़ाव को औसत कर देता है, बजाय इसके कि वह सूक्ष्म खामियाँ बचाए रखे जो असली मानव त्वचा का संकेत देती हैं
- सबसरफ़ेस स्कैटरिंग का न होना: असली त्वचा में रोशनी ऊपरी डर्मल परतों से थोड़ी आर-पार जाती है, जिससे एक सूक्ष्म गर्म आंतरिक चमक बनती है। इसके बिना चेहरे अपारदर्शी और सपाट लगते हैं, जैसे जैविक ऊतक के बजाय रंगी हुई सतह हो
क्लोज़-अप शॉट्स के साथ यह समस्या काफ़ी बढ़ जाती है। वाइड और मीडियम शॉट्स में इतनी स्थानिक जटिलता होती है कि सतह की विफलताएँ छिप जाती हैं। जैसे ही आप क्लोज़-अप में जाते हैं, बनावट रेंडर करने की हर कमज़ोरी तुरंत दिखने लगती है और नकली लगती है।
असली बनावट के लिए प्रॉम्प्ट कैसे लिखें
अपने प्रॉम्प्ट में साफ़ बनावट वाली भाषा जोड़ें। यह मॉडल को संकेत देता है कि सतह का विवरण मायने रखता है और उसे चिकना करने के बजाय बचाकर रखा जाना चाहिए।
💡 क्लोज़-अप प्रॉम्प्ट में ये वाक्यांश जोड़ें: "visible skin pores", "natural skin variation", "fine facial hair", "subsurface light scattering effect", "authentic skin imperfections", "natural oil and moisture on skin surface", "realistic capillary blush"
बालों के लिए खास तौर पर, पूरे आकार के बजाय अलग-अलग तारों का वर्णन करें। "रोशनी को पकड़ते प्राकृतिक हाइलाइट्स वाले गहरे भूरे बाल, अलग-अलग तार दिखते हुए, हेयरलाइन पर हल्का फ़्रिज़, सिर के ऊपरी हिस्से पर प्राकृतिक तेल की चमक" जैसा प्रॉम्प्ट "गहरे भूरे बाल" से काफ़ी ज़्यादा अंतर से बेहतर परिणाम देगा। मॉडल को जटिलता रेंडर करने की अनुमति चाहिए, न कि सरल प्रतिनिधित्व पर डिफ़ॉल्ट करने की।
कारण 3: गलत रोशनी और खराब परछाइयाँ
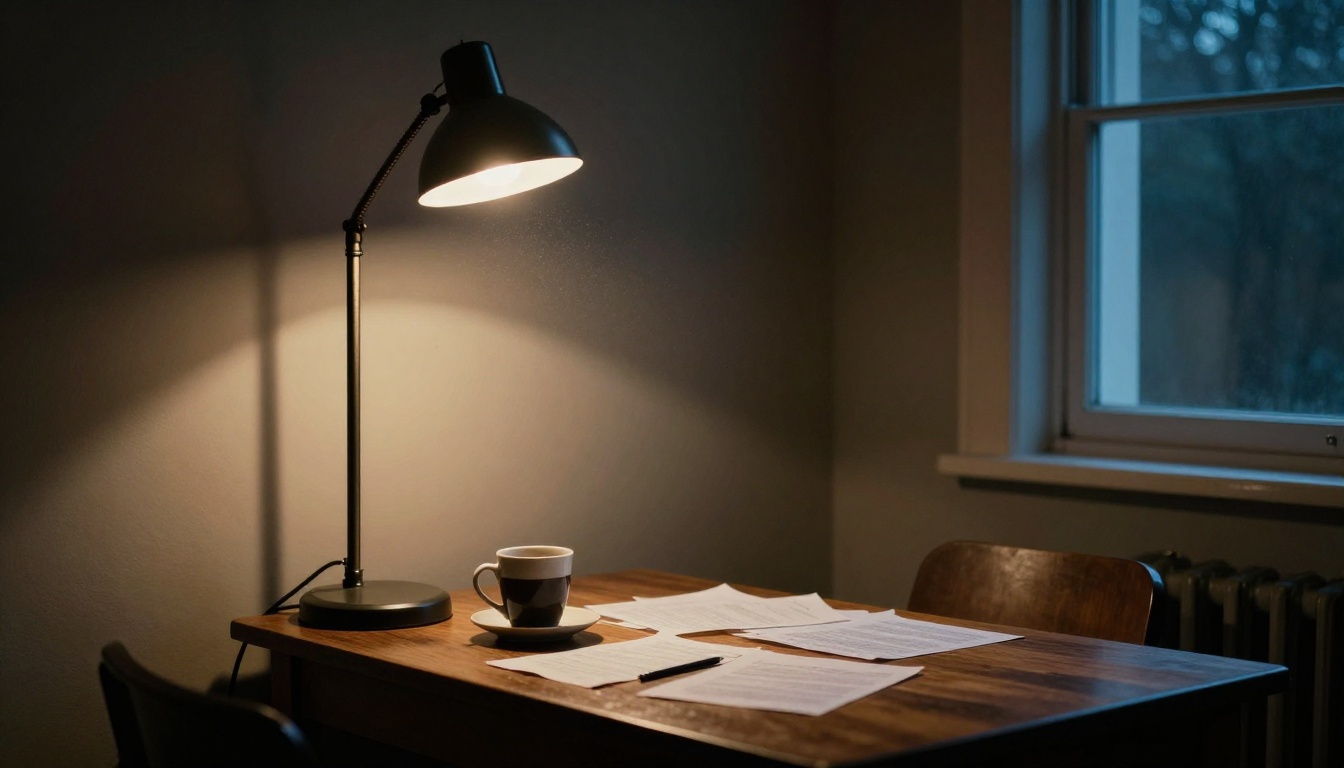
रोशनी वह जगह है जहाँ AI वीडियो ऐसे तरीके से विफल होता है जिसे ज़्यादातर दर्शक सचेत रूप से पहचान नहीं पाते, पर तुरंत महसूस करते हैं। परछाइयाँ गलत दिशा में गिरती हैं। ऐसे दृश्य में जहाँ मज़बूत दिशात्मक रोशनी होनी चाहिए, चेहरा हर तरफ़ से एक समान रोशन होता है। सतहों पर परावर्तन फ़्रेम में दिख रहे रोशनी के स्रोतों से मेल नहीं खाते। ये असंगतियाँ चीखती नहीं कि नकली हैं। ये फुसफुसाती हैं, लगातार, पूरे क्लिप की अवधि तक। रोशनी की भौतिकी की अवचेतन प्रोसेसिंग इंसानी विज़ुअल परसेप्शन के सबसे गहराई से प्रशिक्षित पहलुओं में से एक है, और AI इसे सूक्ष्म पर लगातार तरीकों से तोड़ देता है।
AI रोशनी को इतना गलत क्यों समझता है
AI मॉडल के भीतर कोई लाइट सिमुलेशन इंजन नहीं चलता। वे रोशनी पूरी तरह ट्रेनिंग डेटा से सीखते हैं, जिसका मतलब है कि वे कुछ खास रोशनी पैटर्न की ओर मज़बूत झुकाव विकसित करते हैं: थ्री-पॉइंट पोर्ट्रेट लाइटिंग, नरम बादलदार बाहरी रोशनी, साफ़ स्टूडियो सेटअप। ये ट्रेनिंग डेटा में ज़रूरत से ज़्यादा दिखते हैं, क्योंकि ये सुखद, अच्छी तरह एक्सपोज़ की गई इमेज बनाते हैं।
जैसे ही आप किसी ज़्यादा असामान्य या खास रोशनी परिदृश्य का वर्णन करते हैं, मॉडल अपने आरामदायक औसत की ओर लौट जाता है। तेज़ दोपहर की साइडलाइट माँगें, तो अक्सर नरम, आकर्षक रोशनी मिलती है। दृश्य में एकमात्र स्रोत के रूप में एक मोमबत्ती माँगें, तो अक्सर भी नरम, एक समान रोशनी मिलती है, मानो कैमरे के बगल में कोई बड़ा सॉफ़्टबॉक्स लगा हो। मॉडल जानता है कि "candle" का मतलब क्या है, पर वह उसी पर डिफ़ॉल्ट करता है जिसे उसने सीखा है कि इमेज को अच्छा दिखाता है।
काम करने वाले दृश्य-आधारित रोशनी प्रॉम्प्ट
समाधान यह है कि रोशन स्रोतों का वर्णन भौतिक रूप से करें, सौंदर्यात्मक रूप से नहीं। "नाटकीय रोशनी" या "मूडी माहौल" मत कहें। ये व्यक्तिपरक नतीजे हैं, भौतिक वर्णन नहीं। कहें: "ऊपर सीधे एक ही ट्रंगस्टन प्रैक्टिकल लाइट स्रोत, जो मज़बूत नीचे की ओर परछाइयाँ डाले, कहीं और से कोई एम्बिएंट फ़िल नहीं, नीचे से गहरी छाया भराव।"
💡 रोशनी प्रॉम्प्ट का ढाँचा: [Number and type of light source] + [Position and direction] + [Color temperature in Kelvin] + [Shadow behavior] + [Secondary or fill light if any]
| वांछित लुक | भौतिक प्रॉम्प्ट वर्णन |
|---|
| गर्म सूर्यास्त | "क्षितिज से 10 डिग्री ऊपर दाईं ओर सूरज, 2700K नारंगी-अंबर रोशनी कम कोण पर सतहों पर फैलती हुई, बाईं ओर फैली लंबी परछाइयाँ, हल्का वायुमंडलीय धुंध" |
| प्रैक्टिकल इनडोर | "एक ऊपरी ट्रंगस्टन बल्ब, 2400K गर्म अंबर, सभी वस्तुओं के ठीक नीचे कठोर परछाइयाँ, सफ़ेद पुती दीवारों से हल्की एम्बिएंट बाउंस जो परछाई की गहराई थोड़ी कम करती है" |
| सपाट बादलदार | "ऊपर से एक समान बादलदार आसमान, 5500K फैला हुआ प्रकाश स्रोत, न्यूनतम छाया गहराई, सब्जेक्ट के नीचे घास से हरे रंग की परावर्तित हल्की फ़िल" |
| नाटकीय साइडलाइट | "बाईं ओर एक बड़ी खिड़की, 5500K डेलाइट, चेहरे और शरीर पर मज़बूत क्षैतिज परछाइयाँ, दाहिनी ओर लगभग पूरी छाया, कोई फ़िल लाइट नहीं" |
कारण 4: टेम्पोरल फ़्लिकरिंग और फ़्रेम ड्रिफ़्ट
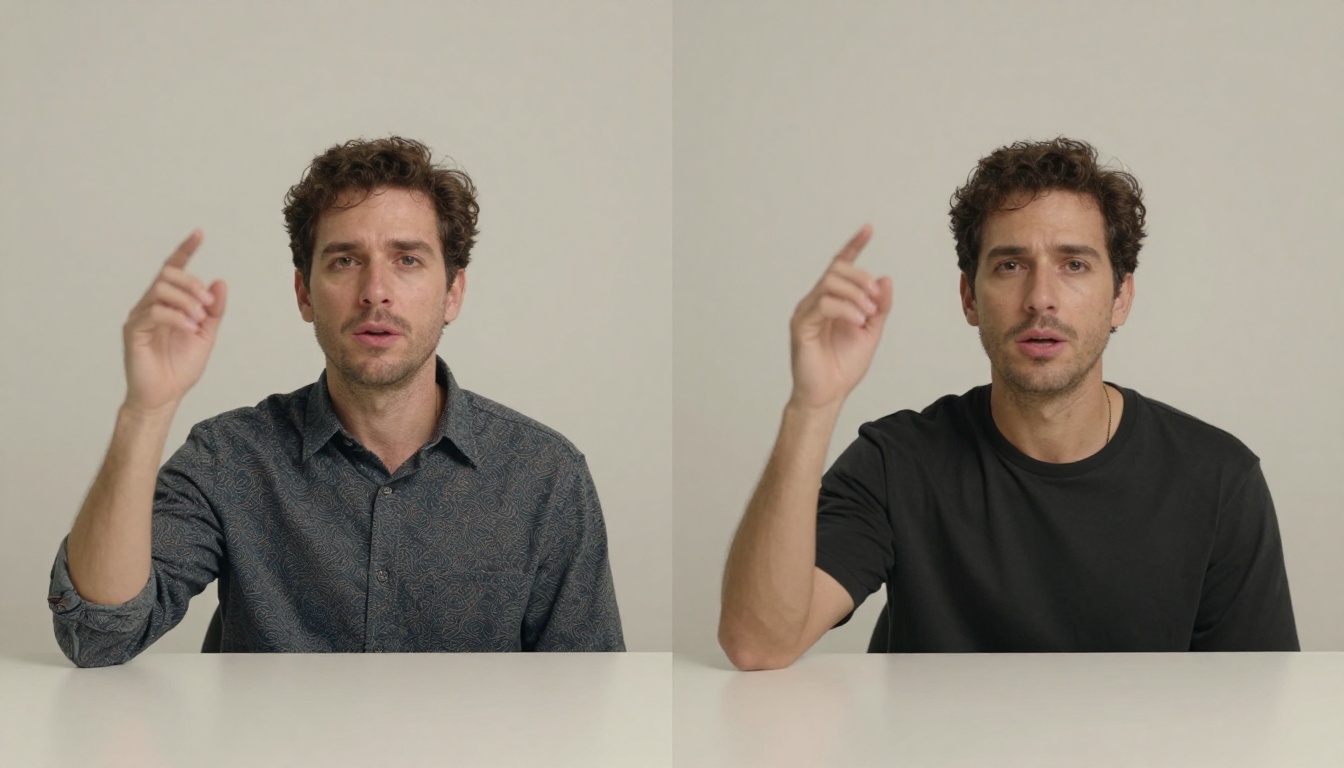
टेम्पोरल स्थिरता सबसे कम समझी गई समस्या है, पर अक्सर समझी गई गुणवत्ता को सबसे ज़्यादा नुकसान पहुँचाती है। यह किसी वीडियो की लगातार फ़्रेमों के बीच विज़ुअल सुसंगति बनाए रखने की क्षमता को दर्शाती है। जब यह विफल होती है, तो फ़्लिकरिंग दिखती है: फ़्रेमों के बीच त्वचा का रंग सूक्ष्म रूप से बदलता है, बालों के विवरण थोड़े स्थान बदलते हैं, पृष्ठभूमि के तत्व पिक्सेल स्तर पर लहराते हैं। सबसे अच्छे में यह कंप्रेशन आर्टिफ़ैक्ट जैसा लगता है। सबसे बुरे में यह ऐसे दृश्य जैसा लगता है जिसे बेमेल तत्वों से जोड़कर बनाया गया हो।
असल में क्या हो रहा है
वीडियो मॉडल फ़्रेम कुछ हद तक स्वतंत्र रूप से जनरेट करते हैं। वे लर्न्ड कंडीशनिंग मैकेनिज़्म के ज़रिए सुसंगति बनाए रखते हैं, पर ये परफ़ेक्ट नहीं हैं, और कुछ परिस्थितियों में ये कमज़ोर पड़ जाते हैं। हाई-फ़्रीक्वेंसी विज़ुअल क्षेत्रों के बारीक विवरण, खासकर बाल, फ़ैब्रिक टेक्सचर, जटिल पृष्ठभूमि और गति में चेहरे, फ़्रेमों के बीच छोटे बदलावों के प्रति खास तौर पर संवेदनशील होते हैं। 24 फ़्रेम प्रति सेकंड पर चलाने पर ये बदलाव झिलमिलाहट या स्ट्रोबिंग प्रभाव पैदा करते हैं, जो तुरंत नकली लगता है।
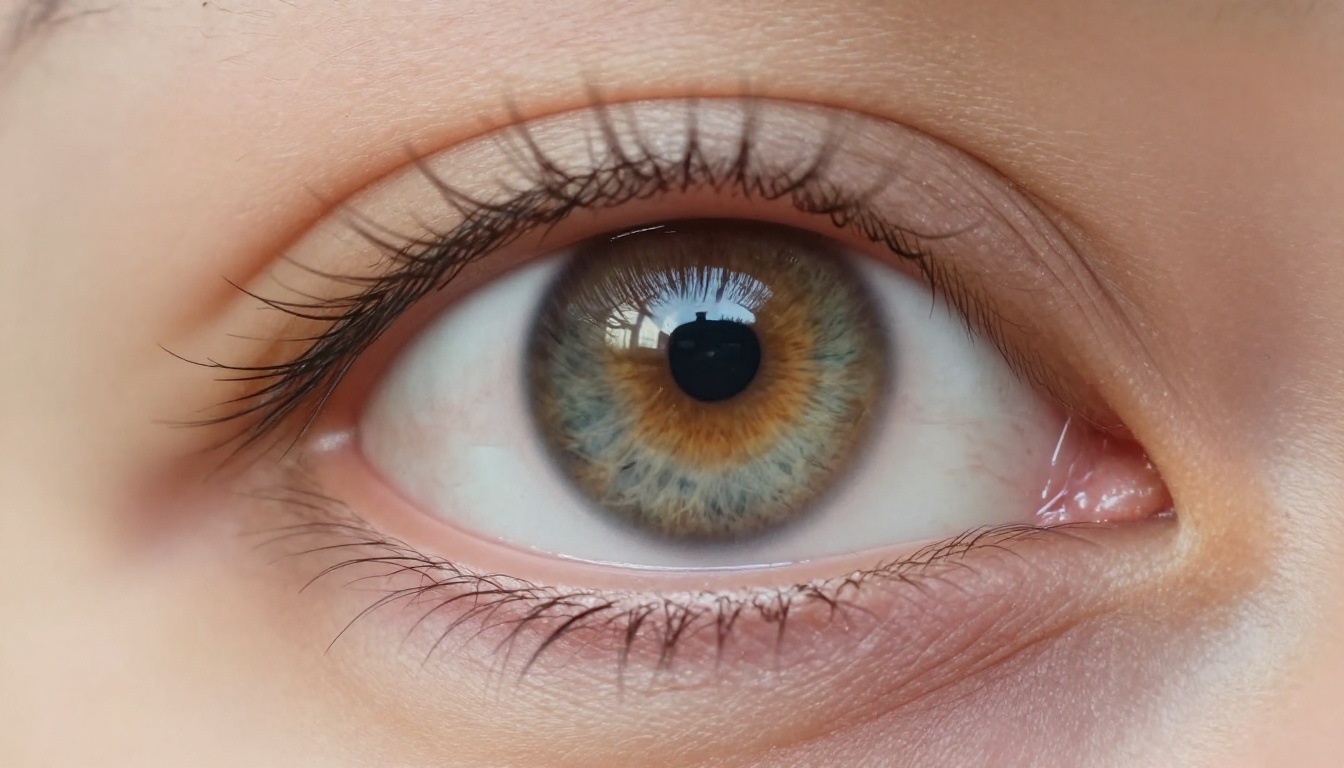
टेम्पोरल फ़्लिकरिंग के लिए आँखें खास तौर पर उजागर करने वाला क्षेत्र हैं। आइरिस पैटर्न, कैचलाइट की स्थिति और पुतली का सटीक आकार, ये सब फ़्रेमों के बीच थोड़े बदल सकते हैं, और ऐसे तरीकों से जो तुरंत नकली लगते हैं। इसी वजह से AI किरदारों की नज़र अक्सर कांच जैसी, थोड़ी बेजान लगती है, भले ही चेहरे की ज्यामिति तकनीकी रूप से सटीक हो। आँख किसी भी दृश्य की सबसे ज़्यादा ध्यान खींचने वाली विशेषताओं में से एक है, और वहाँ टेम्पोरल अस्थिरता को नज़रअंदाज़ करना लगभग असंभव है।
सुसंगति के लिए सही मॉडल चुनना
सभी मॉडल टेम्पोरल स्थिरता को बराबर तरीके से नहीं संभालते। लंबे ट्रेनिंग रन और सिनेमैटिक आउटपुट के लिए खास तौर पर बनाए गए बड़े आर्किटेक्चर वाले मॉडल फ़्रेम-दर-फ़्रेम सुसंगति बनाए रखने में काफ़ी बेहतर होते हैं। ज़्यादातर मॉडल के फ़ास्ट और लाइट वर्ज़न गणना समय और लागत घटाने के लिए टेम्पोरल स्थिरता से समझौता करते हैं।
💡 टेम्पोरल स्थिरता के लिए, लंबा जनरेशन समय आमतौर पर बेहतर सुसंगति से जुड़ा होता है। अगर किसी मॉडल में "fast" और "pro" टियर हों, तो pro टियर आमतौर पर बारीक सतह विवरण पर फ़्लिकरिंग को बेहतर संभालता है।
टेम्पोरल सुसंगति सुधारने वाली प्रॉम्प्ट रणनीतियाँ:
- तेज़, अराजक गति के बजाय स्थिर, धीमी गति का वर्णन करें
- ऐसे दृश्यों से बचें जिनमें कई स्वतंत्र रूप से चलते तत्व ध्यान के लिए होड़ करें
- अस्पष्ट, खुले वर्णनों के बजाय लंबे, ज़्यादा विशिष्ट क्लिप प्रॉम्प्ट का उपयोग करें
- कैमरे के व्यवहार को साफ़ तौर पर बताएँ ("camera completely static" या "slow smooth dolly right at constant speed"), ताकि मॉडल कैमरा मूवमेंट खुद न गढ़े
वे मॉडल जो सच में यथार्थवाद देते हैं
चार समस्याओं को समझना उपयोगी है। उस समझ पर अमल करने के लिए सही टूल होना वही चीज़ है जो असल में आपका आउटपुट बदलती है। ये मॉडल ऊपर बताए गए आर्टिफ़ैक्ट्स कम दिखाने वाले नतीजे लगातार देते हैं, हालाँकि आप जो भी मॉडल चुनें, प्रॉम्प्ट के सिद्धांत लागू रहते हैं।
सिनेमैटिक आउटपुट के लिए Seedance 1.5 Pro
ByteDance का Seedance 1.5 Pro फ़ोटोरियलिस्टिक इंसानी सब्जेक्ट्स के लिए मौजूदा सबसे मज़बूत प्रदर्शनकारियों में से एक है। इसमें नेटिव ऑडियो जनरेशन शामिल है, जो सबसे आम अतिरिक्त एडिटिंग चरणों में से एक को खत्म कर देता है। त्वचा की बनावट और बालों की गति को संभालना उसी स्पीड टियर के कई प्रतिस्पर्धियों से उल्लेखनीय रूप से बेहतर है, और यह प्रॉम्प्ट में साफ़ भौतिक वर्णन पर खास तौर पर अच्छी प्रतिक्रिया देता है। आपकी रोशनी और बनावट की भाषा जितनी स्पेसिफ़िक होगी, आउटपुट उतना ही बेहतर उसी के अनुरूप होगा जो आपने बताया।
मोशन क्वालिटी के लिए Kling v3
Kwai का Kling v3 Video प्राकृतिक मोशन फ़िज़िक्स के लिए मौजूदा मानक तय करने वाला मॉडल है। इसका कपड़े का बर्ताव, किरदार की चाल और सेकंडरी मोशन के विवरण, जैसे सिर के हिलने पर बालों का उसके साथ चलना बजाय स्वतंत्र रूप से एनिमेट होने के, लगातार उपलब्ध सबसे अच्छे में से हैं। अगर फ़िज़िक्स-आधारित मोशन समस्याएँ आपकी मुख्य परेशानी हैं, तो Kling v3 आपकी पहली पसंद होना चाहिए। इसे कारण 1 खंड के विस्तृत मोशन प्रॉम्प्ट के साथ मिलाएँ, और नतीजे भरोसेमंद रूप से मज़बूत होते हैं। Kling v3 Omni Video 1080p पर टेक्स्ट-टू-वीडियो के लिए इसे और आगे ले जाता है।
अन्य मज़बूत विकल्प
कुछ और मॉडल खास उपयोग मामलों के लिए अलग फ़ायदे देते हैं:
- Veo 3: Google का मॉडल, जिसमें नेटिव ऑडियो इंटीग्रेशन है। टेम्पोरल सुसंगति मौजूदा सबसे अच्छों में से है, और यह जटिल प्राकृतिक रोशनी वाले बाहरी दृश्यों को खास तौर पर अच्छी तरह संभालता है।
- Wan 2.7 T2V: 1080p पर उत्कृष्ट आउटपुट और मज़बूत प्रॉम्प्ट अनुपालन। उन दृश्यों के लिए भरोसेमंद ऑल-राउंडर जो रिज़ॉल्यूशन और बारीक विवरण को प्राथमिकता देते हैं।
- Hailuo 2.3: नाटकीय रोशनी वाली सिनेमैटिक कंपोज़िशन के लिए मज़बूत। अपने टियर के अधिकांश मॉडल से बेहतर तरीके से जटिल परछाई वाले दृश्यों को संभालता है।
- LTX 2.3 Pro: प्रभावशाली क्वालिटी स्तरों पर 4K आउटपुट। जब रिज़ॉल्यूशन प्राथमिकता हो और जनरेशन समय बाधा न हो, तो यह असाधारण बारीक सतह विवरण देता है।
- Sora 2: OpenAI के मॉडल में मज़बूत वर्ल्ड मॉडलिंग है, यानी यह कम विस्तृत प्रॉम्प्ट के साथ भी डिफ़ॉल्ट रूप से फ़िज़िक्स को अधिक भरोसेमंद ढंग से संभालता है। अपना प्रॉम्प्टिंग अभ्यास बना रहे उपयोगकर्ताओं के लिए अच्छा शुरुआती बिंदु।
- Pixverse v5: ठोस 1080p क्वालिटी पर तेज़ जनरेशन। पूरी जनरेशन पर लगाने से पहले कई प्रॉम्प्ट विविधताएँ परखते समय तेज़ इटरेशन के लिए उपयुक्त।
| मॉडल | सबसे अच्छा किसके लिए | आउटपुट |
|---|
| Seedance 1.5 Pro | फ़ोटोरियलिस्टिक इंसान, त्वचा और बालों की बनावट | 1080p तक ऑडियो के साथ |
| Kling v3 Video | मोशन फ़िज़िक्स, कपड़े और बालों का बर्ताव | 1080p तक |
| Veo 3 | टेम्पोरल सुसंगति, बाहरी रोशनी | 1080p तक ऑडियो के साथ |
| LTX 2.3 Pro | बारीक विवरण, उच्च रिज़ॉल्यूशन आउटपुट | 4K तक |
| Wan 2.7 T2V | सर्व-उद्देशीय क्वालिटी, प्रॉम्प्ट फ़िडेलिटी | 1080p तक |
| Sora 2 | वर्ल्ड फ़िज़िक्स मॉडलिंग, सरल प्रॉम्प्टिंग | ऑडियो के साथ 1080p तक |
आज ही बेहतर AI वीडियो बनाना शुरू करें
यहाँ बताई गई चार समस्याएँ, यानी टूटी फ़िज़िक्स, सतह की बनावट की विफलताएँ, रोशनी की असंगतियाँ और टेम्पोरल फ़्लिकरिंग, हर एक के व्यावहारिक समाधान हैं, जिन्हें आप अपनी अगली जनरेशन पर लागू कर सकते हैं। इन सबमें एक समान धागा है स्पेसिफ़िसिटी। अस्पष्ट प्रॉम्प्ट औसत आउटपुट देते हैं जो औसत AI वीडियो जैसे दिखते हैं। विस्तृत, भौतिक रूप से सटीक वर्णन मॉडल को वह जानकारी देते हैं जिसकी उसे ऐसे नतीजे बनाने के लिए ज़रूरत है जो जाँच में टिक सकें।
सुधार का सबसे तेज़ रास्ता यह है कि इन चार में से एक क्षेत्र चुनें, अपनी अगली जनरेशन पर उसकी संबंधित प्रॉम्प्ट रणनीति लागू करें, और उसी दृश्य के पिछले प्रयास के आउटपुट से सीधे तुलना करें। अंतर अक्सर इतना बड़ा होता है कि इन टूल्स के काम करने के तरीके के बारे में आपका पूरा मानसिक मॉडल बदल जाए।
जनरेट करने से पहले एक त्वरित चेकलिस्ट:
- क्या आपका प्रॉम्प्ट केवल दिखावट नहीं, बल्कि भौतिक बलों, वज़न और मोमेंटम का वर्णन करता है?
- क्या आपने किसी भी क्लोज़-अप शॉट के लिए त्वचा और सतह की बनावट साफ़ तौर पर बताई है?
- क्या आपने रोशन स्रोतों का वर्णन स्थिति, दिशा और रंग तापमान वाली भौतिक वस्तुओं के रूप में किया है?
- क्या आपने कैमरे को बताया है कि उसे क्या करना है, या उसे अपरिभाषित छोड़ा है?
इस लेख में उल्लिखित सभी मॉडल Picasso IA पर उपलब्ध हैं, जहाँ आप उन्हें बिना किसी लोकल सेटअप, इंस्टॉलेशन या GPU आवश्यकता के सीधे अपने ब्राउज़र से चला सकते हैं। अगर आप अब तक नकली दिखने वाले AI वीडियो से समझौता करते आए हैं, तो उसे बदलने के टूल और ज्ञान दोनों यहीं मौजूद हैं। आपका अगला वीडियो नकली दिखने की ज़रूरत नहीं।


