La sincronización labial con IA por fin ha alcanzado el nivel de calidad que exige la producción de video profesional. Lo que empezó como un truco de salón capaz de producir resultados aguados y ligeramente desfasados se ha convertido en un conjunto de herramientas que resisten en pantallas de televisión, en las redes sociales y en las plataformas de streaming. Si trabajas con video de cualquier forma, esta tecnología merece tu atención ahora mismo.
La distancia entre lo que antes requería un estudio de doblaje completo y lo que un solo creador puede lograr desde un equipo portátil se ha reducido muchísimo en los últimos dos años. Este artículo explica qué es realmente la sincronización labial con IA, dónde encaja en los flujos de producción reales, cómo conseguir resultados que parezcan convincentes y qué modelos de PicassoIA ofrecen hoy los mejores resultados.
Qué es realmente la sincronización labial con IA
En esencia, la sincronización labial con IA consiste en usar inteligencia artificial para ajustar automáticamente los movimientos de la boca de una persona a una pista de audio. Le das al modelo un video y un archivo de audio nuevo, y el modelo redibuja los labios del sujeto para que coincidan con el habla de la nueva grabación. Sin rodajes repetidos, sin estudio de doblaje y sin rotoscopia fotograma a fotograma.
La tecnología funciona analizando el audio de entrada a nivel de fonema, descomponiendo el habla en sus unidades de sonido individuales, y luego usa esos datos para predecir y generar las formas correctas de los labios, las posiciones de la mandíbula y los sutiles movimientos de los músculos faciales para cada sonido. Los modelos modernos basados en difusión conservan detalles finos como los dientes, las barbas, las pecas y la textura natural de la piel, que los sistemas anteriores basados en regresión difuminaban o perdían.
Cómo lee el modelo tu audio
El modelo primero extrae las secuencias de fonemas de tu audio y construye un mapa con marcas de tiempo de cada sonido de la grabación. Después asigna esos fonemas a las formas de visemas, los equivalentes visuales de los fonemas que determinan cómo se ve la boca al pronunciar cada sonido. Los modelos más avanzados usan un proceso de difusión para regenerar la zona de la boca fotograma a fotograma, de modo que el resultado se integre sin fisuras con las partes del rostro y el fondo que no cambian.
En qué se diferencia de los deepfakes
Es un malentendido habitual que conviene aclarar. La sincronización labial con IA no es un intercambio de rostros ni un reemplazo de identidad. Trabaja con imágenes existentes de una persona real y ajusta solo la zona de la boca para que coincida con el nuevo audio. La identidad del sujeto, la iluminación, el cabello, la ropa y el entorno permanecen intactos. Usada de forma responsable, la tecnología es una herramienta de producción, no un método de engaño.
Dónde encaja la IA de sincronización labial en los flujos de trabajo actuales
Los casos de uso de la sincronización labial con IA han ido mucho más allá de los obvios. Los creadores la aplican en un abanico sorprendentemente amplio de escenarios de producción, y los resultados son cada vez más indistinguibles de la grabación original.
Correcciones de diálogo en postproducción
Los cambios de guion, las tomas falladas y las revisiones de última hora del cliente ya no tienen por qué suponer volver al set. Una nueva grabación de audio más un modelo de sincronización labial convierte lo que antes era un rodaje de medio día en una tarea de 10 minutos en postproducción.
Traducción de video a escala global
Aquí es donde la sincronización labial con IA muestra su potencial más espectacular. Grabas tu video una vez en tu idioma nativo, traduces la voz en off, la pasas por un modelo de sincronización labial, y tu contenido ya funciona en un mercado nuevo, con movimientos de boca que coinciden con el audio traducido. Sin nuevo presentador, sin nuevo rodaje y sin renunciar a la calidad de producción.
Avatares de IA y contenido con portavoces
Las marcas que operan a gran escala están construyendo flujos de trabajo completos con portavoces basados en avatares de IA. Grabas una vez, clonas la voz y generas el video. El Avatar IV de HeyGen ha convertido esto en un proceso listo para producción que se sostiene en contextos corporativos y de e-learning sin volver nunca al set.
5 razones para incluirla en tu flujo de trabajo
El argumento a favor de la sincronización labial con IA no es solo una cuestión de comodidad. Cambia lo que realmente se puede lograr dentro de un presupuesto y un plazo determinados. Estas son las razones por las que debería estar en cualquier caja de herramientas de producción de video seria.
Ciclos de producción más rápidos
Lo que antes significaba programar rodajes repetidos o reservar estudio ahora puede resolverse por completo en postproducción. Los cambios de guion, las repeticiones de tomas y las ediciones de última hora se resuelven en minutos en lugar de días. Para agencias y freelancers con plazos ajustados, eso por sí solo cambia la cuenta de qué proyectos merece la pena aceptar.
Menor costo por video
Menos rodajes repetidos significan menos gasto en talento, equipo técnico, localizaciones y equipamiento. Para los productores de gran volumen que generan videos corporativos, módulos de e-learning o contenido para redes sociales, esos ahorros se acumulan rápido. Una sola suscripción a una plataforma sustituye varios días de estudio a lo largo de un año.
Más libertad en el montaje
Cuando corregir una frase ya no implica mandar de vuelta a todo el equipo al set, puedes experimentar más en el montaje sin el miedo a repeticiones caras. Cambia una llamada a la acción, ajusta el nombre de un producto, corrige una mala pronunciación y sigue adelante.
Pruebas A/B sin nuevos rodajes
¿Quieres probar dos ganchos o llamadas a la acción distintos? Graba dos versiones de audio y pásalas ambas por un modelo de sincronización labial. Así tendrás dos versiones de video completas y perfectamente sincronizadas para hacer pruebas A/B, producidas a una fracción del costo de dos rodajes independientes.
Llegar a nuevos mercados rápidamente
La localización solía ser un proyecto. Ahora es un paso de postproducción. Traduces la voz en off, sincronizas los labios y publicas para una audiencia nueva. Con herramientas como Video Translate de HeyGen, que admite más de 150 idiomas, la barrera para la distribución global casi ha desaparecido.
6 prácticas que de verdad mejoran tus resultados
Las herramientas han avanzado mucho, pero tu resultado solo es tan bueno como lo que le pongas. Sigue estas prácticas y obtendrás resultados que se sostienen en pantalla.
💡 Consejo rápido: Los dos factores que más importan para la calidad de la sincronización labial son la claridad del audio y el ángulo de la cámara. Acierta con ambos y la mayoría de los modelos se encargarán del resto.
Primero, audio limpio
El ruido de fondo, los niveles irregulares o la compresión excesiva confunden al modelo y producen una sincronización descuidada. Usa siempre un archivo de audio bien grabado y procesado: idealmente una voz seca, sin música ni ambiente integrados. Una grabación de voz limpia con un micrófono de condensador de calidad es lo más eficaz que puedes hacer para mejorar tus resultados.
Graba mirando a la cámara
Los ángulos de frente o de tres cuartos leves son los que mejor funcionan. Los perfiles laterales marcados, las manos que tapan la boca o los rostros parcialmente fuera de encuadre limitarán lo que la IA puede hacer con la zona de la boca. Si sabes que vas a sincronizar labios en postproducción, tenlo en cuenta desde el diseño del plano.
Empieza con material de calidad
La baja resolución, los artefactos de compresión intensos o las imágenes temblorosas dificultan mucho que la IA siga y regenere con precisión la zona del rostro. Apunta a un mínimo de 1080p, un códec limpio con una tasa de bits alta y una cámara estable. Mejores datos de entrada producen mejores resultados, sin excepción.
Mantén una entrega natural
Tanto el material original como el audio de reemplazo deben tener una interpretación natural y medida. El habla rápida, las expresiones exageradas o los acentos marcados pueden empujar a algunos modelos hacia artefactos visibles. Ajusta la energía y el ritmo del audio de reemplazo al ritmo de la interpretación original para lograr el resultado más convincente.
La sincronización no arregla una mala interpretación
La sincronización labial ajusta los movimientos de la boca. No corrige una entrega plana, una presencia en pantalla pobre ni un guion que no funciona. Si la interpretación no funciona, es un problema completamente distinto, y ningún modelo de IA lo resolverá en postproducción.
Revisa a resolución completa
Revisa siempre tu resultado a resolución completa antes de darlo por bueno. Los casos límite, como las gafas, las barbas, la iluminación dramática o el maquillaje de alto contraste, pueden generar artefactos que se ven bien en una vista previa pequeña pero se vuelven evidentes a tamaño completo. Incorpora un control de calidad a resolución completa en tu flujo de trabajo antes de cada exportación final.
Los mejores modelos de sincronización labial con IA en PicassoIA
La categoría de sincronización labial en PicassoIA abarca todo el espectro, desde herramientas rápidas para el público general hasta modelos de calidad de estudio pensados para trabajos profesionales exigentes. Este es un desglose de las mejores opciones disponibles ahora mismo.
HeyGen: la potencia de la localización
Los tres modelos de sincronización labial de HeyGen cubren distintos puntos de la contrapartida entre velocidad y calidad:
- Lipsync Precision: el resultado de mayor calidad de HeyGen, pensado para trabajos en los que la precisión importa más que la velocidad
- Lipsync Speed: optimizado para entregas rápidas, ideal para flujos de gran volumen en los que el tiempo es el factor limitante
- Video Translate: el proceso de doblaje multilingüe de HeyGen con soporte para más de 150 idiomas, la mejor opción para la localización a escala
Si estás construyendo un flujo de contenido en varios idiomas o produciendo video con portavoces en volumen, HeyGen es el punto de partida natural.
Sync Labs: resultados de calidad de estudio
Sync Labs se ha ganado una reputación por una calidad de resultado que resiste un examen riguroso. Sus modelos en PicassoIA:
- Lipsync 2: el modelo estándar y fiable, adecuado para la mayoría de los escenarios de producción
- Lipsync 2 Pro: la opción de calidad de estudio, que usa superresolución basada en difusión para conservar detalles faciales finos, como los dientes naturales, las barbas, las pecas y los rostros expresivos. Admite salida en 4K y no requiere entrenamiento específico para cada persona. Si la calidad del resultado es tu prioridad absoluta, este es el modelo.
- React 1: añade sincronización labial realista a cualquier video existente, con énfasis en un movimiento natural y reactivo
ByteDance: de foto a video hablado
Los modelos Omni Human de ByteDance abren un caso de uso distinto: animar una foto fija hasta convertirla en un video hablado perfectamente sincronizado:
- Omni Human: anima una foto de retrato hasta convertirla en un video hablado sincronizado con cualquier pista de audio
- Omni Human 1.5: la versión actualizada, con más realismo y resultados más estables en una gama más amplia de tipos de rostro
Son especialmente potentes para flujos de trabajo con avatares de IA y portavoces en los que no existe ningún material original.
Kling, PixVerse, Veed y más
Varios modelos adicionales completan la categoría con opciones rápidas y accesibles:
- Kling Lip Sync: ajusta la boca al audio en cualquier video existente con una gran fidelidad de movimiento
- PixVerse Lipsync: sincroniza cualquier video con el audio al instante, de forma rápida y directa
- Fabric 1.0: el modelo de Veed para hacer hablar cualquier foto, adecuado para contenido en redes sociales
- P Video Avatar: crea videos de avatares hablantes con énfasis en la expresión natural
| Modelo | Ideal para | Característica destacada |
|---|
| Lipsync 2 Pro | Trabajos de calidad profesional | 4K, superresolución por difusión |
| Lipsync Precision | Flujos centrados en la precisión | Resultado de máximo nivel de HeyGen |
| Video Translate | Localización multilingüe | Más de 150 idiomas admitidos |
| Omni Human 1.5 | Flujos de foto a video | No necesita material original |
| Kling Lip Sync | Resultados de calidad cinematográfica | Gran fidelidad de movimiento |
| Lipsync Speed | Entrega rápida en gran volumen | Flujo optimizado para la velocidad |
Cómo usar la sincronización labial en PicassoIA
PicassoIA facilita pasar tu material por cualquier modelo de sincronización labial sin escribir una sola línea de código. Así puedes empezar.
Paso 1: Elige tu modelo
Ve a la colección de sincronización labial en PicassoIA. Explora los modelos disponibles y elige según tu prioridad: velocidad, calidad o soporte de idiomas. Para la mayoría de los usuarios que lo prueban por primera vez, Lipsync 2 es un buen punto de partida.
Paso 2: Sube tu video
Sube el archivo de video con la persona que quieres sincronizar. Asegúrate de que el rostro se vea con claridad y de que el ángulo de la cámara sea de frente o de tres cuartos leve, sin nada que tape la zona de la boca.
Paso 3: Sube tu audio
Sube el archivo de audio de reemplazo: una grabación de voz limpia y seca, sin música ni ambiente de fondo mezclados. El audio procesado y con niveles constantes siempre dará una mejor sincronización que las grabaciones sin editar.
Paso 4: Ejecuta el modelo
Pulsa generar. Según el modelo y la duración de tu video, los resultados suelen estar listos en uno a tres minutos. PicassoIA se encarga del cálculo sin necesidad de una GPU local.
Paso 5: Revisa y descarga
Revisa el resultado a resolución completa. Fíjate con atención en la zona de la boca durante el habla rápida, las consonantes fuertes y las combinaciones de fonemas poco habituales. Si el resultado necesita retoques, prueba con una grabación de audio más limpia o cambia a un modelo de mayor calidad, como Lipsync 2 Pro.
💡 Consejo profesional: Para flujos de localización, usa Video Translate para encargarse de la traducción y de la sincronización labial en un solo paso. Es mucho más rápido que ejecutar la traducción y la sincronización como procesos separados.
Crea tu primer video sincronizado hoy
La sincronización labial con IA ha superado con creces la fase de novedad. Hoy es una herramienta lista para producción que tiene su lugar en cualquier flujo de trabajo de video serio, ya sea que estés localizando contenido para un mercado nuevo, corrigiendo una frase en postproducción o construyendo desde cero un flujo escalable con portavoces de IA.
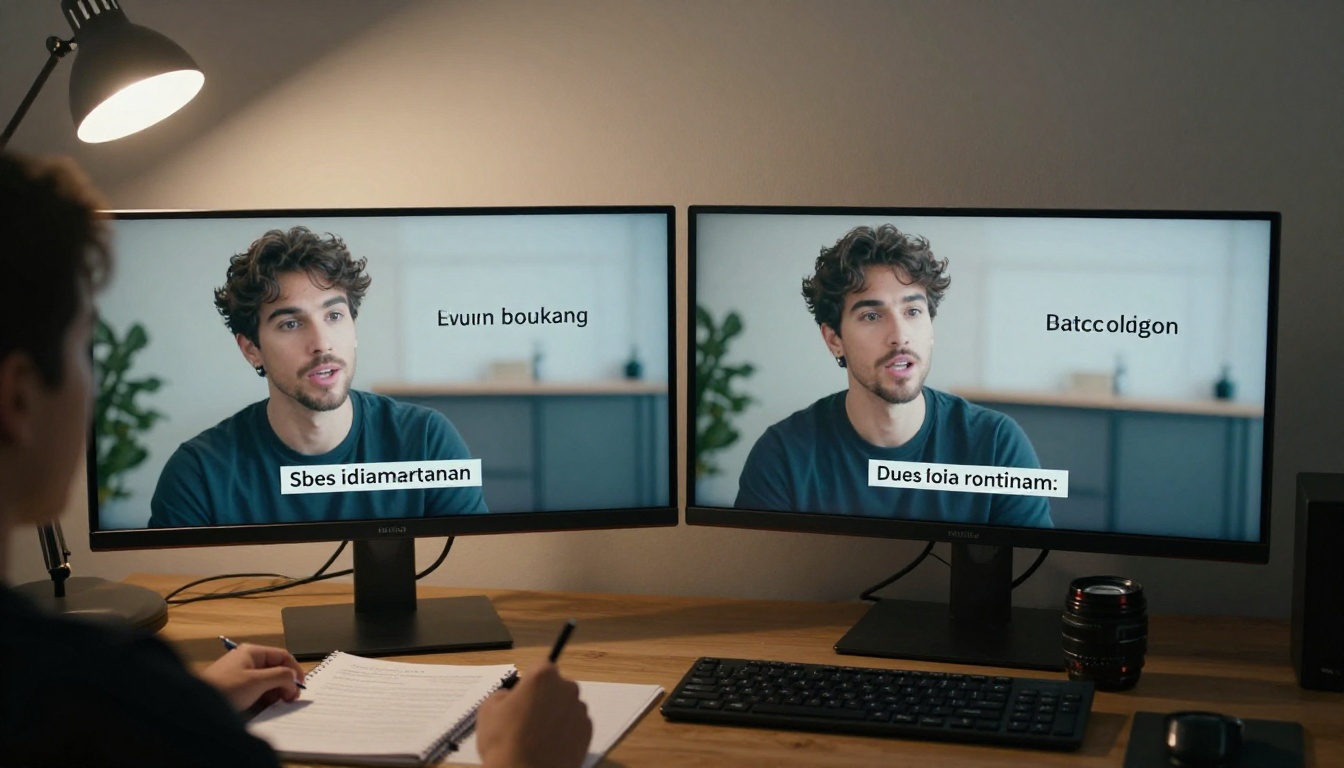
Los modelos de PicassoIA te dan acceso a toda la gama de herramientas: desde opciones rápidas para el público general, como Lipsync Speed, hasta resultados de calidad de estudio con Lipsync 2 Pro, sin necesidad de suscribirte a una docena de plataformas distintas. Elige un clip corto, deja tu audio limpio y prueba tu primera sincronización ahora mismo en la colección de sincronización labial de PicassoIA.
Preguntas frecuentes
¿Qué es la sincronización labial con IA?
La sincronización labial con IA es el proceso de usar inteligencia artificial para ajustar los movimientos de la boca de una persona en un video a una nueva pista de audio. El modelo analiza el audio en busca de fonemas y usa esos datos para regenerar la zona de la boca del video hasta que coincida.
¿Cómo funciona la sincronización labial con IA?
El modelo descompone tu audio en fonemas, los asigna a sus equivalentes visuales llamados visemas, y luego usa un proceso de difusión o de regresión para generar nuevos movimientos de la boca, fotograma a fotograma, que se alineen con el audio.
¿Cuál es la diferencia entre la sincronización labial con IA y un deepfake?
La sincronización labial trabaja con imágenes existentes de una persona real y cambia solo los movimientos de la boca para que coincidan con el nuevo audio. No reemplaza la identidad de la persona ni genera un rostro falso. Los deepfakes, en cambio, reemplazan todo el rostro o la identidad de un sujeto.
¿Qué tipos de contenido se benefician más de la sincronización labial con IA?
El contenido localizado o doblado es el que más se beneficia, pero también tiene mucho valor para las correcciones de diálogo en postproducción, los videos con avatares de IA, el contenido con portavoces corporativos y los módulos de e-learning.
¿Qué hace que el resultado de la sincronización labial con IA se vea mal?
Las causas más comunes son el audio con ruido o comprimido, los ángulos de cámara de perfil o con obstrucciones, el material original de baja resolución y el habla rápida o con acento marcado. Las entradas limpias producen salidas limpias.
¿Cómo consigo los mejores resultados?
Empieza con audio limpio y seco y con material de alta calidad grabado de frente o en un ángulo de tres cuartos leve. Elige un modelo adecuado para tu caso de uso y revisa siempre el resultado a resolución completa antes de publicarlo.


