A sincronização labial com IA finalmente alcançou o nível de qualidade que a produção de vídeo profissional exige. O que começou como um truque de salão, capaz de gerar resultados aquosos e levemente deslocados, amadureceu até virar um conjunto de ferramentas que funcionam bem em telas de TV, feeds de redes sociais e plataformas de streaming. Se você trabalha com vídeo de alguma forma, essa tecnologia merece atenção séria agora.
A distância entre o que antes exigia um estúdio completo de dublagem e o que um único criador consegue fazer a partir de um notebook diminuiu muito nos últimos dois anos. Este artigo explica o que é, de fato, a sincronização labial com IA, onde ela se encaixa em fluxos de produção reais, como obter resultados convincentes e quais modelos no PicassoIA entregam o melhor resultado hoje.
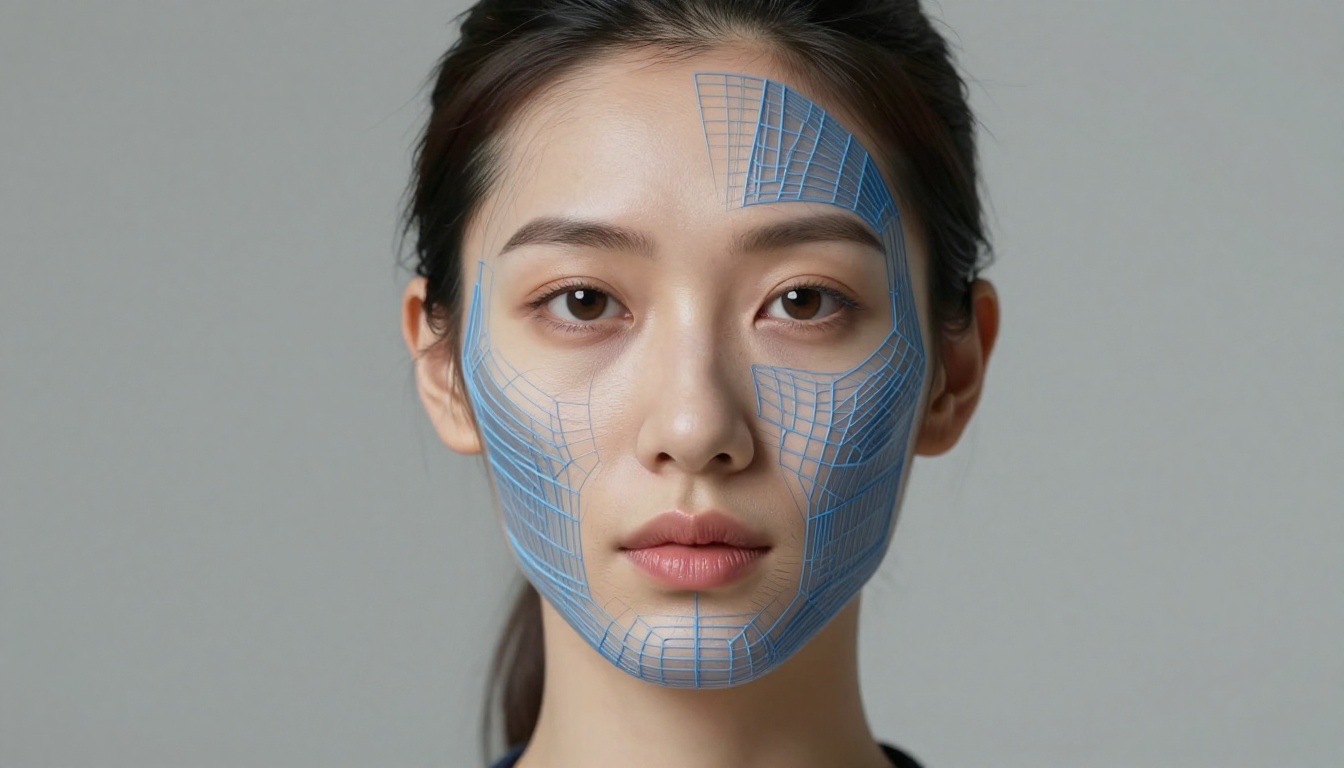
Em sua essência, a sincronização labial com IA é o processo de usar inteligência artificial para sincronizar automaticamente os movimentos da boca de uma pessoa com uma faixa de áudio. Você fornece ao modelo um vídeo e um novo arquivo de áudio, e ele remapeia os lábios do sujeito para combinar com a fala da nova gravação. Sem regravações, sem estúdio de dublagem, sem rotoscopia quadro a quadro.
A tecnologia funciona analisando o áudio de entrada no nível do fonema, dividindo a fala em suas unidades sonoras individuais e, depois, usando esses dados para prever e gerar os formatos corretos dos lábios, as posições da mandíbula e os movimentos sutis dos músculos faciais para cada som. Modelos modernos baseados em difusão preservam detalhes finos como dentes, barba, sardas e textura natural da pele, que sistemas antigos baseados em regressão borravam ou perdiam.
Como ela lê o seu áudio
O modelo primeiro extrai sequências de fonemas do seu áudio, criando um mapa com marcação de tempo de cada som da gravação. Em seguida, associa esses fonemas a formas de visema, os equivalentes visuais dos fonemas que determinam como a boca se parece ao produzir cada som. Os modelos mais avançados usam um processo de difusão para regenerar a região da boca quadro a quadro, garantindo que o resultado se integre sem emendas às partes inalteradas do rosto e do fundo.
O que a diferencia dos deepfakes
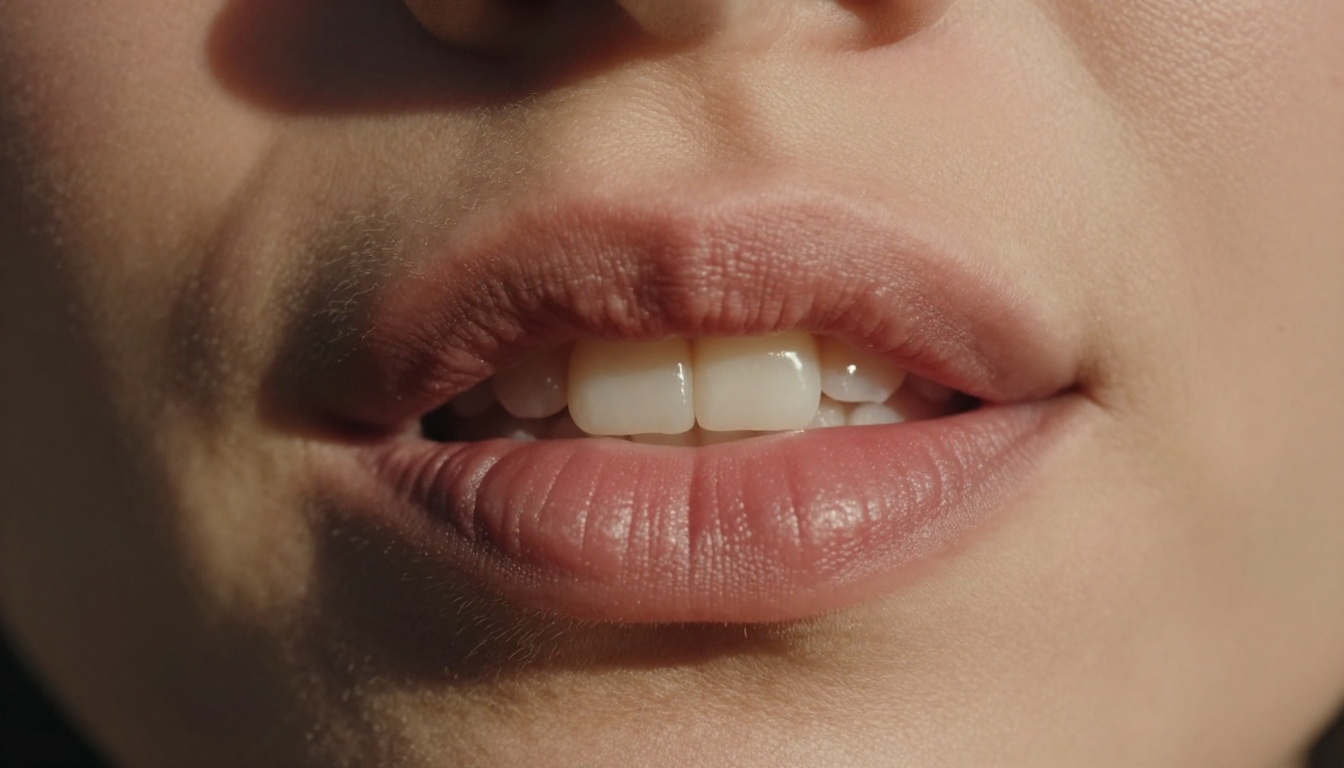
Esta é uma concepção equivocada comum que vale esclarecer. A sincronização labial com IA não é troca de rosto nem substituição de identidade. Ela trabalha com imagens já existentes de uma pessoa real e ajusta apenas a região da boca para combinar com o novo áudio. A identidade, a iluminação, o cabelo, a roupa e o ambiente do sujeito permanecem totalmente intactos. A tecnologia é uma ferramenta de produção, não um método de enganação, quando usada de forma responsável.
Onde a IA de sincronização labial se encaixa nos fluxos de trabalho atuais
Os casos de uso da sincronização labial com IA se expandiram bem além do óbvio. Criadores a estão aplicando em uma gama surpreendentemente ampla de cenários de produção, e os resultados são cada vez mais indistinguíveis de imagens gravadas originalmente.
Correções de diálogo na pós-produção
Mudanças no roteiro, takes com erro e revisões de última hora do cliente não precisam mais significar um retorno ao set. Uma nova gravação de áudio somada a um modelo de lipsync transforma o que antes era uma regravação de meio dia em uma tarefa de 10 minutos na pós-produção.
Tradução global de vídeos
É aqui que a sincronização labial com IA mostra seu potencial mais impressionante. Grave seu vídeo uma vez no seu idioma nativo, traduza a narração, passe o material por um modelo de lipsync e seu conteúdo passa a funcionar em um novo mercado, com movimentos da boca que combinam com o áudio traduzido. Sem novo apresentador, sem nova filmagem, sem abrir mão da qualidade de produção.
Avatares com IA e conteúdo de porta-voz
Marcas que operam em escala estão criando fluxos completos de porta-voz com avatares de IA. Grave uma vez, clone a voz, gere o vídeo. O Avatar IV da HeyGen transformou isso em um pipeline pronto para produção, que funciona bem em contextos corporativos e de e-learning sem nunca voltar ao set.
5 motivos para ela fazer parte do seu fluxo de trabalho
O argumento a favor da sincronização labial com IA não se resume à conveniência. Ela muda o que é realmente possível dentro de um determinado orçamento e prazo. Veja por que ela deve estar em qualquer kit sério de produção de vídeo.
Ciclos de produção mais rápidos
O que antes significava agendar regravações ou reservar tempo de estúdio agora pode acontecer inteiramente na pós-produção. Mudanças de roteiro, refilmagens e edições de última hora ficam prontas em minutos, e não em dias. Para agências e freelancers que lidam com prazos apertados, isso sozinho muda a conta do que vale a pena aceitar.
Custo menor por vídeo
Menos regravações significam menos gastos com talentos, equipe, locações e equipamentos. Para produtores de alto volume que criam vídeos corporativos, módulos de e-learning ou conteúdo para redes sociais, essas economias se acumulam rapidamente. Uma única assinatura de plataforma substitui vários dias de estúdio ao longo do ano.
Mais liberdade na edição
Quando corrigir uma fala não significa mandar toda a equipe de volta ao set, você pode experimentar mais na edição, sem medo de refazer tudo a um custo alto. Troque uma chamada para ação, ajuste o nome de um produto, corrija uma pronúncia e siga em frente.
Testes A/B sem novas filmagens
Quer testar dois ganchos ou chamadas para ação diferentes? Grave duas versões de áudio e processe ambas em um modelo de lipsync. Você terá duas versões completas de vídeo, totalmente sincronizadas, para testes divididos, por uma fração do custo de duas filmagens separadas.
Chegar a novos mercados rapidamente
A localização costumava ser um projeto. Agora é uma etapa de pós-produção. Traduza a narração, sincronize os lábios e publique para um novo público. Com ferramentas como o Video Translate da HeyGen, que oferece suporte a mais de 150 idiomas, a barreira para a distribuição global caiu quase a zero.
6 práticas que realmente melhoram seus resultados
As ferramentas evoluíram muito, mas o seu resultado é tão bom quanto o que você coloca nelas. Siga estas práticas e você obterá resultados que se sustentam na tela.
💡 Dica rápida: os dois fatores que mais importam para a qualidade do lipsync são a clareza do áudio e o ângulo da câmera. Acerte os dois e a maioria dos modelos cuida do resto.
Comece por um áudio limpo
Ruído de fundo, níveis inconsistentes ou compressão pesada vão confundir o modelo e produzir uma sincronização desleixada. Use sempre um arquivo de áudio bem gravado e tratado: idealmente uma voz seca, sem música nem ambiente incorporados. Uma gravação de voz limpa, feita com um microfone condensador de qualidade, é a coisa de maior impacto que você pode fazer para melhorar seus resultados.
Filme de frente para a câmera
Ângulos de frente ou levemente de três quartos funcionam melhor. Perfis laterais acentuados, mãos cobrindo a boca ou rostos parcialmente fora do quadro limitam o que a IA pode fazer na região da boca. Se você sabe que fará sincronização labial na pós-produção, leve isso em conta desde o planejamento do plano.
Comece com imagens de qualidade
Baixa resolução, artefatos de compressão intensa ou imagens tremidas dificultam muito para a IA rastrear e regenerar com precisão a região do rosto. Busque no mínimo 1080p, um codec limpo com alta taxa de bits e uma câmera estável. Dados de entrada melhores geram resultados melhores, sem exceção.
Mantenha a entrega natural
Tanto as imagens originais quanto o áudio de substituição devem ter uma entrega natural e comedida. Fala rápida, expressões exageradas ou sotaques carregados podem levar alguns modelos a artefatos visíveis. Ajuste a energia e o ritmo do áudio de substituição ao ritmo da atuação original para obter o resultado mais convincente.
A sincronização não corrige uma atuação ruim
O lipsync ajusta os movimentos da boca. Ele não corrige uma entrega sem vida, uma presença fraca em cena ou um roteiro que não funciona. Se a atuação não está funcionando, esse é um problema completamente diferente, e nenhum modelo de IA vai resolvê-lo na pós-produção.
Revise em resolução total
Sempre assista ao resultado em resolução total antes de aprová-lo. Casos extremos como óculos, barbas, iluminação dramática ou maquiagem de alto contraste podem gerar artefatos que parecem bons em uma pequena janela de visualização, mas ficam evidentes em tamanho real. Inclua uma etapa de controle de qualidade em resolução total no seu fluxo de trabalho antes de cada exportação final.
A categoria de lipsync no PicassoIA abrange todo o espectro, de ferramentas rápidas de uso geral a modelos de qualidade de estúdio criados para trabalhos profissionais exigentes. Veja um resumo das melhores opções disponíveis agora.
HeyGen: a potência da localização
Os três modelos de lipsync da HeyGen cobrem diferentes pontos da contrapartida entre velocidade e qualidade:
- Lipsync Precision: a saída de maior qualidade da HeyGen, feita para trabalhos em que a precisão importa mais do que a velocidade
- Lipsync Speed: otimizado para entregas rápidas, ideal para fluxos de alto volume em que o tempo é o fator limitante
- Video Translate: o pipeline de dublagem multilíngue da HeyGen, com suporte a mais de 150 idiomas, a melhor escolha para localização em escala
Se você está montando um fluxo de conteúdo em vários idiomas ou produzindo vídeos de porta-voz em volume, a HeyGen é o ponto de partida natural.
Sync Labs: resultado de padrão de estúdio
A Sync Labs construiu uma reputação de qualidade de saída que resiste a exames rigorosos. Os modelos deles no PicassoIA:
- Lipsync 2: o modelo padrão confiável, adequado para a maioria dos cenários de produção
- Lipsync 2 Pro: a opção de padrão de estúdio, que usa super-resolução baseada em difusão para preservar detalhes faciais finos, incluindo dentes naturais, barbas, sardas e rostos expressivos. Oferece saída em 4K e não exige treinamento específico para cada falante. Se a qualidade da saída é sua prioridade máxima, este é o modelo.
- React 1: adiciona sincronização labial realista a qualquer vídeo existente, com foco em movimentos naturais e reativos
ByteDance: de foto para vídeo falado
Os modelos Omni Human da ByteDance abrem um caso de uso distinto: animar uma foto estática em um vídeo falado totalmente sincronizado:
- Omni Human: anima uma foto de retrato em um vídeo falado sincronizado a qualquer faixa de áudio
- Omni Human 1.5: a versão atualizada, com realismo aprimorado e saída mais estável em uma gama maior de tipos de rosto
Eles são especialmente poderosos em fluxos de avatares de IA e de porta-voz em que não existe nenhuma imagem original.
Kling, PixVerse, Veed e outros
Vários modelos adicionais completam a categoria com opções rápidas e acessíveis:
- Kling Lip Sync: ajusta a boca ao áudio em qualquer vídeo existente, com forte fidelidade de movimento
- PixVerse Lipsync: sincroniza qualquer vídeo com o áudio instantaneamente, de forma rápida e direta
- Fabric 1.0: o modelo da Veed para fazer qualquer foto falar, adequado para conteúdo de redes sociais
- P Video Avatar: cria vídeos de avatares falantes com foco em expressão natural
| Modelo | Melhor para | Diferencial |
|---|
| Lipsync 2 Pro | Trabalhos de qualidade profissional | 4K, super-resolução por difusão |
| Lipsync Precision | Fluxos com foco em precisão | Saída de nível superior da HeyGen |
| Video Translate | Localização multilíngue | Mais de 150 idiomas suportados |
| Omni Human 1.5 | Fluxos de foto para vídeo | Não precisa de imagem original |
| Kling Lip Sync | Saída de qualidade cinematográfica | Forte fidelidade de movimento |
| Lipsync Speed | Alto volume com entrega rápida | Pipeline otimizado para velocidade |
Como usar o lipsync no PicassoIA
O PicassoIA torna simples passar suas imagens por qualquer modelo de lipsync sem escrever uma única linha de código. Veja como começar.
Passo 1: escolha seu modelo
Acesse a coleção de lipsync no PicassoIA. Navegue pelos modelos disponíveis e escolha um de acordo com sua prioridade: velocidade, qualidade ou suporte a idiomas. Para a maioria dos usuários iniciantes, o Lipsync 2 é um bom ponto de partida.
Passo 2: envie seu vídeo
Envie o arquivo de vídeo com a pessoa que você quer sincronizar. Certifique-se de que o rosto esteja bem visível e de que o ângulo da câmera seja frontal ou levemente de três quartos, sem nada cobrindo a região da boca.
Passo 3: envie seu áudio
Envie o arquivo de áudio de substituição: uma gravação de voz limpa e seca, sem música nem ambiente de fundo misturados. Áudio tratado e com níveis consistentes sempre produzirá uma sincronização melhor do que gravações brutas, sem edição.
Passo 4: execute o modelo
Clique em gerar. Dependendo do modelo e da duração do vídeo, os resultados costumam ficar prontos em um a três minutos. O PicassoIA cuida do processamento sem necessidade de uma GPU local.
Passo 5: revise e baixe
Assista ao resultado em resolução total. Verifique com atenção a região da boca em falas rápidas, consoantes fortes e combinações de fonemas incomuns. Se o resultado precisar de ajustes, tente uma gravação de áudio mais limpa ou mude para um modelo de qualidade superior, como o Lipsync 2 Pro.
💡 Dica de especialista: para fluxos de localização, use o Video Translate para cuidar da tradução e da sincronização labial em uma única etapa. Ele é bem mais rápido do que executar tradução e sincronização como processos separados.
Crie seu primeiro vídeo sincronizado hoje
A sincronização labial com IA superou muito a fase de novidade. Hoje é uma ferramenta pronta para produção, que cabe em qualquer fluxo de trabalho de vídeo sério, seja para localizar conteúdo para um novo mercado, corrigir uma fala na pós-produção ou montar, do zero, um fluxo escalável de porta-voz com IA.
Os modelos do PicassoIA dão acesso a todo o conjunto de ferramentas: de opções rápidas de uso geral, como o Lipsync Speed a saída de qualidade de estúdio do Lipsync 2 Pro, tudo sem precisar de assinatura em uma dúzia de plataformas diferentes. Escolha um clipe curto, deixe o áudio limpo e teste sua primeira sincronização agora na coleção de lipsync do PicassoIA.
Perguntas frequentes
O que é a sincronização labial com IA?
A sincronização labial com IA é o processo de usar inteligência artificial para combinar os movimentos da boca de uma pessoa em um vídeo com uma nova faixa de áudio. O modelo analisa o áudio em busca de fonemas e usa esses dados para regenerar a região da boca do vídeo de modo que combine com ele.
Como funciona a sincronização labial com IA?
O modelo divide seu áudio em fonemas, associa-os aos seus equivalentes visuais chamados visemas e, em seguida, usa um processo de difusão ou de regressão para gerar, quadro a quadro, novos movimentos da boca alinhados ao áudio.
Qual é a diferença entre sincronização labial com IA e deepfake?
A sincronização labial trabalha com imagens já existentes de uma pessoa real e altera apenas os movimentos da boca para combinar com o novo áudio. Ela não substitui a identidade da pessoa nem gera um rosto falso. Já os deepfakes substituem o rosto ou a identidade inteira de um sujeito.
Que tipos de conteúdo se beneficiam mais da sincronização labial com IA?
Conteúdo localizado ou dublado é o que mais se beneficia, mas ela também é valiosa para correções de diálogo na pós-produção, vídeos com avatares de IA, conteúdo corporativo de porta-voz e módulos de e-learning.
O que faz o resultado da sincronização labial com IA ficar ruim?
As causas mais comuns são áudio com ruído ou comprimido, ângulos de câmera de perfil ou obstruídos, imagens de origem em baixa resolução e fala rápida ou com sotaque carregado. Entradas limpas produzem saídas limpas.
Como obtenho os melhores resultados?
Comece com áudio limpo e seco e com imagens de alta qualidade, filmadas de frente ou com leve ângulo de três quartos. Escolha um modelo adequado ao seu caso de uso e sempre revise o resultado em resolução total antes de publicar.


