AI लिप सिंक आख़िरकार उस गुणवत्ता तक पहुँच गया है जिसकी प्रोफ़ेशनल वीडियो प्रोडक्शन माँग करता है। जो तकनीक कभी धुँधले और थोड़े बेमेल नतीजे देने वाला एक जादुई करतब भर थी, वह अब ऐसे टूल में बदल चुकी है जो ब्रॉडकास्ट स्क्रीन, सोशल फ़ीड और स्ट्रीमिंग प्लेटफ़ॉर्म पर भी टिकती है। अगर आप किसी भी रूप में वीडियो के साथ काम करते हैं, तो इस तकनीक को अभी गंभीरता से लेना चाहिए।
जो काम कभी पूरे डबिंग स्टूडियो की माँग करता था, और जो आज एक अकेला क्रिएटर लैपटॉप से कर सकता है, इन दोनों के बीच की दूरी पिछले दो सालों में बहुत तेज़ी से घटी है। यह लेख बताता है कि AI लिप सिंक असल में क्या है, यह असली प्रोडक्शन वर्कफ़्लो में कहाँ फिट होता है, ऐसे नतीजे कैसे पाएँ जो विश्वसनीय लगें, और PicassoIA पर कौन से मॉडल आज सबसे अच्छा आउटपुट देते हैं।
AI लिप सिंक असल में क्या है
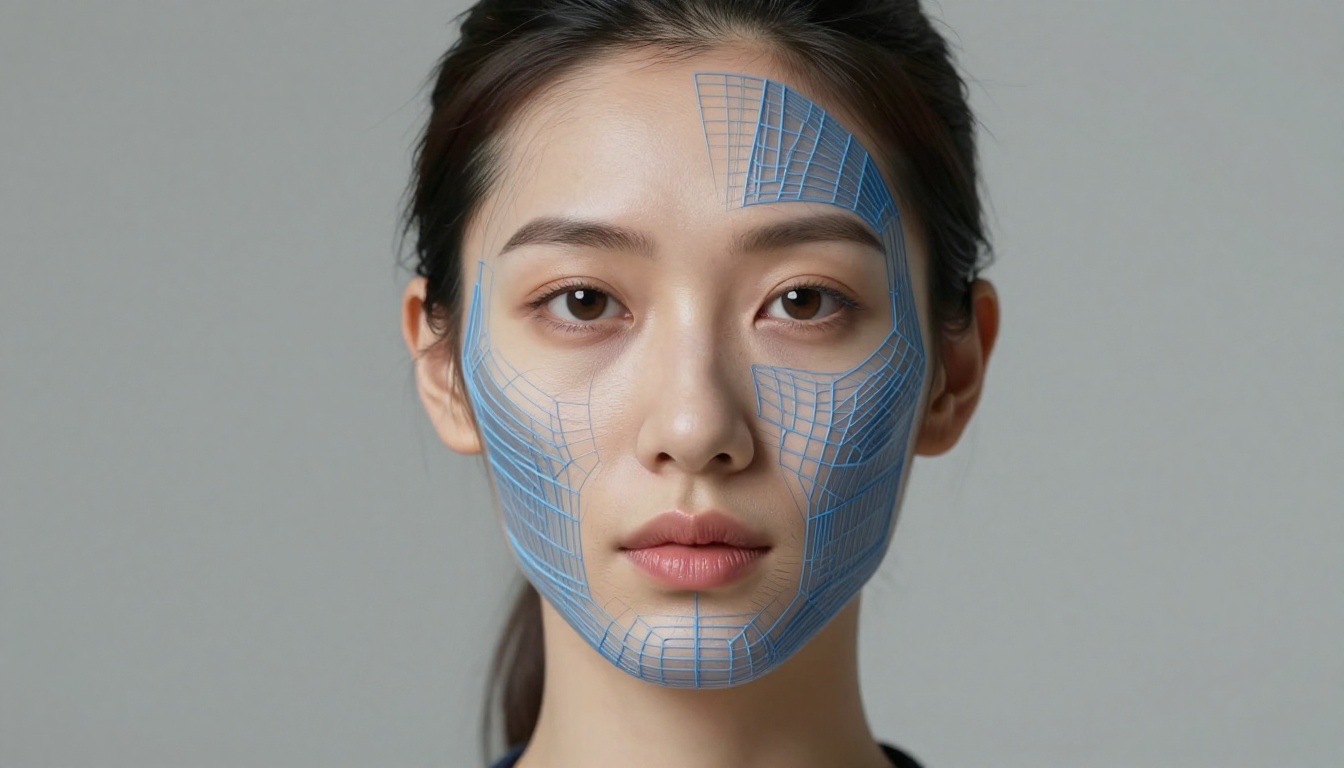
अपने मूल में, AI लिप सिंक वह प्रक्रिया है जिसमें AI का इस्तेमाल करके किसी व्यक्ति के होंठों की हरकतों को अपने-आप एक ऑडियो ट्रैक से मिलाया जाता है। आप मॉडल को एक वीडियो और एक नई ऑडियो फ़ाइल देते हैं, और वह सब्जेक्ट के होंठों को नई रिकॉर्डिंग के बोल से मेल खाने के लिए फिर से बनाता है। न रीशूट, न डबिंग बूथ, न फ़्रेम-दर-फ़्रेम रोटोस्कोपिंग।
यह तकनीक इनपुट ऑडियो का फ़ोनीम स्तर पर विश्लेषण करके काम करती है, यानी बोली को उसकी अलग-अलग ध्वनि इकाइयों में तोड़ती है, फिर उस डेटा से हर ध्वनि के लिए सही होंठों के आकार, जबड़े की स्थिति और चेहरे की बारीक मांसपेशियों की हरकतों का अनुमान लगाकर उन्हें बनाती है। आधुनिक डिफ़्यूज़न-आधारित मॉडल दाँत, दाढ़ी, झाइयाँ और प्राकृतिक त्वचा की बनावट जैसी बारीकियों को सुरक्षित रखते हैं, जिन्हें पुराने रिग्रेशन-आधारित सिस्टम धुँधला कर देते थे या खो देते थे।
यह आपके ऑडियो को कैसे पढ़ता है
मॉडल सबसे पहले आपके ऑडियो से फ़ोनीम के क्रम निकालता है, और रिकॉर्डिंग की हर ध्वनि का समय-अंकित नक्शा बनाता है। फिर वह इन फ़ोनीम को विज़ीम आकारों से मिलाता है, यानी फ़ोनीम के दृश्य समकक्ष, जो तय करते हैं कि हर ध्वनि बोलते समय मुँह कैसा दिखता है। सबसे उन्नत मॉडल डिफ़्यूज़न प्रक्रिया से मुँह वाले हिस्से को फ़्रेम-दर-फ़्रेम फिर से रेंडर करते हैं, ताकि आउटपुट चेहरे और बैकग्राउंड के बाकी अनबदले हिस्सों के साथ सहज ढंग से घुल जाए।
यह डीपफ़ेक से कैसे अलग है
यह एक आम गलतफ़हमी है जिसे साफ़ करना ज़रूरी है। AI लिप सिंक नहीं है फेस स्वैप या पहचान बदलना। यह किसी असली व्यक्ति के मौजूदा फ़ुटेज के साथ काम करता है और नए ऑडियो से मेल खाने के लिए सिर्फ़ मुँह वाले हिस्से को बदलता है। सब्जेक्ट की पहचान, रोशनी, बाल, कपड़े और माहौल पूरी तरह वैसे ही रहते हैं। ज़िम्मेदारी से इस्तेमाल करने पर यह एक प्रोडक्शन टूल है, कोई धोखा देने का तरीका नहीं।
आधुनिक वर्कफ़्लो में लिप सिंक AI कहाँ फिट बैठता है
AI लिप सिंक के इस्तेमाल अब साफ़ दिखने वाले मामलों से कहीं आगे फैल चुके हैं। क्रिएटर इसे कई तरह के प्रोडक्शन परिदृश्यों में लगा रहे हैं, और नतीजे अब असली फ़ुटेज से लगभग अलग पहचाने न जा सकने वाले होते जा रहे हैं।
पोस्ट-प्रोडक्शन में डायलॉग सुधार
स्क्रिप्ट में बदलाव, गलत टेक और आख़िरी वक़्त के क्लाइंट संशोधनों का मतलब अब सेट पर वापस जाना नहीं है। एक नई ऑडियो रिकॉर्डिंग और लिप सिंक मॉडल मिलकर उस काम को, जिसमें पहले आधा दिन रीशूट में लगता था, पोस्ट में 10 मिनट के काम में बदल देते हैं।
ग्लोबल वीडियो ट्रांसलेशन
यहीं AI लिप सिंक अपनी सबसे नाटकीय संभावना दिखाता है। अपना वीडियो एक बार अपनी मूल भाषा में रिकॉर्ड करें, वॉइसओवर का अनुवाद करें, उसे लिप सिंक मॉडल से चलाएँ, और आपका कंटेंट एक नए बाज़ार में काम करने लगता है, जिसमें होंठों की हरकतें अनूदित ऑडियो से मेल खाती हैं। कोई नया प्रेज़ेंटर नहीं, कोई नई शूटिंग नहीं, और प्रोडक्शन क्वालिटी से कोई समझौता नहीं।
AI अवतार और स्पोकपर्सन कंटेंट
बड़े पैमाने पर काम करने वाले ब्रांड AI अवतारों पर आधारित पूरे स्पोकपर्सन वर्कफ़्लो बना रहे हैं। एक बार रिकॉर्ड करें, वॉइस क्लोन करें, वीडियो जनरेट करें। HeyGen's Avatar IV ने इसे ऐसी प्रोडक्शन-रेडी पाइपलाइन बना दिया है जो कॉरपोरेट और ई-लर्निंग संदर्भों में टिकती है, और इसके लिए कभी सेट पर वापस जाने की ज़रूरत नहीं पड़ती।
5 कारण: यह आपके वर्कफ़्लो में क्यों होना चाहिए
AI लिप सिंक का मामला केवल सुविधा का नहीं है। यह बदल देता है कि किसी दिए गए बजट और समय-सीमा में वास्तव में क्या संभव है। यह बताता है कि यह किसी भी गंभीर वीडियो प्रोडक्शन टूलकिट में क्यों होना चाहिए।
तेज़ प्रोडक्शन साइकिल
जिसके लिए पहले रीशूट शेड्यूल करने या स्टूडियो बुक करने की ज़रूरत पड़ती थी, वह अब पूरी तरह पोस्ट में हो सकता है। स्क्रिप्ट बदलाव, रीटेक और आख़िरी वक़्त के एडिट दिनों की जगह मिनटों में पूरे हो जाते हैं। तंग समय-सीमा संभालने वाली एजेंसियों और फ़्रीलांसरों के लिए बस इतना ही बदल देता है कि कौन सा काम करना व्यावहारिक है।
प्रति वीडियो कम लागत
कम रीशूट का मतलब है टैलेंट, क्रू, लोकेशन और उपकरणों पर कम खर्च। कॉरपोरेट वीडियो, ई-लर्निंग मॉड्यूल या सोशल कंटेंट बनाने वाले उच्च-मात्रा प्रोड्यूसरों के लिए ये बचत तेज़ी से जमा होती है। एक प्लेटफ़ॉर्म सब्सक्रिप्शन पूरे साल में कई दिनों के स्टूडियो समय की जगह ले लेता है।
एडिट में ज़्यादा आज़ादी
जब किसी लाइन को ठीक करने के लिए पूरे क्रू को सेट पर वापस नहीं भेजना पड़ता, तो महँगे दोबारा काम के डर के बिना एडिट में और प्रयोग कर सकते हैं। कॉल टू एक्शन बदलें, किसी प्रोडक्ट का नाम सुधारें, गलत उच्चारण ठीक करें और आगे बढ़ जाएँ।
नई शूटिंग के बिना A/B टेस्टिंग
दो अलग हुक या कॉल टू एक्शन टेस्ट करना चाहते हैं? दो ऑडियो वर्ज़न रिकॉर्ड करें और दोनों को लिप सिंक मॉडल से चलाएँ। अब आपके पास स्प्लिट टेस्टिंग के लिए दो पूरी तरह सिंक्ड वीडियो वर्ज़न हैं, जो दो अलग शूट के खर्च के एक हिस्से में बने हैं।
नए बाज़ारों तक तेज़ी से पहुँच
लोकलाइज़ेशन पहले एक पूरा प्रोजेक्ट होता था। अब यह पोस्ट-प्रोडक्शन का एक चरण है। वॉइसओवर का अनुवाद करें, होंठ सिंक करें, नई ऑडियंस के लिए प्रकाशित करें। HeyGen's Video Translate जैसे टूल 150 से ज़्यादा भाषाओं को सपोर्ट करते हैं, इसलिए ग्लोबल वितरण की बाधा लगभग खत्म हो गई है।
6 तरीके जो असल में आपके नतीजे सुधारते हैं
टूल काफ़ी आगे बढ़ चुके हैं, लेकिन आपका आउटपुट उतना ही अच्छा होता है जितना अच्छा आप उसमें डालते हैं। इन तरीकों को अपनाएँ, और ऐसे नतीजे मिलेंगे जो स्क्रीन पर टिकते हैं।
💡 त्वरित टिप: लिप सिंक की गुणवत्ता के लिए सबसे ज़रूरी दो बातें हैं ऑडियो की स्पष्टता और कैमरा एंगल। इन दोनों को सही रखें, तो ज़्यादातर मॉडल बाकी संभाल लेंगे।
पहले साफ़ ऑडियो
बैकग्राउंड शोर, असमान लेवल या भारी कम्प्रेशन मॉडल को भ्रमित करते हैं और खराब सिंक पैदा करते हैं। हमेशा अच्छी तरह रिकॉर्ड और प्रोसेस की गई ऑडियो फ़ाइल इस्तेमाल करें: आदर्श रूप से बिना संगीत या माहौल की आवाज़ वाला ड्राई वोकल। क्वालिटी कंडेंसर माइक पर की गई साफ़ वॉइस रिकॉर्डिंग नतीजे सुधारने का सबसे असरदार तरीका है।
कैमरे की ओर मुँह करके शूट करें
सीधे या हल्के थ्री-क्वार्टर एंगल सबसे अच्छे काम करते हैं। भारी साइड प्रोफ़ाइल, मुँह ढकते हाथ, या आंशिक रूप से फ़्रेम से बाहर चेहरे AI की मुँह वाले हिस्से पर क्षमता सीमित कर देंगे। अगर आपको पता है कि पोस्ट में लिप सिंक करना है, तो शुरू से ही अपने शॉट डिज़ाइन में इसे शामिल करें।
अच्छे फ़ुटेज से शुरुआत करें
कम रेज़ोल्यूशन, भारी कम्प्रेशन आर्टिफ़ैक्ट या हिलते हुए फ़ुटेज AI के लिए चेहरे वाले हिस्से को सटीक तरीके से ट्रैक और रीजेनरेट करना बहुत मुश्किल बना देते हैं। कम से कम 1080p, उच्च बिटरेट पर साफ़ कोडेक और स्थिर कैमरा सेटअप रखें। बेहतर इनपुट डेटा से बेहतर आउटपुट मिलता है, इसमें कोई अपवाद नहीं।
डिलीवरी स्वाभाविक रखें
मूल फ़ुटेज और बदले गए ऑडियो दोनों में स्वाभाविक, संतुलित डिलीवरी होनी चाहिए। तेज़ बोलना, बढ़ा-चढ़ाकर दिखाए गए भाव या भारी लहजे कुछ मॉडल को दिखने वाली गड़बड़ियों की ओर धकेल सकते हैं। सबसे विश्वसनीय आउटपुट के लिए बदले गए ऑडियो की ऊर्जा और गति को मूल परफ़ॉर्मेंस की लय से मिलाएँ।
सिंक खराब परफ़ॉर्मेंस को ठीक नहीं करेगा
लिप सिंक केवल मुँह की हरकतों को समायोजित करता है। यह फीकी डिलीवरी, कमज़ोर स्क्रीन उपस्थिति या ऐसी स्क्रिप्ट को ठीक नहीं करता जो असर न छोड़ रही हो। अगर परफ़ॉर्मेंस काम नहीं कर रही, तो वह बिल्कुल अलग समस्या है, और कोई AI मॉडल उसे पोस्ट में हल नहीं कर सकता।
पूरे रेज़ोल्यूशन पर जाँचें
अंतिम मंज़ूरी देने से पहले हमेशा अपना आउटपुट पूरे रेज़ोल्यूशन पर देखें। चश्मे, दाढ़ी, नाटकीय रोशनी या हाई-कॉन्ट्रास्ट मेकअप जैसे एज केस ऐसी गड़बड़ियाँ पैदा कर सकते हैं जो छोटी प्रीव्यू विंडो में ठीक लगती हैं, लेकिन पूरे आकार पर साफ़ दिखने लगती हैं। हर फ़ाइनल एक्सपोर्ट से पहले अपने वर्कफ़्लो में पूरे रेज़ोल्यूशन वाली QC जाँच जोड़ें।
PicassoIA पर सबसे अच्छे AI लिप सिंक मॉडल
PicassoIA की लिप सिंक श्रेणी में तेज़, उपभोक्ता-स्तर के टूल से लेकर कठिन प्रोफ़ेशनल काम के लिए बने स्टूडियो-क्वालिटी मॉडल तक सब कुछ है। इस समय उपलब्ध सबसे अच्छे विकल्पों का ब्योरा यहाँ है।
HeyGen: लोकलाइज़ेशन की ताकत
HeyGen के तीन लिप सिंक मॉडल स्पीड और क्वालिटी के बीच ट्रेडऑफ़ के अलग-अलग बिंदुओं को कवर करते हैं:
- Lipsync Precision: HeyGen का सबसे उच्च-गुणवत्ता वाला आउटपुट, उन कामों के लिए बना है जहाँ गति से ज़्यादा सटीकता मायने रखती है
- Lipsync Speed: तेज़ टर्नअराउंड के लिए अनुकूलित, उच्च-मात्रा वाले वर्कफ़्लो के लिए आदर्श जहाँ समय ही बाधा है
- Video Translate: HeyGen की बहुभाषी डबिंग पाइपलाइन, 150+ भाषाओं के सपोर्ट के साथ, बड़े पैमाने पर लोकलाइज़ेशन के लिए शीर्ष विकल्प
अगर आप कई भाषाओं पर केंद्रित कंटेंट वर्कफ़्लो बना रहे हैं या बड़ी मात्रा में स्पोकपर्सन वीडियो बना रहे हैं, तो HeyGen स्वाभाविक शुरुआती बिंदु है।
Sync Labs: स्टूडियो-ग्रेड आउटपुट
Sync Labs ने ऐसी आउटपुट क्वालिटी के लिए प्रतिष्ठा बनाई है जो कड़ी जाँच में भी टिकती है। PicassoIA पर उनके मॉडल:
- Lipsync 2: भरोसेमंद मानक मॉडल, जो ज़्यादातर प्रोडक्शन स्थितियों के लिए उपयुक्त है
- Lipsync 2 Pro: स्टूडियो-ग्रेड विकल्प, जो डिफ़्यूज़न-आधारित सुपर-रेज़ोल्यूशन का इस्तेमाल करता है ताकि प्राकृतिक दाँत, दाढ़ी, झाइयाँ और भावपूर्ण चेहरों जैसी बारीक चेहरे की विशेषताएँ सुरक्षित रहें। 4K आउटपुट सपोर्ट करता है और किसी स्पीकर-विशिष्ट ट्रेनिंग की ज़रूरत नहीं होती। अगर आउटपुट क्वालिटी आपकी सर्वोच्च प्राथमिकता है, तो यही मॉडल है।
- React 1: किसी भी मौजूदा वीडियो में यथार्थवादी लिप सिंक जोड़ता है, जिसका ध्यान प्राकृतिक, प्रतिक्रियाशील हरकतों पर है
ByteDance: फ़ोटो से टॉकिंग वीडियो
ByteDance के Omni Human मॉडल एक अलग इस्तेमाल खोलते हैं: एक स्थिर फ़ोटो को पूरी तरह सिंक्ड टॉकिंग वीडियो में एनिमेट करना।
- Omni Human: किसी पोर्ट्रेट फ़ोटो को किसी भी ऑडियो ट्रैक से सिंक्ड टॉकिंग वीडियो में एनिमेट करता है
- Omni Human 1.5: बेहतर यथार्थवाद और विभिन्न प्रकार के चेहरों पर अधिक स्थिर आउटपुट वाला अपडेटेड वर्ज़न
ये AI अवतार और स्पोकपर्सन वर्कफ़्लो के लिए खास तौर पर शक्तिशाली हैं, जहाँ कोई मूल फ़ुटेज मौजूद ही नहीं होता।
Kling, PixVerse, Veed और अन्य
कई अतिरिक्त मॉडल तेज़ और सुलभ विकल्पों के साथ इस श्रेणी को पूरा करते हैं:
- Kling Lip Sync: किसी भी मौजूदा वीडियो में होंठों को ऑडियो से मिलाता है, मज़बूत मोशन फ़िडेलिटी के साथ
- PixVerse Lipsync: किसी भी वीडियो को तुरंत ऑडियो से सिंक करता है, तेज़ और सीधा
- Fabric 1.0: Veed का मॉडल, जो किसी भी फ़ोटो को बोलने वाला बनाता है, सोशल कंटेंट के लिए उपयुक्त
- P Video Avatar: प्राकृतिक भावों पर ध्यान के साथ टॉकिंग अवतार वीडियो बनाता है
PicassoIA पर लिप सिंक कैसे इस्तेमाल करें
PicassoIA बिना एक भी लाइन कोड लिखे आपके फ़ुटेज को किसी भी लिप सिंक मॉडल से चलाना आसान बनाता है। शुरू करने का तरीका यहाँ है।
चरण 1: अपना मॉडल चुनें
PicassoIA पर लिप सिंक कलेक्शन पर जाएँ। उपलब्ध मॉडल देखें और अपनी प्राथमिकता के आधार पर चुनें: स्पीड, क्वालिटी या भाषा सपोर्ट। ज़्यादातर पहली बार इस्तेमाल करने वालों के लिए, Lipsync 2 एक ठोस शुरुआत है।
चरण 2: अपना वीडियो अपलोड करें
वह वीडियो फ़ाइल अपलोड करें जिसमें वह व्यक्ति है जिसे आप सिंक करना चाहते हैं। सुनिश्चित करें कि चेहरा साफ़ दिख रहा हो और कैमरा एंगल सामने की ओर या हल्के थ्री-क्वार्टर वाला हो, जिसमें मुँह वाले हिस्से को कुछ ढका न हो।
चरण 3: अपना ऑडियो अपलोड करें
बदलने वाली ऑडियो फ़ाइल अपलोड करें: एक साफ़, ड्राई वोकल रिकॉर्डिंग जिसमें कोई संगीत या बैकग्राउंड माहौल मिला हुआ न हो। प्रोसेस्ड, एकसमान लेवल वाला ऑडियो हमेशा कच्ची, बिना एडिट की रिकॉर्डिंग से बेहतर सिंक देगा।
चरण 4: मॉडल चलाएँ
जनरेट दबाएँ। मॉडल और वीडियो की लंबाई के हिसाब से नतीजे आम तौर पर एक से तीन मिनट में आ जाते हैं। PicassoIA बिना किसी लोकल GPU के कंप्यूट संभालता है।
चरण 5: समीक्षा करें और डाउनलोड करें
आउटपुट को पूरे रेज़ोल्यूशन पर देखें। तेज़ बोलने, कठोर व्यंजनों और असामान्य फ़ोनीम संयोजनों के आसपास मुँह वाले हिस्से की ध्यान से जाँच करें। अगर नतीजे को सुधार की ज़रूरत है, तो एक साफ़ ऑडियो रिकॉर्डिंग आज़माएँ या Lipsync 2 Pro जैसे उच्च-क्वालिटी मॉडल पर जाएँ।
💡 प्रो टिप: लोकलाइज़ेशन वर्कफ़्लो के लिए, Video Translate का इस्तेमाल करें, जो अनुवाद और लिप सिंक दोनों को एक ही चरण में संभालता है। यह अनुवाद और सिंक को अलग-अलग प्रक्रियाओं में चलाने से काफ़ी तेज़ है।
आज ही अपना पहला सिंक्ड वीडियो बनाएँ
AI लिप सिंक नवीनता से बहुत आगे निकल चुका है। अब यह एक प्रोडक्शन-रेडी टूल है जो किसी भी गंभीर वीडियो वर्कफ़्लो में फिट बैठता है, चाहे आप किसी नए बाज़ार के लिए कंटेंट लोकलाइज़ कर रहे हों, पोस्ट में कोई लाइन ठीक कर रहे हों, या शून्य से एक स्केलेबल AI स्पोकपर्सन वर्कफ़्लो बना रहे हों।
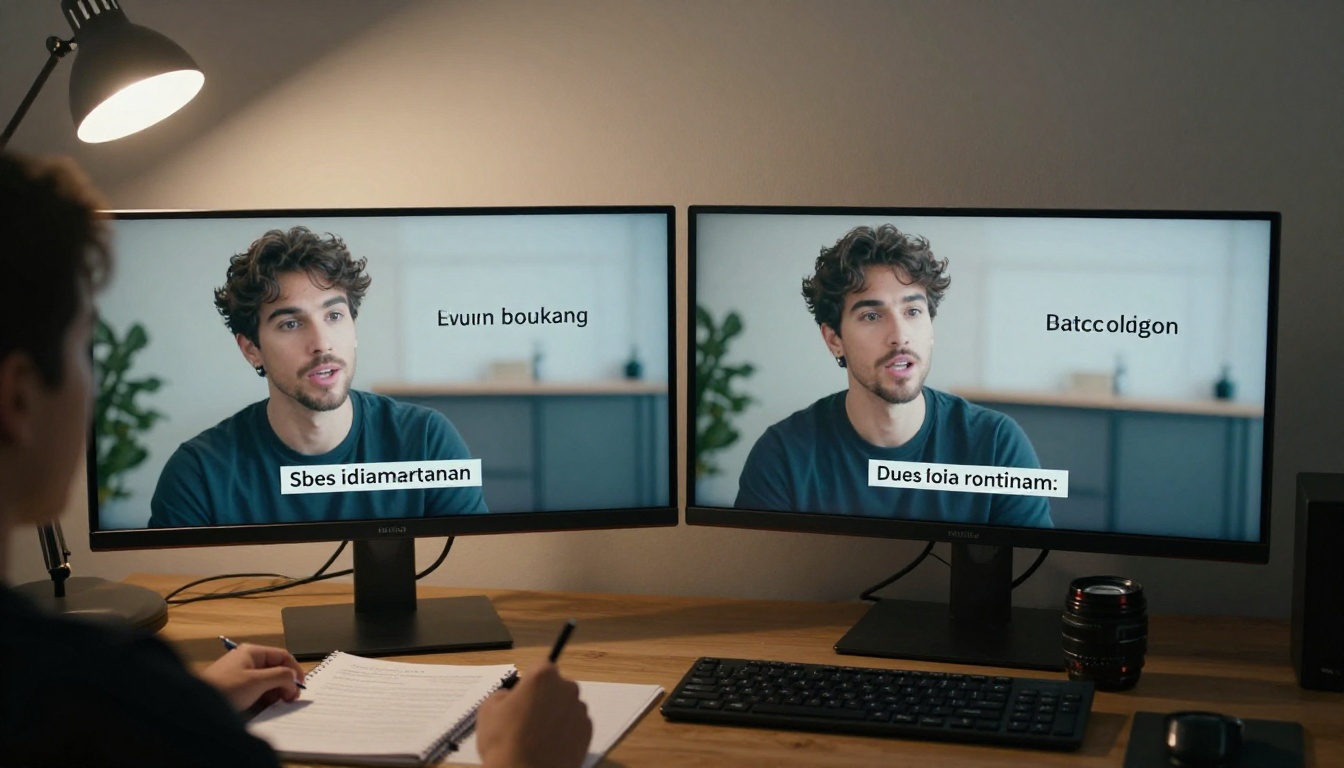
PicassoIA के मॉडल आपको टूल की पूरी रेंज तक पहुँच देते हैं: Lipsync Speed जैसे तेज़, उपभोक्ता-स्तर के विकल्पों से लेकर Lipsync 2 Pro से स्टूडियो-क्वालिटी आउटपुट तक, और यह सब एक दर्जन अलग-अलग प्लेटफ़ॉर्म की सदस्यता के बिना। एक छोटा क्लिप चुनें, अपना ऑडियो साफ़ करें, और अभी PicassoIA लिप सिंक कलेक्शन पर अपना पहला सिंक आज़माएँ।
अक्सर पूछे जाने वाले प्रश्न
AI लिप सिंक क्या है?
AI लिप सिंक वह प्रक्रिया है जिसमें AI का इस्तेमाल करके किसी वीडियो में व्यक्ति की मुँह की हरकतों को एक नए ऑडियो ट्रैक से मिलाया जाता है। मॉडल ऑडियो में फ़ोनीम खोजता है और उस डेटा से वीडियो के मुँह वाले हिस्से को मेल खाने के लिए फिर से बनाता है।
AI लिप सिंक कैसे काम करता है?
मॉडल आपके ऑडियो को फ़ोनीम में तोड़ता है, उन्हें उनके दृश्य समकक्षों, जिन्हें विज़ीम कहते हैं, से मिलाता है, फिर डिफ़्यूज़न या रिग्रेशन प्रक्रिया से फ़्रेम-दर-फ़्रेम नई मुँह की हरकतें बनाता है जो ऑडियो से मेल खाती हैं।
AI लिप सिंक और डीपफ़ेक में क्या अंतर है?
लिप सिंक किसी असली व्यक्ति के मौजूदा फ़ुटेज के साथ काम करता है और केवल नए ऑडियो से मेल खाने के लिए मुँह की हरकतें बदलता है। यह व्यक्ति की पहचान नहीं बदलता और न ही नकली चेहरा बनाता है। इसके विपरीत, डीपफ़ेक पूरे चेहरे या सब्जेक्ट की पहचान को बदल देते हैं।
किस तरह का कंटेंट AI लिप सिंक से सबसे ज़्यादा फ़ायदा उठाता है?
लोकलाइज़्ड या डब किया गया कंटेंट सबसे ज़्यादा फ़ायदा उठाता है, लेकिन यह पोस्ट-प्रोडक्शन डायलॉग सुधार, AI अवतार वीडियो, कॉरपोरेट स्पोकपर्सन कंटेंट और ई-लर्निंग मॉड्यूल के लिए भी उपयोगी है।
AI लिप सिंक का आउटपुट खराब क्यों दिखता है?
सबसे आम कारण हैं शोर वाला या कम्प्रेस्ड ऑडियो, साइड-प्रोफ़ाइल या बाधित कैमरा एंगल, कम रेज़ोल्यूशन वाला सोर्स फ़ुटेज, और तेज़ या भारी लहजे वाला बोलना। साफ़ इनपुट से साफ़ आउटपुट मिलता है।
सबसे अच्छे नतीजे कैसे पाएँ?
साफ़, ड्राई ऑडियो और सामने की ओर या हल्के थ्री-क्वार्टर एंगल से शूट किए गए उच्च-गुणवत्ता वाले फ़ुटेज से शुरुआत करें। अपने उपयोग के मामले के अनुकूल मॉडल चुनें, और प्रकाशित करने से पहले आउटपुट को हमेशा पूरे रेज़ोल्यूशन पर देखें।


