La synchronisation labiale par IA a enfin atteint le niveau de qualité qu’exige la production vidéo professionnelle. Ce qui était à l’origine un tour de passe-passe, capable de produire des résultats pâteux et légèrement décalés, est devenu un ensemble d’outils qui tiennent la route sur les écrans de diffusion, les fils des réseaux sociaux et les plateformes de streaming. Si vous travaillez avec la vidéo, quelle que soit votre activité, cette technologie mérite d’être prise au sérieux dès maintenant.
L’écart entre ce qui exigeait autrefois un studio de doublage complet et ce qu’un seul créateur peut aujourd’hui obtenir depuis son ordinateur portable s’est considérablement réduit au cours des deux dernières années. Cet article explique ce qu’est réellement la synchronisation labiale par IA, où elle s’intègre dans les flux de production réels, comment obtenir des résultats convaincants et quels modèles de PicassoIA offrent aujourd’hui les meilleurs rendus.
Ce qu’est réellement la synchronisation labiale par IA
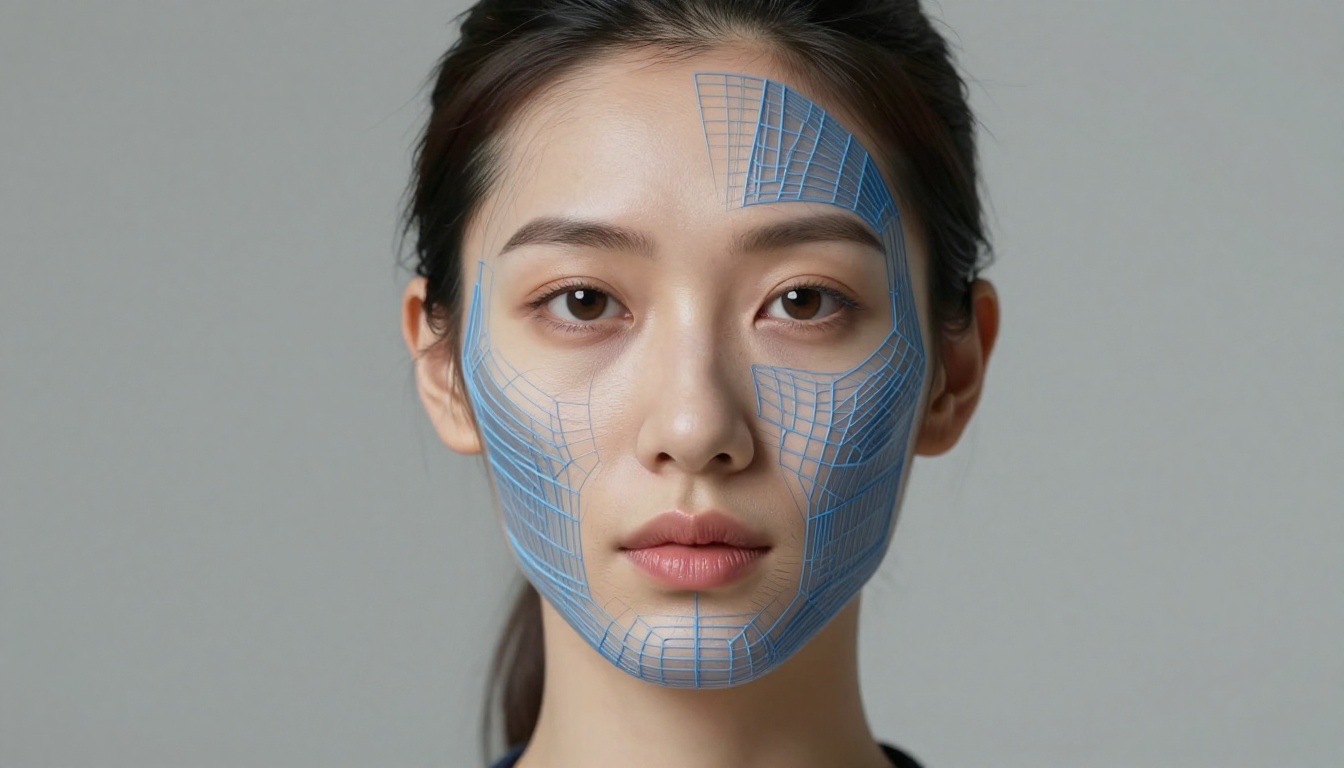
Au fond, la synchronisation labiale par IA consiste à utiliser l’intelligence artificielle pour synchroniser automatiquement les mouvements de bouche d’une personne avec une piste audio. Vous fournissez au modèle une vidéo et un nouveau fichier audio, et il remodèle les lèvres du sujet pour qu’elles correspondent à la parole du nouvel enregistrement. Pas de reprise, pas de studio de doublage, pas de rotoscopie image par image.
La technologie analyse l’audio d’entrée au niveau du phonème, en décomposant la parole en ses unités sonores individuelles, puis utilise ces données pour prédire et générer les formes correctes des lèvres, les positions de la mâchoire et les subtils mouvements des muscles du visage pour chaque son. Les modèles modernes basés sur la diffusion préservent des détails fins comme les dents, la barbe, les taches de rousseur et la texture naturelle de la peau, que les anciens systèmes basés sur la régression écraseraient ou perdraient.
Comment elle lit votre audio
Le modèle extrait d’abord les séquences de phonèmes de votre audio, en construisant une carte horodatée de chaque son de l’enregistrement. Il associe ensuite ces phonèmes à des visèmes, les équivalents visuels des phonèmes qui déterminent l’aspect de la bouche lors de la production de chaque son. Les modèles les plus avancés utilisent un processus de diffusion pour régénérer la zone de la bouche image par image, en veillant à ce que le rendu se fond sans couture dans les parties inchangées du visage et de l’arrière-plan.
En quoi elle se distingue des deepfakes
C’est une idée reçue qu’il vaut la peine de dissiper. La synchronisation labiale par IA n’est pas un échange de visage ni un remplacement d’identité. Elle travaille à partir de séquences existantes d’une personne réelle et n’ajuste que la zone de la bouche pour correspondre au nouvel audio. L’identité du sujet, l’éclairage, les cheveux, les vêtements et l’environnement restent entièrement intacts. Utilisée de manière responsable, la technologie est un outil de production, et non un moyen de tromperie.
Où la synchronisation labiale par IA s’intègre dans les flux de travail modernes
Les usages de la synchronisation labiale par IA ont largement dépassé les évidences. Les créateurs la déploient dans un éventail étonnamment large de scénarios de production, et les résultats deviennent de plus en plus impossibles à distinguer des images tournées à l’origine.
Corrections de dialogues en post-production
Les changements de script, les prises ratées et les révisions de dernière minute du client n’impliquent plus forcément un retour sur le plateau. Un nouvel enregistrement audio associé à un modèle de synchronisation labiale transforme ce qui était autrefois une reprise d’une demi-journée en une tâche de 10 minutes en post-production.
Traduction vidéo à l’échelle mondiale
C’est là que la synchronisation labiale par IA révèle son potentiel le plus spectaculaire. Enregistrez votre vidéo une seule fois dans votre langue maternelle, traduisez la voix off, passez-la dans un modèle de synchronisation labiale, et votre contenu fonctionne désormais sur un nouveau marché, avec des mouvements de bouche qui correspondent à l’audio traduit. Pas de nouveau présentateur, pas de nouveau tournage, aucun compromis sur la qualité de production.
Avatars IA et contenus de porte-parole
Les marques qui opèrent à grande échelle construisent des flux de travail complets autour de porte-parole fondés sur des avatars IA. Enregistrez une fois, clonez la voix, générez la vidéo. HeyGen's Avatar IV a fait de cette chaîne de production un processus prêt à l’emploi, qui tient la route dans les contextes d’entreprise et de e-learning sans jamais revenir sur le plateau.
5 raisons de l’intégrer à votre flux de travail
L’intérêt de la synchronisation labiale par IA ne se résume pas à la commodité. Elle change ce qui est réellement faisable dans un budget et des délais donnés. Voici pourquoi elle a sa place dans toute boîte à outils de production vidéo sérieuse.
Des cycles de production plus rapides
Ce qui impliquait autrefois de planifier des reprises ou de réserver du temps de studio peut désormais se faire entièrement en post-production. Les changements de script, les reprises et les modifications de dernière minute se traitent en quelques minutes plutôt qu’en quelques jours. Pour les agences et les freelances qui gèrent des délais serrés, cela change à lui seul le calcul de ce qu’il est viable d’entreprendre.
Un coût par vidéo plus faible
Moins de reprises signifie moins de dépenses en talents, équipe technique, lieux et matériel. Pour les producteurs à gros volume qui enchaînent les vidéos d’entreprise, les modules de e-learning ou les contenus pour les réseaux sociaux, ces économies s’accumulent vite. Un seul abonnement à une plateforme remplace plusieurs jours de studio au fil de l’année.
Plus de liberté au montage
Quand corriger une réplique ne signifie plus renvoyer toute l’équipe sur le plateau, vous pouvez expérimenter davantage au montage, sans craindre des reprises coûteuses. Modifiez un appel à l’action, ajustez le nom d’un produit, corrigez une mauvaise prononciation, et passez à la suite.
Des tests A/B sans nouveau tournage
Vous voulez tester deux accroches ou deux appels à l’action différents ? Enregistrez deux versions audio et passez-les toutes deux dans un modèle de synchronisation labiale. Vous obtenez deux vidéos complètes et parfaitement synchronisées pour des tests A/B, pour une fraction du coût de deux tournages distincts.
Atteindre rapidement de nouveaux marchés
La localisation était autrefois un projet. Elle est aujourd’hui une étape de post-production. Traduisez votre voix off, synchronisez les lèvres, publiez auprès d’un nouveau public. Avec des outils comme HeyGen's Video Translate, qui prend en charge plus de 150 langues, la barrière de la diffusion mondiale est devenue presque nulle.
6 pratiques qui améliorent réellement vos résultats
Les outils ont fait beaucoup de chemin, mais votre résultat ne vaut que ce que vous y mettez. Suivez ces pratiques et vous obtiendrez des rendus qui tiennent la route à l’écran.
💡 Astuce rapide : Les deux facteurs qui comptent le plus pour la qualité de la synchronisation labiale sont la clarté de l’audio et l’angle de la caméra. Réussissez ces deux points et la plupart des modèles se chargeront du reste.
Commencer par un audio propre
Les bruits de fond, les niveaux irréguliers ou une compression importante vont dérouter le modèle et produire une synchronisation approximative. Utilisez toujours un fichier audio bien enregistré et traité : idéalement une voix sèche, sans musique ni ambiance intégrée. Un enregistrement vocal propre, réalisé avec un microphone à condensateur de qualité, est la chose la plus efficace que vous puissiez faire pour améliorer vos résultats.
Filmer face à la caméra
Les angles de face ou légèrement de trois quarts fonctionnent le mieux. Les profils de côté prononcés, les mains qui cachent la bouche ou les visages partiellement hors cadre limiteront ce que l’IA peut faire de la zone de la bouche. Si vous savez que vous ferez une synchronisation labiale en post-production, prenez-le en compte dès le départ dans la conception de vos plans.
Partir de séquences de qualité
Une faible résolution, des artefacts de compression importants ou des images instables compliquent beaucoup le suivi et la régénération précise de la zone du visage par l’IA. Visez une résolution d’au moins 1080p, un codec propre à haut débit et une caméra stable. De meilleures données d’entrée donnent de meilleurs résultats, sans exception.
Garder une élocution naturelle
La séquence d’origine comme l’audio de remplacement doivent tous deux présenter une élocution naturelle et mesurée. Une parole rapide, des expressions exagérées ou des accents marqués peuvent pousser certains modèles vers des artefacts visibles. Adaptez l’énergie et le rythme de l’audio de remplacement à ceux de la performance originale pour obtenir le rendu le plus convaincant.
La synchronisation ne corrigera pas une mauvaise prestation
La synchronisation labiale ajuste les mouvements de la bouche. Elle ne corrige ni une élocution plate, ni une présence à l’écran médiocre, ni un script qui ne porte pas. Si la prestation ne fonctionne pas, c’est un tout autre problème, et aucun modèle d’IA ne le résoudra en post-production.
Vérifier en pleine résolution
Regardez toujours votre résultat en pleine résolution avant de le valider. Les cas limites comme les lunettes, les barbes, les éclairages contrastés ou un maquillage très marqué peuvent produire des artefacts qui paraissent corrects dans une petite fenêtre d’aperçu mais deviennent évidents en grand format. Intégrez une étape de contrôle qualité en pleine résolution dans votre flux de travail avant chaque export final.
Les meilleurs modèles de synchronisation labiale par IA sur PicassoIA
La catégorie de synchronisation labiale de PicassoIA couvre tout le spectre, des outils rapides grand public aux modèles de qualité studio conçus pour les travaux professionnels exigeants. Voici un panorama des meilleures options disponibles aujourd’hui.
HeyGen : la référence de la localisation
Les trois modèles de synchronisation labiale de HeyGen couvrent différents points du compromis entre vitesse et qualité :
- Lipsync Precision : la meilleure qualité de HeyGen, conçue pour les travaux où la précision compte plus que la vitesse
- Lipsync Speed : optimisé pour une livraison rapide, idéal pour les flux à gros volume où le temps est la contrainte
- Video Translate : le pipeline de doublage multilingue de HeyGen, avec la prise en charge de plus de 150 langues, le meilleur choix pour la localisation à grande échelle
Si vous construisez un flux de contenus autour de plusieurs langues ou produisez des vidéos de porte-parole en volume, HeyGen est le point de départ naturel.
Sync Labs : une qualité de niveau studio
Sync Labs s’est forgé une réputation de qualité qui résiste à un examen rigoureux. Leurs modèles sur PicassoIA :
- Lipsync 2 : le modèle standard fiable, adapté à la plupart des scénarios de production
- Lipsync 2 Pro : l’option de qualité studio, qui utilise une super-résolution par diffusion pour préserver les détails fins du visage, dont les dents, les barbes, les taches de rousseur et les visages expressifs. Prend en charge les sorties en 4K et ne nécessite aucun entraînement propre à chaque locuteur. Si la qualité du rendu est votre priorité absolue, c’est ce modèle qu’il vous faut.
- React 1 : ajoute une synchronisation labiale réaliste à toute vidéo existante, avec un accent sur des mouvements naturels et réactifs
ByteDance : de la photo à la vidéo parlante
Les modèles Omni Human de ByteDance ouvrent un usage distinct : animer une photo fixe en une vidéo parlante entièrement synchronisée.
- Omni Human : anime un portrait photo en une vidéo parlante synchronisée sur n’importe quelle piste audio
- Omni Human 1.5 : la version mise à jour, avec un réalisme amélioré et un rendu plus stable sur une plus grande variété de types de visages
Ils sont particulièrement puissants pour les flux d’avatars IA et de porte-parole où aucune séquence d’origine n’existe.
Kling, PixVerse, Veed et autres
Plusieurs modèles supplémentaires complètent la catégorie avec des options rapides et accessibles :
- Kling Lip Sync : fait correspondre la bouche à l’audio dans n’importe quelle vidéo existante, avec une bonne fidélité des mouvements
- PixVerse Lipsync : synchronise instantanément n’importe quelle vidéo sur l’audio, rapidement et directement
- Fabric 1.0 : le modèle de Veed pour faire parler n’importe quelle photo, adapté aux contenus pour les réseaux sociaux
- P Video Avatar : crée des vidéos d’avatars parlants avec un accent sur une expression naturelle
| Modèle | Idéal pour | Atout principal |
|---|
| Lipsync 2 Pro | Travaux de qualité professionnelle | 4K, super-résolution par diffusion |
| Lipsync Precision | Flux axés sur la précision | Rendu haut de gamme de HeyGen |
| Video Translate | Localisation multilingue | Plus de 150 langues prises en charge |
| Omni Human 1.5 | Flux de la photo à la vidéo | Aucune séquence source nécessaire |
| Kling Lip Sync | Rendu de qualité cinématographique | Bonne fidélité des mouvements |
| Lipsync Speed | Gros volume, livraison rapide | Pipeline optimisé pour la vitesse |
PicassoIA permet de faire passer vos séquences dans n’importe quel modèle de synchronisation labiale sans écrire une seule ligne de code. Voici comment commencer.
Étape 1 : choisissez votre modèle
Rendez-vous dans la collection de synchronisation labiale de PicassoIA. Parcourez les modèles disponibles et choisissez-en un selon votre priorité : vitesse, qualité ou prise en charge des langues. Pour la plupart des premiers utilisateurs, Lipsync 2 est un bon point de départ.
Étape 2 : importez votre vidéo
Importez le fichier vidéo contenant la personne que vous souhaitez synchroniser. Assurez-vous que le visage est bien visible et que l’angle de caméra est de face ou légèrement de trois quarts, sans obstacle masquant la zone de la bouche.
Étape 3 : importez votre audio
Importez le fichier audio de remplacement : un enregistrement vocal propre et sec, sans musique ni ambiance mélangée. Un audio traité et au niveau constant donnera toujours une meilleure synchronisation qu’un enregistrement brut non retouché.
Étape 4 : lancez le modèle
Cliquez sur générer. Selon le modèle et la durée de votre vidéo, les résultats arrivent généralement d’une à trois minutes. PicassoIA gère le calcul sans qu’aucun GPU local ne soit nécessaire.
Étape 5 : vérifiez et téléchargez
Regardez le résultat en pleine résolution. Vérifiez attentivement la zone de la bouche lors des passages rapides, des consonnes dures et des combinaisons de phonèmes inhabituelles. Si le résultat nécessite des retouches, essayez un enregistrement audio plus propre ou passez à un modèle de meilleure qualité comme Lipsync 2 Pro.
💡 Astuce pro : Pour les flux de localisation, utilisez Video Translate pour gérer à la fois la traduction et la synchronisation labiale en une seule étape. C’est nettement plus rapide que d’exécuter la traduction et la synchronisation comme deux processus séparés.
Créez votre première vidéo synchronisée dès aujourd’hui
La synchronisation labiale par IA a largement dépassé le stade de la nouveauté. C’est désormais un outil prêt pour la production, qui a sa place dans tout flux de travail vidéo sérieux, que vous localisiez un contenu pour un nouveau marché, corrigiez une réplique en post-production ou construisiez de zéro un flux de porte-parole IA évolutif.
Les modèles de PicassoIA vous donnent accès à l’ensemble des outils, des options rapides grand public comme Lipsync Speed à la qualité de niveau studio de Lipsync 2 Pro, sans avoir à souscrire à une dizaine de plateformes différentes. Choisissez un court extrait, préparez un audio propre et essayez votre première synchronisation dès maintenant dans la collection de synchronisation labiale de PicassoIA.
Questions fréquentes
Qu’est-ce que la synchronisation labiale par IA ?
La synchronisation labiale par IA consiste à utiliser l’intelligence artificielle pour faire correspondre les mouvements de bouche d’une personne dans une vidéo à une nouvelle piste audio. Le modèle analyse l’audio pour en extraire les phonèmes et utilise ces données pour régénérer la zone de la bouche de la vidéo afin qu’elle corresponde.
Comment fonctionne la synchronisation labiale par IA ?
Le modèle décompose votre audio en phonèmes, les associe à leurs équivalents visuels appelés visèmes, puis utilise un processus de diffusion ou de régression pour générer de nouveaux mouvements de bouche, image par image, alignés sur l’audio.
Quelle est la différence entre la synchronisation labiale par IA et un deepfake ?
La synchronisation labiale travaille à partir de séquences existantes d’une personne réelle et ne modifie que les mouvements de la bouche pour correspondre au nouvel audio. Elle ne remplace pas l’identité de la personne et ne génère pas de faux visage. Les deepfakes, en revanche, remplacent l’intégralité du visage ou l’identité d’un sujet.
Quels types de contenus profitent le plus de la synchronisation labiale par IA ?
Les contenus localisés ou doublés en tirent le plus de profit, mais elle est aussi précieuse pour les corrections de dialogues en post-production, les vidéos d’avatars IA, les contenus de porte-parole d’entreprise et les modules de e-learning.
Qu’est-ce qui rend un résultat de synchronisation labiale par IA médiocre ?
Les causes les plus fréquentes sont un audio bruité ou compressé, des angles de caméra de profil ou obstrués, des images sources de faible résolution et une parole rapide ou fortement accentuée. Des entrées propres produisent des sorties propres.
Comment obtenir les meilleurs résultats ?
Partez d’un audio propre et sec et de séquences de haute qualité filmées de face ou légèrement de trois quarts. Choisissez un modèle adapté à votre usage et vérifiez toujours le résultat en pleine résolution avant publication.


