AuraFlow llegó sin hacer ruido a Hugging Face a mediados de 2024, pero la reacción de la comunidad de imágenes con IA fue de todo menos silenciosa. Cloneofsimo y colaboradores publicaron un nuevo modelo de texto a imagen de código abierto basado en flow matching, y en cuestión de días, investigadores y creadores ya estaban ejecutando benchmarks, comparando resultados y publicando imágenes de muestra que rivalizaban con modelos tres veces más grandes. Esto no es otra actualización incremental de las arquitecturas existentes. AuraFlow es un intento desde cero de repensar cómo deberían construirse los modelos de generación de imágenes de código abierto, y los resultados merecen mucha atención.
Qué es AuraFlow realmente
AuraFlow es un modelo de texto a imagen que genera imágenes fotorrealistas y artísticas a partir de prompts en lenguaje natural. Está construido sobre una arquitectura basada en transformer y entrenado con flow matching, un objetivo de entrenamiento fundamentalmente distinto al proceso de difusión por eliminación de ruido que usan la mayoría de los modelos populares de hoy.
El modelo se publicó con pesos abiertos bajo una licencia permisiva, lo que significa que cualquiera puede descargarlo, ejecutarlo, ajustarlo o construir sobre él. Esa apertura es importante: sitúa a AuraFlow en la misma categoría que FLUX y las primeras versiones de Stable Diffusion, en lugar de las APIs comerciales cerradas, donde pagas por imagen y nunca ves la arquitectura subyacente.
Flow matching, no difusión
La mayoría de los modelos de imágenes con IA que has usado, desde Stable Diffusion hasta SDXL, se basan en modelos probabilísticos de difusión con eliminación de ruido (DDPM). El proceso consiste en aprender a invertir un proceso que añade ruido: dada una imagen llena de ruido aleatorio, el modelo lo elimina progresivamente hasta que aparece una imagen coherente.
Flow matching sigue un camino distinto. En lugar de aprender a eliminar el ruido paso a paso, entrena al modelo para aprender un campo vectorial continuo que lleva el ruido puro directamente a los datos. Piénsalo como trazar una línea recta del caos al orden, en lugar de dar cientos de pequeños pasos de eliminación de ruido sin una dirección clara.
Esto tiene consecuencias prácticas:
- Menos pasos de inferencia necesarios para generar imágenes de alta calidad
- Interpolación más suave entre conceptos y estilos de imagen
- Mayor estabilidad de entrenamiento con escalas de parámetros grandes
- Mayor coherencia del prompt en descripciones complejas con varios elementos
La arquitectura que hay detrás
AuraFlow usa un backbone basado en transformer en lugar de la arquitectura U-Net que dominó los modelos de difusión de primera y segunda generación. Esto lo sitúa en la misma familia arquitectónica que FLUX y Imagen 3 de Google.
El modelo procesa tokens de texto e imagen juntos en un único mecanismo de atención unificado, lo que le permite mantener una mayor coherencia en descripciones complejas. Cuando le pides que genere una mujer de pie en un campo de trigo al atardecer, con un vestido de seda color crema, no olvida el vestido de seda crema a mitad del render del atardecer. Esa coherencia a largo alcance ha sido una debilidad persistente de los modelos de difusión con U-Net más antiguos.
Por qué el código abierto cambia las cosas
La publicación de los pesos de AuraFlow importa por motivos que van más allá de un modelo gratuito más para probar. Representa un compromiso continuo de la comunidad investigadora por mantener la generación de imágenes de vanguardia al alcance de cualquiera que tenga una GPU capaz y ganas de experimentar.
Acceso a los pesos del modelo
Cuando un modelo publica sus pesos abiertos, el valor real no es solo la inferencia gratuita. Es la capacidad de:
- Ejecutar el modelo en local, sin límites de peticiones de la API ni costos por imagen
- Ajustarlo con conjuntos de datos propios para igualar un estilo fotográfico o artístico concreto
- Integrarlo en flujos de trabajo de producción sin depender de un proveedor
- Crear modelos derivados y devolver las mejoras a la comunidad
Los pesos de AuraFlow están disponibles directamente a través de Hugging Face, compatibles con la biblioteca diffusers. Esto significa que cualquiera con una GPU de consumo puede ejecutarlo sin costos de cómputo en la nube ni restricciones de cuenta.
Iteración impulsada por la comunidad
Los modelos de código abierto mejoran más rápido que los cerrados, una vez que superan un umbral de calidad crítico. La familia FLUX lo demostró: en cuestión de semanas desde el lanzamiento de Dev, la comunidad había creado ajustes finos con LoRA, adaptadores ControlNet y variantes fusionadas que elevaron el techo de calidad muy por encima de lo que logró el modelo base por sí solo.
AuraFlow está en posición de beneficiarse de la misma dinámica. Los investigadores pueden auditar la metodología de entrenamiento, identificar fallos y proponer mejoras específicas. Ese tipo de iteración colaborativa no ocurre con modelos solo accesibles por API, donde los pesos permanecen privados.
💡 La ventaja de los pesos abiertos: Un modelo que puedes ajustar vale diez veces más que uno que solo puedes usar con prompts. El ajuste fino reduce la distancia entre los resultados genéricos de la IA y un resultado que coincide con tu estilo visual específico, tu identidad de marca o tus requisitos de producción.
AuraFlow frente a la competencia
AuraFlow no existe en el vacío. Se incorpora a un ecosistema en el que FLUX.1 Dev, SDXL y Stable Diffusion 3 compiten por la misma base de usuarios. Esta es una comparación honesta basada en resultados documentados y benchmarks de la comunidad.
Cómo se compara con FLUX
| Característica | AuraFlow | FLUX.1 Dev |
|---|
| Arquitectura | Transformer (flow matching) | Transformer (flow matching) |
| Pesos abiertos | Sí, permisiva | Sí, no comercial |
| Pasos de inferencia | 20 a 30 | 20 a 50 |
| Requisito de VRAM | ~12GB fp16 | ~16 a 24GB |
| Adherencia al prompt | Sólida | Muy sólida |
| Ecosistema de la comunidad | En crecimiento | Amplio y activo |
| Calidad de retratos | Excelente | Muy buena |
| Accesibilidad de hardware | GPU de gama media | GPU de gama alta |
FLUX.1 Dev, que puedes usar a través del modelo Flux Redux Dev en PicassoIA, tiene actualmente un ecosistema de comunidad más grande y una adherencia al prompt ligeramente mejor en prompts muy complejos con varios sujetos. Pero AuraFlow reduce bastante esa distancia en retratos y generación de sujetos humanos, un punto que históricamente ha sido débil en los modelos de imagen basados en transformer a esta escala de parámetros.
AuraFlow también necesita menos VRAM, lo que supone una ventaja práctica importante. Una GPU de 12GB puede ejecutar AuraFlow con precisión completa, mientras que FLUX.1 Dev requiere entre 16 y 24GB para una calidad similar.
Dónde SDXL todavía tiene ventaja
La principal ventaja de SDXL es su enorme ecosistema de ajustes finos con LoRA y checkpoints de la comunidad. Si necesitas un estilo visual muy concreto que ya se ha entrenado en un LoRA existente (una estética artística particular, un estilo de marca, una configuración de iluminación específica), es probable que SDXL lo tenga. AuraFlow todavía no tiene esa biblioteca.
Sin embargo, en calidad de modelo base sin ningún ajuste fino, AuraFlow supera a SDXL en la mayoría de los casos de uso fotorrealistas: sujetos humanos, precisión de la iluminación natural y coherencia del prompt en descripciones detalladas.
💡 Cuándo usar AuraFlow: Fotorrealismo sólido desde el primer uso, sin ajuste fino. Cuándo quedarte con SDXL: si necesitas un LoRA o checkpoint concreto de la biblioteca consolidada de la comunidad que todavía no existe para AuraFlow.
La calidad de los resultados en la práctica
Los benchmarks y las explicaciones de arquitectura solo cuentan una parte de la historia. Lo que más importa es si el modelo produce imágenes que se ven bien sin mucho posprocesado ni elegir a mano entre decenas de resultados descartados.
Retratos y sujetos humanos
Aquí es donde AuraFlow realmente impresiona. El retrato humano ha sido uno de los retos más persistentes en los modelos de imagen de código abierto, especialmente en las manos, la simetría facial y la microtextura natural de la piel.
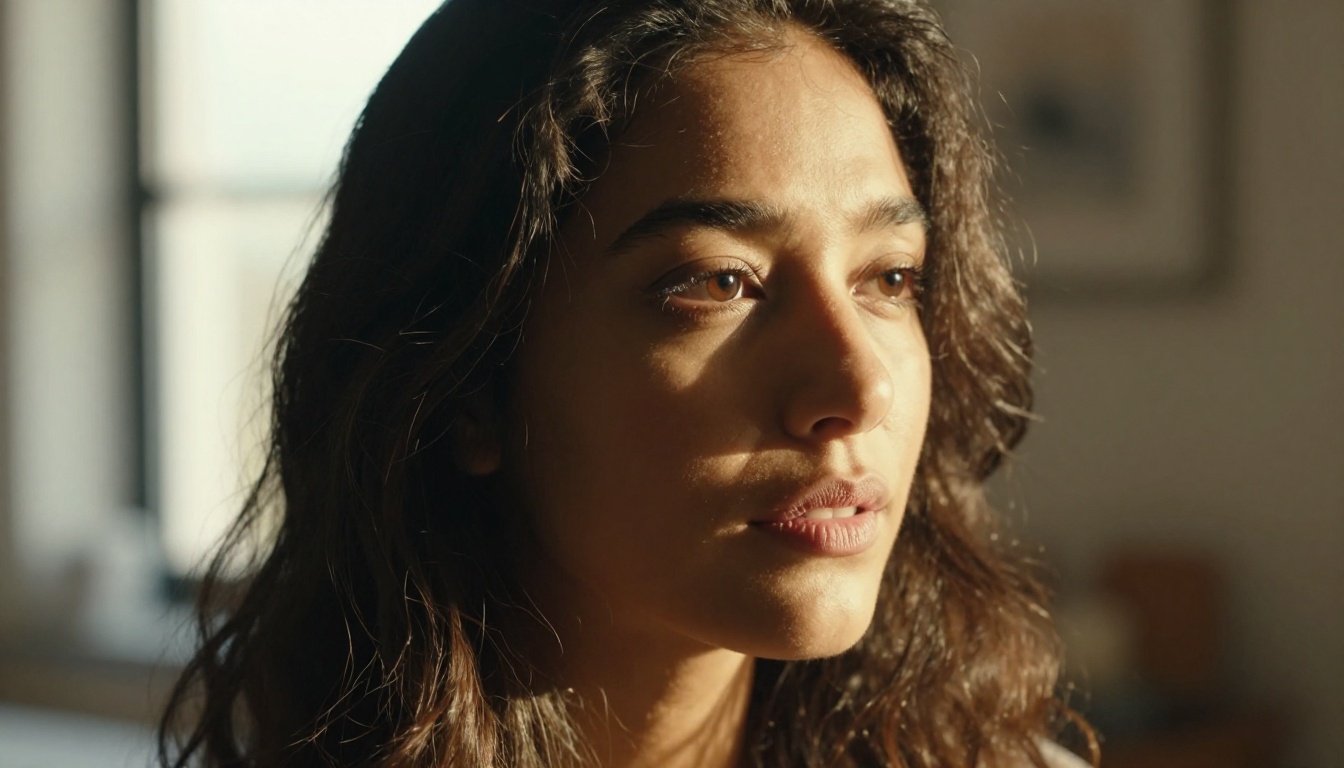
AuraFlow produce retratos con:
- Textura natural de la piel, con poros visibles y líneas finas, sin la suavidad de plástico habitual en los primeros modelos de difusión
- Renderizado preciso de los ojos, con reflejos (catchlights) correctos, detalle del iris y profundidad de las pestañas
- Geometría facial coherente en distintas condiciones de iluminación y descripciones del prompt
- Cabello realista, con variación de mechones individuales en lugar de masas de aspecto pintado o simetría artificial
Para quien genera retratos de personajes, fotos de perfil con estilo fotográfico o imágenes editoriales, esta es una mejora significativa respecto a lo que ofrecían las opciones de código abierto anteriores con costos de inferencia comparables.
Paisajes y arquitectura
La generación de paisajes se beneficia del enfoque de entrenamiento por flow matching de AuraFlow. El modelo maneja la perspectiva atmosférica, las transiciones de iluminación en escenas amplias y texturas orgánicas complejas como el follaje, el agua y la roca con una fuerte coherencia interna.
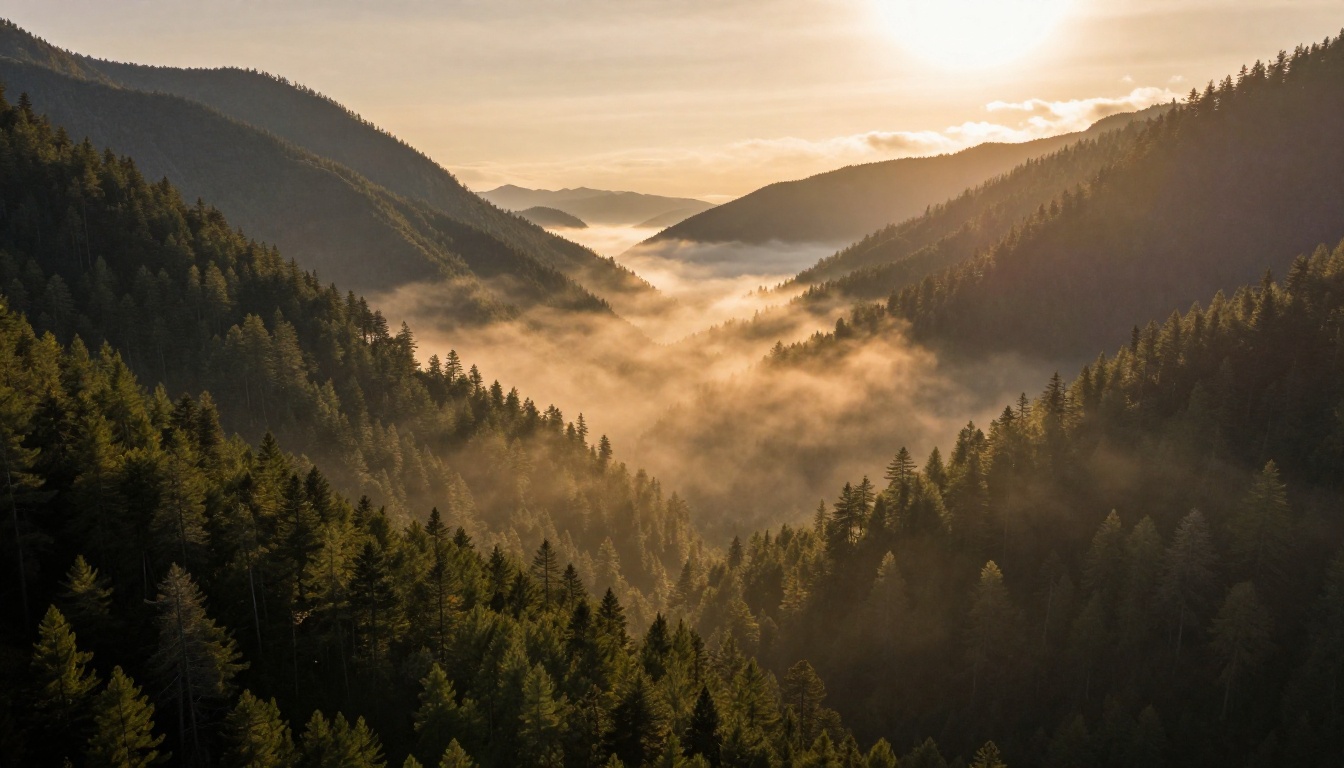
El proceso de entrenamiento permite un manejo más suave de los grandes elementos de composición. El cielo, el plano medio y el primer plano de un paisaje mantienen relaciones tonales adecuadas, sin el aspecto de "pegado" que a veces producían los modelos anteriores al intentar renderizar escenas complejas de varios planos con iluminación variada.
Moda y fotografía editorial
Para imágenes de moda y de estilo de fotografía comercial, AuraFlow aguanta muy bien la comparación con modelos ajustados específicamente para ello. La textura de las telas, la caída de la ropa y la interacción de la luz con distintos materiales (seda, lino, denim, cuero) se representan con una precisión fotográfica que resulta real y no simulada.
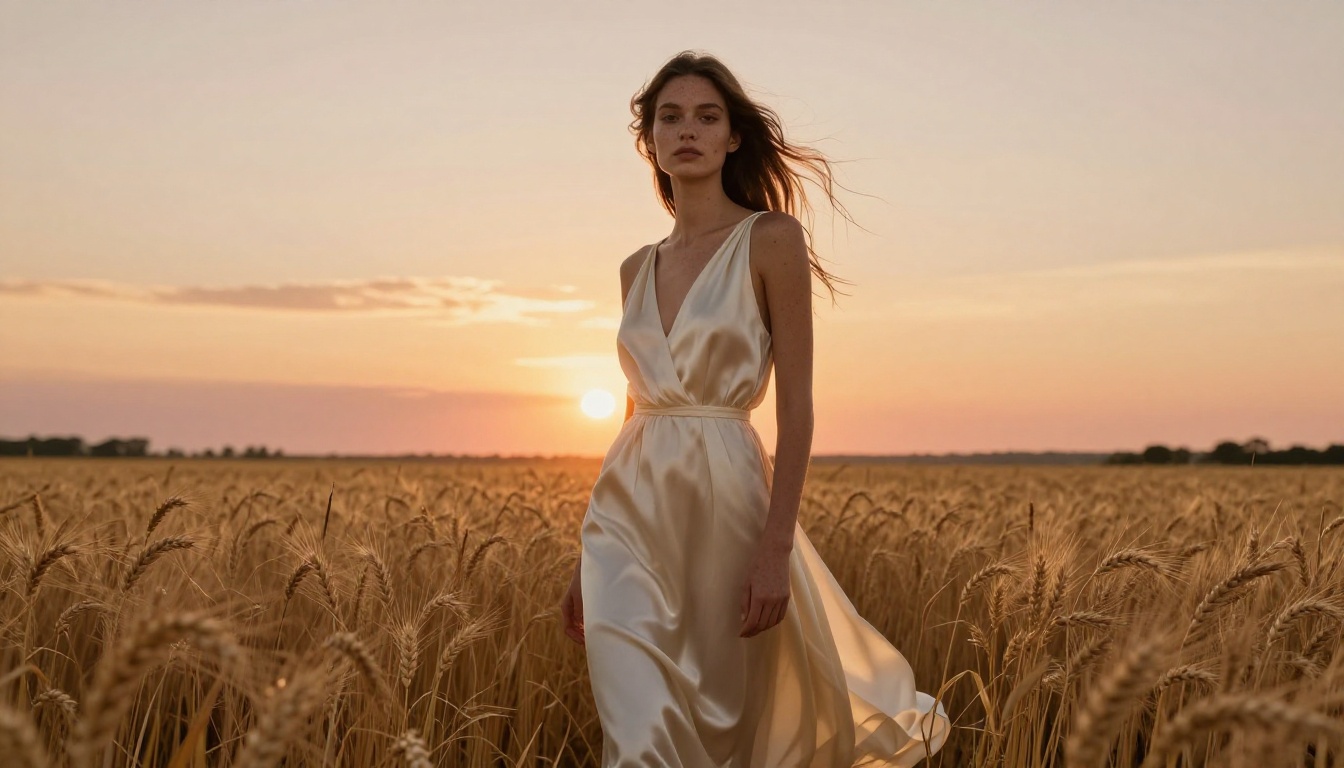
El modelo también maneja con soltura escenarios de iluminación complejos. El contraluz que crea halos de luz en los bordes, la luz moteada que se filtra entre el follaje y produce una iluminación irregular, y las configuraciones de iluminación direccional al estilo de estudio dan resultados que parecen fotográficos y no renderizados de forma algorítmica.
Imágenes espontáneas y de estilo de vida
Las imágenes de estilo espontáneo, con varios sujetos, expresiones naturales y contexto ambiental, son notoriamente difíciles para los modelos de imagen con IA. Las interacciones entre personas suelen parecer posadas, físicamente torpes o emocionalmente vacías.
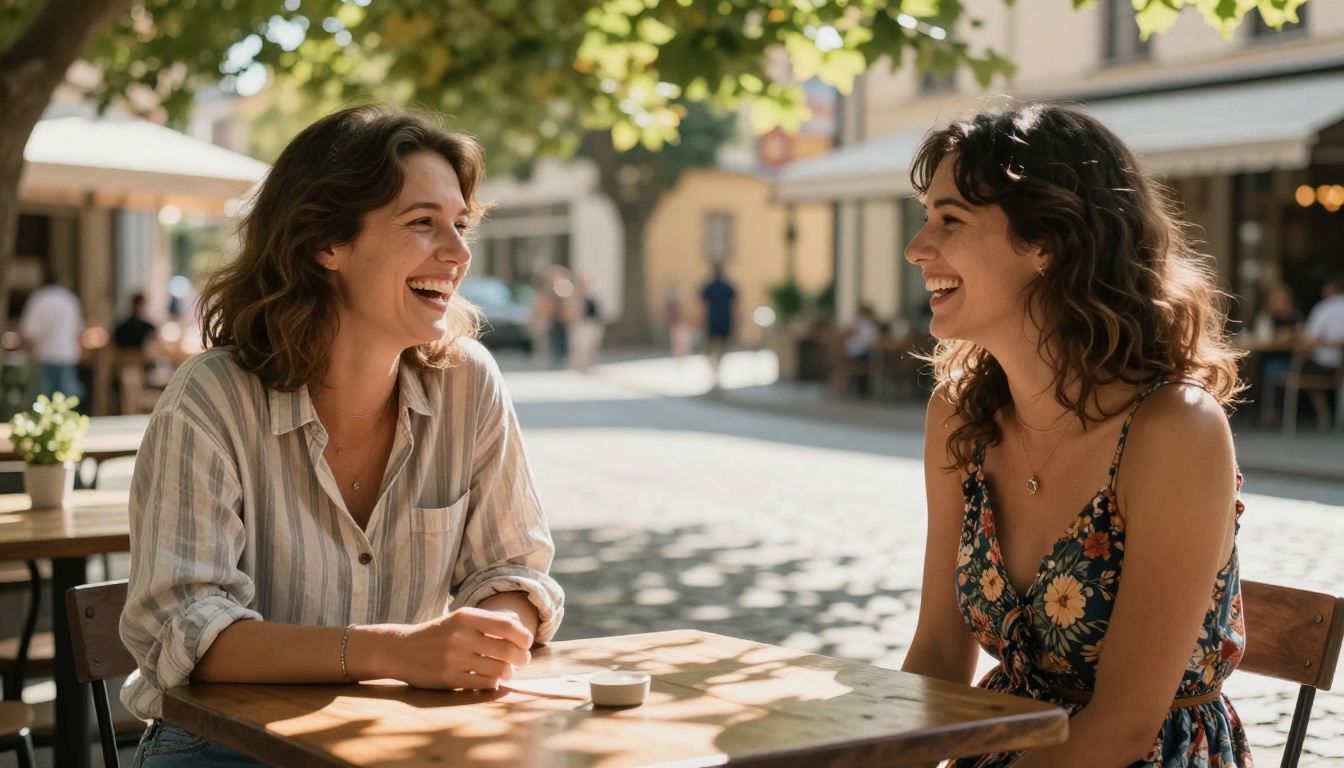
La sólida coherencia del prompt de AuraFlow ayuda aquí. Especificar un contexto emocional en el prompt (risa genuina, conversación relajada, concentración) se traduce en imágenes donde las expresiones y el lenguaje corporal realmente se leen como naturales. El modelo no recurre a caras vacías ni a sonrisas forzadas cuando recibe una dirección emocional descriptiva en el prompt.
Ejecutar AuraFlow en tu propio hardware
AuraFlow está disponible a través del hub de modelos de Hugging Face y es compatible con el pipeline estándar de diffusers. Ponerlo en marcha en local es sencillo para quien ya haya configurado un modelo similar.
Requisitos de hardware
| Configuración | VRAM mínima | Velocidad de generación (aprox.) |
|---|
| fp16 precisión completa | 12GB | ~45 segundos por imagen |
| fp8 cuantizado | 8GB | ~90 segundos por imagen |
| Modo de descarga a CPU | 8GB de VRAM | De 3 a 5 minutos por imagen |
Una GPU de gama media como la RTX 3080 o la RTX 4070 puede ejecutar AuraFlow en fp16 sin problemas. Esta es una ventaja de accesibilidad importante frente a FLUX.1 Dev, que a menudo requiere hardware de gama alta para obtener resultados de calidad equivalente.
Configuración y requisitos
La biblioteca diffusers gestiona AuraFlow de forma nativa a través de su interfaz de pipeline estándar. Una configuración local básica requiere:
- Python 3.10 o superior como entorno de ejecución
- PyTorch 2.x con CUDA para la aceleración por GPU
- Las bibliotecas Python diffusers, transformers y accelerate
- El checkpoint del modelo desde Hugging Face, una descarga de unos 12GB
El pipeline de muestreo acepta parámetros estándar. Un guidance scale (CFG) entre 3,5 y 7,0 produce los mejores resultados para salidas fotorrealistas, es decir, define cuánto se ajusta la imagen al prompt. Entre 20 y 30 pasos cubren la mayoría de los casos de uso, y con más pasos (hasta 50) se obtienen mejoras de calidad marginales en escenas muy detalladas, a costa de más tiempo de generación.
💡 Consejo para el prompt: AuraFlow responde muy bien a descripciones detalladas de escenas. Añadir la dirección de la luz ("luz suave de la mañana desde la izquierda"), parámetros de lente ("85mm f/1.8 con poca profundidad de campo") y detalles del material ("seda con caída y textura visibles") eleva el fotorrealismo bastante más que los prompts genéricos y cortos.
Qué significa esto para los creadores de imágenes con IA
La publicación de AuraFlow forma parte de una tendencia que se está acelerando: la distancia entre los modelos comerciales cerrados y las alternativas de código abierto se reduce más rápido de lo que la mayoría esperaba. Hace tres años, la mejor generación de imágenes requería acceso a la API restringida de DALL-E 2. Hoy, el ecosistema de código abierto incluye modelos de flow matching basados en transformer que igualan la calidad comercial en la mayoría de los casos de uso prácticos.
El cambio en el panorama de imágenes de código abierto
Para los creadores, esto se traduce en ventajas concretas:
- Más control: ajusta con tus propios datos, conserva los pesos y sé dueño del estilo
- Costos más bajos: sin tarifas por imagen cuando se ejecuta en local a gran escala
- Sin dependencia de un proveedor: tu flujo de trabajo no se rompe cuando una API cambia sus precios
- Mejoras de la comunidad: el modelo mejorará a medida que los investigadores construyan sobre él de forma pública
AuraFlow se suma a FLUX como prueba de que la generación de imágenes de código abierto ha llegado a un punto en el que la pregunta ya no es "¿es lo bastante bueno?", sino "¿qué fortalezas concretas se ajustan a mi caso de uso?". Ambos modelos producen imágenes comercialmente viables a partir de un modelo base sin ajuste fino, algo que no era cierto para las opciones de código abierto ni siquiera hace 18 meses.
La combinación de arquitectura de flow matching, fotorrealismo sólido en sujetos humanos, requisitos de hardware más bajos que los de modelos comparables y pesos totalmente abiertos convierte a AuraFlow en una de las publicaciones más interesantes de síntesis de imágenes con IA en 2024. Tanto si lo ejecutas en local como si accedes a él a través de una plataforma, merece un lugar en tu radar para entender en qué punto se encuentra el campo.
Empieza a generar con modelos de imágenes con IA hoy
Si quieres poner a trabajar las capacidades de los modelos de imágenes con IA más recientes sin configurar un entorno local, Picasso IA te da acceso a una amplia biblioteca de modelos profesionales de texto a imagen, incluidos Flux Redux Dev y docenas de otros modelos para distintos estilos y tipos de salida.
La plataforma te permite generar retratos fotorrealistas, fotografías editoriales de moda, paisajes dramáticos e imágenes de estilo de vida espontáneas directamente a partir de prompts de texto, sin necesidad de configurar una GPU local ni un entorno de Python. Puedes experimentar con distintos estilos de prompt, comparar resultados entre modelos y ver de primera mano qué producen las arquitecturas basadas en flow matching frente a los pipelines de difusión tradicionales.
Tanto si eres fotógrafo y prototipas conceptos de toma antes de un día de producción costoso, como diseñador que crea contenido visual a gran escala o desarrollador que evalúa qué modelo encaja con tu producto, la forma más rápida de formarte una opinión fundada es empezar a generar. Elige una escena concreta, escribe un prompt detallado y comprueba lo que la generación actual de modelos de imagen de código abierto es capaz de producir de verdad.


