AuraFlow मध्य-2024 में चुपचाप Hugging Face पर आया, लेकिन AI इमेज कम्युनिटी की प्रतिक्रिया बिल्कुल भी चुप नहीं थी। Cloneofsimo और सहयोगियों ने फ़्लो मैचिंग पर बना एक नया ओपन-सोर्स टेक्स्ट-टू-इमेज मॉडल जारी किया, और कुछ ही दिनों में रिसर्चर और क्रिएटर्स बेंचमार्क चलाने, आउटपुट की तुलना करने और ऐसी सैंपल इमेज पोस्ट करने लगे जो तीन गुना बड़े मॉडलों से टक्कर लेती थीं। यह मौजूदा आर्किटेक्चर का कोई और इंक्रीमेंटल अपडेट नहीं है। AuraFlow शून्य से शुरू की गई कोशिश है कि ओपन-सोर्स इमेज जनरेशन मॉडल कैसे बनाए जाने चाहिए, इस पर नए सिरे से सोचा जाए, और इसके नतीजे ध्यान से देखने लायक हैं।
AuraFlow असल में क्या है
AuraFlow एक टेक्स्ट-टू-इमेज मॉडल है जो प्राकृतिक भाषा के प्रॉम्प्ट से फोटोरियलिस्टिक और आर्टिस्टिक दोनों तरह की इमेज बनाता है। यह ट्रांसफ़ॉर्मर-आधारित आर्किटेक्चर पर बना है और फ़्लो मैचिंग से प्रशिक्षित है, जो आज की ज़्यादातर लोकप्रिय मॉडलों में इस्तेमाल होने वाली डिनॉइज़िंग डिफ्यूज़न प्रक्रिया से मूल रूप से अलग ट्रेनिंग उद्देश्य है।
इस मॉडल को परमिसिव लाइसेंस के तहत ओपन वेट्स के साथ जारी किया गया है, यानी कोई भी इसे डाउनलोड, चला, फ़ाइन-ट्यून या इसके ऊपर कुछ बना सकता है। यह खुलापन अहम है: यह AuraFlow को FLUX और शुरुआती Stable Diffusion रिलीज़ की श्रेणी में रखता है, न कि उन बंद कमर्शियल APIs की श्रेणी में जहाँ आप हर इमेज का भुगतान करते हैं और अंदरूनी आर्किटेक्चर कभी नहीं देख पाते।
फ़्लो मैचिंग, डिफ्यूज़न नहीं
आपने जिन AI इमेज मॉडलों का इस्तेमाल किया है, Stable Diffusion से लेकर SDXL तक, वे ज़्यादातर डिनॉइज़िंग डिफ्यूज़न प्रोबेबिलिस्टिक मॉडल (DDPMs) पर बने हैं। यह प्रक्रिया नॉइज़ जोड़ने की प्रक्रिया को उलटना सीखकर काम करती है: जिस इमेज में ढेर सारा रैंडम नॉइज़ हो, मॉडल उसे चरण-दर-चरण हटाता जाता है, जब तक एक सुसंगत इमेज सामने न आ जाए।
फ़्लो मैचिंग अलग रास्ता लेती है। चरण-दर-चरण डिनॉइज़ करना सीखने के बजाय, फ़्लो मैचिंग मॉडल को एक कंटिन्यूअस वेक्टर फ़ील्ड सीखने की ट्रेनिंग देती है, जो शुद्ध नॉइज़ को सीधे डेटा तक ले जाती है। इसे ऐसे समझें जैसे अराजकता से व्यवस्था तक एक सीधा रास्ता खींचा जा रहा हो, बजाय इसके कि बिना साफ़ दिशा के सैकड़ों छोटे डिनॉइज़िंग कदम उठाए जाएँ।
इसके व्यावहारिक नतीजे ये हैं:
- कम इनफ़रेंस स्टेप लगते हैं उच्च-गुणवत्ता वाली इमेज बनाने के लिए
- इमेज कॉन्सेप्ट और स्टाइल के बीच स्मूद इंटरपोलेशन
- बड़े पैरामीटर स्केल पर बेहतर ट्रेनिंग स्थिरता
- जटिल, कई-तत्वों वाले विवरणों में मज़बूत प्रॉम्प्ट कोहेरेंस
इसके पीछे का आर्किटेक्चर
AuraFlow ट्रांसफ़ॉर्मर-आधारित बैकबोन इस्तेमाल करता है, न कि उस U-Net आर्किटेक्चर को जो पहली और दूसरी पीढ़ी के डिफ्यूज़न मॉडलों पर हावी था। इस तरह यह FLUX और Google के Imagen 3 के उसी आर्किटेक्चरल परिवार में आता है।
यह मॉडल टेक्स्ट और इमेज टोकन को एक ही यूनिफ़ाइड अटेंशन मेकेनिज़्म में एक साथ प्रोसेस करता है, जिससे जटिल विवरणों में यह ज़्यादा मज़बूत सुसंगतता बनाए रख पाता है। जब आप इसे कहते हैं कि सूर्यास्त के समय गेहूँ के खेत में खड़ी एक महिला बनाए जिसने क्रीम सिल्क ड्रेस पहनी है, तो रेंडरिंग के बीच में वह क्रीम सिल्क ड्रेस को भूलती नहीं है। इस तरह की लंबी दूरी की सुसंगति पुराने U-Net डिफ्यूज़न मॉडलों की लगातार कमज़ोरी रही है।
ओपन सोर्स चीज़ें क्यों बदलता है
AuraFlow के वेट्स का जारी होना सिर्फ़ एक और मुफ़्त मॉडल आज़माने से कहीं ज़्यादा मायने रखता है। यह रिसर्च कम्युनिटी की उस प्रतिबद्धता को दिखाता है कि फ्रंटियर इमेज जनरेशन हर उस व्यक्ति के लिए सुलभ रहे जिसके पास सक्षम GPU और प्रयोग करने की इच्छा हो।
मॉडल वेट्स तक पहुँच
जब कोई मॉडल ओपन वेट्स जारी करता है, तो असली मूल्य सिर्फ़ मुफ़्त इनफ़रेंस नहीं होता। असली मूल्य यह क्षमता है कि आप:
- API रेट लिमिट या प्रति-इमेज खर्च के बिना मॉडल को लोकल तौर पर चला सकें
- किसी खास फ़ोटोग्राफ़िक या कलात्मक स्टाइल से मेल खाने के लिए कस्टम डेटासेट पर फ़ाइन-ट्यून कर सकें
- वेंडर लॉक-इन के बिना प्रोडक्शन वर्कफ़्लो में इंटीग्रेट कर सकें
- डेरिवेटिव मॉडल बना सकें और सुधार कम्युनिटी के साथ साझा कर सकें
AuraFlow के वेट्स सीधे Hugging Face के ज़रिए उपलब्ध हैं और diffusers लाइब्रेरी के साथ संगत हैं। इसका मतलब है कि कंज़्यूमर-ग्रेड GPU वाला कोई भी व्यक्ति इसे बिना क्लाउड कंप्यूट खर्च या अकाउंट की पाबंदियों के चला सकता है।
कम्युनिटी-संचालित सुधार
ओपन-सोर्स मॉडल एक खास क्वालिटी थ्रेशोल्ड पार करने के बाद बंद मॉडलों से तेज़ी से सुधरते हैं। FLUX परिवार ने यह साबित किया: उसके Dev रिलीज़ के कुछ ही हफ़्तों के भीतर कम्युनिटी ने LoRA फ़ाइन-ट्यून, ControlNet एडैप्टर और मर्ज्ड वर्ज़न बना दिए, जिन्होंने क्वालिटी की सीमा को बेस मॉडल के अपने दम पर हासिल किए स्तर से काफ़ी ऊपर धकेल दिया।
AuraFlow भी इसी गतिशीलता से फ़ायदा उठाने की स्थिति में है। रिसर्चर ट्रेनिंग मेथडोलॉजी का ऑडिट कर सकते हैं, फ़ेल्योर मोड पहचान सकते हैं और लक्षित सुधार सुझा सकते हैं। इस तरह का सहयोगी सुधार उन API-only मॉडलों में नहीं होता जिनके वेट्स निजी रहते हैं।
💡 ओपन वेट्स का फ़ायदा: जिस मॉडल को आप फ़ाइन-ट्यून कर सकते हैं, वह उस मॉडल से दस गुना कीमती है जिसे आप सिर्फ़ प्रॉम्प्ट दे सकते हैं। फ़ाइन-ट्यूनिंग सामान्य AI आउटपुट और आपकी खास विज़ुअल स्टाइल, ब्रैंड पहचान या प्रोडक्शन ज़रूरतों से मेल खाने वाले आउटपुट के बीच का फ़ासला मिटा देती है।
AuraFlow बनाम प्रतिस्पर्धा
AuraFlow किसी अलग-थलग दुनिया में मौजूद नहीं है। यह एक ऐसे इकोसिस्टम में आता है जहाँ FLUX.1 Dev, SDXL और Stable Diffusion 3 एक ही यूज़र बेस के लिए होड़ में हैं। यहाँ दस्तावेज़ीकृत आउटपुट और कम्युनिटी बेंचमार्क के आधार पर एक ईमानदार तुलना है।
FLUX के मुकाबले यह कैसा ठहरता है
| विशेषता | AuraFlow | FLUX.1 Dev |
|---|
| आर्किटेक्चर | Transformer (फ़्लो मैचिंग) | Transformer (फ़्लो मैचिंग) |
| ओपन वेट्स | हाँ, परमिसिव | हाँ, नॉन-कमर्शियल |
| इनफ़रेंस स्टेप्स | 20 से 30 | 20 से 50 |
| VRAM आवश्यकता | ~12GB fp16 | ~16 से 24GB |
| प्रॉम्प्ट एडहेरेंस | मज़बूत | बहुत मज़बूत |
| कम्युनिटी इकोसिस्टम | बढ़ता हुआ | बड़ा और सक्रिय |
| पोर्ट्रेट क्वालिटी | उत्कृष्ट | बहुत अच्छी |
| हार्डवेयर सुलभता | मिड-रेंज GPU | हाई-एंड GPU |
FLUX.1 Dev, जिसे आप PicassoIA पर Flux Redux Dev मॉडल के ज़रिए इस्तेमाल कर सकते हैं, फ़िलहाल बड़ा कम्युनिटी इकोसिस्टम रखता है और अत्यधिक जटिल मल्टी-सब्जेक्ट प्रॉम्प्ट पर थोड़ा बेहतर प्रॉम्प्ट एडहेरेंस दिखाता है। लेकिन AuraFlow पोर्ट्रेट और इंसानी सब्जेक्ट जनरेशन में यह अंतर काफ़ी हद तक पाट देता है, जो इस पैरामीटर स्केल पर ट्रांसफ़ॉर्मर-आधारित इमेज मॉडलों की ऐतिहासिक रूप से कमज़ोर कड़ी रही है।
AuraFlow कम VRAM पर भी चलता है, जो एक व्यावहारिक और अहम फ़ायदा है। 12GB GPU पर AuraFlow पूरी प्रिसिज़न पर चल सकता है, जबकि इसी जैसी क्वालिटी के लिए FLUX.1 Dev को 16 से 24GB चाहिए।
जहाँ SDXL अब भी आगे है
SDXL की मुख्य ताक़त उसका विशाल LoRA फ़ाइन-ट्यून और कम्युनिटी चेकपॉइंट्स का इकोसिस्टम है। अगर आपको कोई बहुत खास विज़ुअल स्टाइल चाहिए जो किसी मौजूदा LoRA में ट्रेन हो चुकी हो (कोई खास आर्टिस्ट की सौंदर्य शैली, ब्रैंड स्टाइल या कोई खास लाइटिंग सेटअप), तो SDXL के पास शायद वह होगा। AuraFlow के पास वह लाइब्रेरी अभी नहीं है।
हालाँकि, बिना किसी फ़ाइन-ट्यूनिंग के बेस मॉडल क्वालिटी के लिए, AuraFlow ज़्यादातर फ़ोटोरियलिस्टिक उपयोगों में SDXL से बेहतर प्रदर्शन करता है: इंसानी सब्जेक्ट, प्राकृतिक लाइटिंग की सटीकता और वर्णनात्मक प्रॉम्प्ट पर प्रॉम्प्ट कोहेरेंस।
💡 AuraFlow कब इस्तेमाल करें: बिना फ़ाइन-ट्यूनिंग के मज़बूत, तुरंत मिलने वाला फ़ोटोरियलिज़्म। SDXL पर कब टिके रहें: जब आपको स्थापित कम्युनिटी लाइब्रेरी का कोई खास LoRA या चेकपॉइंट चाहिए, जो AuraFlow के लिए अभी मौजूद ही नहीं है।
प्रैक्टिस में आउटपुट की गुणवत्ता
बेंचमार्क और आर्किटेक्चर की व्याख्याएँ कहानी का सिर्फ़ एक हिस्सा बताती हैं। सबसे ज़रूरी यह है कि क्या मॉडल वाकई ऐसी इमेज बनाता है जो भारी पोस्ट-प्रोसेसिंग या दर्जनों रिजेक्टेड आउटपुट में से चुनने के बिना अच्छी लगे।
पोर्ट्रेट और इंसानी सब्जेक्ट
यहीं AuraFlow सचमुच प्रभावित करता है। ओपन-सोर्स इमेज मॉडलों में इंसानी पोर्ट्रेट जनरेशन सबसे लगातार चुनौतियों में से एक रही है, खासकर हाथों, चेहरे की सममिति और प्राकृतिक त्वचा की बनावट के मामले में।
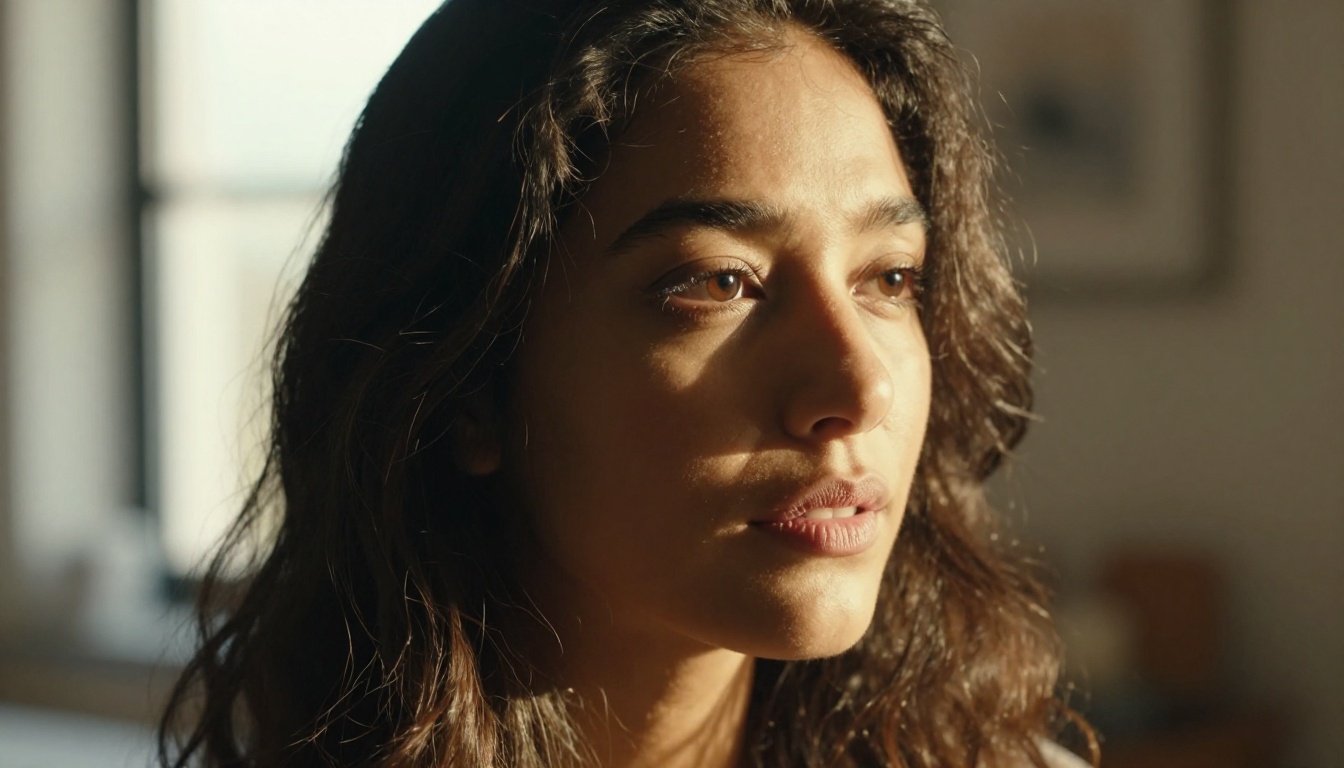
AuraFlow ऐसे पोर्ट्रेट बनाता है जिनमें:
- प्राकृतिक त्वचा की बनावट होती है, जिसमें दिखने वाले रोमछिद्र और बारीक लकीरें शामिल हैं, बिना उस प्लास्टिक जैसी चिकनाई के जो पुराने डिफ्यूज़न मॉडलों में आम थी
- सटीक आँख रेंडरिंग होती है, जिसमें सही कैचलाइट, आइरिस की डिटेल और पलकों की गहराई शामिल है
- सुसंगत चेहरे की ज्यामिति होती है, अलग-अलग लाइटिंग स्थितियों और प्रॉम्प्ट विवरणों में भी
- यथार्थवादी बाल होते हैं, जिनमें हर स्ट्रैंड की अलग बनावट होती है, न कि पेंट किए हुए जैसे गुच्छे या कृत्रिम सममिति
कैरेक्टर पोर्ट्रेट, फ़ोटोग्राफ़ी-शैली के हेडशॉट या एडिटोरियल इमेज बनाने वालों के लिए, यह तुलनीय इनफ़रेंस लागत पर पहले के ओपन-सोर्स विकल्पों से एक अहम सुधार है।
लैंडस्केप और आर्किटेक्चर
लैंडस्केप जनरेशन को AuraFlow के फ़्लो मैचिंग ट्रेनिंग तरीके से फ़ायदा मिलता है। मॉडल एटमॉस्फ़ेरिक परिप्रेक्ष्य, बड़े दृश्यों में लाइटिंग के बदलाव और पत्तियों, पानी और चट्टानों जैसी जटिल ऑर्गेनिक बनावटों को मज़बूत आंतरिक सुसंगति के साथ संभालता है।
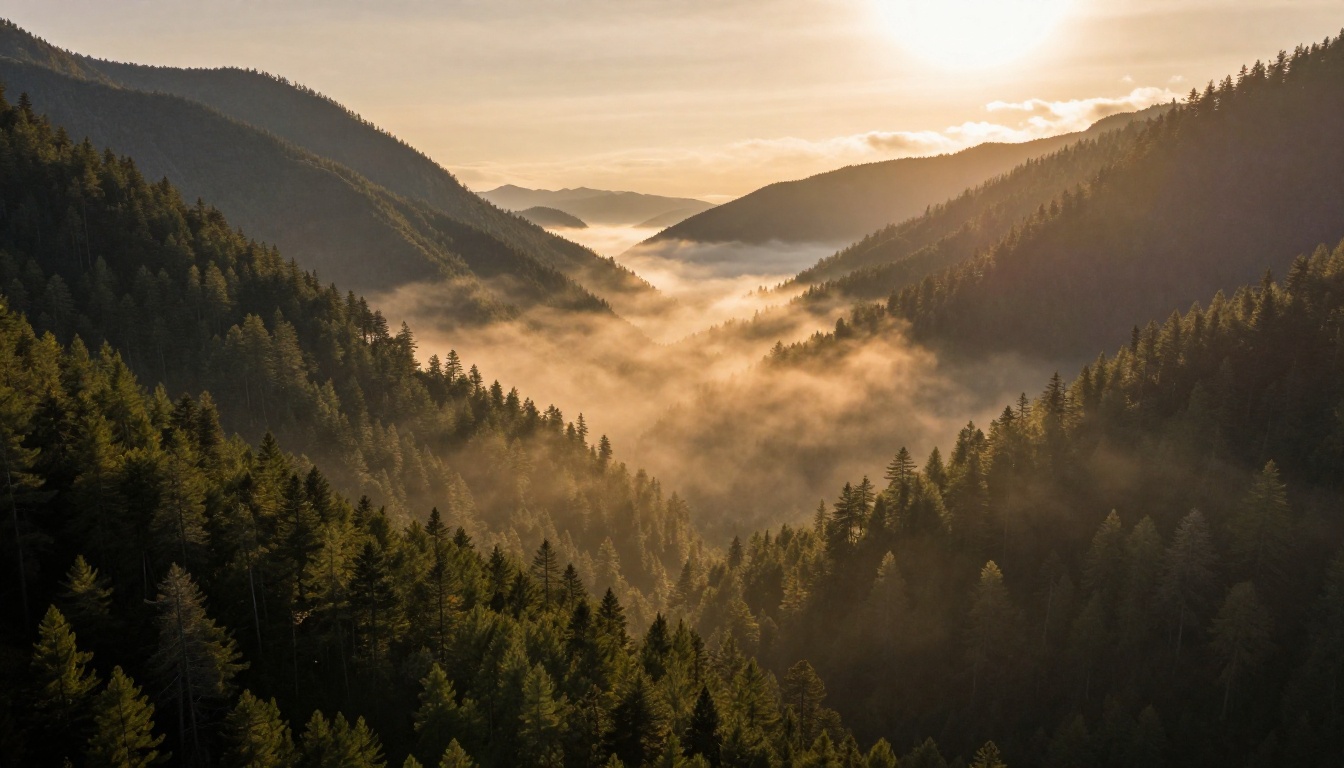
ट्रेनिंग प्रक्रिया बड़े कंपोज़िशनल तत्वों को ज़्यादा स्मूद तरीके से संभालने देती है। लैंडस्केप का आसमान, मिडग्राउंड और फ़ोरग्राउंड सही टोनल संबंध बनाए रखते हैं, बिना उस "चिपकाए हुए" लुक के जो पुराने मॉडल कभी-कभी तब देते थे जब वे अलग-अलग लाइटिंग वाले जटिल बहु-परत दृश्य बनाने की कोशिश करते थे।
फ़ैशन और एडिटोरियल शॉट्स
फ़ैशन और कमर्शियल फ़ोटोग्राफ़ी-शैली की इमेज के लिए, AuraFlow इसी काम के लिए बने फ़ाइन-ट्यून किए गए मॉडलों के मुकाबले भी अच्छा टिकता है। फ़ैब्रिक की बनावट, कपड़े का ड्रेप और अलग-अलग मटेरियल (सिल्क, लिनन, डेनिम, लेदर) पर रोशनी का असर ऐसी फ़ोटोग्राफ़िक सटीकता से रेंडर होता है जो असली लगता है, सिमुलेटेड नहीं।
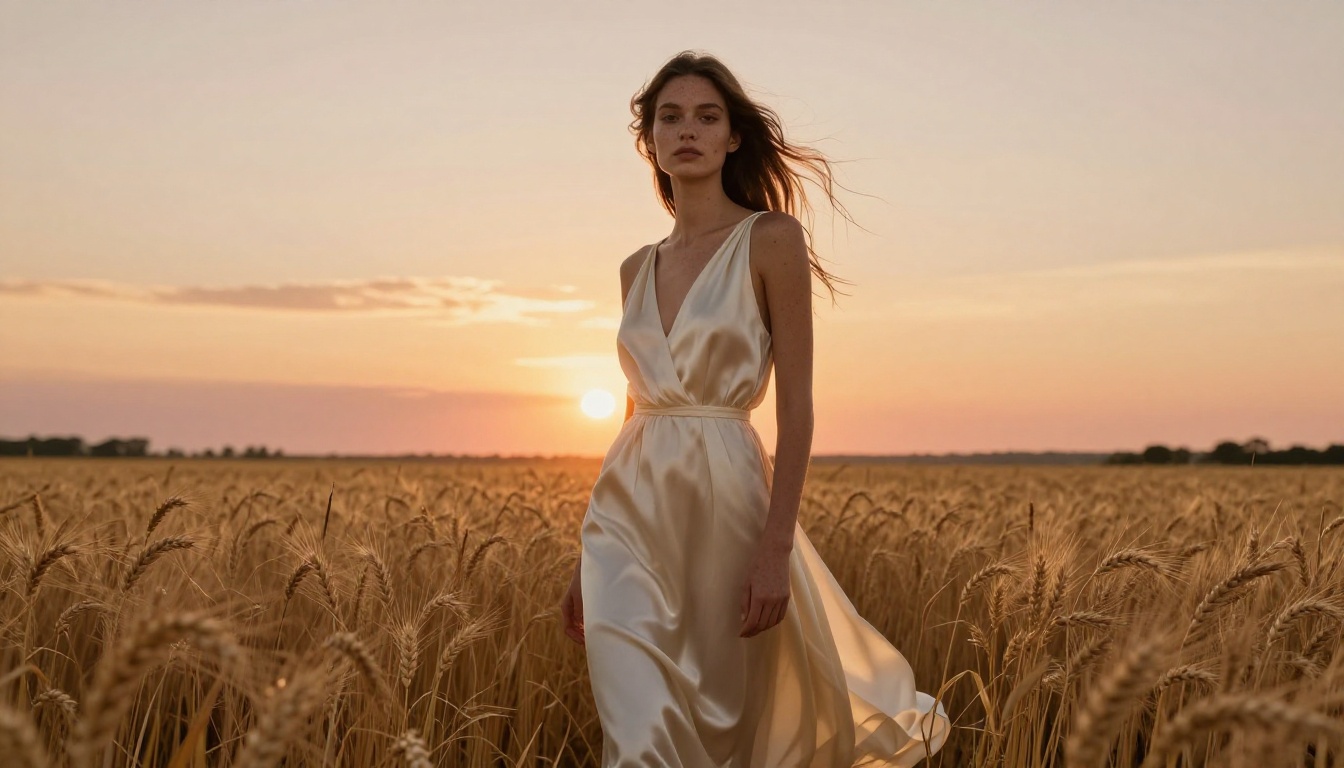
मॉडल जटिल लाइटिंग स्थितियों को भी आत्मविश्वास से संभालता है। बैकलाइटिंग से बनने वाले रिम-लाइट हेलो, पत्तियों से छनकर आती असमान रोशनी और स्टूडियो-शैली की दिशात्मक लाइटिंग सेटअप, सब ऐसे नतीजे देते हैं जो कंप्यूटेशनली रेंडर किए हुए नहीं, बल्कि फ़ोटोग्राफ़िक लगते हैं।
कैंडिड और लाइफ़स्टाइल इमेज
कई सब्जेक्ट, स्वाभाविक भाव और परिवेश के संदर्भ वाली कैंडिड-शैली की इमेज AI इमेज मॉडलों के लिए कुख्यात रूप से कठिन होती हैं। लोगों के बीच की बातचीत अक्सर बनावटी, शारीरिक रूप से अजीब या भावहीन लगती है।
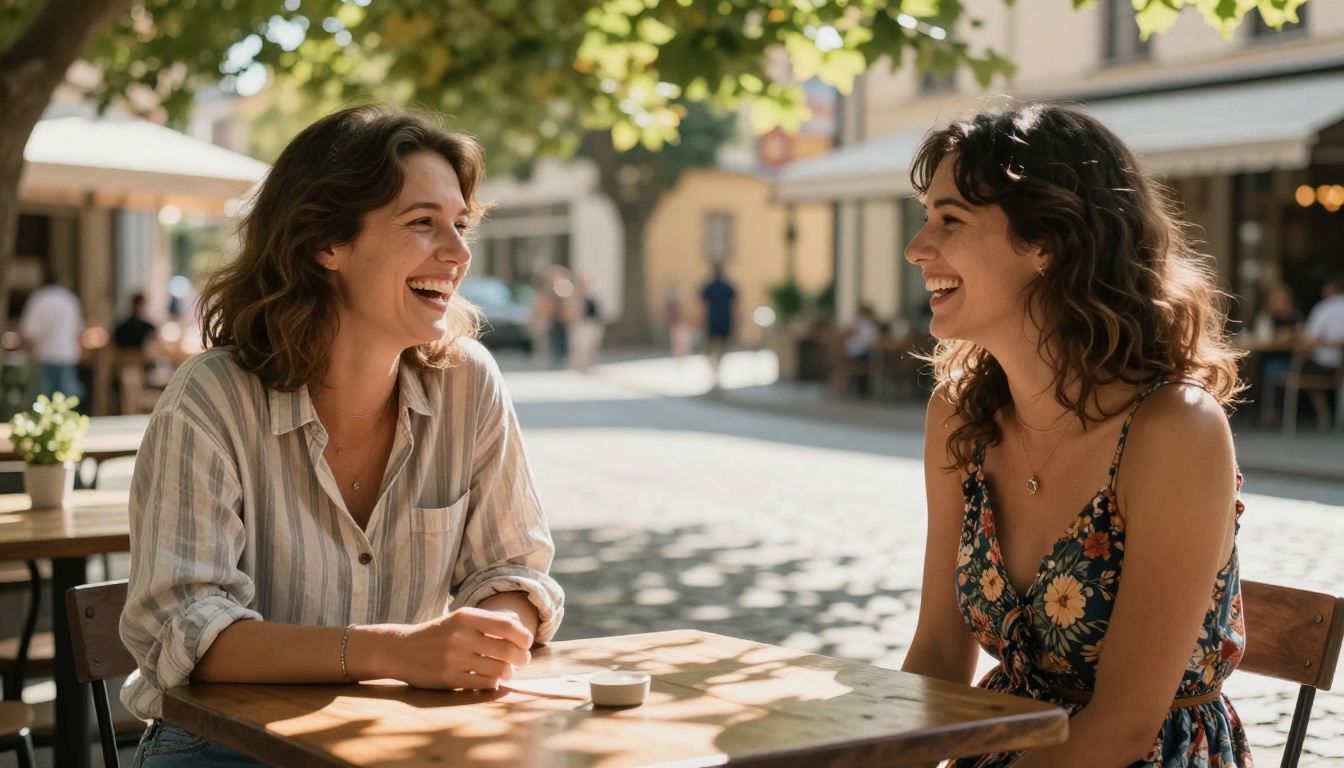
यहाँ AuraFlow का मज़बूत प्रॉम्प्ट कोहेरेंस मदद करता है। प्रॉम्प्ट में भावनात्मक संदर्भ बताने से (सच्ची हँसी, आरामदेह बातचीत, केंद्रित एकाग्रता) ऐसी इमेज मिलती हैं जिनमें चेहरे के भाव और शरीर की भाषा वाकई स्वाभाविक लगते हैं। जब प्रॉम्प्ट में भावनात्मक दिशा दी जाती है, तो मॉडल खाली चेहरों या ज़बरदस्ती की मुस्कान पर डिफ़ॉल्ट नहीं करता।
अपने हार्डवेयर पर AuraFlow चलाना
AuraFlow Hugging Face के मॉडल हब के ज़रिए उपलब्ध है और मानक diffusers पाइपलाइन के साथ संगत है। जो व्यक्ति पहले कोई मिलता-जुलता मॉडल सेट कर चुका है, उसके लिए इसे लोकली चलाना सीधा है।
हार्डवेयर आवश्यकताएँ
| सेटअप | न्यूनतम VRAM | जनरेशन स्पीड (लगभग) |
|---|
| fp16 फ़ुल प्रिसिज़न | 12GB | ~45 सेकंड प्रति इमेज |
| fp8 क्वांटाइज़्ड | 8GB | ~90 सेकंड प्रति इमेज |
| CPU ऑफ़लोड मोड | 8GB VRAM | 3 से 5 मिनट प्रति इमेज |
RTX 3080 या RTX 4070 जैसा मिड-रेंज GPU AuraFlow को fp16 पर आराम से चला सकता है। FLUX.1 Dev के मुकाबले यह एक अहम सुलभता फ़ायदा है, क्योंकि समतुल्य क्वालिटी के आउटपुट के लिए वह अक्सर हाई-एंड हार्डवेयर माँगता है।
सेटअप और आवश्यकताएँ
diffusers लाइब्रेरी अपने मानक पाइपलाइन इंटरफ़ेस के ज़रिए AuraFlow को सीधे संभालती है। बुनियादी लोकल सेटअप के लिए ये चाहिए:
- Python 3.10 या नया रनटाइम वातावरण के रूप में
- CUDA के साथ PyTorch 2.x GPU एक्सेलेरेशन के लिए
- diffusers, transformers और accelerate Python लाइब्रेरी
- मॉडल चेकपॉइंट Hugging Face से, लगभग 12GB का डाउनलोड
सैंपलिंग पाइपलाइन मानक पैरामीटर स्वीकार करती है। फ़ोटोरियलिस्टिक आउटपुट के लिए 3.5 और 7.0 के बीच का गाइडेंस स्केल सबसे अच्छे नतीजे देता है। ज़्यादातर उपयोगों के लिए 20 से 30 स्टेप काफ़ी हैं, जबकि बहुत विस्तृत दृश्यों के लिए ज़्यादा स्टेप (50 तक) थोड़ी और क्वालिटी देते हैं, लेकिन जनरेशन का समय बढ़ जाता है।
💡 प्रॉम्प्ट टिप: AuraFlow विस्तृत दृश्य विवरणों पर मज़बूती से प्रतिक्रिया देता है। लाइटिंग की दिशा ("बाईं ओर से नरम सुबह की रोशनी"), लेंस पैरामीटर ("85mm f/1.8 शैलो डेप्थ ऑफ़ फ़ील्ड") और मटेरियल की बारीकियाँ ("दिखने वाले ड्रेप और बनावट वाला सिल्क फ़ैब्रिक") जोड़ने से फ़ोटोरियलिज़्म छोटे, सामान्य प्रॉम्प्ट की तुलना में काफ़ी ऊपर चला जाता है।
AI इमेज क्रिएटर्स के लिए इसका क्या मतलब है
AuraFlow की रिलीज़ उस पैटर्न का हिस्सा है जो तेज़ी पकड़ रहा है: बंद कमर्शियल मॉडलों और ओपन-सोर्स विकल्पों के बीच का फ़ासला उम्मीद से कहीं ज़्यादा तेज़ी से घट रहा है। तीन साल पहले, सबसे अच्छी इमेज जनरेशन के लिए DALL-E 2 के प्रतिबंधित API तक पहुँच चाहिए थी। आज ओपन-सोर्स इकोसिस्टम में ट्रांसफ़ॉर्मर-आधारित फ़्लो मैचिंग मॉडल शामिल हैं, जो ज़्यादातर व्यावहारिक उपयोगों में कमर्शियल क्वालिटी से मेल खाते हैं।
ओपन-सोर्स इमेज लैंडस्केप में बदलाव
क्रिएटर्स के लिए, इसका मतलब है ठोस फ़ायदे:
- ज़्यादा नियंत्रण: अपने डेटा पर फ़ाइन-ट्यून करें, वेट्स अपने पास रखें, स्टाइल के मालिक बनें
- कम लागत: बड़े पैमाने पर लोकली चलाने पर प्रति-इमेज शुल्क नहीं
- कोई वेंडर निर्भरता नहीं: जब कोई API कीमत बदलता है, तो आपका वर्कफ़्लो नहीं टूटता
- कम्युनिटी सुधार: जैसे-जैसे रिसर्चर सार्वजनिक रूप से इसके ऊपर काम करेंगे, मॉडल बेहतर होता जाएगा
AuraFlow FLUX के साथ इस बात का सबूत बनता है कि ओपन-सोर्स इमेज जनरेशन उस बिंदु पर पहुँच चुका है जहाँ सवाल अब "क्या यह काफ़ी अच्छा है?" नहीं, बल्कि "मेरे उपयोग के मामले में कौन-सी खास ताक़तें फ़िट होती हैं?" है। दोनों मॉडल बिना फ़ाइन-ट्यूनिंग के बेस मॉडल से ही कमर्शियल रूप से उपयोगी इमेज बनाते हैं, जो 18 महीने पहले भी ओपन-सोर्स विकल्पों के बारे में सच नहीं था।
फ़्लो मैचिंग आर्किटेक्चर, इंसानी सब्जेक्ट पर मज़बूत फ़ोटोरियलिज़्म, तुलनीय मॉडलों से कम हार्डवेयर आवश्यकताएँ और पूरी तरह खुले वेट्स का संयोजन AuraFlow को 2024 में AI इमेज सिंथेसिस की सबसे दिलचस्प रिलीज़ों में से एक बनाता है। चाहे आप इसे लोकली चलाएँ या किसी प्लेटफ़ॉर्म के ज़रिए इस्तेमाल करें, यह आपकी समझ में ज़रूर रहना चाहिए कि यह क्षेत्र अभी कहाँ खड़ा है।
आज ही AI इमेज मॉडलों से जनरेट करना शुरू करें
अगर आप लोकल एनवायरनमेंट कॉन्फ़िगर किए बिना नवीनतम AI इमेज मॉडलों की क्षमताओं का इस्तेमाल करना चाहते हैं, तो PicassoIA आपको प्रोफ़ेशनल टेक्स्ट-टू-इमेज मॉडलों की एक विस्तृत लाइब्रेरी तक पहुँच देता है, जिसमें Flux Redux Dev और अलग-अलग स्टाइल व आउटपुट प्रकारों के दर्जनों दूसरे मॉडल शामिल हैं।
यह प्लेटफ़ॉर्म आपको टेक्स्ट प्रॉम्प्ट से सीधे फ़ोटोरियलिस्टिक पोर्ट्रेट, एडिटोरियल फ़ैशन शॉट्स, नाटकीय लैंडस्केप और कैंडिड लाइफ़स्टाइल इमेज बनाने देता है, और इसमें किसी लोकल GPU सेटअप या Python एनवायरनमेंट की ज़रूरत नहीं होती। आप अलग-अलग प्रॉम्प्ट स्टाइल आज़मा सकते हैं, मॉडलों के आउटपुट की तुलना कर सकते हैं, और खुद देख सकते हैं कि फ़्लो मैचिंग-आधारित आर्किटेक्चर पारंपरिक डिफ्यूज़न पाइपलाइनों की तुलना में क्या बनाते हैं।
चाहे आप एक फ़ोटोग्राफ़र हों जो महँगे प्रोडक्शन दिन से पहले शॉट के कॉन्सेप्ट का प्रोटोटाइप बना रहे हों, एक डिज़ाइनर जो बड़े पैमाने पर विज़ुअल कंटेंट बना रहा हो, या एक डेवलपर जो तय कर रहा हो कि कौन-सा मॉडल आपके प्रोडक्ट में फ़िट होता है, किसी सूचित राय तक पहुँचने का सबसे तेज़ तरीका जनरेट करना शुरू करना है। कोई एक खास दृश्य चुनें, एक विस्तृत प्रॉम्प्ट लिखें, और देखें कि आज की पीढ़ी के ओपन इमेज मॉडल असल में क्या बनाने में सक्षम हैं।


