O AuraFlow chegou discretamente ao Hugging Face em meados de 2024, mas a reação da comunidade de IA de imagens foi tudo menos discreta. Cloneofsimo e colaboradores lançaram um novo modelo de texto para imagem de código aberto construído sobre flow matching e, em poucos dias, pesquisadores e criadores já estavam rodando benchmarks, comparando resultados e publicando imagens de exemplo que rivalizavam com modelos três vezes maiores. Isso não é apenas mais uma atualização incremental das arquiteturas existentes. O AuraFlow é uma tentativa do zero de repensar como os modelos de geração de imagens de código aberto devem ser construídos, e os resultados merecem muita atenção.
O que o AuraFlow realmente é
O AuraFlow é um modelo de texto para imagem que gera imagens fotorrealistas e artísticas a partir de prompts em linguagem natural. Ele é construído sobre uma arquitetura baseada em transformer e treinado com flow matching, um objetivo de treinamento fundamentalmente diferente do processo de difusão por remoção de ruído usado na maioria dos modelos populares atualmente.
O modelo foi lançado com pesos abertos sob uma licença permissiva, o que significa que qualquer pessoa pode baixar, executar, fazer fine-tuning ou construir sobre ele. Essa abertura é importante: coloca o AuraFlow na mesma categoria de FLUX e dos primeiros lançamentos do Stable Diffusion, e não entre as APIs comerciais fechadas, em que você paga por imagem e nunca vê a arquitetura por trás.
Flow matching, não difusão
A maioria dos modelos de IA de imagens que você já usou, do Stable Diffusion ao SDXL, é construída sobre modelos probabilísticos de difusão com remoção de ruído (DDPMs). O processo funciona aprendendo a reverter um processo de adição de ruído: dada uma imagem cheia de ruído aleatório, o modelo remove esse ruído progressivamente até surgir uma imagem coerente.
O flow matching adota uma abordagem diferente. Em vez de aprender a remover ruído passo a passo, ele treina o modelo para aprender um campo vetorial contínuo que leva diretamente do ruído puro aos dados. Pense nisso como traçar um caminho reto do caos à ordem, em vez de dar centenas de pequenos passos de remoção de ruído sem uma direção clara.
Isso tem consequências práticas:
- Menos passos de inferência necessários para gerar imagens de alta qualidade
- Interpolação mais suave entre conceitos e estilos de imagem
- Maior estabilidade de treinamento em escalas grandes de parâmetros
- Maior coerência com o prompt em descrições complexas, com vários elementos
A arquitetura por trás disso
O AuraFlow usa um backbone baseado em transformer, em vez da arquitetura U-Net que dominou os modelos de difusão de primeira e segunda geração. Isso o coloca na mesma família arquitetural do FLUX e do Imagen 3 do Google.
O modelo processa tokens de texto e de imagem juntos em um único mecanismo de atenção unificado, o que lhe permite manter maior coerência em descrições complexas. Quando você pede para gerar uma mulher em pé em um campo de trigo ao pôr do sol, usando um vestido de seda creme, ele não esquece o vestido de seda creme no meio da renderização do pôr do sol. Esse tipo de consistência de longo alcance tem sido uma fraqueza constante dos modelos de difusão U-Net mais antigos.
Por que o código aberto muda as coisas
O lançamento dos pesos do AuraFlow importa por razões que vão além de mais um modelo gratuito para testar. Ele representa um compromisso contínuo da comunidade de pesquisa em manter a geração de imagens de ponta acessível a qualquer pessoa com uma GPU capaz e vontade de experimentar.
Acesso aos pesos do modelo
Quando um modelo é lançado com pesos abertos, o valor real não está apenas na inferência gratuita. Está na possibilidade de:
- Executar o modelo localmente, sem limites de requisições da API nem custos por imagem
- Fazer fine-tuning em conjuntos de dados próprios para combinar com um estilo fotográfico ou artístico específico
- Integrar o modelo em fluxos de trabalho de produção sem dependência de fornecedor
- Construir modelos derivados e compartilhar melhorias com a comunidade
Os pesos do AuraFlow estão disponíveis diretamente pelo Hugging Face, compatíveis com a biblioteca diffusers. Isso significa que qualquer pessoa com uma GPU de consumo pode executá-lo sem custos de computação em nuvem nem restrições de conta.
Iteração impulsionada pela comunidade
Modelos de código aberto melhoram mais rápido que os fechados, depois que ultrapassam um limiar crítico de qualidade. A família FLUX provou isso: em poucas semanas após o lançamento da versão Dev, a comunidade já havia criado fine-tunes com LoRA, adaptadores ControlNet e variantes combinadas que elevaram o teto de qualidade bem acima do que o modelo base alcançava sozinho.
O AuraFlow tem potencial para se beneficiar da mesma dinâmica. Pesquisadores podem auditar a metodologia de treinamento, identificar modos de falha e propor melhorias direcionadas. Esse tipo de iteração colaborativa não acontece com modelos apenas de API, em que os pesos permanecem privados.
💡 A vantagem dos pesos abertos: Um modelo que você pode fazer fine-tuning vale dez vezes mais do que um modelo que você só pode usar com prompts. O fine-tuning reduz a distância entre a saída genérica da IA e uma saída que combina com seu estilo visual específico, identidade de marca ou requisitos de produção.
AuraFlow ou a concorrência
O AuraFlow não existe no vácuo. Ele entra em um ecossistema em que FLUX.1 Dev, SDXL e Stable Diffusion 3 disputam o mesmo público. Aqui está uma comparação honesta, baseada em resultados documentados e benchmarks da comunidade.
Como ele se compara ao FLUX
| Recurso | AuraFlow | FLUX.1 Dev |
|---|
| Arquitetura | Transformer (flow matching) | Transformer (flow matching) |
| Pesos abertos | Sim, permissiva | Sim, não comercial |
| Passos de inferência | 20 a 30 | 20 a 50 |
| Requisito de VRAM | ~12GB fp16 | ~16 a 24GB |
| Aderência ao prompt | Forte | Muito forte |
| Ecossistema da comunidade | Em crescimento | Grande e ativo |
| Qualidade de retratos | Excelente | Muito boa |
| Acessibilidade de hardware | GPU de faixa intermediária | GPU de ponta |
O FLUX.1 Dev, que você pode usar pelo modelo Flux Redux Dev no PicassoIA, tem atualmente um ecossistema de comunidade maior e uma aderência ao prompt um pouco mais forte em prompts muito complexos, com vários sujeitos. Mas o AuraFlow fecha essa distância de forma significativa em retratos e geração de sujeitos humanos, que historicamente têm sido um ponto fraco dos modelos de imagem baseados em transformer nessa escala de parâmetros.
O AuraFlow também roda com menos VRAM, o que é uma vantagem prática relevante. Uma GPU de 12GB consegue executar o AuraFlow em precisão total, enquanto o FLUX.1 Dev exige de 16 a 24GB para uma qualidade semelhante.
Onde o SDXL ainda se sai bem
A principal vantagem do SDXL é o seu enorme ecossistema de fine-tunes com LoRA e checkpoints da comunidade. Se você precisa de um estilo visual muito específico que tenha sido treinado em um LoRA existente (uma estética de determinado artista, um estilo de marca, uma configuração de iluminação específica), é provável que o SDXL tenha. O AuraFlow ainda não tem essa biblioteca.
Ainda assim, para a qualidade do modelo base sem nenhum fine-tuning, o AuraFlow supera o SDXL na maioria dos casos de uso fotorrealistas: sujeitos humanos, precisão da iluminação natural e coerência do prompt em prompts descritivos.
💡 Quando usar o AuraFlow: Fotorrealismo forte já de fábrica, sem fine-tuning. Quando ficar com o SDXL: você precisa de um LoRA ou checkpoint específico da biblioteca consolidada da comunidade, que ainda não existe para o AuraFlow.
A qualidade das imagens na prática
Benchmarks e explicações de arquitetura contam apenas parte da história. O que mais importa é se o modelo realmente produz imagens que parecem boas sem pós-processamento pesado nem seleção a partir de dezenas de resultados descartados.
Retratos e sujeitos humanos
É aqui que o AuraFlow realmente impressiona. A geração de retratos humanos tem sido um dos desafios mais persistentes nos modelos de imagem de código aberto, especialmente em relação a mãos, simetria facial e textura natural da pele.
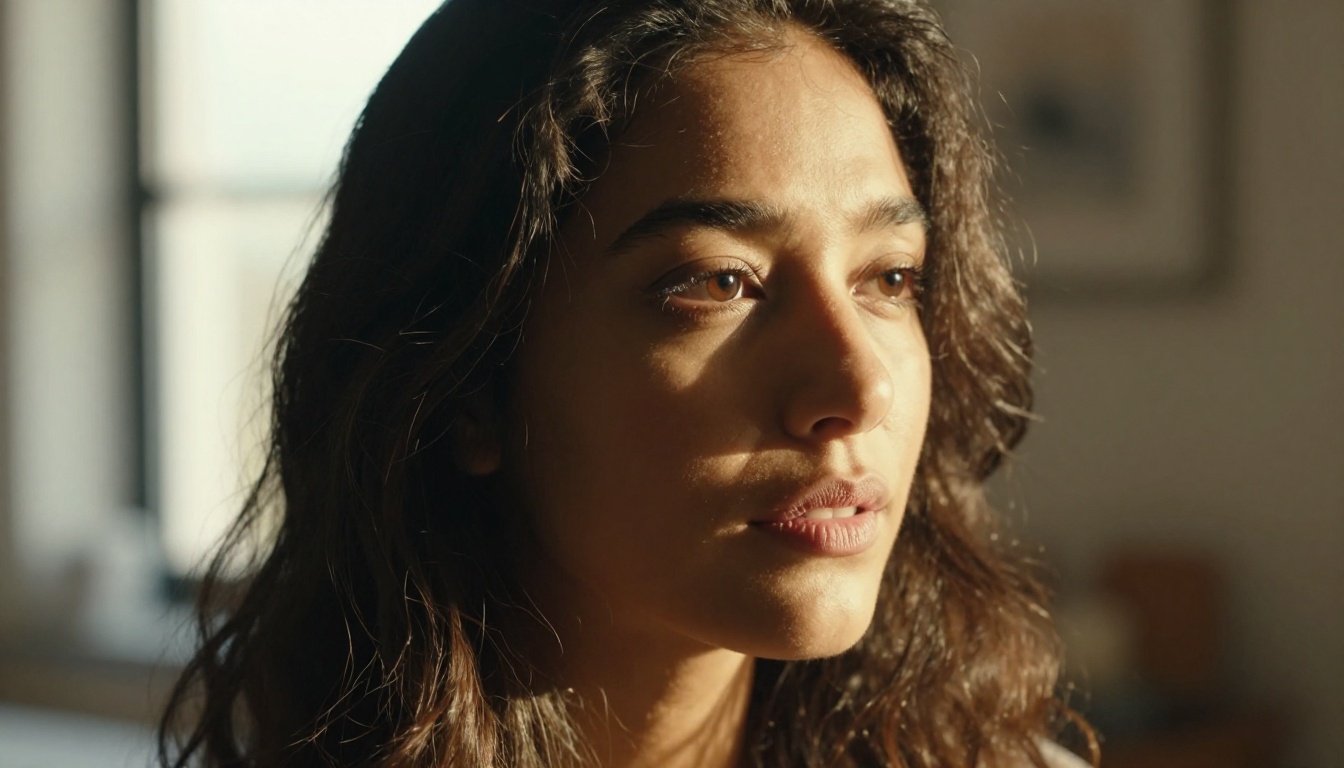
O AuraFlow produz retratos com:
- Textura natural da pele, incluindo poros visíveis e linhas finas, sem a suavidade artificial comum nos modelos de difusão anteriores
- Renderização precisa dos olhos, com reflexos de luz (catchlights) adequados, detalhe da íris e profundidade dos cílios
- Geometria facial consistente em diferentes condições de iluminação e descrições do prompt
- Cabelo realista, com variação de fios individuais, em vez de massas com aparência pintada ou simetria artificial
Para quem gera retratos de personagens, headshots em estilo fotográfico ou imagens editoriais, isso é uma melhoria relevante em relação ao que as opções anteriores de código aberto ofereciam com custos de inferência comparáveis.
Paisagens e arquitetura
A geração de paisagens se beneficia da abordagem de treinamento por flow matching do AuraFlow. O modelo lida bem com perspectiva atmosférica, transições de iluminação em cenas amplas e texturas orgânicas complexas, como folhagem, água e rocha, com forte consistência interna.
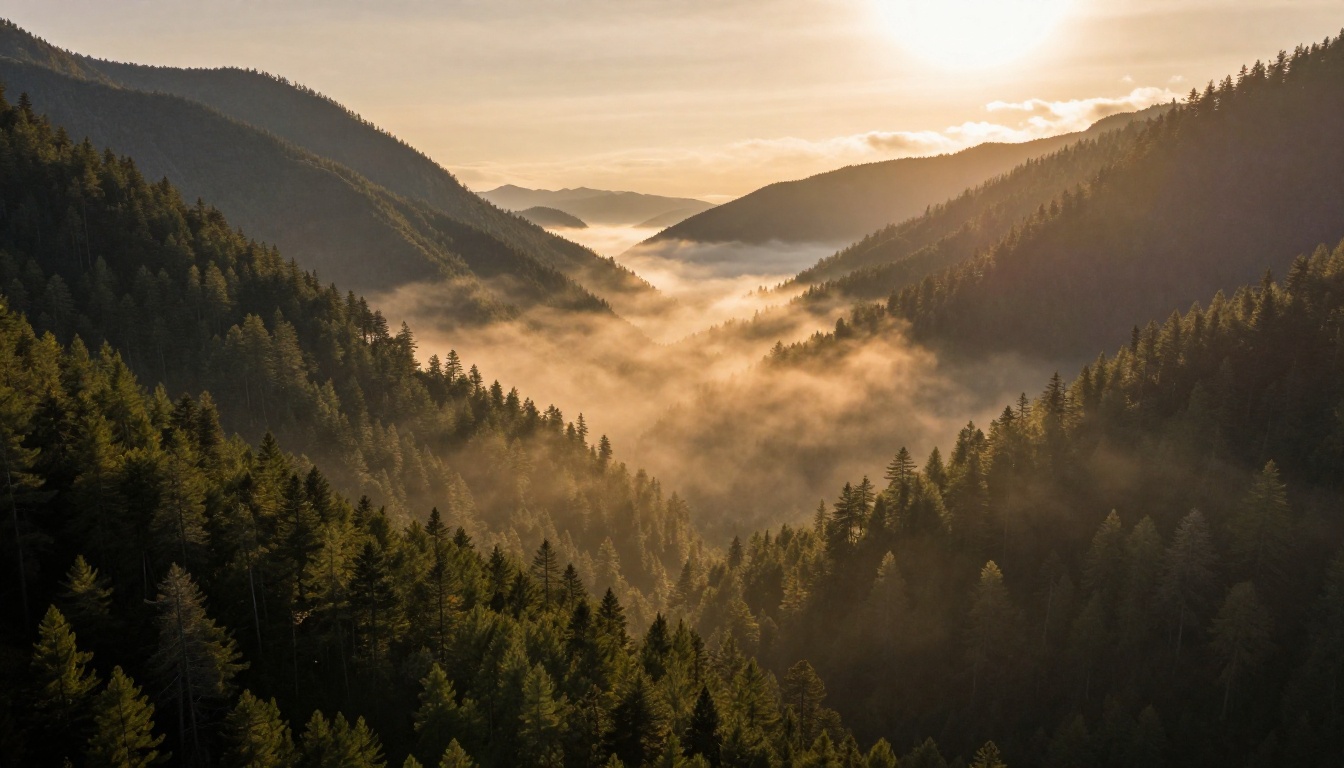
O processo de treinamento permite um tratamento mais suave de grandes elementos de composição. O céu, o plano intermediário e o primeiro plano de uma paisagem mantêm relações tonais adequadas, sem o aspecto de "colagem" que modelos anteriores às vezes produziam ao tentar renderizar cenas complexas em vários planos com iluminações variadas.
Moda e fotos editoriais
Para imagens de moda e de estilo de fotografia comercial, o AuraFlow se sai bem até mesmo diante de modelos ajustados especificamente para essa finalidade. A textura do tecido, o caimento da roupa e a interação da luz com diferentes materiais (seda, linho, jeans, couro) são renderizados com uma precisão fotográfica que parece real, e não simulada.
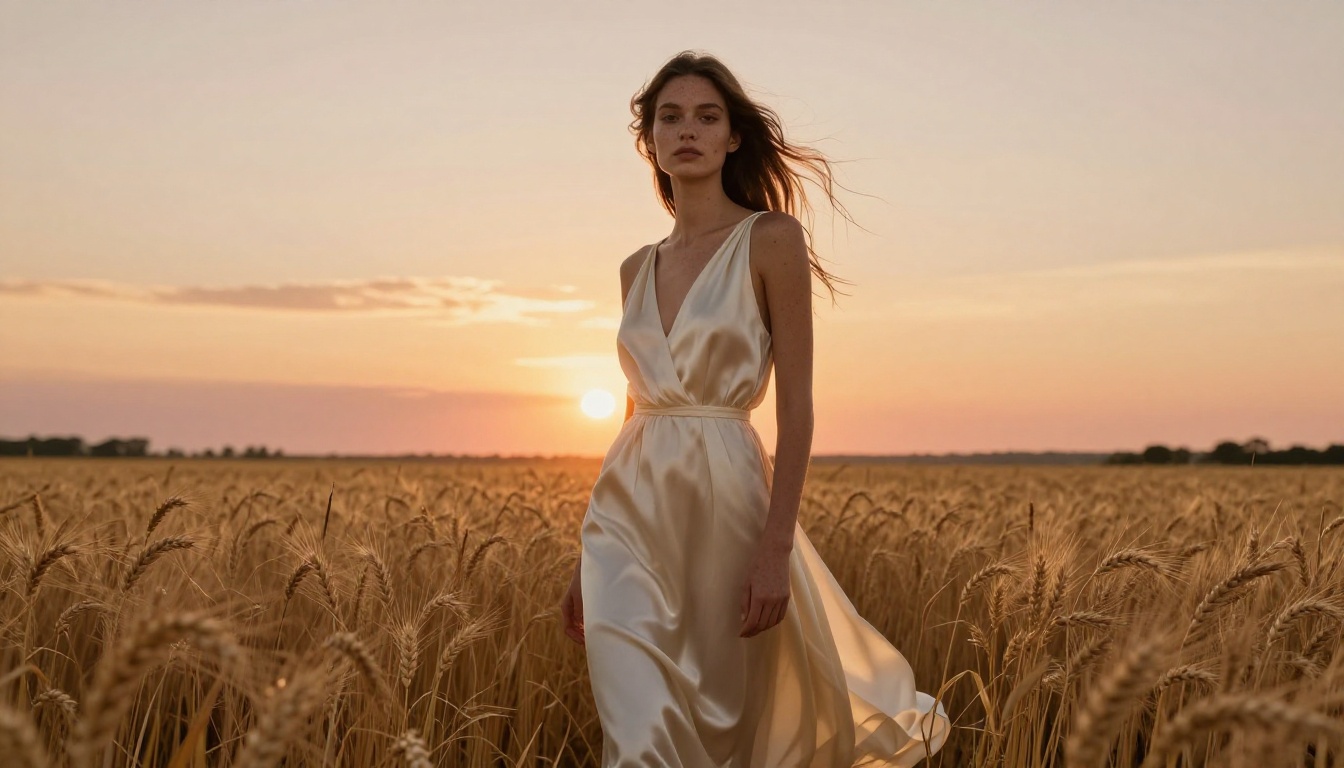
O modelo também lida com cenários de iluminação complexos com segurança. Contraluz que cria halos de luz de contorno (rim light), luz filtrada pela folhagem gerando iluminação irregular e configurações de iluminação direcional em estilo de estúdio produzem resultados que parecem fotográficos, e não renderizados por computador.
Imagens espontâneas e de estilo de vida
Imagens de estilo espontâneo, com vários sujeitos, expressões naturais e contexto ambiental, são notoriamente difíceis para os modelos de IA de imagens. As interações entre pessoas costumam parecer forçadas, desajeitadas do ponto de vista físico ou emocionalmente vazias.
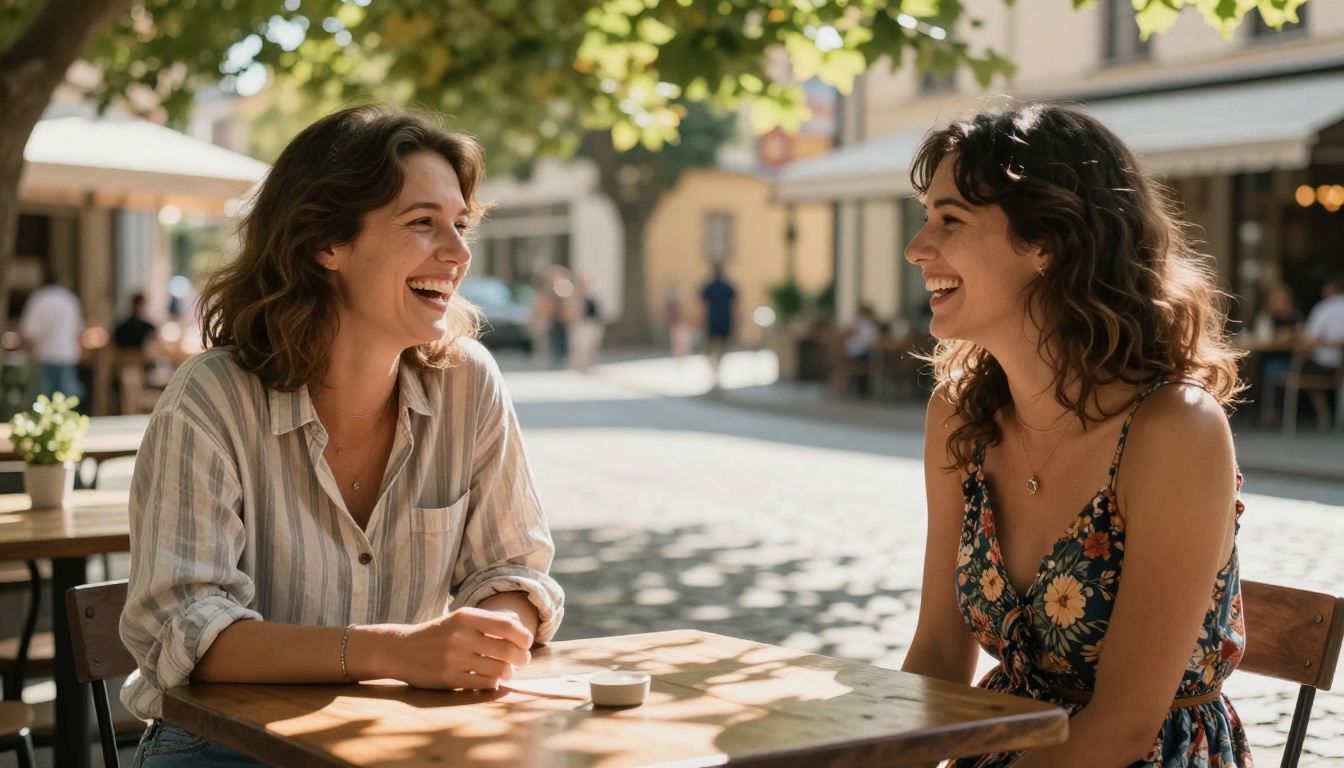
A forte coerência de prompt do AuraFlow ajuda nesse caso. Especificar o contexto emocional no prompt (risadas genuínas, conversa descontraída, concentração focada) resulta em imagens em que as expressões e a linguagem corporal de fato parecem naturais. O modelo não recorre a rostos vazios nem a sorrisos forçados quando recebe uma direção emocional descritiva no prompt.
Executando o AuraFlow no seu próprio hardware
O AuraFlow está disponível pelo hub de modelos do Hugging Face e é compatível com o pipeline padrão da diffusers. Colocá-lo para funcionar localmente é simples para quem já configurou um modelo parecido.
Requisitos de hardware
| Configuração | VRAM mínima | Velocidade de geração (aprox.) |
|---|
| fp16 precisão total | 12GB | ~45 segundos por imagem |
| fp8 quantizado | 8GB | ~90 segundos por imagem |
| Modo de offload para CPU | 8GB de VRAM | 3 a 5 minutos por imagem |
Uma GPU de faixa intermediária, como a RTX 3080 ou a RTX 4070, consegue executar o AuraFlow em fp16 com folga. Isso é uma vantagem relevante de acessibilidade em relação ao FLUX.1 Dev, que muitas vezes exige hardware mais avançado para uma saída de qualidade equivalente.
Configuração e requisitos
A biblioteca diffusers lida com o AuraFlow nativamente, pela sua interface de pipeline padrão. Uma configuração local básica exige:
- Python 3.10 ou mais recente como ambiente de execução
- PyTorch 2.x com CUDA para aceleração por GPU
- As bibliotecas Python diffusers, transformers e accelerate
- O checkpoint do modelo do Hugging Face, um download de aproximadamente 12GB
O pipeline de amostragem aceita parâmetros padrão. Um guidance scale entre 3,5 e 7,0 produz os melhores resultados para saídas fotorrealistas. Uma contagem de passos de 20 a 30 atende à maioria dos casos, e contagens mais altas (até 50) oferecem melhorias marginais de qualidade para cenas extremamente detalhadas, ao custo de mais tempo de geração.
💡 Dica de prompt: O AuraFlow responde bem a descrições detalhadas de cena. Acrescentar a direção da luz ("luz suave da manhã vinda da esquerda"), parâmetros de lente ("85mm f/1.8 com profundidade de campo rasa") e especificidades de material ("seda com caimento e textura visíveis") eleva o fotorrealismo bem mais do que prompts curtos e genéricos.
O lançamento do AuraFlow faz parte de um padrão que vem se acelerando: a distância entre os modelos comerciais fechados e as alternativas de código aberto está diminuindo mais rápido do que a maioria esperava. Três anos atrás, a melhor geração de imagens exigia acesso à API restrita do DALL-E 2. Hoje, o ecossistema de código aberto inclui modelos de flow matching baseados em transformer que igualam a qualidade comercial na maioria dos casos de uso práticos.
A mudança no cenário de imagens de código aberto
Para criadores, isso se traduz em vantagens concretas:
- Mais controle: faça fine-tuning com seus próprios dados, mantenha os pesos, seja dono do estilo
- Custos menores: sem taxas por imagem quando você executa localmente em escala
- Sem dependência de fornecedor: seu fluxo de trabalho não quebra quando uma API muda os preços
- Melhorias da comunidade: o modelo vai melhorar à medida que pesquisadores construírem sobre ele publicamente
O AuraFlow se junta ao FLUX como prova de que a geração de imagens de código aberto chegou a um ponto em que a pergunta já não é "isso é bom o suficiente?", mas "quais pontos fortes específicos servem ao meu caso de uso?". Ambos os modelos produzem imagens comercialmente viáveis a partir do modelo base, sem fine-tuning, algo que não era verdade para as opções de código aberto nem 18 meses atrás.
A combinação de arquitetura de flow matching, forte fotorrealismo em sujeitos humanos, requisitos de hardware menores que os de modelos comparáveis e pesos totalmente abertos faz do AuraFlow um dos lançamentos mais interessantes em síntese de imagens por IA em 2024. Quer você o execute localmente, quer o acesse por uma plataforma, ele merece um lugar no seu radar sobre o estágio atual do campo.
Se você quer colocar para funcionar os recursos dos modelos de IA de imagens mais recentes sem configurar um ambiente local, o PicassoIA dá acesso a uma ampla biblioteca de modelos profissionais de texto para imagem, incluindo o Flux Redux Dev e dezenas de outros modelos em diferentes estilos e tipos de saída.
A plataforma permite gerar retratos fotorrealistas, fotos editoriais de moda, paisagens dramáticas e imagens espontâneas de estilo de vida diretamente a partir de prompts de texto, sem configuração de GPU local nem ambiente Python. Você pode testar diferentes estilos de prompt, comparar resultados entre modelos e ver na prática o que as arquiteturas baseadas em flow matching produzem em comparação com os pipelines de difusão tradicionais.
Seja você um fotógrafo que prototipa conceitos de fotos antes de um dia de produção caro, um designer que cria conteúdo visual em escala ou um desenvolvedor avaliando qual modelo se encaixa no seu produto, a forma mais rápida de formar uma opinião embasada é começar a gerar. Escolha uma cena específica, escreva um prompt detalhado e veja o que a geração atual de modelos de imagem de código aberto realmente consegue produzir.


