AuraFlow est arrivé discrètement sur Hugging Face à la mi-2024, mais la réaction de la communauté de l’image IA a été tout sauf discrète. Cloneofsimo et ses collaborateurs ont publié un nouveau modèle open source de texte vers image fondé sur le flow matching, et en quelques jours, chercheurs et créateurs faisaient tourner des benchmarks, comparaient les rendus et publiaient des images d’exemple qui rivalisaient avec des modèles trois fois plus grands. Il ne s’agit pas d’une simple mise à jour incrémentale d’architectures existantes. AuraFlow est une tentative repartie de zéro pour redéfinir la manière dont les modèles open source de génération d’images devraient être conçus, et ses résultats méritent toute votre attention.
Ce qu’est vraiment AuraFlow
AuraFlow est un modèle de texte vers image qui génère des images photoréalistes et artistiques à partir de prompts en langage naturel. Il repose sur une architecture basée sur des transformers et est entraîné avec le flow matching, un objectif d’entraînement fondamentalement différent du processus de diffusion par débruitage utilisé par la plupart des modèles populaires aujourd’hui.
Le modèle a été publié avec des poids ouverts sous une licence permissive, ce qui signifie que chacun peut le télécharger, le faire tourner, le fine-tuner ou construire à partir de lui. Cette ouverture est importante : elle place AuraFlow dans la même catégorie que FLUX et les premières versions de Stable Diffusion, plutôt que dans celle des API commerciales fermées où vous payez par image sans jamais voir l’architecture sous-jacente.
Flow matching plutôt que diffusion
La plupart des modèles d’image IA que vous avez utilisés, de Stable Diffusion à SDXL, reposent sur des modèles de diffusion probabilistes par débruitage (DDPM). Le processus consiste à apprendre à inverser un processus d’ajout de bruit : à partir d’une image remplie de bruit aléatoire, le modèle retire progressivement ce bruit jusqu’à ce qu’une image cohérente apparaisse.
Le flow matching adopte une approche différente. Au lieu d’apprendre à débruiter pas à pas, le flow matching entraîne le modèle à apprendre un champ vectoriel continu qui relie directement un bruit pur aux données. Imaginez un trajet en ligne droite allant du chaos vers l’ordre, plutôt que des centaines de petites étapes de débruitage sans direction claire.
Cela a des conséquences concrètes :
- Moins d’étapes d’inférence nécessaires pour générer des images de haute qualité
- Une interpolation plus fluide entre les concepts et les styles d’image
- Une meilleure stabilité d’entraînement à grande échelle de paramètres
- Une cohérence de prompt plus forte pour des descriptions complexes comportant plusieurs éléments
L’architecture qui le sous-tend
AuraFlow utilise un backbone basé sur des transformers plutôt que l’architecture U-Net qui dominait les modèles de diffusion de première et deuxième génération. Il se situe ainsi dans la même famille architecturale que FLUX et qu’Imagen 3 de Google.
Le modèle traite les tokens de texte et d’image ensemble, dans un mécanisme d’attention unifié, ce qui lui permet de maintenir une cohérence plus forte face à des descriptions complexes. Si vous lui demandez de générer une femme debout dans un champ de blé au coucher du soleil, vêtue d’une robe en soie crème, il n’oubliera pas la robe en soie crème au milieu du rendu du coucher de soleil. Ce type de cohérence sur de longues distances a longtemps été une faiblesse persistante des anciens modèles de diffusion à U-Net.
Pourquoi l’open source change la donne
La publication des poids d’AuraFlow compte pour bien plus qu’un simple modèle gratuit de plus à essayer. Elle témoigne d’un engagement continu de la communauté de recherche à rendre la génération d’images de pointe accessible à quiconque dispose d’un GPU performant et de l’envie d’expérimenter.
Accès aux poids du modèle
Lorsqu’un modèle publie ses poids ouverts, la vraie valeur ne réside pas seulement dans l’inférence gratuite. Elle tient à la possibilité de :
- Faire tourner le modèle en local, sans limites de requêtes API ni coût par image
- Le fine-tuner sur des jeux de données personnalisés pour coller à un style photographique ou artistique précis
- L’intégrer à des flux de travail de production sans dépendance à un fournisseur
- Construire des modèles dérivés et partager les améliorations avec la communauté
Les poids d’AuraFlow sont disponibles directement via Hugging Face, compatibles avec la bibliothèque diffusers. Cela signifie que quiconque dispose d’un GPU grand public peut le faire tourner sans frais de calcul dans le cloud ni restrictions de compte.
Des améliorations portées par la communauté
Les modèles open source progressent plus vite que les modèles fermés, une fois qu’ils franchissent un seuil de qualité critique. La famille FLUX l’a démontré : quelques semaines après la sortie de sa version Dev, la communauté avait créé des fine-tunes LoRA, des adaptateurs ControlNet et des variantes fusionnées qui ont repoussé le plafond de qualité bien au-delà de ce que le modèle de base atteignait seul.
AuraFlow est en position de profiter de la même dynamique. Les chercheurs peuvent auditer la méthodologie d’entraînement, identifier les modes de défaillance et proposer des améliorations ciblées. Ce type d’itération collaborative ne se produit pas avec les modèles accessibles uniquement par API, dont les poids restent privés.
💡 L’avantage des poids ouverts : Un modèle que vous pouvez fine-tuner vaut dix fois un modèle que vous ne pouvez qu’interroger par prompt. Le fine-tuning réduit l’écart entre les rendus d’IA génériques et un résultat qui correspond à votre style visuel, à votre identité de marque ou à vos exigences de production.
AuraFlow face à la concurrence
AuraFlow n’existe pas dans le vide. Il arrive dans un écosystème où FLUX.1 Dev, SDXL et Stable Diffusion 3 se disputent la même base d’utilisateurs. Voici une comparaison honnête, fondée sur les rendus documentés et les benchmarks de la communauté.
Comment il se positionne face à FLUX
| Caractéristique | AuraFlow | FLUX.1 Dev |
|---|
| Architecture | Transformer (flow matching) | Transformer (flow matching) |
| Poids ouverts | Oui, licence permissive | Oui, non commerciale |
| Étapes d’inférence | 20 à 30 | 20 à 50 |
| VRAM nécessaire | ~12 Go en fp16 | ~16 à 24 Go |
| Respect du prompt | Fort | Très fort |
| Écosystème communautaire | En croissance | Vaste et actif |
| Qualité des portraits | Excellente | Très bonne |
| Accessibilité matérielle | GPU de gamme intermédiaire | GPU haut de gamme |
FLUX.1 Dev, que vous pouvez utiliser via le modèle Flux Redux Dev sur PicassoIA, dispose actuellement d’un écosystème communautaire plus vaste et d’un respect du prompt légèrement supérieur sur des prompts très complexes mettant en scène plusieurs sujets. Mais AuraFlow comble nettement cet écart pour les portraits et la génération de sujets humains, un point historiquement faible des modèles d’image à base de transformers à cette échelle de paramètres.
AuraFlow consomme aussi moins de VRAM, ce qui constitue un avantage pratique non négligeable. Un GPU de 12 Go peut faire tourner AuraFlow en pleine précision là où FLUX.1 Dev demande de 16 à 24 Go pour une qualité comparable.
Ce que SDXL conserve comme avantage
Le principal atout de SDXL réside dans son immense écosystème de fine-tunes LoRA et de checkpoints communautaires. Si vous avez besoin d’un style visuel très précis, intégré dans un LoRA existant (une esthétique d’artiste particulière, un style de marque, un éclairage spécifique), SDXL l’a probablement. AuraFlow ne dispose pas encore de cette bibliothèque.
En revanche, pour la qualité d’un modèle de base sans aucun fine-tuning, AuraFlow surpasse SDXL dans la plupart des cas d’usage photoréalistes : sujets humains, précision de l’éclairage naturel et cohérence du prompt sur des descriptions détaillées.
💡 Quand utiliser AuraFlow : Pour un photoréalisme solide prêt à l’emploi, sans fine-tuning. Quand rester sur SDXL : si vous avez besoin d’un LoRA ou d’un checkpoint précis issu de la bibliothèque communautaire établie, qui n’existe pas encore pour AuraFlow.
La qualité des rendus en pratique
Les benchmarks et les explications d’architecture ne racontent qu’une partie de l’histoire. Ce qui compte le plus, c’est de savoir si le modèle produit réellement des images convaincantes, sans post-traitement lourd ni tri parmi des dizaines de rendus rejetés.
Portraits et sujets humains
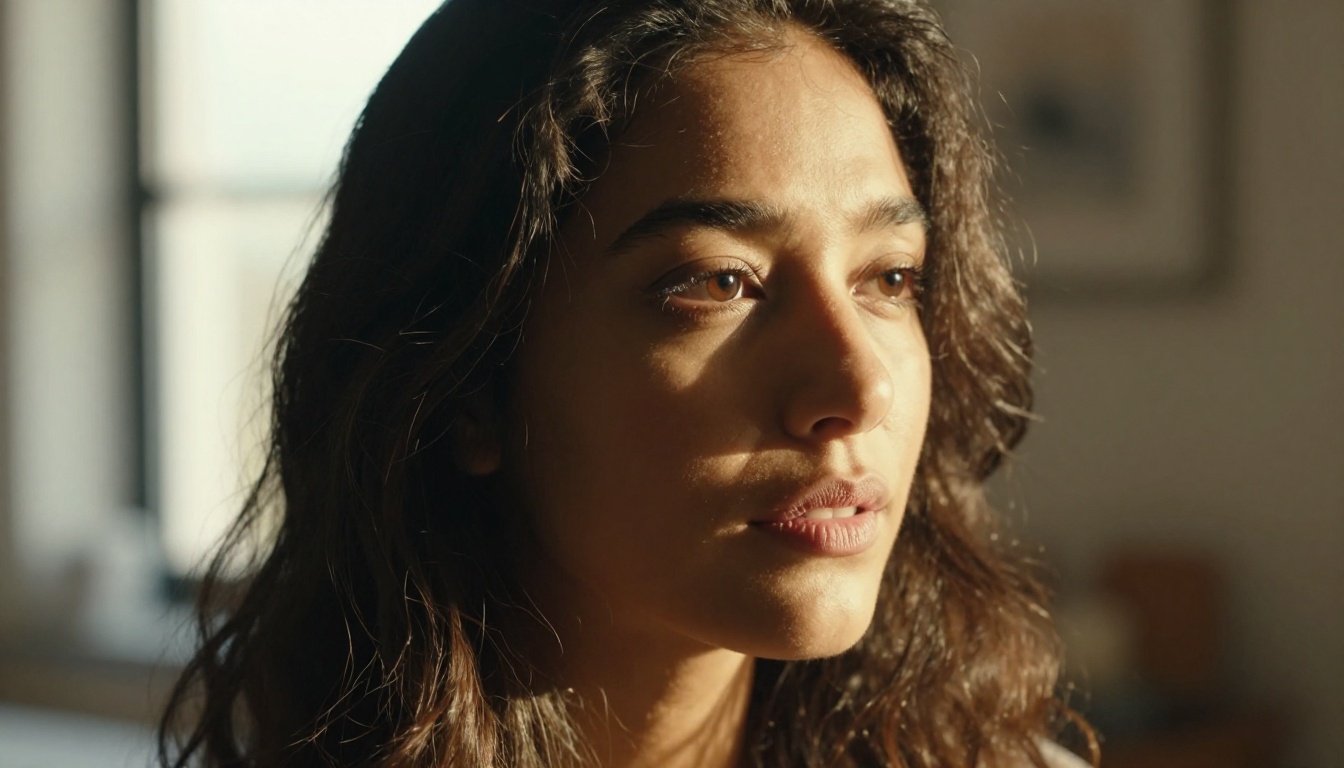
C’est là qu’AuraFlow impressionne vraiment. La génération de portraits humains reste l’un des défis les plus tenaces des modèles d’image open source, notamment pour les mains, la symétrie du visage et la texture naturelle de la peau.
AuraFlow produit des portraits avec :
- Une texture de peau naturelle, avec pores visibles et fines rides, sans le lissage plastique fréquent dans les premiers modèles de diffusion
- Un rendu précis des yeux, avec des reflets lumineux justes, du détail dans l’iris et une profondeur des cils convaincante
- Une géométrie du visage cohérente selon les conditions d’éclairage et les descriptions du prompt
- Des cheveux réalistes, avec une variation mèche par mèche, plutôt que des masses d’aspect peint ou une symétrie artificielle
Pour quiconque génère des portraits de personnages, des photos de type portrait professionnel en buste ou des images éditoriales, il s’agit d’une amélioration notable par rapport aux options open source précédentes, à coût d’inférence comparable.
Paysages et architecture
La génération de paysages profite de l’approche d’entraînement en flow matching d’AuraFlow. Le modèle gère la perspective atmosphérique, les transitions d’éclairage sur de grandes scènes et les textures organiques complexes comme le feuillage, l’eau et la roche, avec une forte cohérence interne.
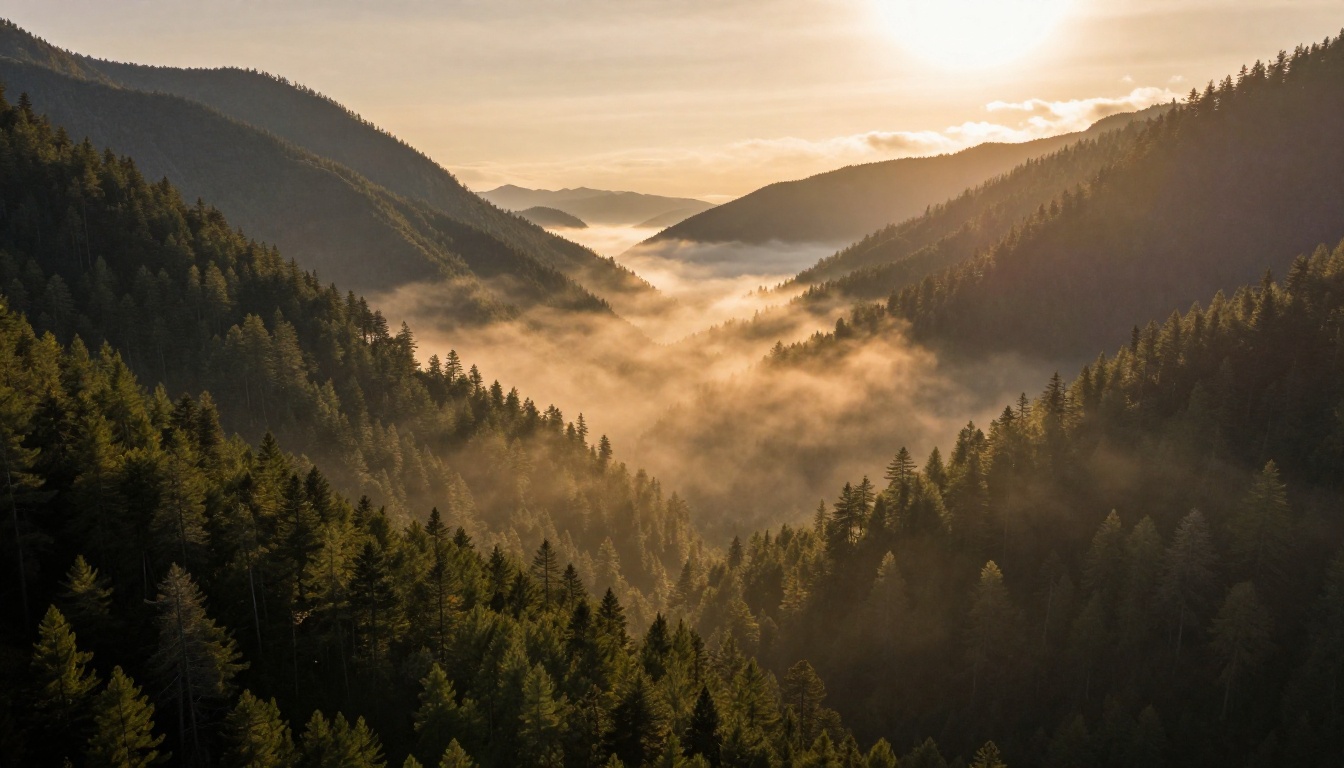
Le processus d’entraînement permet un traitement plus fluide des grands éléments de composition. Le ciel, le second plan et l’avant-plan d’un paysage conservent des rapports tonals justes, sans l’aspect « collé » que produisaient parfois les modèles antérieurs lorsqu’ils tentaient de rendre des scènes complexes à plusieurs plans avec un éclairage varié.
Mode et images éditoriales
Pour les images de mode et de photographie commerciale, AuraFlow tient bien la comparaison avec des modèles fine-tunés spécialement conçus pour ces usages. La texture des tissus, la tombée des vêtements et l’interaction de la lumière avec différentes matières (soie, lin, denim, cuir) sont rendues avec une précision photographique qui paraît réelle plutôt que simulée.
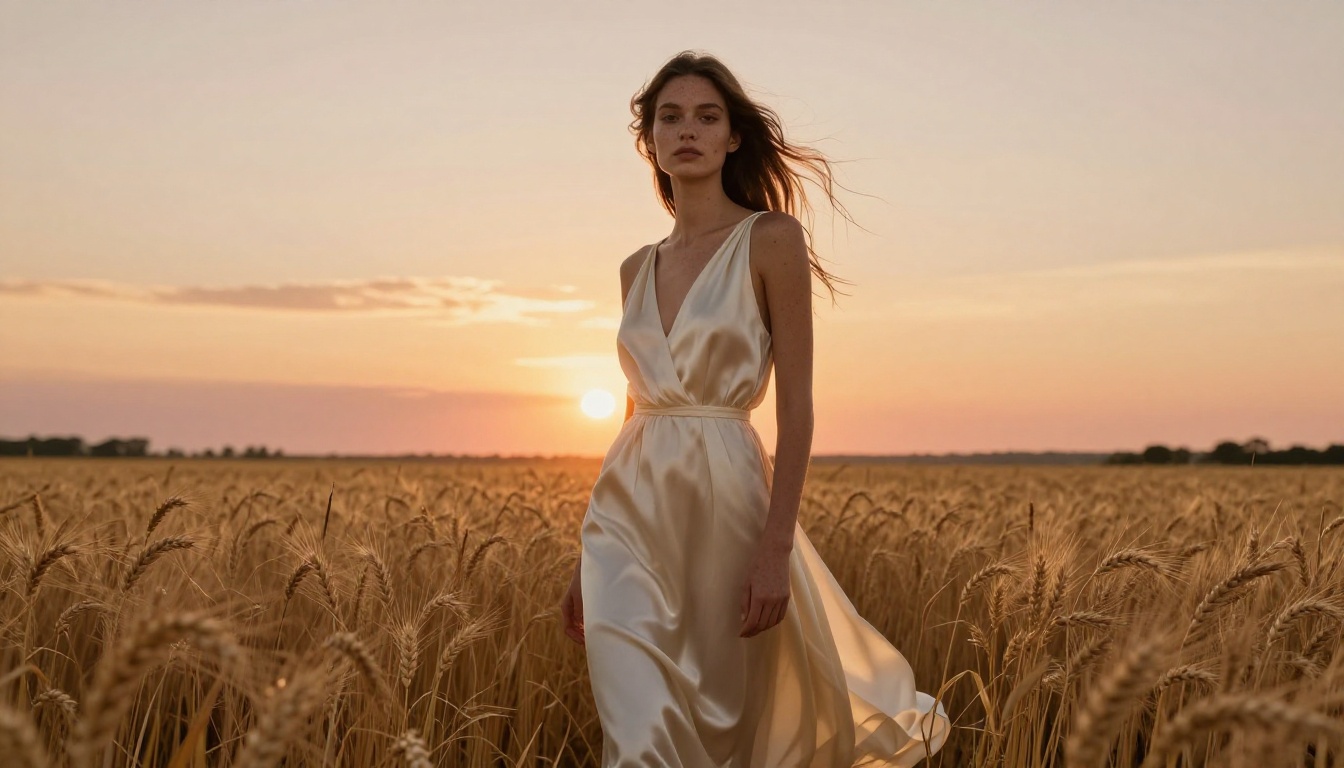
Le modèle gère aussi avec assurance les scénarios d’éclairage complexes. Le contre-jour qui crée des halos de contour, la lumière tachetée à travers le feuillage qui produit un éclairage irrégulier et les dispositifs d’éclairage directionnel de type studio donnent tous des résultats qui se lisent comme photographiques plutôt que comme des rendus calculés.
Images candid et lifestyle
Les images de style candid, avec plusieurs sujets, des expressions naturelles et un contexte environnant, sont réputées difficiles pour les modèles d’image IA. Les interactions entre personnes paraissent souvent posées, physiquement maladroites ou émotionnellement vides.
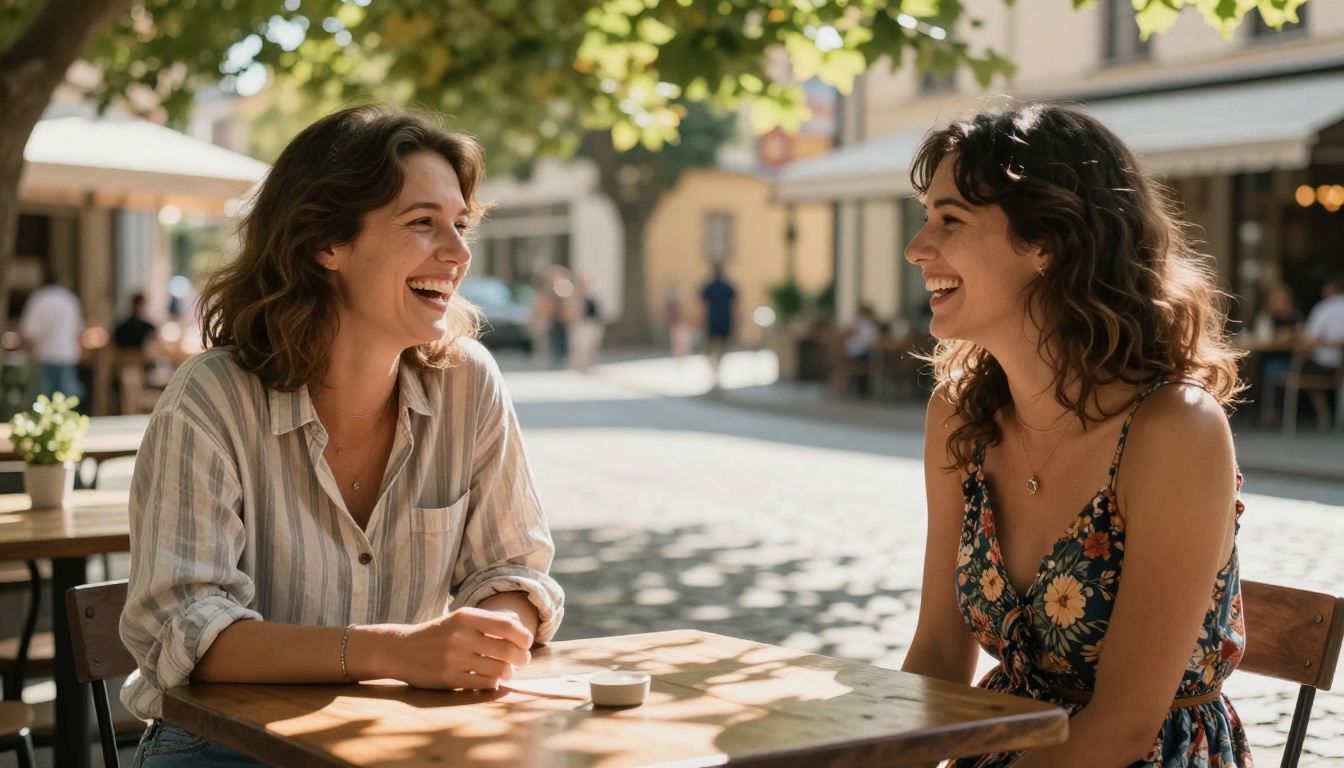
La forte cohérence du prompt d’AuraFlow est ici un atout. Préciser le contexte émotionnel dans le prompt (rire franc, conversation détendue, concentration) se traduit par des images dont les expressions et le langage corporel paraissent réellement naturels. Le modèle ne tombe pas par défaut dans des visages vides ou des sourires forcés lorsqu’on lui donne une indication émotionnelle descriptive dans le prompt.
Faire tourner AuraFlow sur votre propre matériel
AuraFlow est disponible via le hub de modèles de Hugging Face et compatible avec le pipeline diffusers standard. Le faire tourner en local est simple pour quiconque a déjà installé un modèle similaire.
Configuration matérielle requise
| Configuration | VRAM minimale | Vitesse de génération (approx.) |
|---|
| fp16 pleine précision | 12 Go | ~45 secondes par image |
| fp8 quantifié | 8 Go | ~90 secondes par image |
| Mode CPU offload | 8 Go de VRAM | 3 à 5 minutes par image |
Un GPU de gamme intermédiaire comme la RTX 3080 ou la RTX 4070 peut faire tourner AuraFlow en fp16 sans difficulté. C’est un avantage d’accessibilité notable par rapport à FLUX.1 Dev, qui exige souvent un matériel haut de gamme pour une qualité de sortie équivalente.
Installation et prérequis
La bibliothèque diffusers prend en charge AuraFlow nativement via son interface de pipeline standard. Une installation locale de base nécessite :
- Python 3.10 ou une version plus récente comme environnement d’exécution
- PyTorch 2.x avec CUDA pour l’accélération GPU
- Les bibliothèques Python diffusers, transformers et accelerate
- Le checkpoint du modèle depuis Hugging Face, un téléchargement d’environ 12 Go
Le pipeline d’échantillonnage accepte les paramètres standard. Un guidance scale compris entre 3,5 et 7,0 donne les meilleurs résultats pour les rendus photoréalistes. Un nombre d’étapes de 20 à 30 suffit pour la plupart des cas, tandis qu’un nombre plus élevé (jusqu’à 50) n’apporte que de légères améliorations de qualité pour des scènes extrêmement détaillées, au prix d’un temps de génération plus long.
💡 Astuce de prompt : AuraFlow réagit fortement aux descriptions de scène détaillées. Ajouter une direction de lumière (« lumière matinale douce venant de la gauche »), des paramètres d’objectif (« 85 mm f/1.8, faible profondeur de champ ») et des précisions sur les matières (« soie avec tombé et texture visibles ») améliore nettement le photoréalisme, bien plus que des prompts génériques et courts.
Ce que cela change pour les créateurs d’images IA
La sortie d’AuraFlow s’inscrit dans une tendance qui s’accélère : l’écart entre les modèles commerciaux fermés et les alternatives open source se réduit plus vite que la plupart ne l’imaginaient. Il y a trois ans, la meilleure génération d’images exigeait l’accès à l’API restreinte de DALL-E 2. Aujourd’hui, l’écosystème open source comprend des modèles de flow matching à base de transformers qui égalent la qualité commerciale pour la plupart des usages concrets.
Le changement dans le paysage open source de l’image
Pour les créateurs, cela se traduit par des avantages concrets :
- Plus de contrôle : fine-tunez sur vos propres données, gardez les poids, possédez le style
- Des coûts réduits : aucun frais par image lorsque vous faites tourner le modèle en local à grande échelle
- Aucune dépendance à un fournisseur : votre flux de travail ne se casse pas quand une API change de tarifs
- Des améliorations communautaires : le modèle s’améliorera à mesure que les chercheurs s’appuieront dessus publiquement
AuraFlow vient s’ajouter à FLUX comme preuve que la génération d’images open source a atteint un point où la question n’est plus « est-ce assez bon ? » mais « quelles forces spécifiques conviennent à mon cas d’usage ? ». Les deux modèles produisent des images commercialement exploitables à partir d’un modèle de base sans fine-tuning, ce qui n’était pas vrai des options open source il y a encore 18 mois.
La combinaison d’une architecture de flow matching, d’un photoréalisme solide sur les sujets humains, d’exigences matérielles plus légères que celles de modèles comparables et de poids entièrement ouverts fait d’AuraFlow l’une des sorties les plus intéressantes de la synthèse d’images IA en 2024. Que vous le fassiez tourner en local ou que vous y accédiez via une plateforme, il mérite sa place dans votre veille sur l’état actuel du domaine.
Commencez à générer avec les modèles d’image IA dès aujourd’hui
Si vous voulez mettre à profit les capacités des derniers modèles d’image IA sans configurer d’environnement local, Picasso IA vous donne accès à une vaste bibliothèque de modèles professionnels de texte vers image, dont Flux Redux Dev et des dizaines d’autres modèles couvrant différents styles et types de rendus.
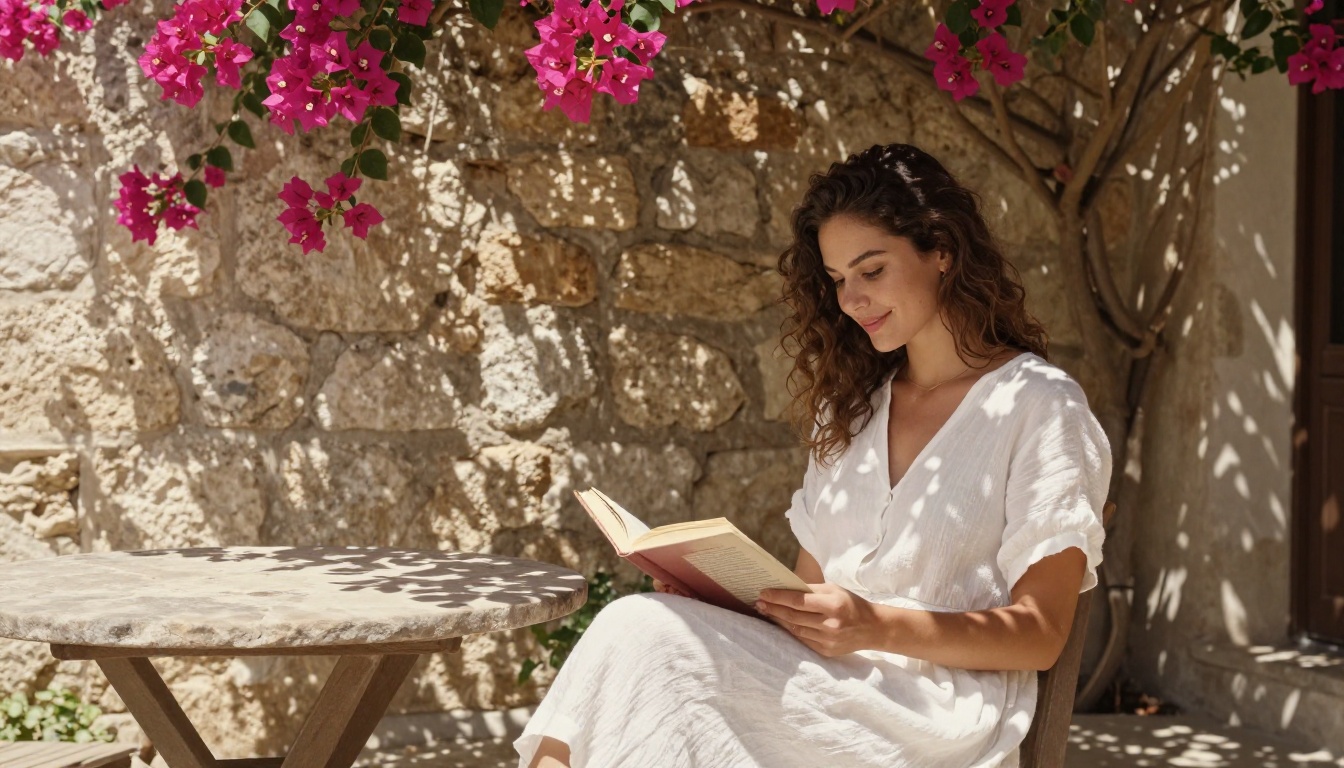
La plateforme vous permet de générer directement à partir de prompts textuels des portraits photoréalistes, des prises de vue de mode éditoriale, des paysages spectaculaires et des images lifestyle de type candid, sans GPU local ni environnement Python. Vous pouvez tester différents styles de prompts, comparer les rendus entre modèles et voir par vous-même ce que produisent les architectures fondées sur le flow matching par rapport aux pipelines de diffusion traditionnels.
Que vous soyez photographe et que vous prototypiez des concepts de plans avant une journée de tournage coûteuse, designer produisant des contenus visuels à grande échelle ou développeur évaluant le modèle le plus adapté à votre produit, le moyen le plus rapide de vous forger un avis éclairé est de vous lancer dans la génération. Choisissez une scène précise, rédigez un prompt détaillé et voyez ce que la génération actuelle de modèles d’image ouverts est réellement capable de produire.


