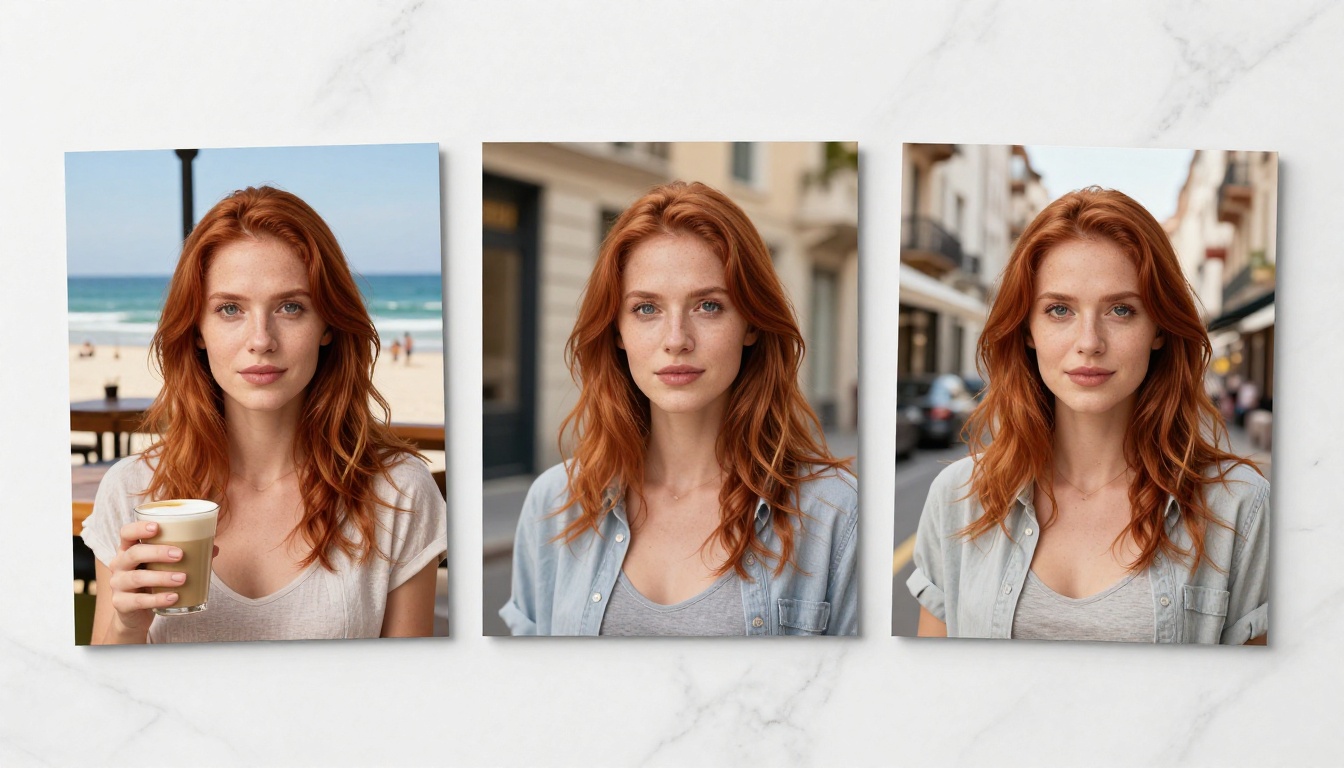
La coherencia de personajes es probablemente la función más pedida en la generación de imágenes con IA, y la promesa más incumplida. Preparas tu flujo de trabajo, generas imagen tras imagen y, entre la tercera y la cuarta escena, el rostro de tu personaje empieza a desviarse. Color de ojos equivocado. Otra nariz. Una mandíbula que pertenece a otra persona por completo. Si te has topado con este muro en OpenArt, has llegado al lugar correcto.
Por qué tu personaje no deja de cambiar
El problema central no tiene nada que ver con tus prompts. Es de arquitectura.
El problema de la deriva facial
La mayoría de los generadores de imágenes con IA interpretan tu prompt de texto desde cero en cada generación. Aunque describas al mismo personaje con el mismo detalle en diez prompts distintos, el modelo trata cada solicitud por separado. No tiene memoria del rostro que generó tres solicitudes antes. El resultado es un personaje que comparte un parecido familiar vago entre imágenes, pero que falla siempre la prueba de coherencia cuando los pones uno junto a otro.
Esto resulta especialmente doloroso para quienes crean novelas visuales, webtoons, personajes de marca o perfiles en redes sociales. Cuando aparece la deriva facial, se rompe la inmersión. También se rompe la confianza de tu audiencia, que nota enseguida cuando "el mismo personaje" se ve ligeramente distinto de un panel a otro o de una publicación a otra.
Las limitaciones de los LoRA en OpenArt
OpenArt sí ofrece soporte para LoRA, que en teoría resuelve este problema. Pero en la práctica, entrenar un LoRA en OpenArt requiere un conjunto específico de condiciones para dar resultados coherentes: imágenes de referencia limpias, un etiquetado adecuado del dataset y una comprensión de los parámetros de entrenamiento que la mayoría de los usuarios no tiene tiempo de desarrollar. El ecosistema comunitario de LoRA de la plataforma también se ha fragmentado, y cientos de modelos producen resultados muy desiguales según el modelo base y los ajustes con los que los combines.
El problema de fondo es que incluso un LoRA bien entrenado no resuelve del todo la coherencia de personajes en múltiples escenas sin control de pose adicional y anclaje de referencia. Puedes tener un LoRA excelente y seguir sufriendo deriva facial cuando la escena se complica.
💡 El problema real: la coherencia de personajes requiere o bien una arquitectura dedicada (condicionamiento por imagen de referencia), o bien un LoRA entrenado con cuidado combinado con una guía estructural. La generación genérica de texto a imagen por sí sola no puede resolverla.
Qué distingue a una alternativa real
No todas las plataformas que se presentan como alternativas a OpenArt abordan de verdad el problema de la coherencia de personajes. La mayoría solo ofrece más modelos o una interfaz más limpia. Esto es lo que de verdad importa.
Anclaje de estilo frente a anclaje de personaje
El anclaje de estilo mantiene constante la estética visual: la misma paleta de colores, el mismo estilo de iluminación, la misma dirección artística. Es relativamente fácil de lograr. El anclaje de personaje es el problema más difícil. Significa mantener el mismo rostro, las mismas proporciones, los mismos rasgos distintivos, la misma forma de ojos y la misma asimetría de labios, en escenas y poses muy diferentes.
Una plataforma necesita herramientas específicas para el anclaje de personaje: condicionamiento por imagen de referencia, fusión de varias imágenes o modelos de personaje dedicados, entrenados con la coherencia como objetivo principal. Sin esas herramientas, sigues enfrentándote al mismo problema, pero con una calidad más alta.
Contrapartidas entre velocidad y calidad
Algunos modelos priorizan la velocidad y producen aproximaciones rápidas que, vistas aisladas, parecen lo bastante parecidas. Otros tardan más en la inferencia, pero fijan los rasgos con una precisión que aguanta la comparación lado a lado. Para el trabajo de coherencia de personajes, la velocidad es secundaria. Una generación de tres segundos que se desvía vale menos que una de veinte segundos que fija el rostro de tu personaje a la perfección en cada escena que necesitas.
| Función | OpenArt | PicassoIA |
|---|
| Modelos de personaje dedicados | Limitado | Sí (Ideogram Character, Image 01) |
| Fusión de múltiples referencias | No | Sí (Multi Image Kontext Max) |
| Entrenamiento de LoRA | Sí (configuración compleja) | Sí (P Image Trainer, simplificado) |
| Generación de series de retratos | No | Sí (Portrait Series) |
| Control de estructura con ControlNet | Limitado | Sí (RealVisXL Multi Controlnet) |
Los modelos creados para la coherencia de personajes
PicassoIA ejecuta más de 183 modelos de texto a imagen. La mayoría son de uso general. Pero un subconjunto específico se creó en torno al problema de la coherencia de personajes, y estos son los que merece la pena conocer.
Ideogram Character
Ideogram Character es la solución más directa de la plataforma. Acepta una imagen de referencia de tu personaje y la usa como ancla de condicionamiento para cada generación posterior. El rostro no se desvía porque el modelo está restringido por arquitectura para conservar la referencia. Dale el mismo rostro en otra escena, con otro atuendo o con una iluminación muy distinta, y mantendrá la identidad central en todas ellas.
Este es el modelo para el que OpenArt no tiene un equivalente claro.
Image 01 by Minimax
Image 01 se creó específicamente para generar imágenes coherentes de personajes. Donde la mayoría de los modelos fallan en el trabajo de personajes en múltiples escenas, Image 01 se entrenó con la coherencia como objetivo principal, no como un añadido posterior. Funciona especialmente bien con sujetos humanos y gestiona condiciones de iluminación variadas sin que los rasgos faciales se alejen del original.
Flux Redux Dev
Flux Redux Dev sigue un enfoque distinto. En lugar de que un prompt de texto guíe la generación, toma una imagen de referencia y crea variaciones estructuradas de ella, preservando la identidad visual central a nivel de arquitectura del modelo. Para el trabajo con personajes, esto significa que estableces una imagen de referencia canónica y generas variaciones de escena manteniendo al personaje visualmente fijo. El modelo complementario más rápido, Flux Redux Schnell, te permite iterar con rapidez antes de comprometerte con las generaciones finales.
Portrait Series
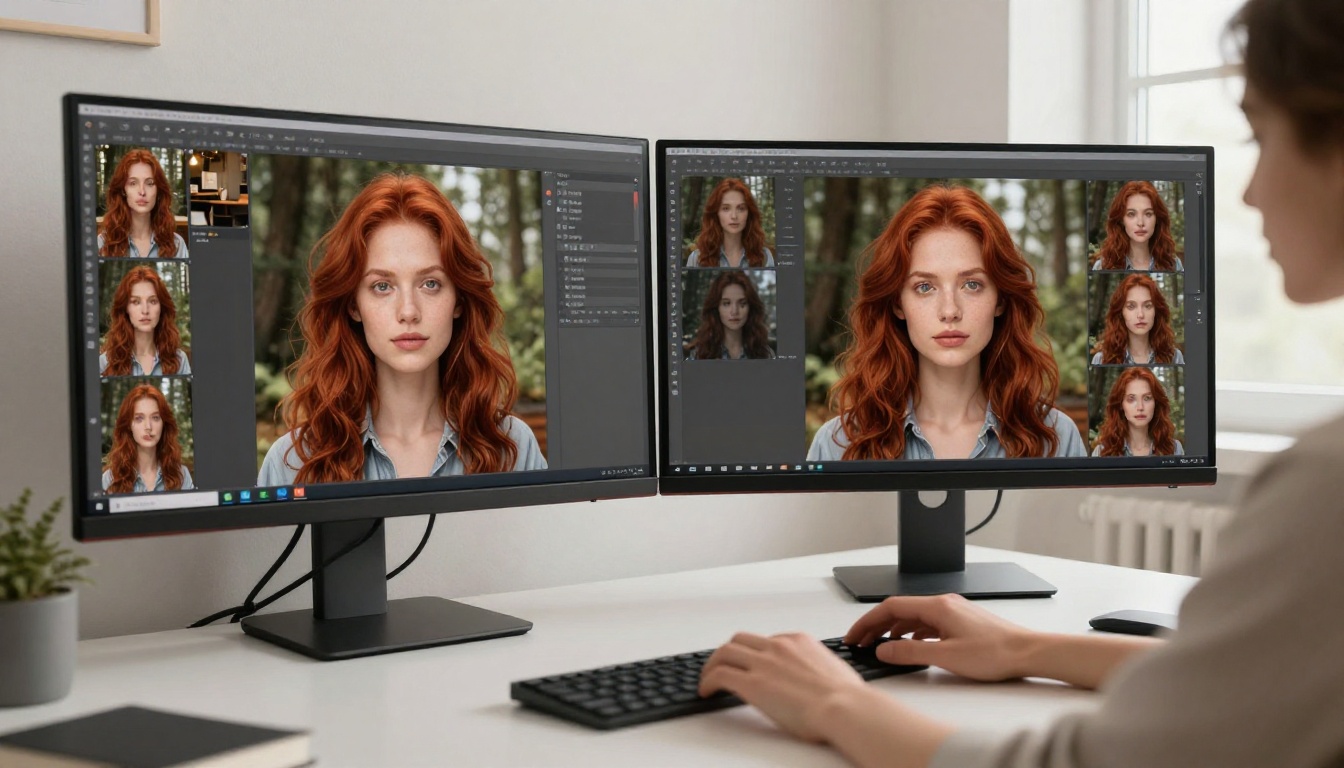
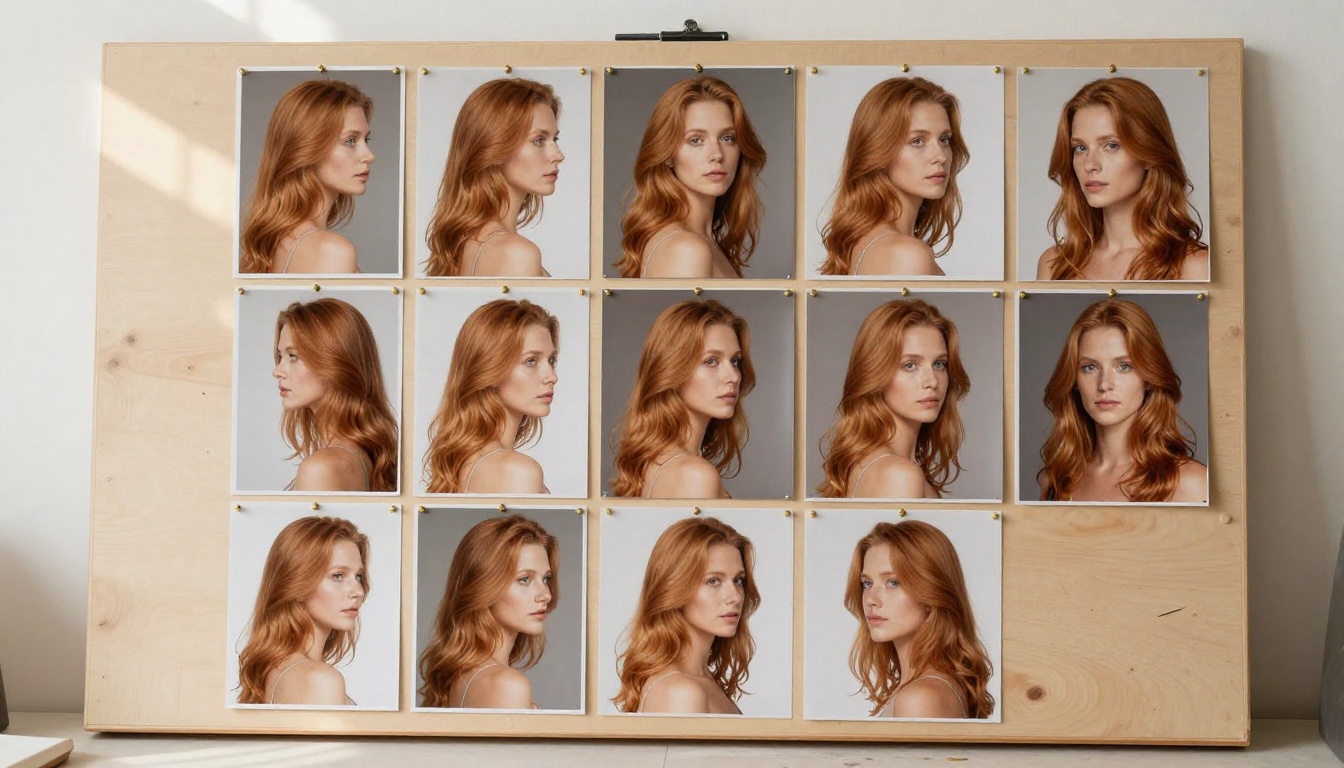
Portrait Series es una aplicación creada con este fin que toma una sola fotografía de referencia y genera una serie de retratos coherentes. Distintos fondos, distintas poses, distintos estados de ánimo. El personaje sigue siendo idéntico. Es ideal para contenido en redes sociales, hojas de personaje y narrativa visual en la que necesitas a la misma persona en muchas imágenes sin gestionar manualmente la coherencia de cada una.
Cómo usar Ideogram Character en PicassoIA
Como Ideogram Character es la respuesta más directa a la pregunta de la coherencia de personajes, aquí tienes exactamente cómo usarlo.
Paso 1: sube tu referencia
Ve a Ideogram Character en PicassoIA. El modelo requiere al menos una imagen de referencia de tu personaje. Para obtener mejores resultados, usa:
- Un retrato frontal limpio con expresión neutra e iluminación uniforme y buena
- Alta resolución (al menos 512 píxeles en el lado más corto)
- Sin filtros fuertes ni estilizaciones que puedan confundir la extracción de rasgos del modelo
Dos o tres imágenes de referencia desde ángulos ligeramente distintos mejoran notablemente la coherencia en poses poco habituales. El modelo usa el conjunto de referencias para construir una representación interna de la geometría facial de tu personaje que se mantiene cuando cambia la escena.
Paso 2: escribe el prompt del personaje
Tu prompt de texto describe la escena, no el personaje. Como Ideogram Character condiciona según tu imagen de referencia, tu prompt se encarga del entorno, la iluminación y la acción:
- Prompt sólido: "De pie en una tienda de conveniencia de Tokio por la noche, luz fluorescente desde el techo, algo de lluvia visible a través de las puertas de cristal detrás de ella, atuendo casual de calle"
- Prompt débil: "Mujer hermosa de pelo castaño rojizo con ojos verdes en Tokio"
El segundo ejemplo compite con la imagen de referencia. Confía en que el modelo se encargue de la apariencia física del personaje. Usa tu prompt para controlar todo lo demás.
Paso 3: genera e itera
Lanza tu primera generación. Compara el rostro directamente con tu imagen de referencia. Si el modelo se ha desviado, prueba a ajustar:
- Aumenta el peso de la referencia si el modelo te ofrece ese parámetro
- Simplifica el prompt de escena para reducir el conflicto semántico con la referencia
- Cambia a una imagen de referencia más sólida con una iluminación más limpia y una definición de rasgos más nítida
Tres a cinco iteraciones suelen fijar al personaje de forma fiable. Cuando encuentres una generación que te convenza, úsala como nueva entrada de referencia para tu siguiente lote de escenas.
💡 Consejo profesional: crea una biblioteca personal de generaciones de personaje confirmadas como coherentes. A medida que crezca, tendrás referencias más sólidas y variadas para anclar las escenas futuras, y tu coherencia se acumulará con el tiempo.
El entrenamiento de LoRA lo cambia todo
Si necesitas coherencia absoluta del personaje en cincuenta o cien imágenes, el entrenamiento de un modelo dedicado es el camino que elimina la deriva por completo.
Qué hace realmente un LoRA
Un LoRA (Low-Rank Adaptation) es un conjunto pequeño de pesos entrenados que modifican el comportamiento de un modelo base para un concepto específico. Cuando entrenas un LoRA con tu personaje, le enseñas al modelo a reconocer a ese personaje como un concepto con nombre, de la misma forma que ya sabe cómo es un "labrador retriever" o un "invernadero victoriano". Una vez entrenado, generas a tu personaje en cualquier escena con una sola palabra disparadora, sin imagen de referencia y sin deriva.
La diferencia con los enfoques basados en prompts o en referencias es fundamental. No describes al personaje ni lo condicionas con una referencia cada vez. Invocas un concepto que el modelo ha interiorizado de forma permanente.
Entrenar tu LoRA de personaje en PicassoIA
P Image Trainer hace accesible el entrenamiento de LoRA sin necesidad de hardware GPU local ni conocimientos técnicos profundos. Todo el proceso se ejecuta en la infraestructura de PicassoIA:
- Reúne de 10 a 20 imágenes de referencia de tu personaje, desde ángulos e iluminaciones variados
- Sube las imágenes a P Image Trainer y asigna una palabra disparadora única (por ejemplo, "auroracharacter")
- Define los pasos de entrenamiento (de 800 a 1200 pasos funcionan de forma fiable para LoRA de personaje)
- Ejecuta el entrenamiento (normalmente de 15 a 30 minutos en la plataforma)
- Prueba la salida usando tu palabra disparadora combinada con descripciones de escena variadas
Después del entrenamiento, usa tu LoRA con Flux Schnell LoRA para una generación rápida, o con Flux Pro Finetuned para la salida de mayor calidad. Cuando necesites una resolución de calidad de impresión, Flux 1.1 Pro Ultra Finetuned ofrece resultados de 4 MP. Para el control de pose junto con tu LoRA de personaje, RealVisXL v3 Multi Controlnet LoRA combina la guía estructural de ControlNet con el condicionamiento de personaje mediante LoRA para una precisión máxima.
Comparación de resultados: OpenArt frente a PicassoIA
La diferencia de resultados se nota más cuando pruebas al mismo personaje en escenas muy distintas dentro de la misma sesión.
Calidad de salida lado a lado
En OpenArt, un personaje generado en una cafetería y luego regenerado en una playa suele compartir características generales, pero falla en los detalles específicos: el color de los ojos cambia un tono, el puente de la nariz varía en perfil, la textura del pelo adquiere otra calidad y la mandíbula se suaviza o se endurece de maneras que no pediste. Estos errores parecen triviales por separado. Destruyen la narrativa visual cuando se ven en secuencia.
En PicassoIA, con Ideogram Character o un LoRA entrenado, el mismo personaje en escenas distintas mantiene lo específico: la distribución exacta de las pecas, la forma particular del arco de cupido, el color preciso del iris, la manera concreta en que caen los párpados. No es solo parecido. Es la misma persona en otro lugar.
Velocidad del flujo de trabajo
La comparación práctica también favorece a las plataformas estructuradas. En OpenArt, lograr una coherencia aproximada exige encontrar un LoRA comunitario compatible, probar varias combinaciones de modelo base, ajustar la intensidad y iterar durante decenas de generaciones antes de obtener algo utilizable. Es lento e incierto.
En PicassoIA, o bien usas un modelo creado para este fin, como Image 01, y obtienes resultados fiables de inmediato, o bien entrenas un LoRA con P Image Trainer una sola vez y generas de forma coherente para siempre, sin configuración adicional por escena.
Consejos para mantener personajes coherentes en todo momento
Incluso con los modelos adecuados, pequeñas decisiones en tu flujo de trabajo afectan mucho a la coherencia del personaje.
Selección de la imagen de referencia
La calidad de tu referencia determina la calidad de tu coherencia. Las malas imágenes de referencia producen una mala coherencia, sin importar qué modelo uses. El modelo solo puede anclar lo que ve con claridad.
Qué hace una buena referencia:
- Enfoque nítido en el rostro y sin desenfoque por movimiento
- Iluminación suave o direccional y neutra que revele con claridad la estructura facial
- Sombras fuertes mínimas que oculten los rasgos distintivos
- Ángulo frontal o casi frontal con ambos ojos totalmente visibles
- Expresión natural (las expresiones extremas distorsionan las proporciones y confunden la extracción de rasgos)
Qué evitar:
- Filtros fuertes que alteren el tono de la piel y el contraste de los rasgos
- Maquillaje intenso que cambie la estructura facial de fondo
- Imágenes con contraluz o en silueta, donde se pierde el detalle facial
- Imágenes de resolución muy baja, en las que los rasgos individuales no se definen con claridad
Ingeniería de prompts para la coherencia
Tus prompts de escena deben describir todo excepto la apariencia física del personaje. Deja que la imagen de referencia o el LoRA se encarguen del rostro. Tu prompt se ocupa de:
- Lugar y hora del día: "terraza en la azotea, hora dorada, Roma"
- Atuendo: "americana de lino blanco, pantalón oscuro a medida, collar sencillo de oro"
- Acción y postura: "riendo ante la pantalla de un teléfono, apoyada contra una pared de ladrillo calentada por el sol"
- Iluminación: "contraluz cálido del sol poniente, relleno suave y práctico desde la derecha"
- Ángulo y distancia de cámara: "plano medio, ligero contrapicado, objetivo de 85 mm"
Cuanto más intentes describir el rostro del personaje en texto junto a una imagen de referencia, más conflicto introduces. La descripción textual y la imagen de referencia se contradicen, y el modelo transige entre ambas. Confía en la referencia. Dirige la escena.
Fusión de múltiples imágenes para escenas complejas
Cuando una sola referencia no basta, Multi Image Kontext Max y Multi Image Kontext Pro te permiten combinar varias imágenes de referencia en una única generación coherente. Esto resulta especialmente útil para escenas que requieren varios personajes coherentes, o para combinar el rostro de un personaje concreto con un atuendo o un entorno específicos.
Gen4 Image by Runway avanza un paso más, al convertir varias entradas de referencia en escenas completamente nuevas, preservando la identidad visual de cada elemento.
Empieza a crear tus propios personajes coherentes
La coherencia de personajes fue en su momento una capacidad premium, algo reservado para estudios de animación con flujos de trabajo dedicados y artistas técnicos que dedicaban semanas al entrenamiento de modelos personalizados. Esa brecha se ha cerrado.
Ideogram Character es el punto de entrada más rápido. Sube una imagen de referencia, describe tu escena y genera. No hace falta entrenamiento, ni configuración compleja, ni conocimientos técnicos profundos. Image 01 cubre el mismo terreno con una arquitectura complementaria, y te ofrece una segunda opción fiable cuando la primera necesita afinarse para un tipo de escena concreto.
Para proyectos de larga duración en los que necesitas un personaje en cincuenta o cien escenas, entrena un LoRA con P Image Trainer. Una sola sesión de entrenamiento, coherencia permanente, sin deriva. Combínalo con Flux Pro Finetuned o con AI Avatars, según el formato de salida que requiera tu proyecto.
Las herramientas están ahí. El personaje es tuyo para construirlo.