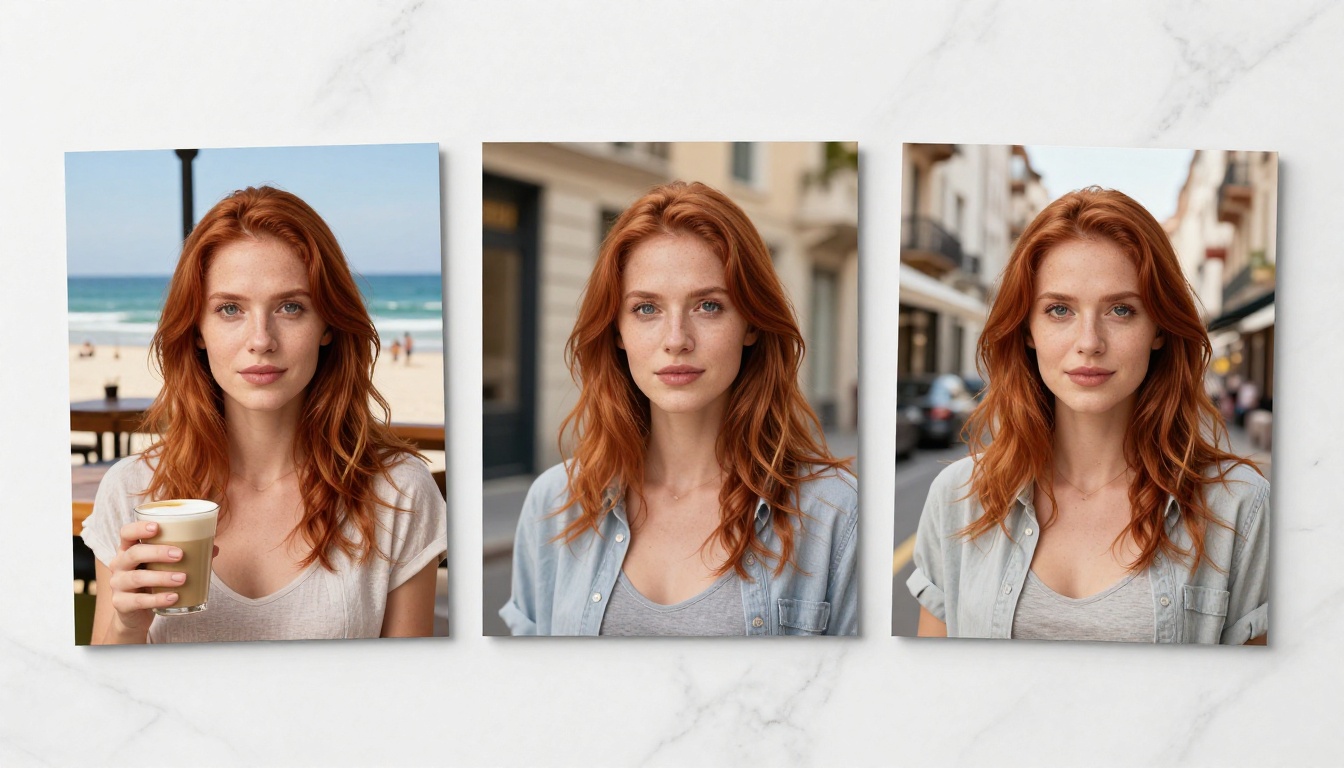
La cohérence des personnages est sans doute la fonctionnalité la plus demandée en génération d’images par IA, et la promesse la plus souvent non tenue. Vous mettez en place votre flux de travail, vous générez image après image, et quelque part entre la troisième et la quatrième scène, le visage de votre personnage commence à dériver. Mauvaise couleur des yeux. Nez différent. Une mâchoire qui appartient à quelqu’un d’autre. Si vous vous heurtez à ce mur sur OpenArt, vous êtes au bon endroit.
Pourquoi votre personnage ne cesse de changer
Le problème central n’a rien à voir avec vos prompts. Il est structurel.
Le problème de la dérive du visage
La plupart des générateurs d’images par IA fonctionnent en interprétant votre prompt texte à nouveau à chaque génération. Même si vous décrivez le même personnage avec exactement les mêmes détails dans dix prompts différents, le modèle traite chaque requête de manière indépendante. Il n’a aucune mémoire du visage qu’il a généré trois requêtes plus tôt. Le résultat est un personnage qui présente une vague ressemblance familiale d’une image à l’autre, mais qui échoue systématiquement au test de cohérence lorsque vous les placez côte à côte.
Cela devient particulièrement pénible pour les créateurs de romans visuels, de webtoons, de personnages de marque ou de personnalités sur les réseaux sociaux. Quand la dérive du visage se produit, elle brise l’immersion. Elle entame aussi la confiance de votre audience, qui remarque immédiatement quand « le même personnage » paraît légèrement différent d’une case ou d’une publication à l’autre.
Les limites des LoRA sur OpenArt
OpenArt propose bien la prise en charge des LoRA, ce qui répond en théorie à ce problème. Mais en pratique, entraîner un LoRA sur OpenArt exige un ensemble précis de conditions pour obtenir des résultats cohérents : des images de référence propres, un étiquetage rigoureux du jeu de données et une bonne compréhension des paramètres d’entraînement, que la plupart des utilisateurs n’ont pas le temps d’acquérir. L’écosystème communautaire de LoRA de la plateforme s’est par ailleurs fragmenté, avec des centaines de modèles aux résultats très incohérents selon le modèle de base et les réglages associés.
Le problème plus profond, c’est qu’un LoRA bien entraîné ne résout pas entièrement la cohérence des personnages sur plusieurs scènes sans un contrôle de pose supplémentaire et un ancrage par image de référence. Vous pouvez disposer d’un excellent LoRA et connaître tout de même une dérive du visage quand la scène devient complexe.
💡 Le vrai problème : la cohérence des personnages exige soit une architecture dédiée (conditionnement par image de référence), soit un LoRA soigneusement entraîné associé à un guidage structurel. La génération texte vers image générique ne peut pas la résoudre à elle seule.
Ce qui distingue une véritable alternative
Toutes les plateformes qui se présentent comme des alternatives à OpenArt ne répondent pas réellement au problème de la cohérence des personnages. La plupart proposent simplement davantage de modèles ou une interface plus épurée. Voici ce qui compte vraiment.
Ancrage du style face à ancrage du personnage
L’ancrage du style préserve l’esthétique visuelle : même palette de couleurs, même type d’éclairage, même direction artistique. C’est relativement facile à obtenir. L’ancrage du personnage est un problème plus difficile. Il suppose le même visage, les mêmes proportions, les mêmes traits distinctifs, la même forme précise des yeux et la même asymétrie des lèvres, dans des scènes et des poses très différentes.
Une plateforme a besoin d’outils spécifiques pour l’ancrage du personnage : conditionnement par image de référence, fusion de plusieurs images, ou modèles de personnages dédiés entraînés avec la cohérence comme objectif principal. Sans ces outils, vous restez confronté au même problème, à un niveau de qualité simplement plus élevé.
Compromis entre vitesse et qualité
Certains modèles privilégient la vitesse et produisent des approximations rapides qui paraissent assez proches lorsqu’on les regarde isolément. D’autres demandent une inférence plus lente, mais verrouillent les traits avec une précision qui tient à la comparaison côte à côte. Pour le travail sur la cohérence des personnages, la vitesse passe au second plan. Une génération de trois secondes qui dérive vaut moins qu’une génération de vingt secondes qui verrouille parfaitement le visage de votre personnage dans chaque scène dont vous avez besoin.
| Fonctionnalité | OpenArt | PicassoIA |
|---|
| Modèles de personnages dédiés | Limités | Oui (Ideogram Character, Image 01) |
| Fusion de plusieurs références | Non | Oui (Multi Image Kontext Max) |
| Entraînement de LoRA | Oui (configuration complexe) | Oui (P Image Trainer, simplifié) |
| Génération de séries de portraits | Non | Oui (Portrait Series) |
| Contrôle structurel ControlNet | Limité | Oui (RealVisXL Multi Controlnet) |
Les modèles conçus pour la cohérence des personnages
PicassoIA propose plus de 183 modèles de texte vers image. La plupart sont polyvalents. Mais un sous-ensemble spécifique a été conçu autour du problème de la cohérence des personnages, et ce sont ceux qu’il vaut la peine de connaître.
Ideogram Character
Ideogram Character est la solution la plus directe de la plateforme. Il accepte une image de référence de votre personnage et l’utilise comme ancre de conditionnement pour chaque génération suivante. Le visage ne dérive pas, car le modèle est structurellement contraint de préserver la référence. Donnez-lui le même visage dans une autre scène, avec une tenue différente ou une lumière radicalement différente, et il conserve l’identité essentielle dans tous ces cas.
C’est le modèle pour lequel OpenArt n’a pas d’équivalent véritablement comparable.
Image 01 de Minimax
Image 01 a été conçu spécifiquement pour générer des images de personnages cohérentes. Là où la plupart des modèles échouent sur le travail de personnages multi-scènes, Image 01 a été entraîné avec la cohérence comme objectif principal, et non comme une réflexion après coup. Il donne de très bons résultats avec des sujets humains et gère des conditions d’éclairage variées sans laisser les traits du visage dériver.
Flux Redux Dev
Flux Redux Dev adopte une approche différente. Au lieu de piloter la génération par un prompt texte, il prend une image de référence et crée des variations structurées de celle-ci, en préservant l’identité visuelle essentielle au niveau de l’architecture du modèle. Pour le travail sur les personnages, cela signifie que vous établissez une image de référence canonique et générez des variations de scène tout en gardant le personnage visuellement verrouillé. Le modèle compagnon plus rapide Flux Redux Schnell vous permet d’itérer vite avant de valider les générations finales.
Portrait Series
Portrait Series est une application conçue spécifiquement pour prendre une seule photo de référence et générer une série de portraits cohérents. Arrière-plans, poses et ambiances différents. Le personnage reste identique. C’est idéal pour les contenus sur les réseaux sociaux, les planches de personnages et la narration visuelle, lorsque vous avez besoin de la même personne sur de nombreuses images sans gérer manuellement la cohérence pour chacune.
Comme Ideogram Character est la réponse la plus directe à la question de la cohérence des personnages, voici précisément comment l’utiliser.
Étape 1 : importez votre référence
Rendez-vous sur Ideogram Character sur PicassoIA. Le modèle exige au moins une image de référence de votre personnage. Pour de meilleurs résultats, utilisez :
- Un portrait frontal net avec une expression neutre et un éclairage uniforme et équilibré
- Une haute résolution (au moins 512 pixels sur le plus petit côté)
- Aucun filtre lourd ni stylisation susceptible de perturber l’extraction des traits par le modèle
Deux ou trois images de référence prises sous des angles légèrement différents améliorent nettement la cohérence dans les poses inhabituelles. Le modèle utilise cet ensemble de références pour construire une représentation interne de la géométrie du visage de votre personnage, qui tient quand la scène change.
Étape 2 : rédigez le prompt de votre personnage
Votre prompt texte décrit la scène, pas le personnage. Comme Ideogram Character se base sur votre image de référence, votre prompt gère l’environnement, l’éclairage et l’action :
- Prompt efficace : « Debout dans une supérette de Tokyo, la nuit, éclairage fluorescent au plafond, une légère pluie visible à travers les portes vitrées derrière elle, tenue décontractée de rue »
- Prompt peu efficace : « Belle femme aux cheveux auburn et aux yeux verts à Tokyo »
Le second exemple entre en conflit avec l’image de référence. Faites confiance au modèle pour gérer l’apparence physique du personnage. Utilisez votre prompt pour contrôler tout le reste.
Étape 3 : générez et itérez
Lancez votre première génération. Comparez directement le visage à votre image de référence. Si le modèle a dérivé, essayez d’ajuster :
- Augmentez le poids de la référence si le modèle vous propose ce paramètre
- Simplifiez votre prompt de scène pour réduire le conflit sémantique avec la référence
- Changez pour une image de référence plus forte, avec un éclairage plus propre et des traits du visage mieux définis
Trois à cinq itérations suffisent généralement à verrouiller le personnage de façon fiable. Une fois que vous obtenez une génération qui vous satisfait, utilisez-la comme nouvelle entrée de référence pour votre prochain lot de scènes.
💡 Astuce pro : constituez une bibliothèque personnelle de générations dont la cohérence est confirmée. Plus cette bibliothèque s’enrichit, plus vous disposez de références solides et variées pour ancrer les scènes suivantes, et votre cohérence se renforce avec le temps.
L’entraînement de LoRA change tout
Si vous avez besoin d’une cohérence absolue du personnage sur cinquante ou cent images, l’entraînement d’un modèle dédié est la voie qui élimine entièrement la dérive.
Ce que fait réellement un LoRA
Un LoRA (Low-Rank Adaptation) est un petit ensemble de poids entraînés qui modifient le comportement d’un modèle de base pour un concept précis. Lorsque vous entraînez un LoRA sur votre personnage, vous apprenez au modèle à reconnaître ce personnage comme un concept nommé, de la même manière qu’il sait déjà à quoi ressemblent un « Labrador retriever » ou une « serre victorienne ». Une fois entraîné, vous générez votre personnage dans n’importe quelle scène à l’aide d’un seul mot déclencheur, sans image de référence et sans dérive.
La différence avec les approches fondées sur le prompt ou sur la référence est fondamentale. Vous ne décrivez pas le personnage et ne le conditionnez pas sur une référence à chaque fois. Vous faites appel à un concept que le modèle a intériorisé de façon permanente.
Entraîner votre LoRA de personnage sur PicassoIA
P Image Trainer rend l’entraînement de LoRA accessible sans matériel GPU local ni connaissances techniques approfondies. Tout le processus s’exécute sur l’infrastructure de PicassoIA :
- Rassemblez 10 à 20 images de référence de votre personnage, sous des angles et dans des conditions d’éclairage variés
- Importez-les dans P Image Trainer et attribuez un mot déclencheur unique (par exemple, « auroracharacter »)
- Réglez le nombre d’étapes d’entraînement (800 à 1 200 étapes donnent des résultats fiables pour les LoRA de personnages)
- Lancez l’entraînement (généralement de 15 à 30 minutes sur la plateforme)
- Testez le résultat en associant votre mot déclencheur à des descriptions de scènes variées
Après l’entraînement, utilisez votre LoRA avec Flux Schnell LoRA pour une génération rapide, ou Flux Pro Finetuned pour la sortie de meilleure qualité. Lorsque vous avez besoin d’une résolution de qualité impression, Flux 1.1 Pro Ultra Finetuned fournit des résultats de 4 MP. Pour un contrôle de pose en complément de votre LoRA de personnage, RealVisXL v3 Multi Controlnet LoRA combine le guidage structurel ControlNet avec le conditionnement LoRA du personnage pour une précision maximale.
Comparer les résultats : OpenArt face à PicassoIA
L’écart de résultats est le plus visible lorsque vous testez le même personnage dans des scènes radicalement différentes, au cours de la même session.
Qualité des résultats côte à côte
Sur OpenArt, un personnage généré dans un café puis régénéré sur une plage partagera généralement les grandes caractéristiques, mais échouera sur les détails précis : la couleur des yeux change d’une nuance, l’arête du nez se modifie de profil, la texture des cheveux prend une autre qualité, la mâchoire s’adoucit ou se durcit d’une manière que vous n’aviez pas demandée. Ces erreurs paraissent insignifiantes isolément. Elles ruinent la narration visuelle lorsqu’elles s’enchaînent.
Sur PicassoIA, avec Ideogram Character ou un LoRA entraîné, le même personnage dans des scènes différentes conserve le détail : la répartition exacte des taches de rousseur, la forme particulière de l’arc de Cupidon, la couleur précise de l’iris, la façon spécifique dont les paupières se posent. Ce n’est pas seulement une ressemblance. C’est la même personne, dans un autre endroit.
Rapidité du flux de travail
La comparaison pratique avantage aussi les plateformes structurées. Sur OpenArt, obtenir même une cohérence approximative exige de trouver un LoRA communautaire compatible, de tester plusieurs associations de modèles de base, d’ajuster les réglages d’intensité et d’itérer sur des dizaines de générations avant d’arriver à un résultat exploitable. C’est lent et incertain.
Sur PicassoIA, vous utilisez soit un modèle conçu spécifiquement, comme Image 01, et obtenez des résultats fiables immédiatement, soit vous entraînez un LoRA avec P Image Trainer une seule fois, puis générez de façon cohérente à l’infini, sans configuration supplémentaire pour chaque scène.
Des conseils pour des personnages cohérents à chaque fois
Même avec les bons modèles, de petites décisions dans votre flux de travail influencent fortement la cohérence des personnages.
Choix de l’image de référence
La qualité de votre référence détermine la qualité de votre cohérence. Une mauvaise image de référence produit une mauvaise cohérence, quel que soit le modèle utilisé. Le modèle ne peut ancrer que ce qu’il voit clairement.
Ce qui fait une bonne référence :
- Une mise au point nette sur le visage, sans aucun flou de bougé
- Un éclairage neutre ou doux et directionnel qui révèle clairement la structure du visage
- Des ombres portées minimales qui masquent les traits distinctifs
- Un angle frontal ou presque frontal, avec les deux yeux entièrement visibles
- Une expression naturelle (les expressions extrêmes déforment les proportions et perturbent l’extraction des traits)
À éviter :
- Les filtres lourds qui modifient le teint et le contraste des traits
- Un maquillage important qui change la structure sous-jacente du visage
- Les images en contre-jour ou en silhouette, où les détails du visage disparaissent
- Les images de très basse résolution, où les traits individuels ne sont pas nettement définis
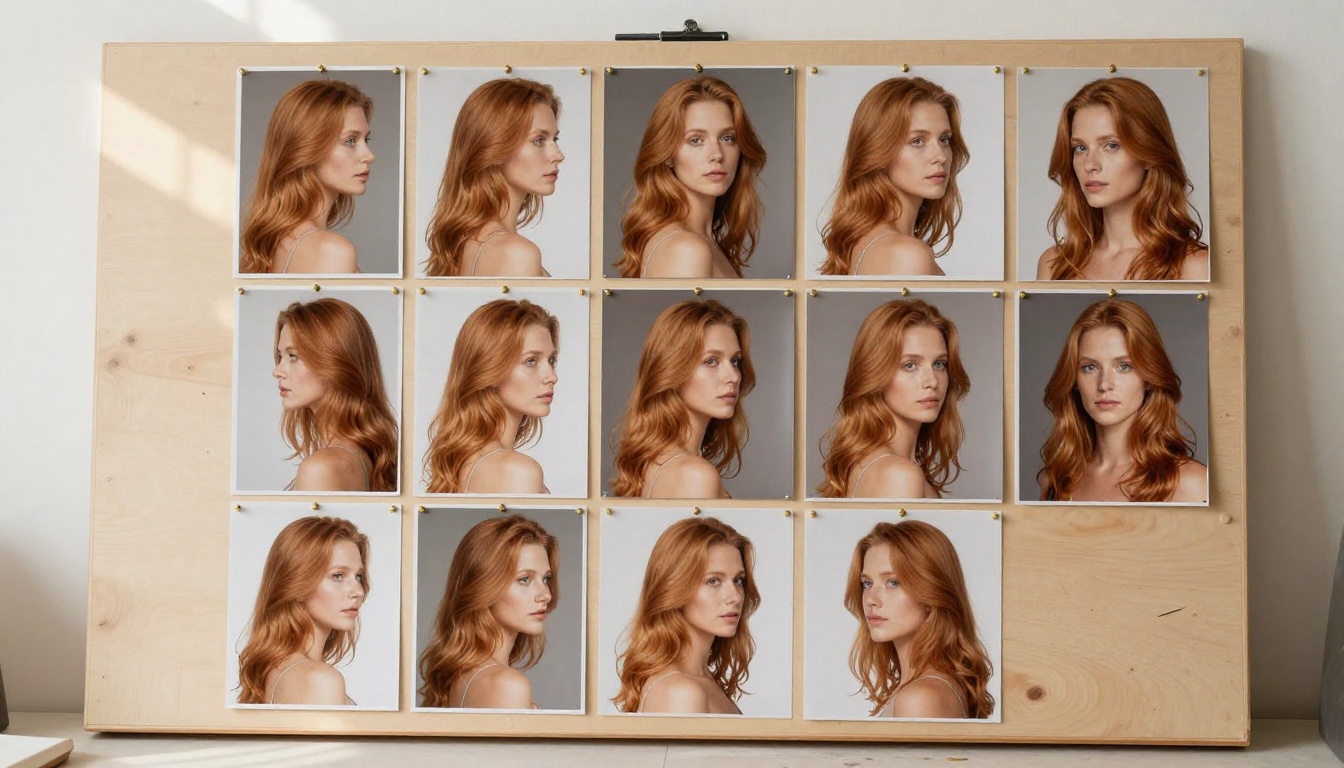
Ingénierie des prompts pour la cohérence
Vos prompts de scène doivent décrire tout sauf l’apparence physique du personnage. Laissez l’image de référence ou le LoRA gérer le visage. Votre prompt gère :
- Lieu et moment de la journée : « terrasse de toit, heure dorée, Rome »
- Tenue : « blazer en lin blanc, pantalon sombre et coupé sur mesure, collier d’or simple »
- Action et posture : « riant devant un écran de téléphone, adossé à un mur de brique réchauffé par le soleil »
- Éclairage : « contre-jour chaud du soleil couchant, lumière d’appoint douce venant de la droite »
- Angle et distance de prise de vue : « plan moyen, légère contre-plongée, objectif 85 mm »
Plus vous essayez de décrire le visage du personnage en texte à côté d’une image de référence, plus vous introduisez de conflits. La description textuelle et l’image de référence se contredisent, et le modèle fait des compromis entre les deux. Faites confiance à la référence. Dirigez la scène.
Fusion de plusieurs images pour les scènes complexes
Lorsqu’une seule référence ne suffit pas, Multi Image Kontext Max et Multi Image Kontext Pro vous permettent de combiner plusieurs images de référence en une seule génération cohérente. C’est particulièrement utile pour les scènes qui exigent plusieurs personnages cohérents, ou pour associer le visage d’un personnage précis à une tenue ou à un environnement de référence précis.
Gen4 Image de Runway va plus loin en transformant plusieurs références en scènes entièrement nouvelles tout en préservant l’identité visuelle de chaque élément.
Commencez à créer vos propres personnages cohérents
La cohérence des personnages était autrefois une capacité premium, réservée aux studios d’animation disposant de chaînes de production dédiées et de techniciens qui passaient des semaines à entraîner des modèles sur mesure. Cet écart s’est refermé.
Ideogram Character est le point d’entrée le plus rapide. Importez une image de référence, décrivez votre scène, générez. Aucun entraînement requis, aucune configuration complexe, aucune connaissance technique approfondie nécessaire. Image 01 couvre le même territoire avec une architecture complémentaire, vous offrant une seconde option fiable lorsque la première a besoin d’être affinée pour un type de scène particulier.
Pour les projets au long cours où vous avez besoin d’un personnage sur cinquante ou cent scènes, entraînez un LoRA avec P Image Trainer. Une seule session d’entraînement, une cohérence permanente, aucune dérive. Associez-le à Flux Pro Finetuned ou à AI Avatars, selon le format de sortie dont votre projet a besoin.
Les outils sont là. Le personnage est à vous de le construire.